即刻App年轻人的同好社区
下载
前端开发者小站
</div><script>alert('hello')</script><div>
9210人已经加入
- 很多没接触过现代编程的人最容易产生误解的地方
很多人以为的“用 AI 挂机跑一晚上”是:对着 ChatGPT 说一句话:“帮我把那个网站克隆下来”,然后电脑就自动开始动了——这在现实中是不存在的。因为网页端的大模型无法直接操控你的电脑桌面,它只能输出文字和代码。
真实发生的情况是:这个初学者在睡前的 1~2 个小时里,通过“多轮对话(Prompt Chaining)”,把 GPT 当作一个 24 小时随叫随到的高级程序员,一段一段地向它索要代码、把报错日志丢给它修改,最终把几个功能模块拼成一个完整的 .py 脚本,在本地终端里敲下运行回车,然后去睡觉。
为了让你彻底看清他是怎么做到的,下面我把他在睡前跟 GPT 对话的完整提示词(Prompt)过程、对话轮次、真实发生的调试细节,以及脚本挂机一整晚的底层运行逻辑,全景式地复原给你
第一阶段:他在睡前到底跟 GPT 说了什么?(核心对话全景复原)
整个过程不是一句话,而是分为极其典型的 5 到 6 轮精准提问。他用自然语言下达指令,GPT 则输出标准代码:
第一轮:分析目标网站结构(提取规则生成)
初学者对 GPT 说:
“我现在想抓取一个网站的文章。这是我用浏览器‘审查元素’复制下来的一篇详情页 HTML 代码片段:[此处粘贴了一大段包含标题、发布时间、正文和百度网盘下载框的 HTML 源码]。
请帮我用 Python 的 BeautifulSoup 或 CSS 选择器,写几行提取逻辑:分别把文章标题、正文文本、VIP 专享的网盘链接和提取码精准提取出来,存成一个字典。”
· GPT 的响应:分析了 HTML 的类名(Class Name)和标签结构,直接给出了 soup.select_one('.entry-title').text、soup.select('.download-box a') 等精准的提取代码。
第二轮:构建自动化抓取框架(解决登录与翻页)
初学者对 GPT 说:
“目标网站有分页,列表页是从 xxx.com 到 page/100。而且下载链接必须登录才能看。我已经在这个网站买了一个账号,在浏览器里拿到了 Cookie 字符串:[粘贴 Cookie]。
请用 Python 的 Playwright 异步库给我写一个完整的爬虫框架:
1. 自动带着我的 Cookie 访问每一页列表;
2. 从列表页提取所有文章的详情页 URL;
3. 自动遍历每一个详情页,用你刚才写的提取逻辑拿到数据;
4. 每抓完一篇,先保存到本地的 data.json 文件里,防止中间中断。”
· GPT 的响应:生成了一个标准的 Python 异步爬虫脚手架,包含了 browser_context.add_cookies() 和递归遍历 URL 列表的 async for 循环结构。
第三轮:在脚本中嵌入“GPT 自动洗稿与脱敏”中继(核心智能化)
这一步是整个项目最具杀伤力的地方。初学者让 GPT 在写爬虫脚本的同时,把调用大模型 API 的代码也写了进去。
初学者对 GPT 说:
“我现在有 OpenAI 的 API Key。我想在抓取到每一篇文章后,不直接保存,而是先调用大模型的接口对文章做一次处理,处理规则如下:
1. 把标题重新改写,风格要吸引人,适合做 SEO 搜索;
2. 把正文里所有出现的原作者名字、微信号、QQ群号、公众号全部删干净;
3. 把正文中的‘XX网创’替换成‘老张副业社’;
4. 把提取到的百度网盘链接保留,格式化输出为 JSON。
请帮我写一个 clean_content_with_gpt() 函数,无缝嵌入到刚才的爬虫流程中。”
· GPT 的响应:编写了调用 OpenAI API 的请求封装函数,将每篇爬下来的文章作为 Prompt 变量,让大模型在后台进行毫秒级的清洗与改写。
第四轮:报错排查与防崩溃机制(初学者的“救命稻草”)
初学者把前面几段代码拼在一起运行,终端立刻弹出红字报错(如网络超时、连接重置、某个页面缺少标签导致 NoneType error)。
初学者对 GPT 说:
“我运行脚本的时候报错了,终端显示:AttributeError: 'NoneType' object has no attribute 'text' at line 45,还有几篇报了 TimeoutError: Page crashed。
我怎么改才能让它遇到报错不中断退出?请帮我加上 try-except 异常捕获、自动重试 3 次机制,并且每次抓取之间加上 1 到 3 秒的随机等待,防止被对方封 IP。”
· GPT 的响应:将整个爬虫进行了工业级健壮性封装,加入了 tenacity 重试库、随机 asyncio.sleep(),以及将抓取失败的链接自动记录到 failed_urls.txt 的容错机制。
第五轮:自动化入库与发布(组装最终的 main.py)
初学者对 GPT 说:
“最后一步,我自己在宝塔面板搭了一个新的 WordPress 网站,开启了 REST API 功能。这是我的后台发布接口地址和 Application Password。
请写一个发布函数,把洗好的文章标题、正文、分类目录、自定义字段(网盘下载地址和密码),全自动通过 POST 请求发布到我的 WordPress 网站上。
最后,把以上所有代码整合进一个单一的 main.py 文件,我只需要在终端运行 python main.py 就能全自动跑。”
· GPT 的响应:输出了一套长达数百行的完整单文件自动化脚本。
第二阶段:他敲下回车后,这一晚上电脑里到底在发生什么?
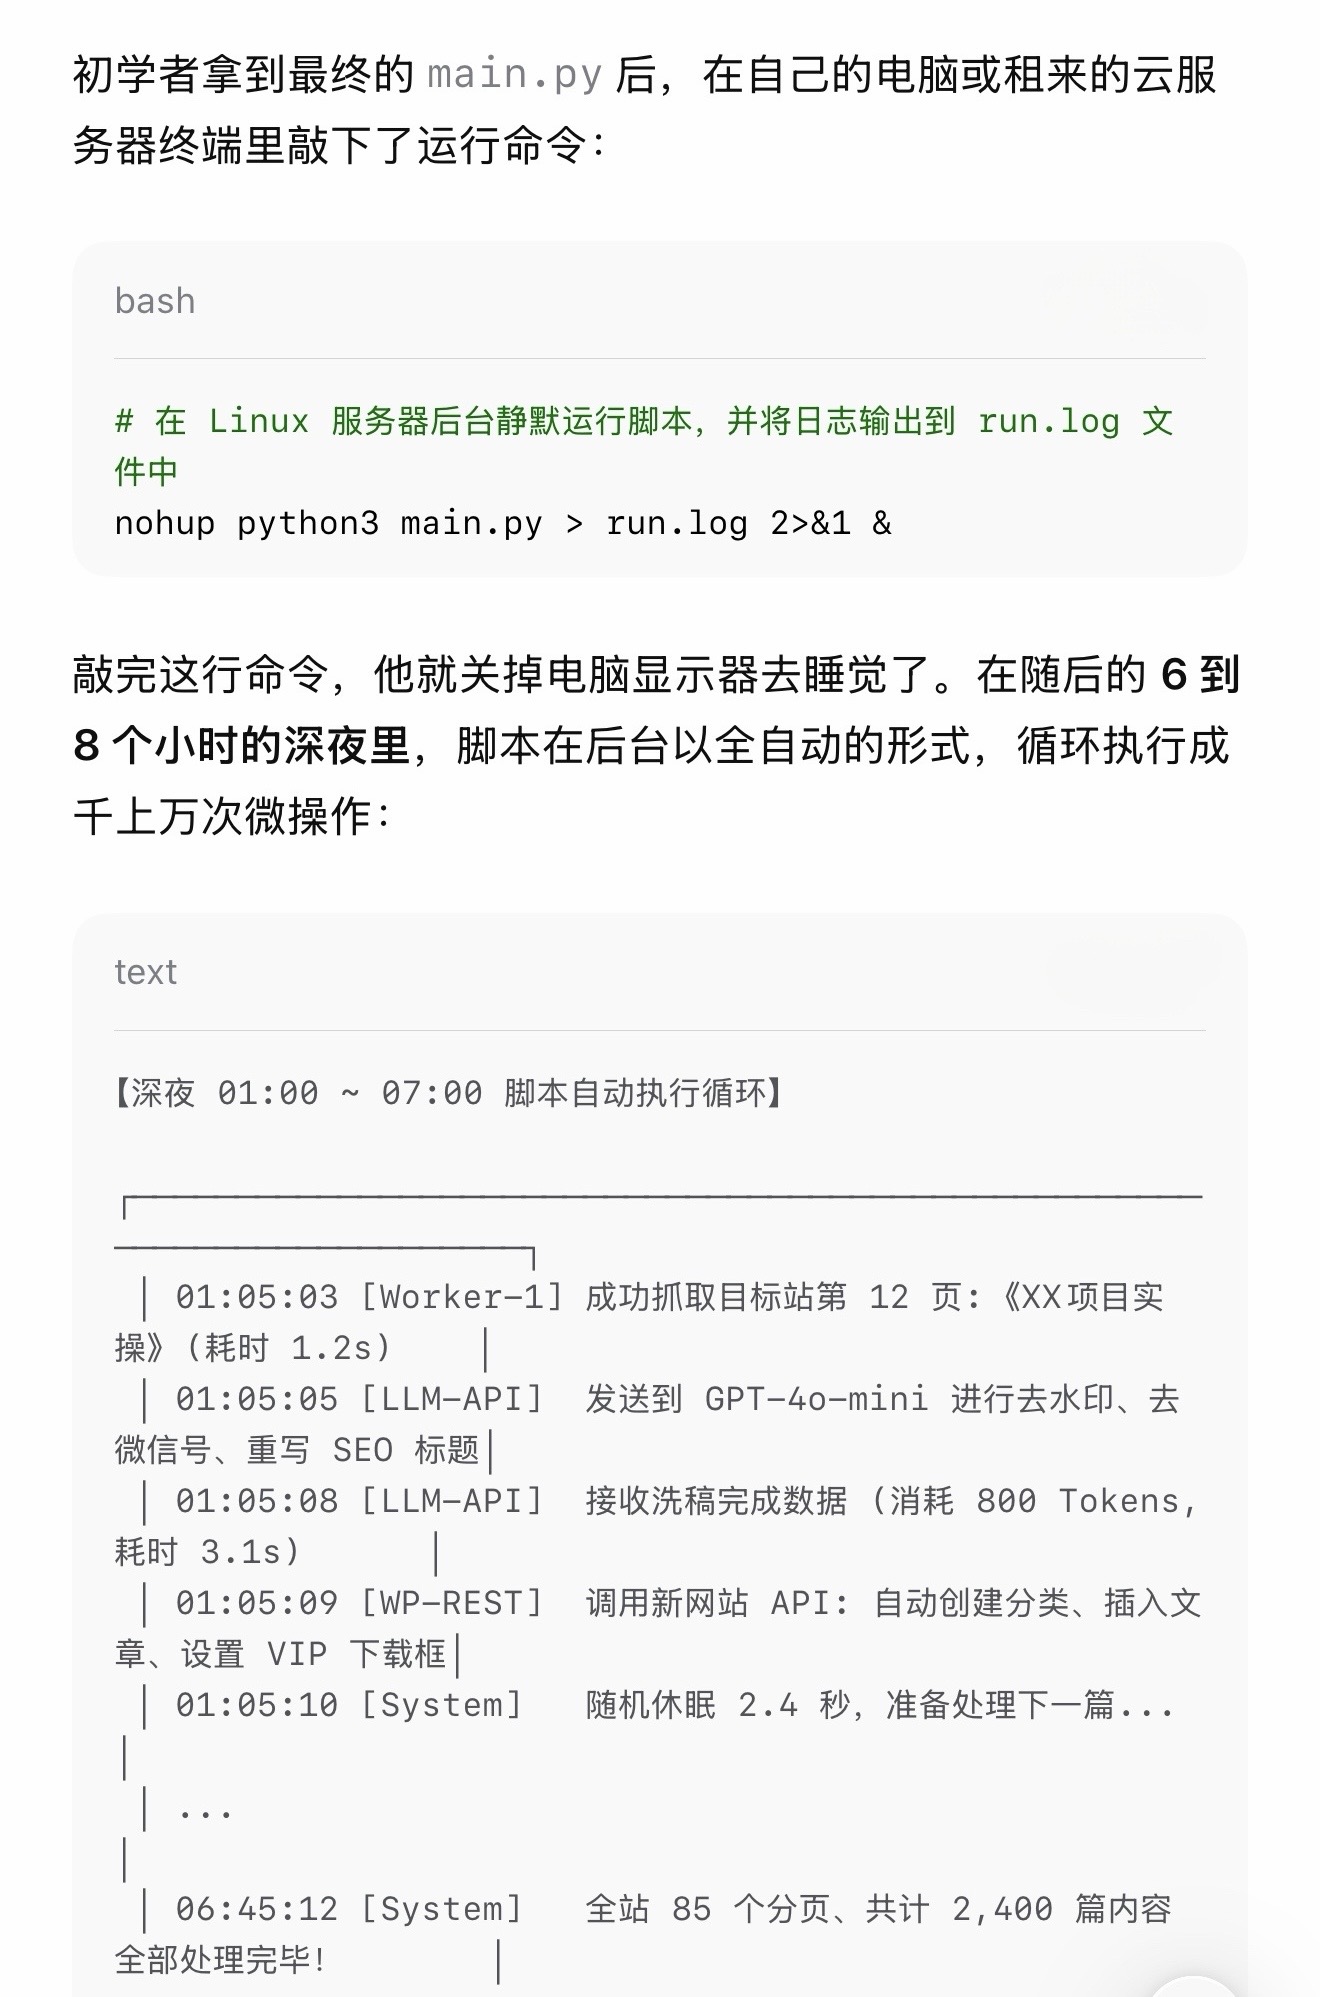
初学者拿到最终的 main.py 后,在自己的电脑或租来的云服务器终端里敲下了运行命令:
1. 无头浏览器在内存中静默穿梭:屏幕上没有任何画面,但内存里的 Chromium 正在一页一页地打开目标网站的列表,点击、翻页、解析 DOM 树,把文章正文、配图地址、百度网盘与夸克网盘链接一网打尽。
2. 多线程并发调用大模型:脚本抓取到数据后,通过 API 批量丢给大模型。大模型在云端充当流水线工人,每秒钟都在把抓来的文章剥离原作者信息、改写标题、生成摘要。
3. 数据源源不断注入新站:清洗好的数据通过 HTTP 请求直接打入新网站的数据库中。
4. 日志忠实记录:遇到个别死链或反爬拦截,脚本自动记录错误日志并跳过,绝不卡死。
第三阶段:为什么初学者能做到这一切?
在过去,完成这一整套操作需要:
· 扎实的 Python 编程能力;
· 熟练掌握前端 DOM 结构分析与抓包调试;
· 深刻理解 HTTP 协议与 RESTful API;
· 具备编写高并发、容错机制的架构思维。
但通过大模型的自然语言交互,技术实现的门槛被从“手写代码”降维成了“逻辑表达”:
· 这个初学者不需要知道每一行代码的具体语法,他只需要知道“整个业务流程应该分几步走”;
· 他只需要具备将大任务拆解为小指令的能力(先抓列表 → 再抓详情 → 送入清洗 → 写入数据库);
· 遇到任何报错,他只需要充当一个“日志搬运工”,把错误信息复制回给大模型,大模型就会给出修补补丁。
这就是这位初学者能靠着自然语言对话,在极短时间内拼装出一套高杀伤力的自动化采集与洗稿系统,并挂机运行一整晚的完整技术真相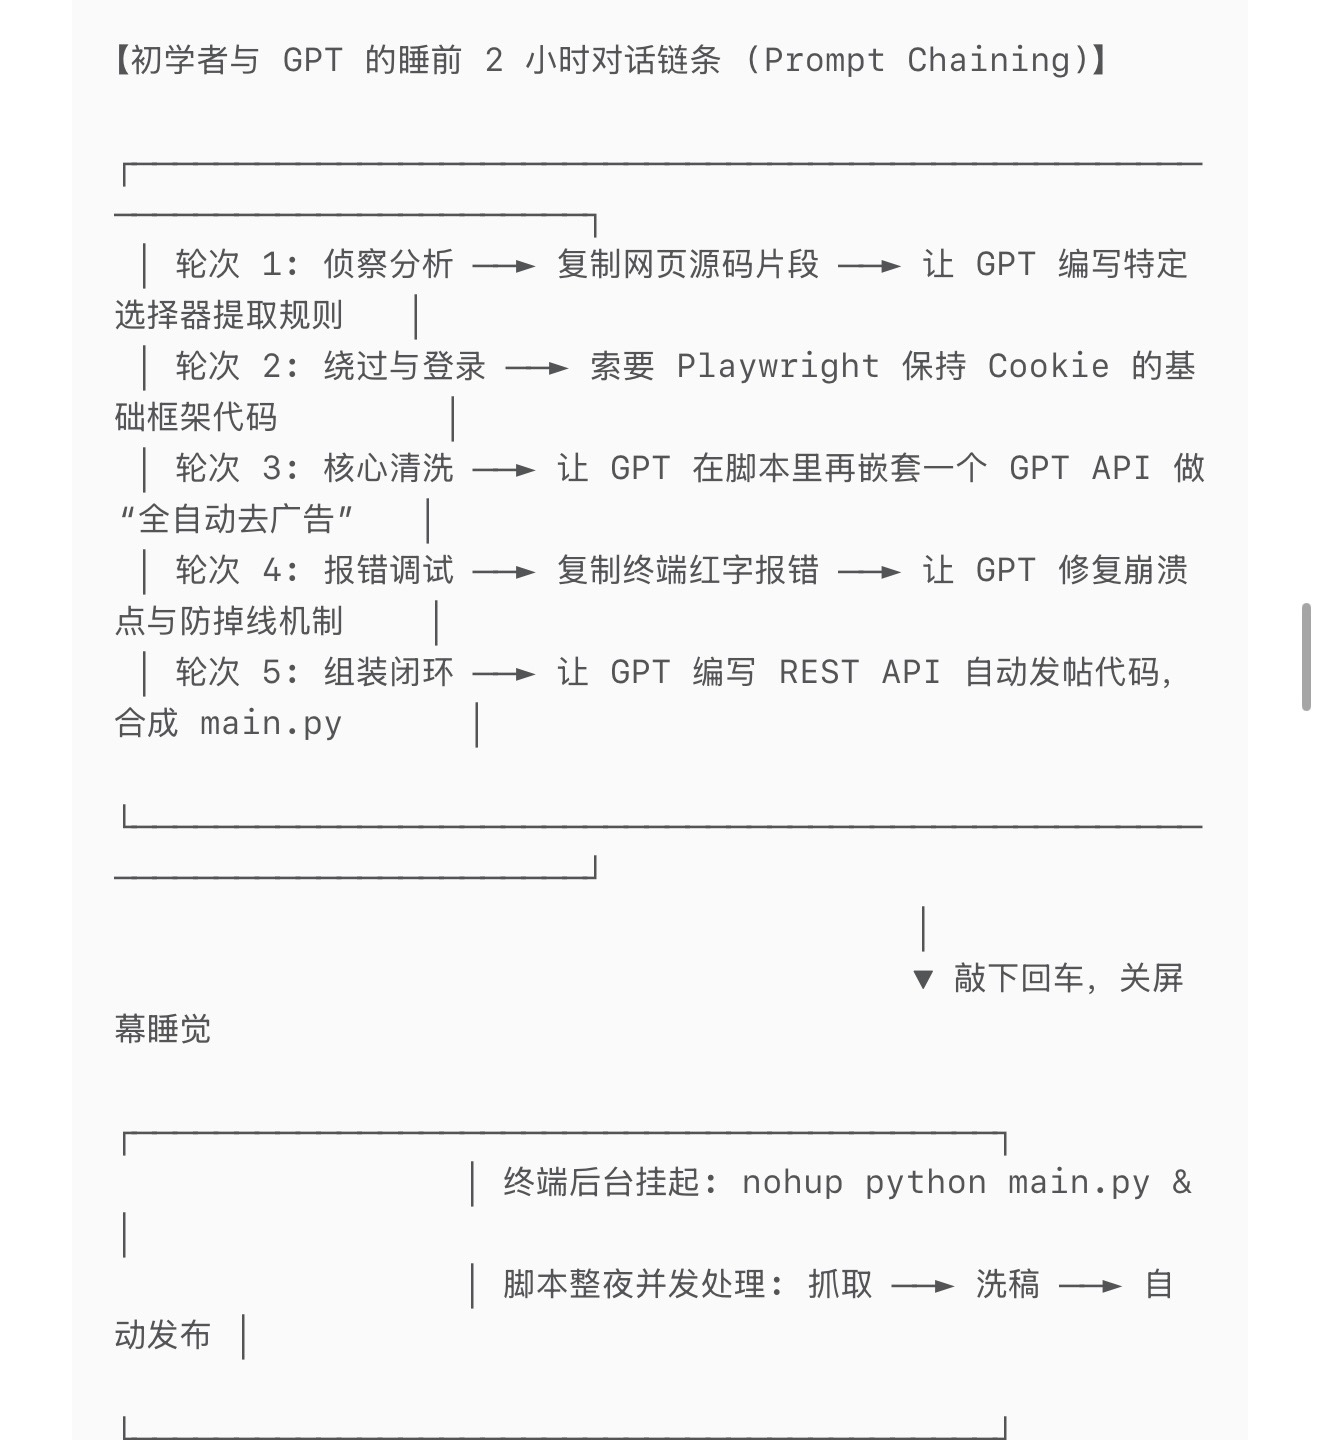
 7 14