即刻App年轻人的同好社区
下载
数据分析师的日常
数据唠嗑儿专用。致力于实现数据驱动,提升用户体验。
13855人已经加入
- 几乎所有数据相关岗位都收到 AI 的巨大冲击,资源投入也转向 AI 建设相关。
传统分析师需要转向 AI + 数据的复合型岗位,从过往的 bp 业务转到为 Agent 提供业务知识/Skill + 人 Agent 协作 bp 业务;传统数仓也从业务数据开发转向为 Agent 建设结构化数据知识(指标语义、数据集、表等);同时也会有专门负责数据 Agent 建设的横向组织出来。
所以 AI 应用能力是如今数据相关岗位的杠杆,能够带来更多机遇。培养 AI 应用能力需要了解 Agent 系统的几个部分:模型、Prompt 、Skill、知识库、Tool、记忆以及在执行链路(意图识别->规划推理->调用工具/Skill/知识检索->执行交付)中如何衔接,如何评估输出质量(评测机制)和改进输出(定位问题环节并优化)。
同时思路也需要从分析师的相对宏观视角落地,面向用户体验考虑产品(Agent 链路及输出本身)如何迭代优化;能力也需要从分析师拓展边界到产品、PMO 甚至是开发。
最重要就是好奇心和主观能动性,保持行业先进经验(优秀论文、大厂实践)的信息敏感度,同时也要需要“把手弄脏”——实际用 AI 去build。(很重要!空谈理论不做事会失去体感)1 00 - 数仓/数分的日常,要跑大量 SQL —— 验证数据准确性、调试任务稳定性
1. 少数 presto 任务秒级返回
2. 但大部分 spark 任务得花几分钟,多则几十分钟
这段时间大家在干嘛?我观察了自己,也问了几个同事:
1. Multitask:趁等待另起一个任务或 SQL。少数情况能像 CPU 一样高效切换,但大多数时候是做完后面忘了前面:诶,我刚干嘛要看这个数来着?
2. 干等:啥也不干,因为受够了 Multitask 时大脑的疲惫与无奈
如果说,睡眠是身体放松的最高形式,那么深度无聊则是精神放松的终极状态。一味的忙碌不会产生新事物。它只会重复或加速业已存在的事物
—— 《倦怠社会》韩炳哲倦怠社会里的数仓人
1 00 - 作为一个分析师,如果问我现在 AI 离真正“接管数据工作”还有多远,我会觉得,最大的瓶颈已经不完全是智力了,它越来越像一个可信度工程的问题。
AI 能不能完成查询、计算、写入数据?很多时候已经能。
AI 能不能连续正确地完成 100 次?开始变得困难。
第 73 次做错的时候,它自己知不知道?更困难。
而当它不知道自己错了的时候,系统能不能发现异常、拦住错误,不让一个“看起来正确”的结果进入正式产出?
这可能才是最后一公里。
像 lock、validator、state machine、golden baseline 这些东西,看起来只是我为了修一个 Excel 自动化逐渐接触到的工程概念,但它们背后其实都在解决同一个问题:
怎么把一个“很聪明但可能犯错的 Agent”,装进一个能够约束它、验证它,并尽可能阻止错误结果被正式交付的系统里。
说得更具体一点。
当你告诉 AI:“检查本周数据是否完整,然后更新 Excel。”它需要先理解“完整”是什么意思,再决定应该怎么做。
于是可能出现:
第一次:发现只有 6 天 → 停止。
第二次:发现只有 6 天 → 认为“虽然不完整,但也够分析” → 继续。
第三次:发现缺了一天 → 自己想办法补了一下 → 继续。
真正麻烦的是,后两种情况不一定会报错。
Agent 可能非常流畅地读取数据 → 做出判断 → 写入 Excel → 生成周报 → 告诉你“任务完成”。
整个流程看起来完全正常,但它其实在中间替你做了一个它本来没有资格做的判断。
传统程序当然也会产生静默错误,但 Agent 又增加了一层新的风险:
它可能理解错了、判断错了,却依然非常顺利地把整个任务执行完。
所以后来我发现,给自动化不断增加的那些检查,本质上都是在给 Agent 划定一些它没有资格自行判断的边界:
6 天够不够?——你不用判断,必须 7 天。
重复运行能不能再写?——你不用判断,唯一键不允许。
前一步失败还能不能继续?——你不用判断,状态机不允许。
两个任务能不能同时写 Excel?——你不用判断,lock 不允许。
这些规则不是为了让 AI 变得更聪明,而是为了让一些关键问题根本不需要 AI 发挥聪明。
能验证的自动验证,不能验证的明确暴露,有疑问的停止交付,而不是让错误安静地流到最后。9 11 - 6年数分,都是和公司同事一起做,分享下近一年做的几个有意思的分析项目抛砖引玉,有任何想法欢迎交流
https://gdhgptylld.feishu.cn/docx/DB7jdpLVpor8x1xPzVfcoYTWndb
2 00 - 睡了一小觉了中途惊醒,没再睡着,怀民亦未寝,记录一二
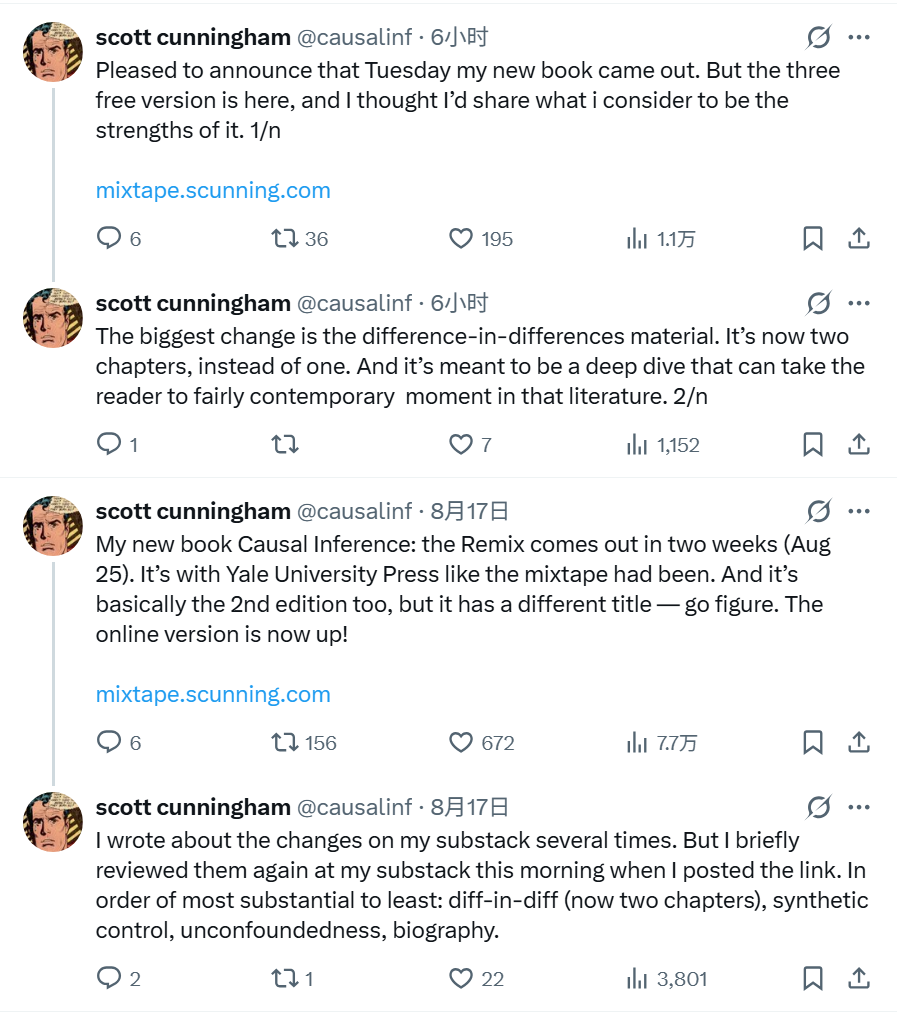
1.宇宙厂现在大多可以ab数据论证了,人也更螺丝钉化,数据分析和模型理解能力现在对单体要求也低了不少,仍在做corr分析,没怎么做casual impact
2.查内容冷启动badcase,一个半小时看了10条case,合作的算法3-2会直接问一线有什么总结的,一线大概2-1水平,我说他要是能做明白也就不需要和我开会了,找回了一些好久不做一线case分析的手感,定位了几大关键问题,指出了内容找人类算法的建议,圈定了早期人群的性别年龄地域目标比例,优化到我的直觉水位,评测先行。感受就是「魔鬼在细节」,实现没问题,但技术选型出了偏差,不仔细肯定发现不了
3.结构洞是新时代人才供需关系的核心6 00