即刻App年轻人的同好社区
下载
科技圈大小事
今天科技圈又发生了什么重要事件?订阅该主题就能知晓。
100万+人已经加入
- 给 JEV 简单做了一些实验,结论就是在一些需要快速响应和顾虑成本的场景下,可以作为 Router 来平衡性能和成本。
比如不同型号的模型×思考强度,甚至后续搭配不同 Harness 插件组合达到更好的效果也不是不行。
初步猜测可能是个小参数的 Encoder,输出内容只和分类任务相关,可以简单理解是对应选项的概率。
当前社区也有人用小参数模型做了个替代,见链接。
总之我感觉还是有一定潜力的,比较期待后续的技术报告。
另外,JEV 刚出第一天的时候就有人开吹我是真不明白是串子还是真不懂。
用这玩意儿做五子棋不就相当于微调 H3 声称自己是世界模型么😅。
不要总想搞个大新闻,一点点来。
https://huggingface.co/Contrastive-LM
14 11 - @SUKIII @永远怀念过去的高策 录 Today 这期,最让我欣慰的一刻,是高策说:模型越来越强,产品经理的价值反而越来越大。我说你早讲这个啊,不然我都快以为自己没活干了。
他现在最想找的人,也挺能说明问题:懂模型怎么工作,懂 Agent 的架构和执行框架,还得懂一点产品,能把这几件事放在一起设计。Personal Agent 要处理的是一个不断变化的人,光把模型接上、把上下文喂进去,离“懂你、替你办事”还差很远。
这期聊 Today,也聊了不少这中间的难题。277.从提醒你,到替你办:Today想把Personal AI带到哪一步?
乱翻书
35 22 - 最近和做 Personal AI 的Today 聊了聊,顺手给大家要来了 50 个6个月体验名额😎
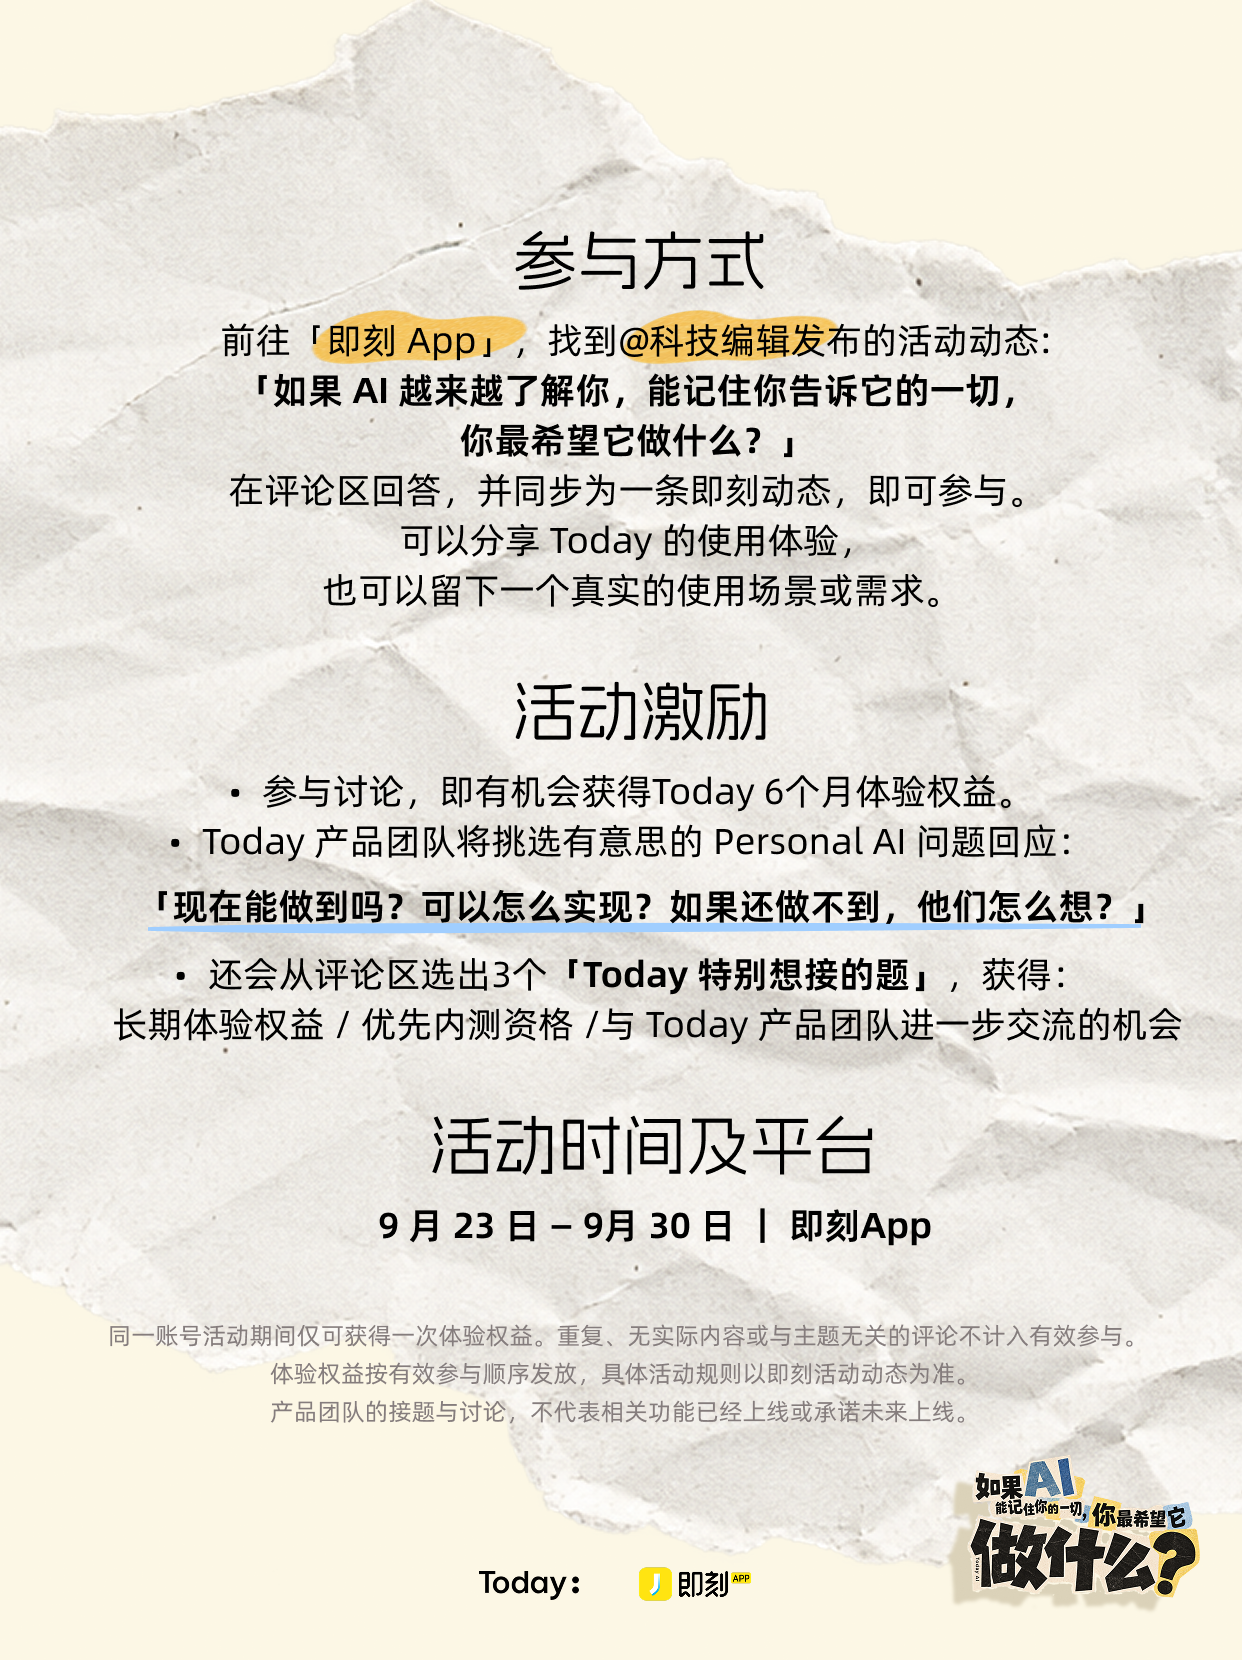
参与方式很简单,直接评论回答一个问题:
如果 AI 越来越了解你,能记住你告诉它的一切,你最希望它做什么?
在评论区留下答案,并勾选同步动态,就算参与成功
用过 Today 的可以聊聊真实体验,没用过也没关系,尽管提需求、开脑洞。
Today 的创始团队@SUKIII @永远怀念过去的高策 @Falcom_花卷 @Freyaisnice @不稳定朱 @江沉舟 @Sunhow @alansyn 也会来评论区逛逛,挑一些有意思的问题直接接题👇
现在能不能做、怎么做,或者为什么还做不到。
不用替他们考虑能不能实现,先提了再说😎
最后还会挑 3 个他们特别想接的题,送额外的长期体验 / 优先内测权益。
活动时间:即日起——9.30
具体玩法和活动规则可以看图👇
看看能不能问倒产品经理😎
 64 8671
- The Information:
- DeepSeek已经完成了70亿美金的B轮融资,估值达到750亿美金,成为中国身价最高的大模型厂商;
- 作为对比,智谱的市值差不多是400亿美金,MiniMax大概在120亿美金左右,Kimi递表期间的投前估值定在500亿美金;
- 这次的投资者内部交流会议吸取了上次泄露完整全文的教训,设置了极其严厉的保密措施,所以只有部分重点信息被带出来;
- DeeoSeek最新的年化收入达到10亿美金,是7月份的2倍,同期指标低于智谱的18亿美金,高于MiniMax的8亿美金;
- 梁文锋表示,DeepSeek的模型价格上调并没有影响客户使用,因为需求十分强劲,收入的增长也是通过涨价实现的,所以滑动变阻器不许指在男梁这个档位上,好吧最后一句是我加的;
- 但是创造更高收入并不是DeepSeek这家公司的首要目标,目前的算力分配是,70%投入到新模型的训练上,30%留给现有模型的业务调用;
- 梁文锋说在内部测试里,公司采购的游戏显卡能够负担部分日常运行的算力,这是一个用来缓解芯片短缺问题的暂时性手段,有助于把AI芯片留给新模型的训练上;
- 华为的训练用芯片最早将在今年第四季度开始给DeepSeek发货,国产替代会是DeepSeek解决卡量不足的唯一方法。37 43 - AI 办公的热闹还没散,下一个更大的战场已经露头:个人 Agent。
它不只替你写邮件、做表格,而是读懂你的关系、日程和偏好,替你订餐厅、约医生、处理账单,甚至替你打电话。Town、Instinct、Grok Bot、Meta Muse,正在把“聊天机器人”推向“你的数字分身”。
这意味着,超级 App、手机厂商、模型公司和创业公司,都要重新争夺一个问题:谁能成为用户真正的第一入口?
明晚跟@SUKIII @郦橙锦妖Vanessa @莫唯书Mark 一起直播聊聊,个人 Agent 真正的产品门槛是什么?美国这几个产品的区别又是什么?中国市场会怎么打这一仗?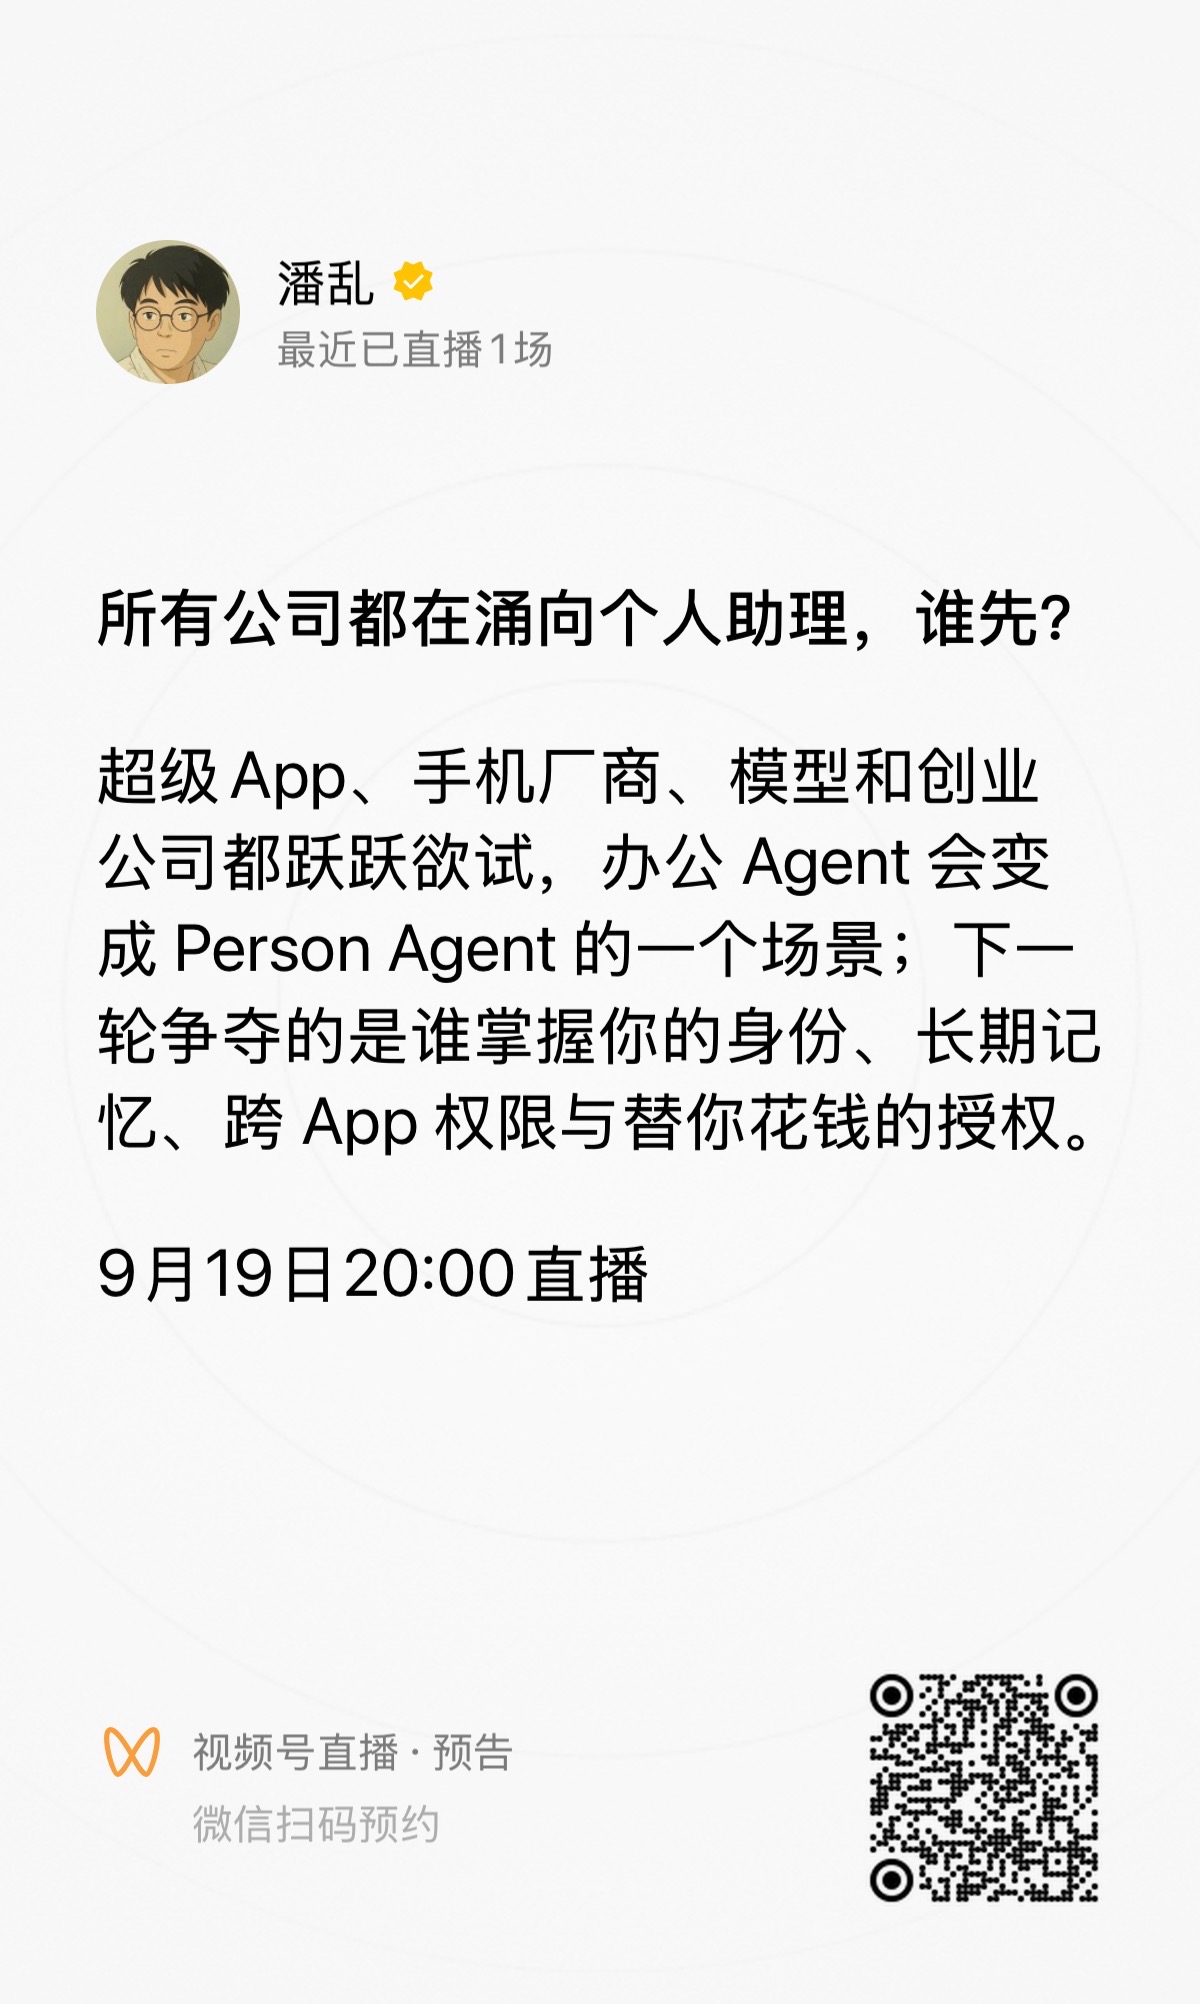 103 2730
- 很多人可能还没意识到,中国大模型其实已经进入了一段尴尬期。
什么叫尴尬期呢?
你如果养过猫,尤其是布偶这种猫,应该知道它从小长大的时候,会经历一段尴尬期。
旧毛掉了,新毛还没完全长出来,看起来多少有点别扭。
但再过一段时间,等新毛长齐了,漂亮的那个状态又会回来。
我觉得现在国内大模型差不多就是这个阶段,核心主要是有三个问题。
第一个,就是模型越训越大,但训练算力开始有点跟不上了。
现在大家都在往更大的模型走,5T、8T、10T 这种规模也开始被摆到台面上。
比如阿里在本次的云栖大会上提到,未来可能会训练 5T 到 10T 参数规模的模型。
Kimi、GLM 也都在继续往更大规模走。
但问题是,模型规模可以继续往上加,训练卡没有那么容易增加。
大家都知道 Scaling 还没有完全走到头,但在国内,算力确实已经越来越容易变成一个现实限制。
第二个是推理,或者说模型上线之后怎么稳定提供服务。
之前梁文锋在那个所谓流出的DeepSeek投资人会议纪要里也提到过,国内之前为什么很多 MoE 模型会把激活参数控制在几十 B,一个重要原因就是推理资源。
因为模型训出来是一回事,能不能长期、稳定、大规模地给用户用,是另外一回事。
虽然那个会议纪要出来之后,Kimi 也发了 K3 这种2.4T参数的模型,但这个问题还是没有被缓解。
一些新模型(就比如K3还有刚发的Step5Preview)刚上线的时候速度很好,但很快可能就会遇到限速、排队、额度收紧之类的情况。
这说明推理算力的问题其实还没有完全解决。
我们的团队们很难像 OpenAI 那样,时不时直接给用户 reset 一轮额度。
因为模型越大,每多放一点额度,背后都对应着真实的推理成本。
第三个,就是价格和定位的问题。
模型越做越大,推理成本越高,价格自然也很难一直维持在原来的水平。
但国内模型之前比较明显的两个优势,一个是开源,一个是性价比。
所以如果价格慢慢往上涨,就会出现一个新的问题:
如果价格差距越来越小,那用户为什么一定要选择国内模型?
尤其到了 Agent 时代,一次任务消耗的 Token 可能会比普通聊天高很多,价格会变得比以前更敏感。
最后很可能还是会回到一个很朴素的问题:效果差不多的情况下,谁便宜就用谁。
那就会有人选择赔本赚吆喝喽,当然我没有特指某些模型哈。
包括 DeepSeek 自己,其实也经历过价格调整。
所以我觉得,国内大模型现在确实处在一个比较微妙的阶段。
模型做大之后,推理算力又会成为新的限制。
推理成本上升之后,价格也需要调整,但价格一上去,又会影响原本的性价比优势。
有点像猫长大的尴尬期。
旧毛已经开始掉了,新毛还没有完全长出来。
接下来这段时间,得看国内厂商怎么把这几个问题一起解决掉(下一条我会聊这个)。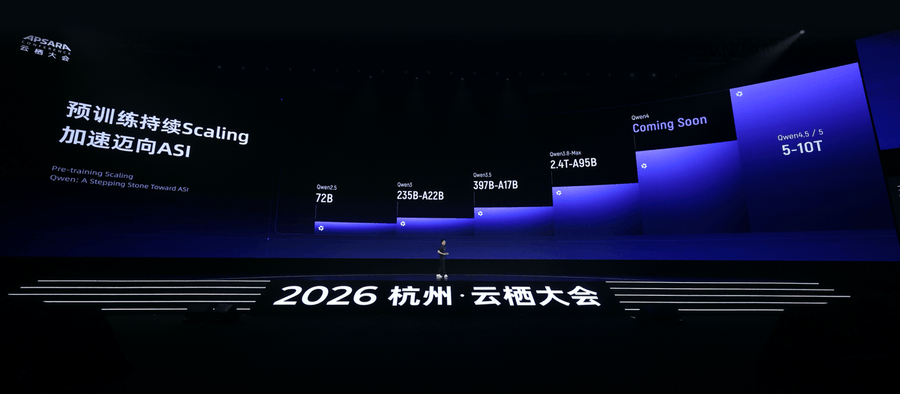 7 30