即刻App年轻人的同好社区
下载
Max_means_best
1k关注3k被关注3夸夸
数码科技领域优秀贡献者
海本辍学创业
前创业公司CMO、美元基金SR、模型厂小天才HR、Founder Park运营、AI PM
小红书Max For AI(4万粉
前创业公司CMO、美元基金SR、模型厂小天才HR、Founder Park运营、AI PM
小红书Max For AI(4万粉
 置顶
“我喜欢看到欣欣向荣的世界”
国内已经有很多创业者社群了,但 builder的社群比较少
有时候,不考虑盈利,纯粹做一个喜欢的事情也是挺不错的
————Hackathon Weekly 北京01场纪念
国内已经有很多创业者社群了,但 builder的社群比较少
有时候,不考虑盈利,纯粹做一个喜欢的事情也是挺不错的
————Hackathon Weekly 北京01场纪念


114 138
各位找工作的朋友们注意了⚠️
最近boss直聘上的nvidia应该会release一个岗位叫什么chief executive officer,这个岗年薪挺高的💰
据说工作氛围不好,上一位是个华人,被排挤辞职了😮💨
最近boss直聘上的nvidia应该会release一个岗位叫什么chief executive officer,这个岗年薪挺高的💰
据说工作氛围不好,上一位是个华人,被排挤辞职了😮💨
15 42

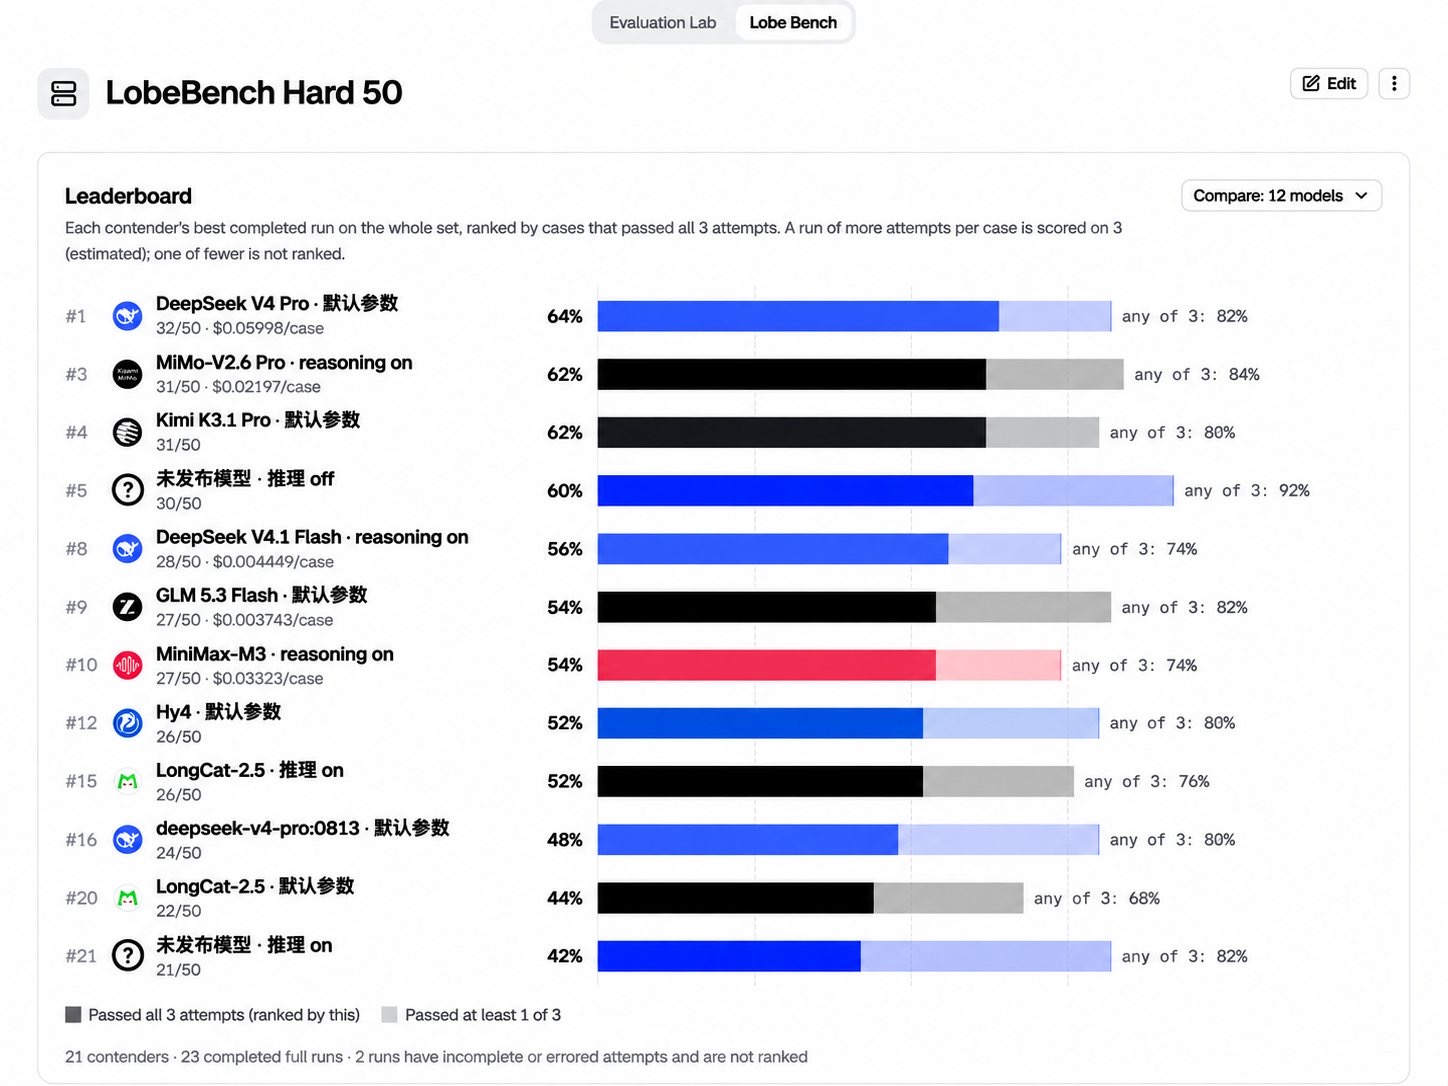
一款尚未发布的中国模型,在我们 @lobehub 的LobeBench Hard 50上进行了测试,成绩还挺有意思的。
这个模型最反直觉的地方是:关闭推理之后,表现反而大幅提升。
在关闭推理的情况下,它的三次全过率达到了60%,50道真实Agent任务中,有30道能够连续三次成功完成。
这个成绩排在当前榜单第5,距离第一名DeepSeek V4 Pro(64%)只差两道题,也超过了DeepSeek V4.1 Flash、GLM 5.3 Flash和MiniMax-M3。
更值得关注的是,它在50道题中,有46道至少成功完成过一次,覆盖率达到了92%,是这次展示的所有模型中最高的。
这说明它能够处理的任务范围相当广,但距离每次都能稳定完成,还有一定差距。
然后有意思的事情来了。
当我们打开推理模式后,它的三次全过率竟然从60%下降到了42%。
整整下降了18个百分点,相当于少做对了9道题。
至少成功一次的比例也从92%下降到了82%。
同一个模型,两种推理配置,居然产生了这么大的性能差异。
经过进一步分析具体的推理配置和Agent执行轨迹,我们发现原因是该款模型的工具调用存在一定概率的失败,这导致了Pass3的大部分错误。
但从目前的结果来看,这个未发布模型已经展现出相当不错的Agent任务处理能力,尤其是任务覆盖范围。
同时,这也提醒我们,模型在真实Agent场景中的表现,对推理模式、执行策略和稳定性都非常敏感。
至于具体是哪家公司的模型,暂时先卖个关子🤔
这个模型最反直觉的地方是:关闭推理之后,表现反而大幅提升。
在关闭推理的情况下,它的三次全过率达到了60%,50道真实Agent任务中,有30道能够连续三次成功完成。
这个成绩排在当前榜单第5,距离第一名DeepSeek V4 Pro(64%)只差两道题,也超过了DeepSeek V4.1 Flash、GLM 5.3 Flash和MiniMax-M3。
更值得关注的是,它在50道题中,有46道至少成功完成过一次,覆盖率达到了92%,是这次展示的所有模型中最高的。
这说明它能够处理的任务范围相当广,但距离每次都能稳定完成,还有一定差距。
然后有意思的事情来了。
当我们打开推理模式后,它的三次全过率竟然从60%下降到了42%。
整整下降了18个百分点,相当于少做对了9道题。
至少成功一次的比例也从92%下降到了82%。
同一个模型,两种推理配置,居然产生了这么大的性能差异。
经过进一步分析具体的推理配置和Agent执行轨迹,我们发现原因是该款模型的工具调用存在一定概率的失败,这导致了Pass3的大部分错误。
但从目前的结果来看,这个未发布模型已经展现出相当不错的Agent任务处理能力,尤其是任务覆盖范围。
同时,这也提醒我们,模型在真实Agent场景中的表现,对推理模式、执行策略和稳定性都非常敏感。
至于具体是哪家公司的模型,暂时先卖个关子🤔
6 10
好消息!苹果天气说十天后是世界末日!!
大半个中国都是-32度😁
起初大家没有在意....
我重生了,重生在极寒末世的前9天,上一世我在出租屋里活活冻死,这一事我一定要提前做好准备,修建避难所,囤好物资,努力活下去
大半个中国都是-32度😁
起初大家没有在意....
我重生了,重生在极寒末世的前9天,上一世我在出租屋里活活冻死,这一事我一定要提前做好准备,修建避难所,囤好物资,努力活下去

13 10
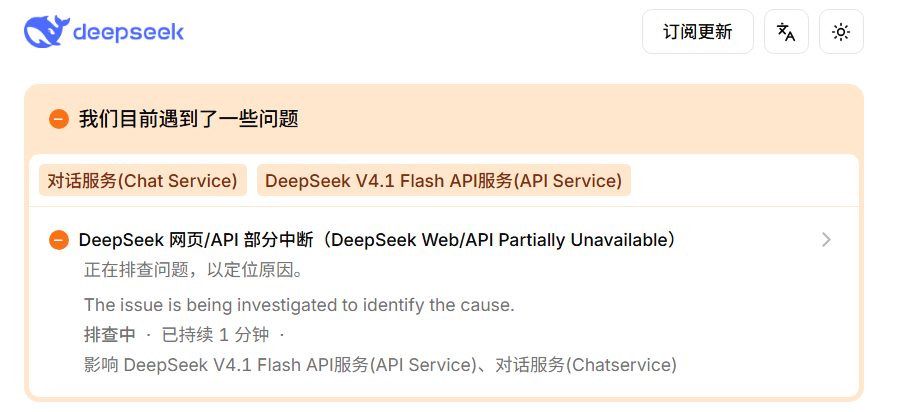
PS:Qwen朋友表示:他又知道了,我都不知道🤣
Max_means_best: 信这种消息的可以留一下联系方式,我介绍朋友的agent卖你保健品
2 00