即刻App年轻人的同好社区
下载
“语言即世界”,或许只是人类的一种自大。
这一轮 AI 的成功,很大程度上得益于 LLM 的突破。而语言,本身就是人类使用了上千年的思考工具。
维特根斯坦说过:
我语言的边界意味着我的世界的极限。
我们使用语言来思考和描述世界,但能够被描述的世界,并不一定就是世界本身。
处于马车时代的人无法想象今天的汽车,农民也只能想象皇帝耕地一定用的金锄头吧。
我们对未知的想象,很难真正逃离已经知道的东西,今天的 LLM 也面临类似的问题。它们学习了几乎所有人类的知识,越来越擅长回答已知的问题。
但如果答案根本还不存在呢?
这个时候,“生成一个看起来合理的答案”其实没有太大意义。
最近读了
@Apodex_AI
及其创始人
@tianqiao_chen
发布的论文和观点,里面抛出的核心问题非常深刻:
怎么让 AI 在一个答案尚未知、过程也尚未定义的现实问题里,持续行动、得到反馈、验证自己、修正自己,最后得到一个值得相信的结论?
过去我们使用AI,是人给 Prompt , AI 在已有 Context 中寻找答案。
但做未知领域的研究发现,我们需要另一套逻辑,让 AI 可以调用工具、运行代码、搜索证据、提出假设,再根据实验或环境返回的新信息不断修正自己的判断。
基于这个思路,Apodex 做了一个叫 TRACES 的 “Benchmark”。
把 Model、Tools、Memory、Harness 和 Agent Loop 放在一起,形成一个完整的 Solver System,基于此作为新的评估基准。
T (Tools):有没有选对并用对工具?
R (Repair):遇到错误后能否自主修复?
A (Alternatives):是否评估了其他可能的假设?
C (Coherence):长路径探索中逻辑能否保持一致?
E (Evidence):结论是否有真实证据支撑?
S (Scope):是否清晰界定了结论的边界与局限?
在此模式下,AI 获得的 Context 不再仅依赖初始 Prompt,是在与环境的持续交互中动态涌现。评估视角也随之改变:比起单次输出的“答案正确与否”,系统更关注这个答案“究竟是如何被推演和验证出来的”。TRACES 重点评估的是探索未知答案的逻辑严密度。
论文开头用 Apollo 登月做类比,十分精辟: 真正让人类登上月球的,不只是几个天才工程师,而是一整套围绕目标建立起来的工具、系统、反馈与持续纠错机制。
面对复杂未知,单纯的语言智能固然重要,但让智能沿着可靠路径持续自我迭代的系统,才是未来。
这一轮 AI 的成功,很大程度上得益于 LLM 的突破。而语言,本身就是人类使用了上千年的思考工具。
维特根斯坦说过:
我语言的边界意味着我的世界的极限。
我们使用语言来思考和描述世界,但能够被描述的世界,并不一定就是世界本身。
处于马车时代的人无法想象今天的汽车,农民也只能想象皇帝耕地一定用的金锄头吧。
我们对未知的想象,很难真正逃离已经知道的东西,今天的 LLM 也面临类似的问题。它们学习了几乎所有人类的知识,越来越擅长回答已知的问题。
但如果答案根本还不存在呢?
这个时候,“生成一个看起来合理的答案”其实没有太大意义。
最近读了
@Apodex_AI
及其创始人
@tianqiao_chen
发布的论文和观点,里面抛出的核心问题非常深刻:
怎么让 AI 在一个答案尚未知、过程也尚未定义的现实问题里,持续行动、得到反馈、验证自己、修正自己,最后得到一个值得相信的结论?
过去我们使用AI,是人给 Prompt , AI 在已有 Context 中寻找答案。
但做未知领域的研究发现,我们需要另一套逻辑,让 AI 可以调用工具、运行代码、搜索证据、提出假设,再根据实验或环境返回的新信息不断修正自己的判断。
基于这个思路,Apodex 做了一个叫 TRACES 的 “Benchmark”。
把 Model、Tools、Memory、Harness 和 Agent Loop 放在一起,形成一个完整的 Solver System,基于此作为新的评估基准。
T (Tools):有没有选对并用对工具?
R (Repair):遇到错误后能否自主修复?
A (Alternatives):是否评估了其他可能的假设?
C (Coherence):长路径探索中逻辑能否保持一致?
E (Evidence):结论是否有真实证据支撑?
S (Scope):是否清晰界定了结论的边界与局限?
在此模式下,AI 获得的 Context 不再仅依赖初始 Prompt,是在与环境的持续交互中动态涌现。评估视角也随之改变:比起单次输出的“答案正确与否”,系统更关注这个答案“究竟是如何被推演和验证出来的”。TRACES 重点评估的是探索未知答案的逻辑严密度。
论文开头用 Apollo 登月做类比,十分精辟: 真正让人类登上月球的,不只是几个天才工程师,而是一整套围绕目标建立起来的工具、系统、反馈与持续纠错机制。
面对复杂未知,单纯的语言智能固然重要,但让智能沿着可靠路径持续自我迭代的系统,才是未来。
2 10
Minimax H3 你的结果是入局!
从H3发布到现在,目前视频生成的效果估计 Minimax 自己没有想到吧,股票都跟着涨了一轮。
这得益于社区内各路大佬、组织的二次优化。
当一个模型出厂可能仅 70 分,由于开源开放,全世界的开发者都能参与进来,完全可以帮它做到 90 分。
我发现有很多这类模式的成功产品:
Obsidian 的第三方插件、Comfyui 的第三方节点、包括现在火爆的 Omarchy 等等 ,都有自发的第三方开发者,自愿为爱发电。
回到大模型领域,各厂开源“大“模型,不如开源“小”模型,能让一些家用级别的设备也能参与进来,反而可能会促进自己下一代模型的进步。
开源 100 T 的模型,约等于没有开源。
从H3发布到现在,目前视频生成的效果估计 Minimax 自己没有想到吧,股票都跟着涨了一轮。
这得益于社区内各路大佬、组织的二次优化。
当一个模型出厂可能仅 70 分,由于开源开放,全世界的开发者都能参与进来,完全可以帮它做到 90 分。
我发现有很多这类模式的成功产品:
Obsidian 的第三方插件、Comfyui 的第三方节点、包括现在火爆的 Omarchy 等等 ,都有自发的第三方开发者,自愿为爱发电。
回到大模型领域,各厂开源“大“模型,不如开源“小”模型,能让一些家用级别的设备也能参与进来,反而可能会促进自己下一代模型的进步。
开源 100 T 的模型,约等于没有开源。
1 00
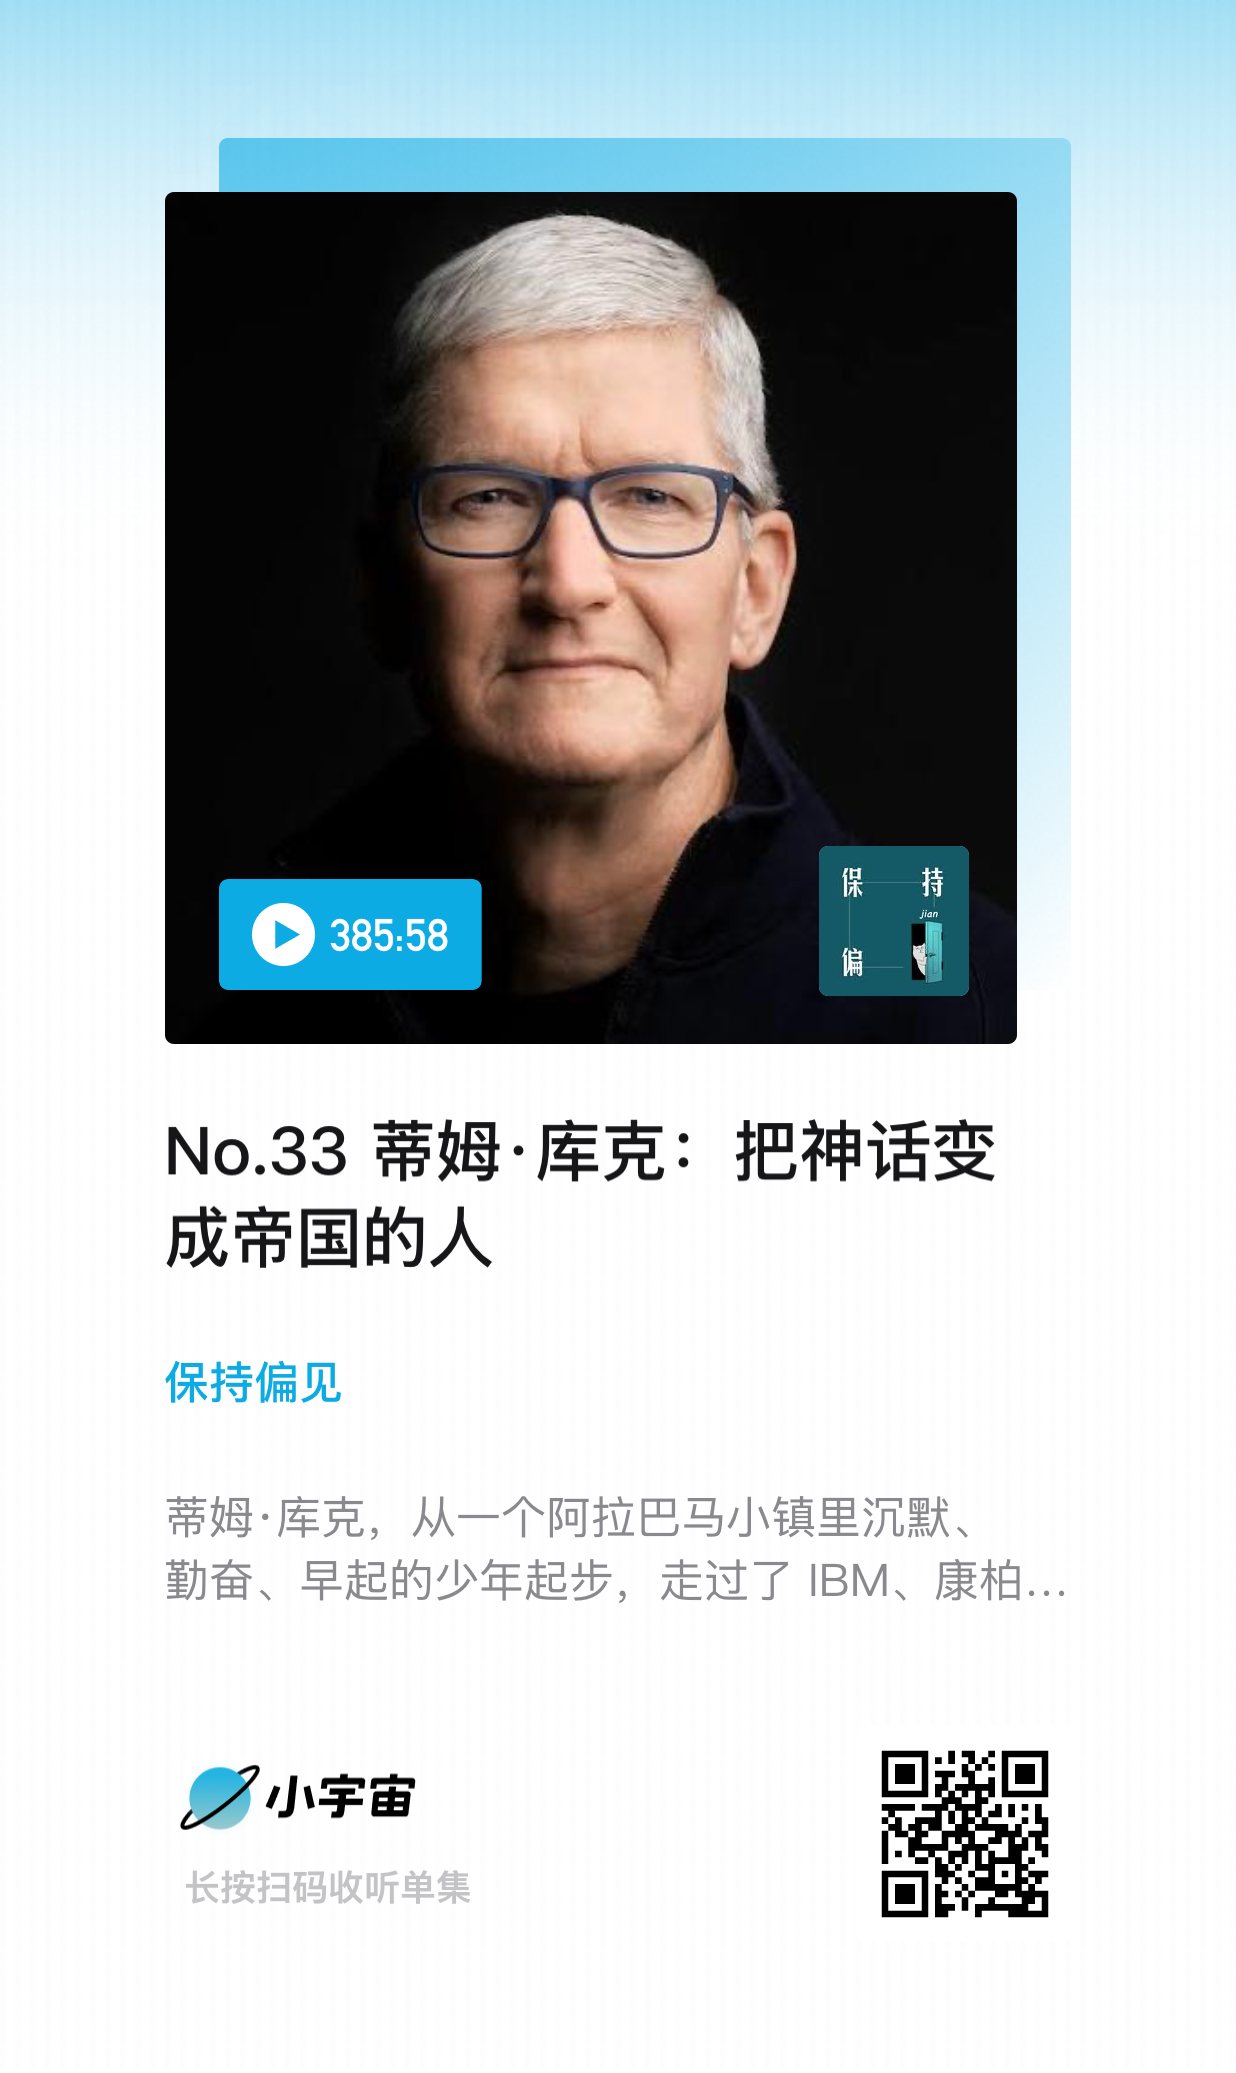
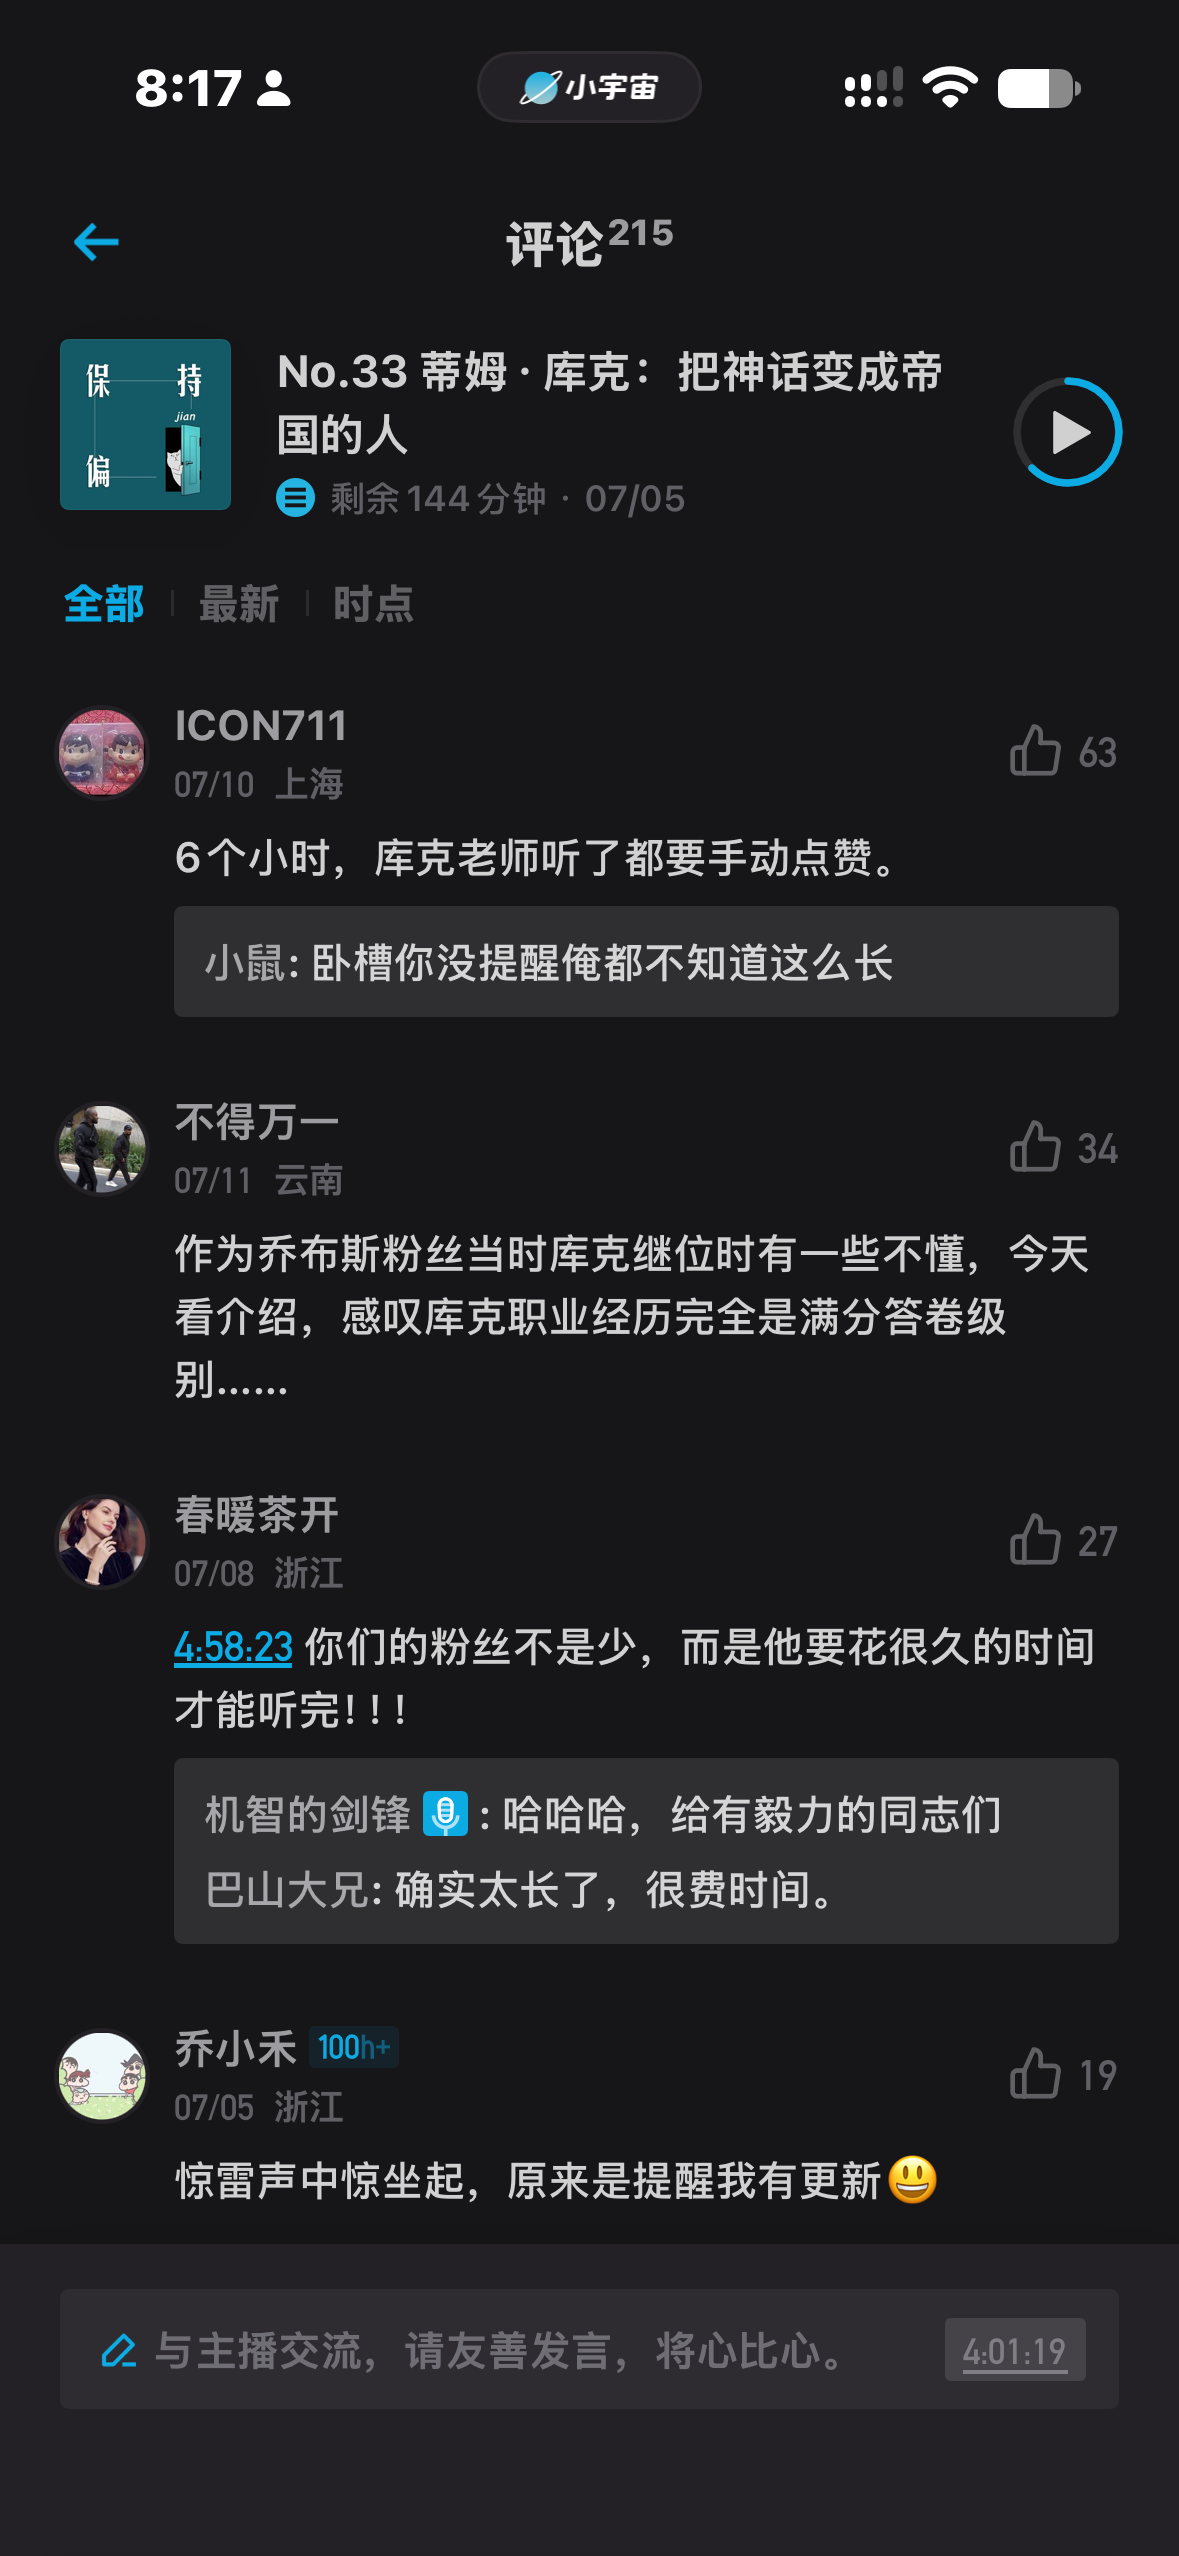
“6个小时,库克听了都要手动点赞 ”
推荐一个名为 [保持偏见] 频道的播客,
从 9 个小时雷军那期入坑的。
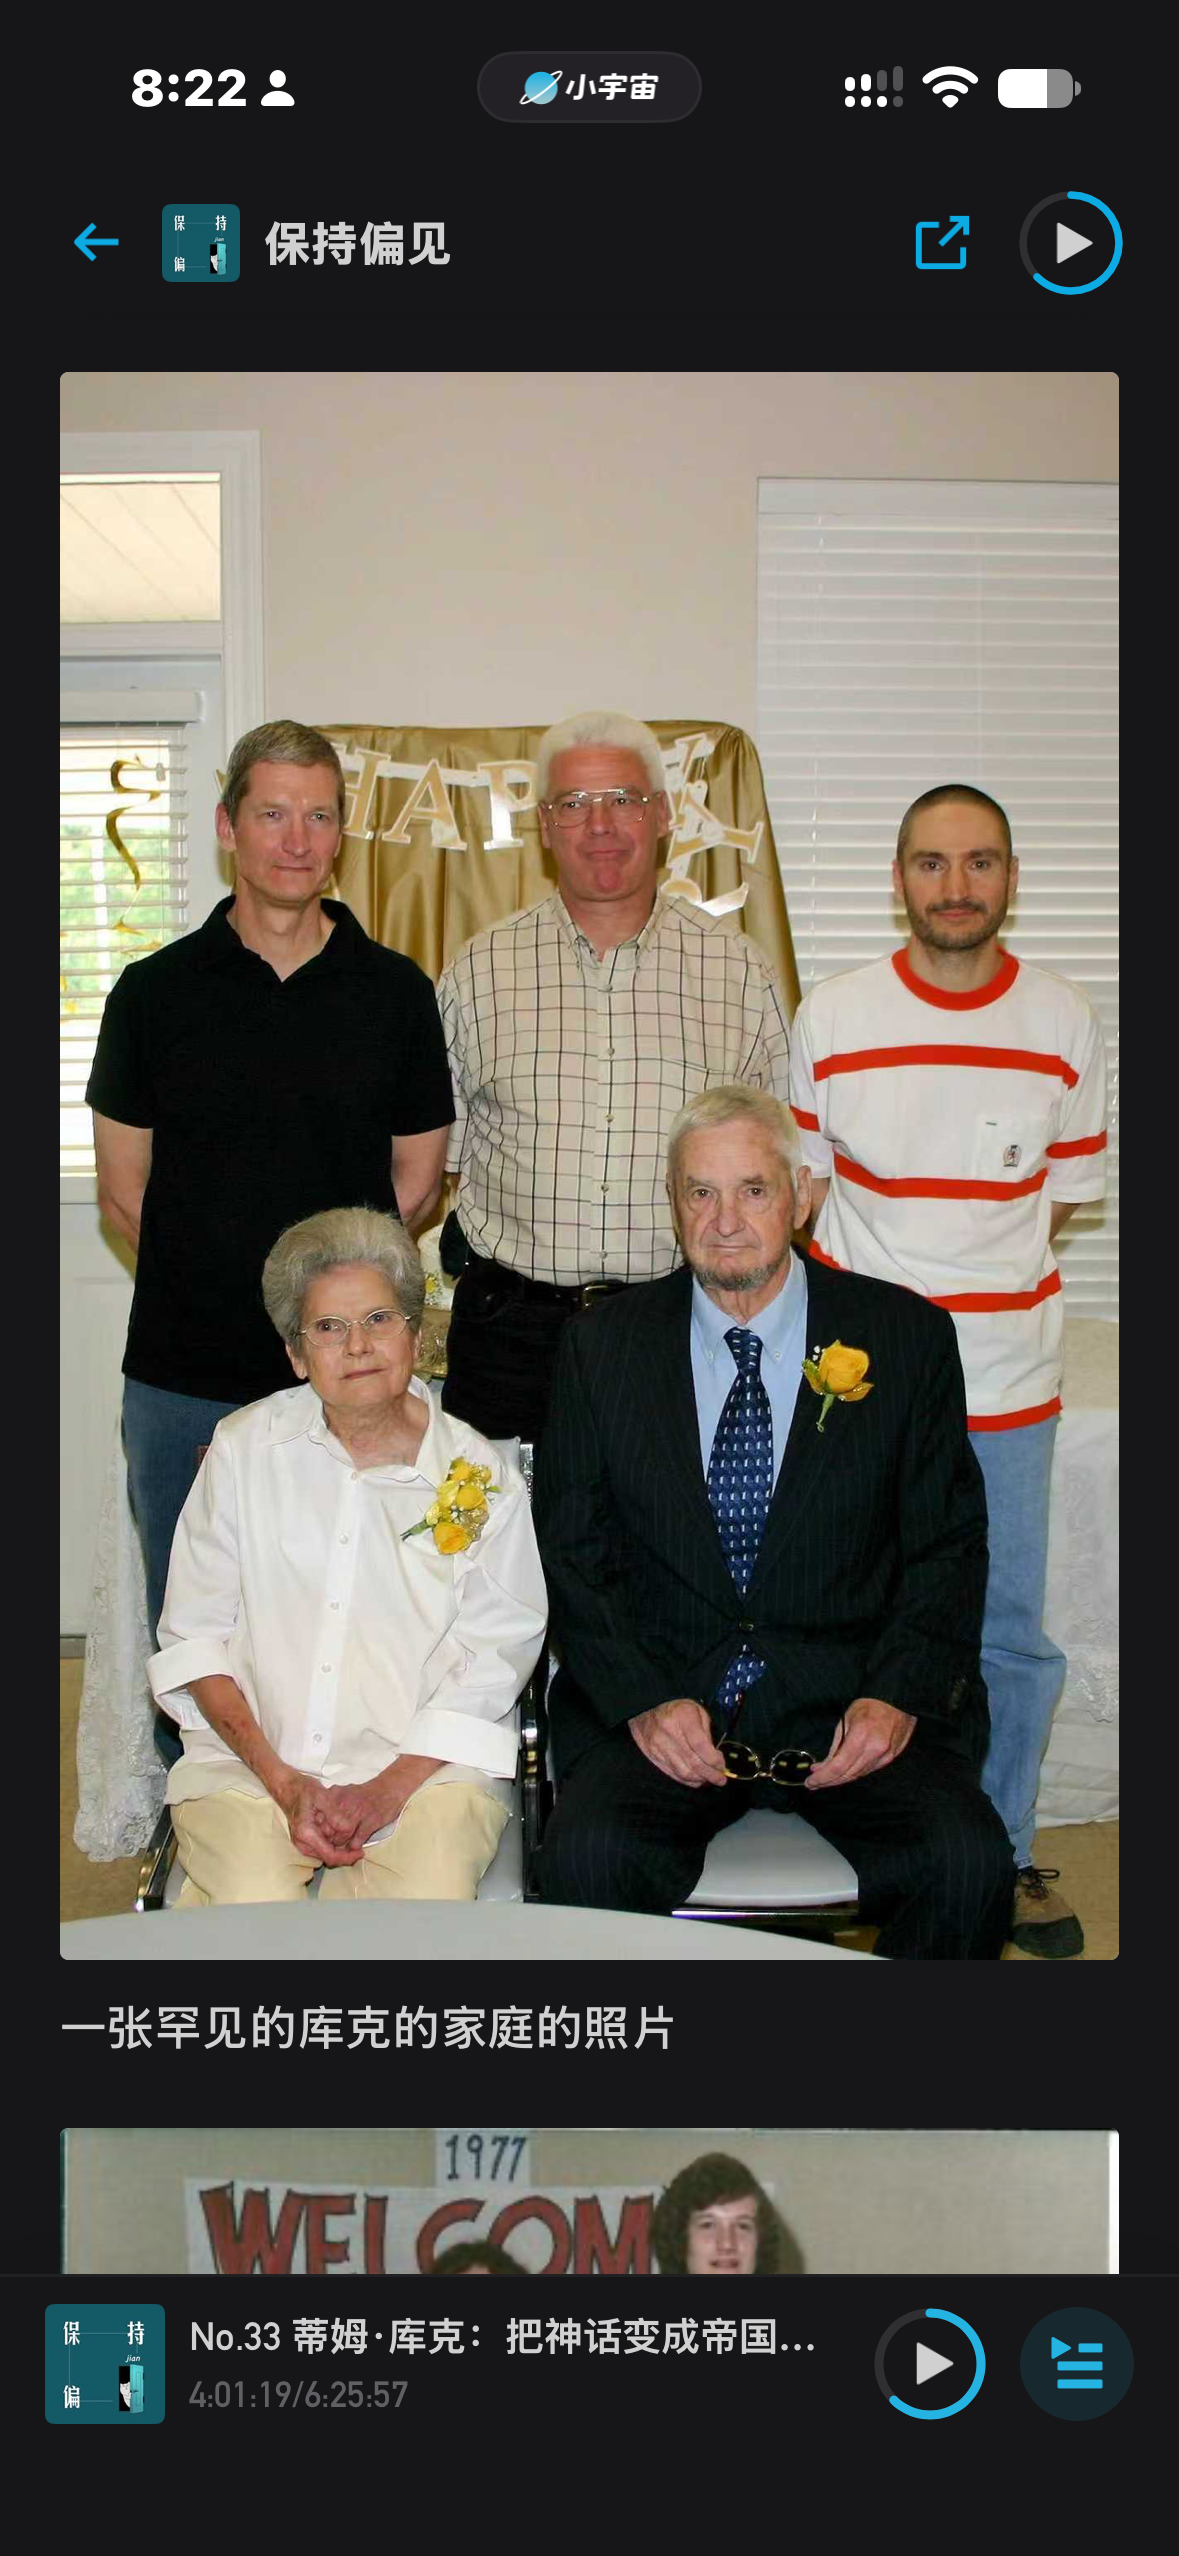
这次借由 Apple 换届之际听了库克的个人故事,很多不知道的细节让我对其有了新认知,他的成就不输乔布斯。
推荐一个名为 [保持偏见] 频道的播客,
从 9 个小时雷军那期入坑的。
这次借由 Apple 换届之际听了库克的个人故事,很多不知道的细节让我对其有了新认知,他的成就不输乔布斯。
5 10
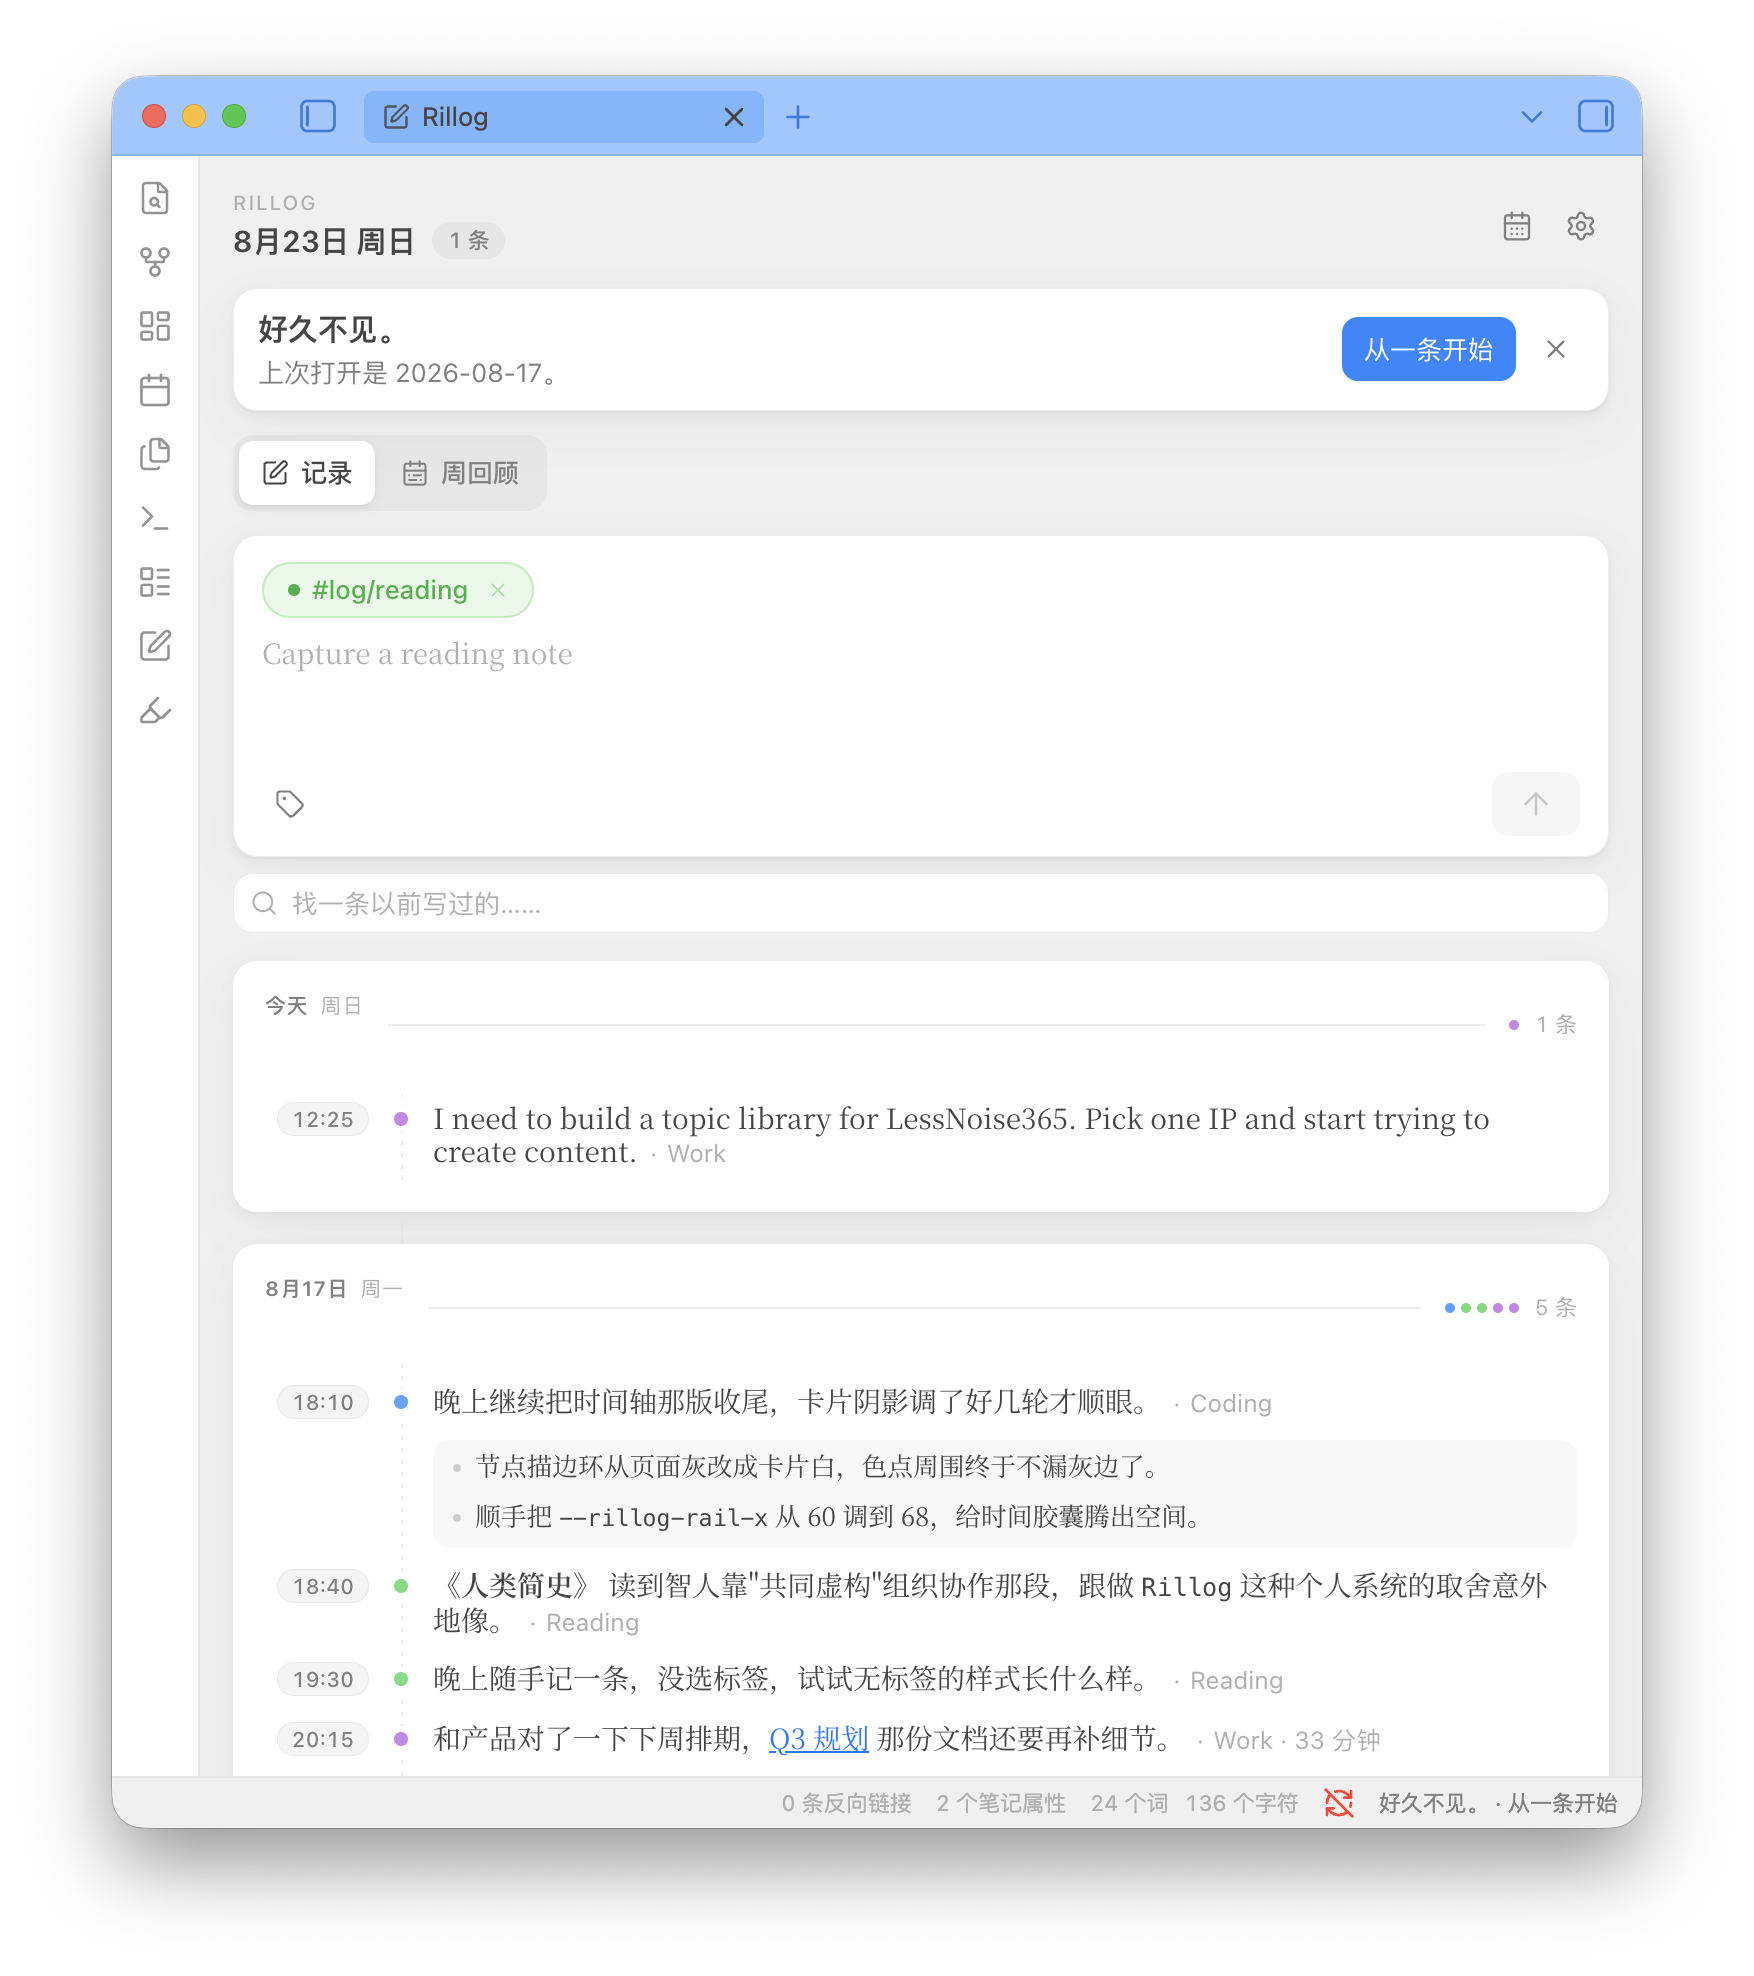
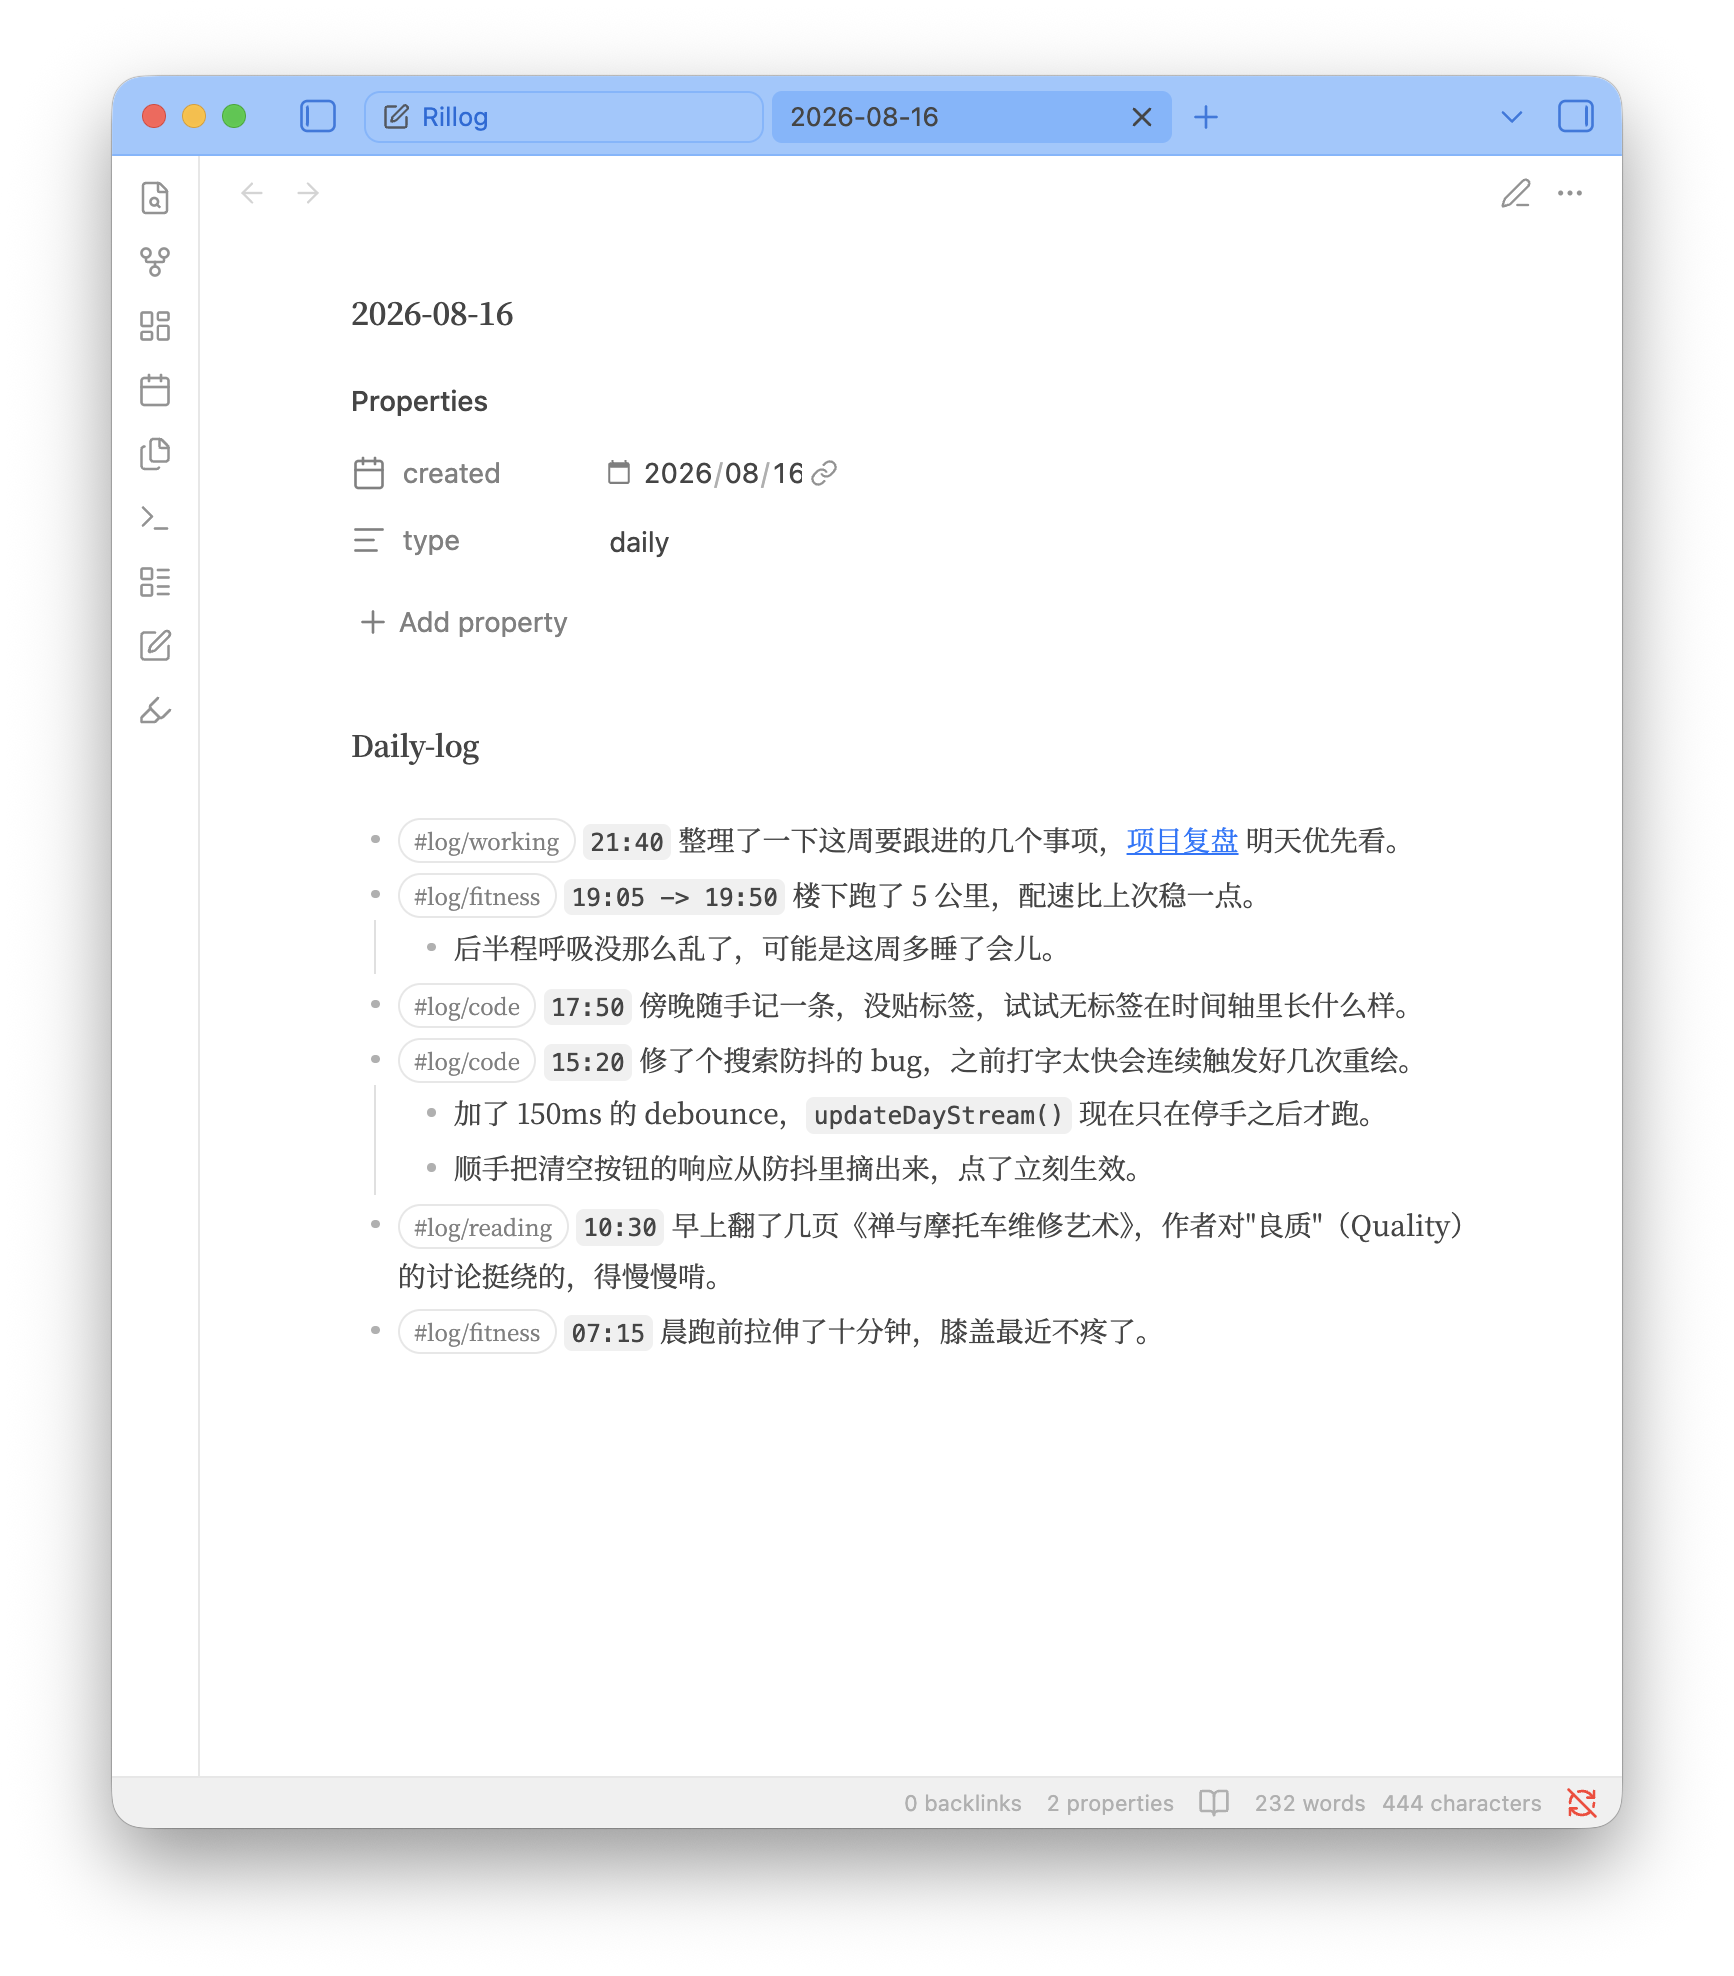
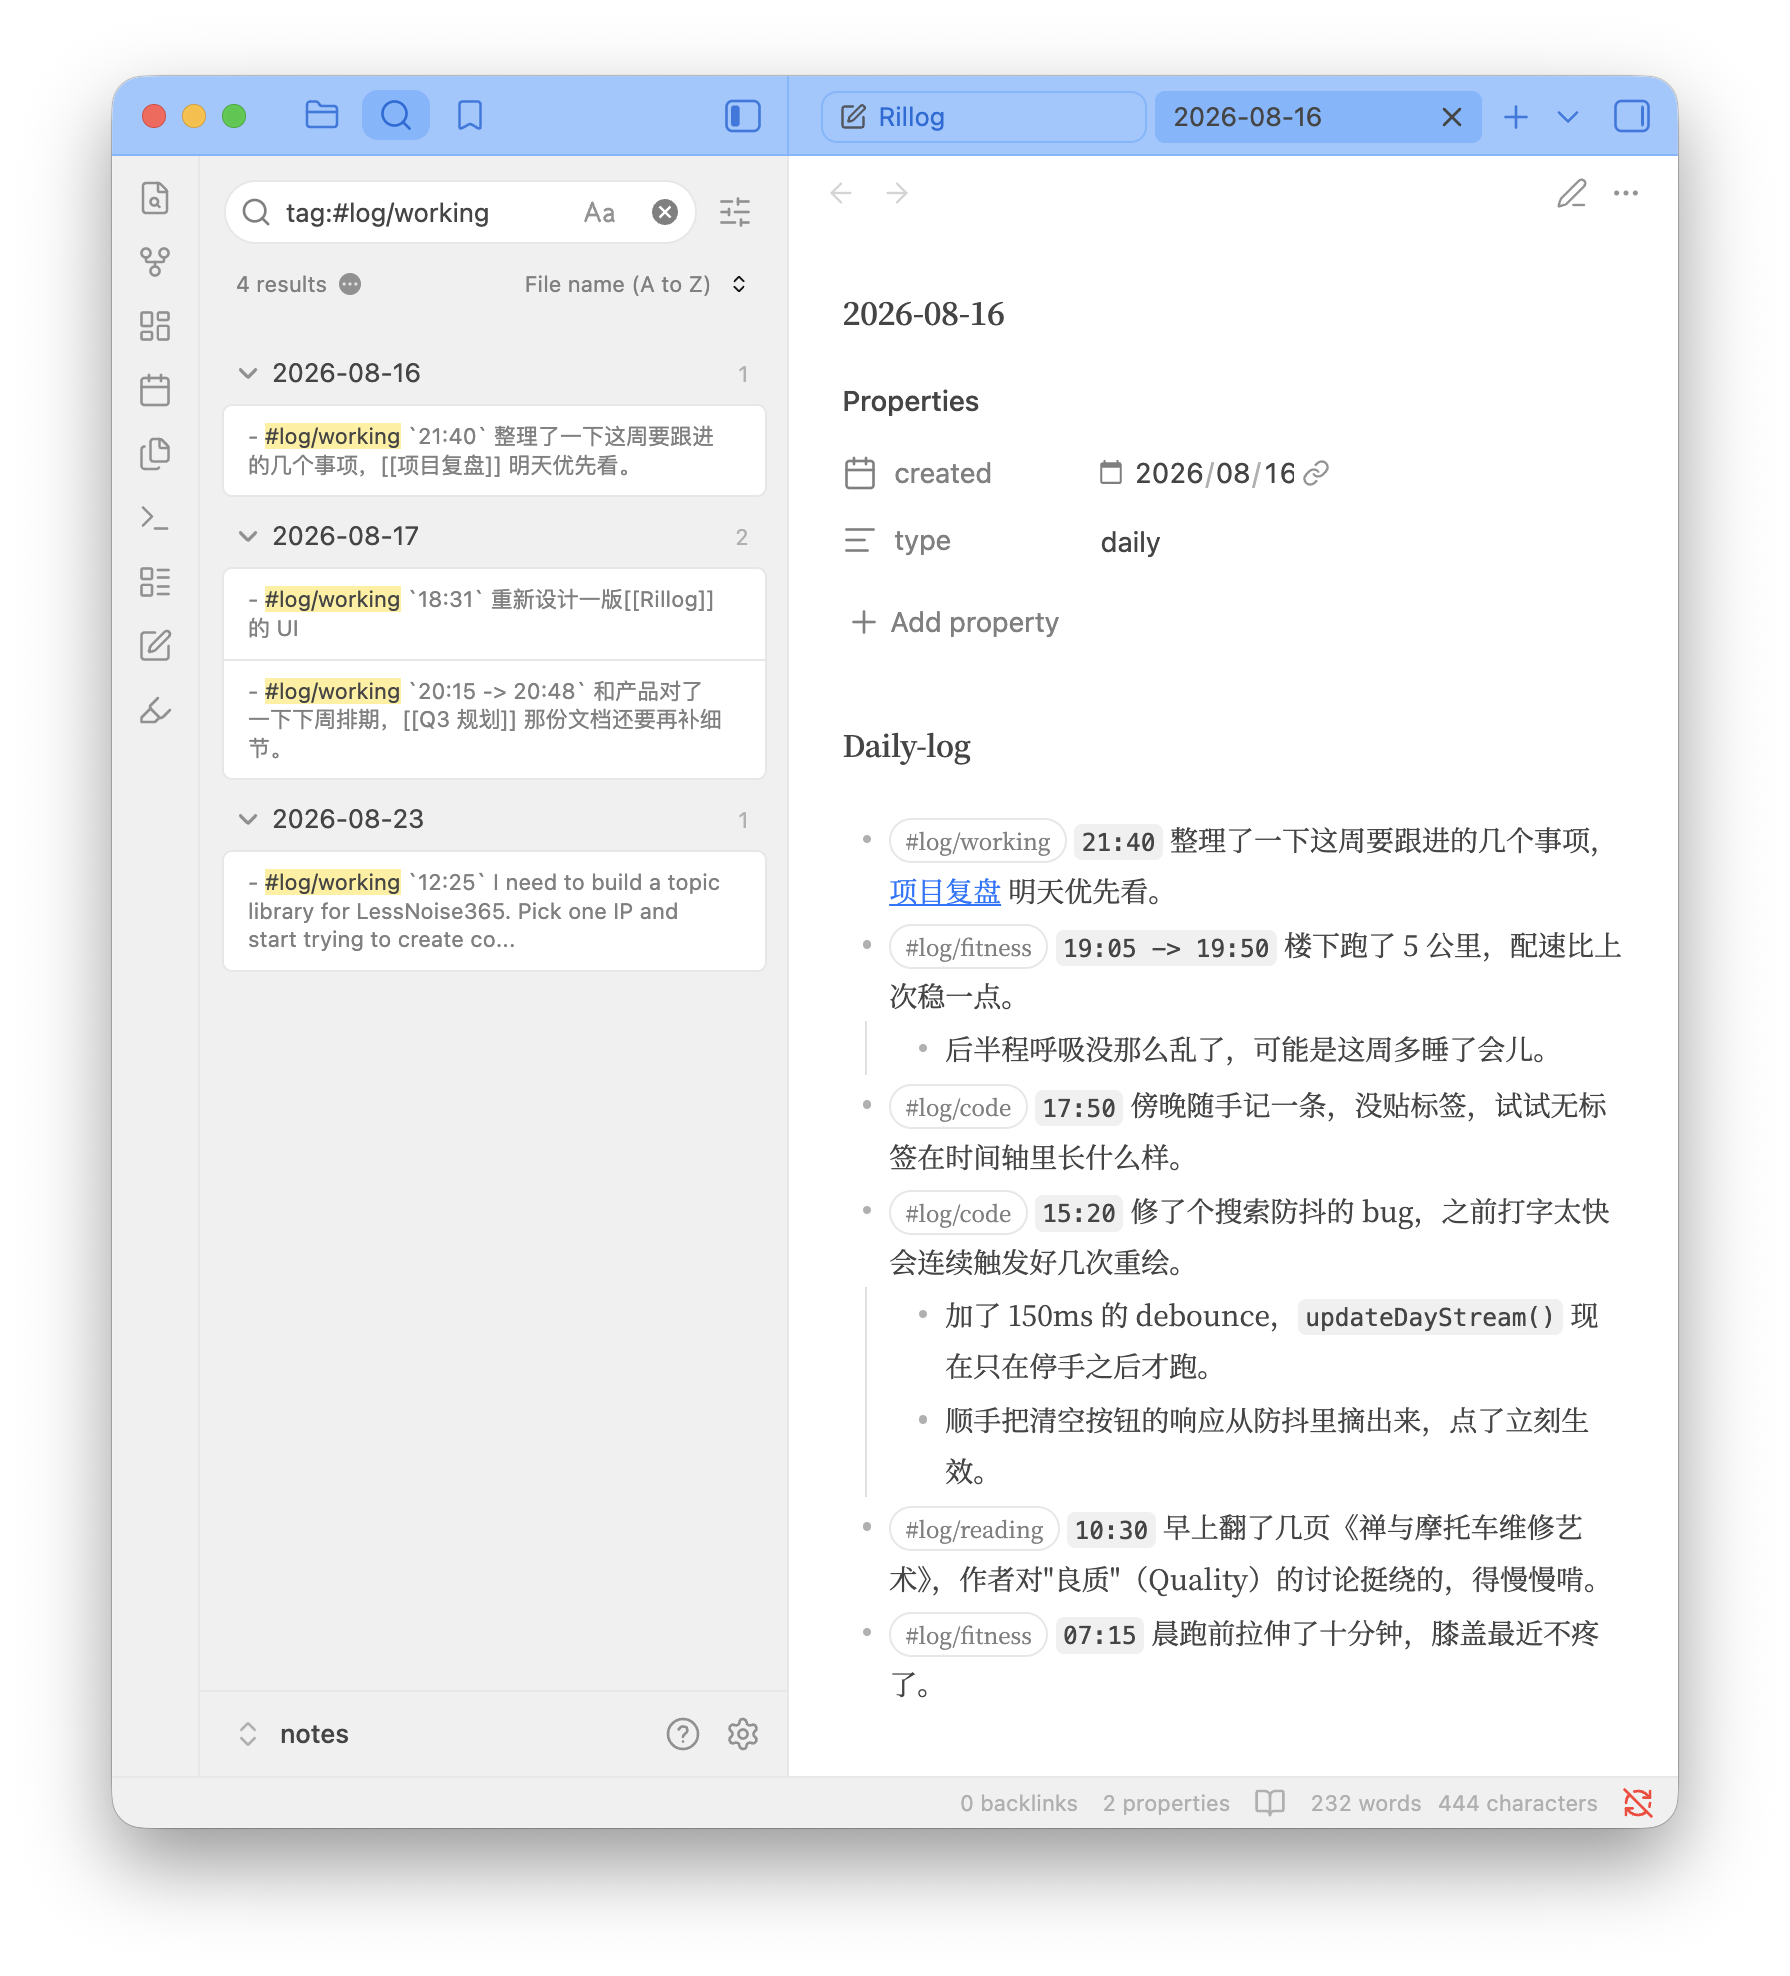
一种新的 Obsidian 记录方式。
我发现很多人用 Obsidian 时,会有一种写作的压力,导致不能建立好的记录习惯。
在新建一条笔记时,面对整篇空白的页面,常常不知道如何下笔,不仅需要想标题,同时如果只写下少量的几个字,又会觉得这篇笔记不够分量。
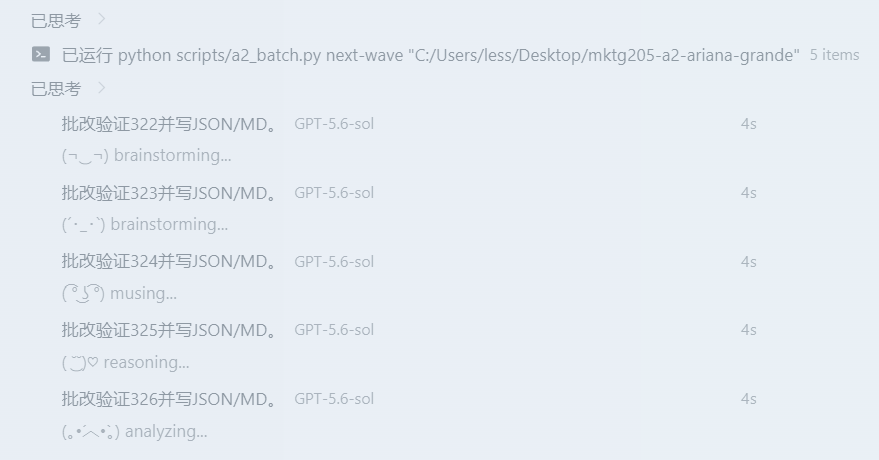
最近结合 Obsidian 的特性,用 AI 搓了一个插件,作为日常记录的主要入口,减少输入压力,想到什么直接写,同时会在原始笔记页面留下明文的 Markdown 记录,不破坏 MD 格式的情况下,又可以有很多延伸查询和玩法。
目前还在测试,全程都是我指挥 AI 干活,测试完了就会发布了。
我发现很多人用 Obsidian 时,会有一种写作的压力,导致不能建立好的记录习惯。
在新建一条笔记时,面对整篇空白的页面,常常不知道如何下笔,不仅需要想标题,同时如果只写下少量的几个字,又会觉得这篇笔记不够分量。
最近结合 Obsidian 的特性,用 AI 搓了一个插件,作为日常记录的主要入口,减少输入压力,想到什么直接写,同时会在原始笔记页面留下明文的 Markdown 记录,不破坏 MD 格式的情况下,又可以有很多延伸查询和玩法。
目前还在测试,全程都是我指挥 AI 干活,测试完了就会发布了。
7 20