即刻App年轻人的同好社区
下载
 置顶
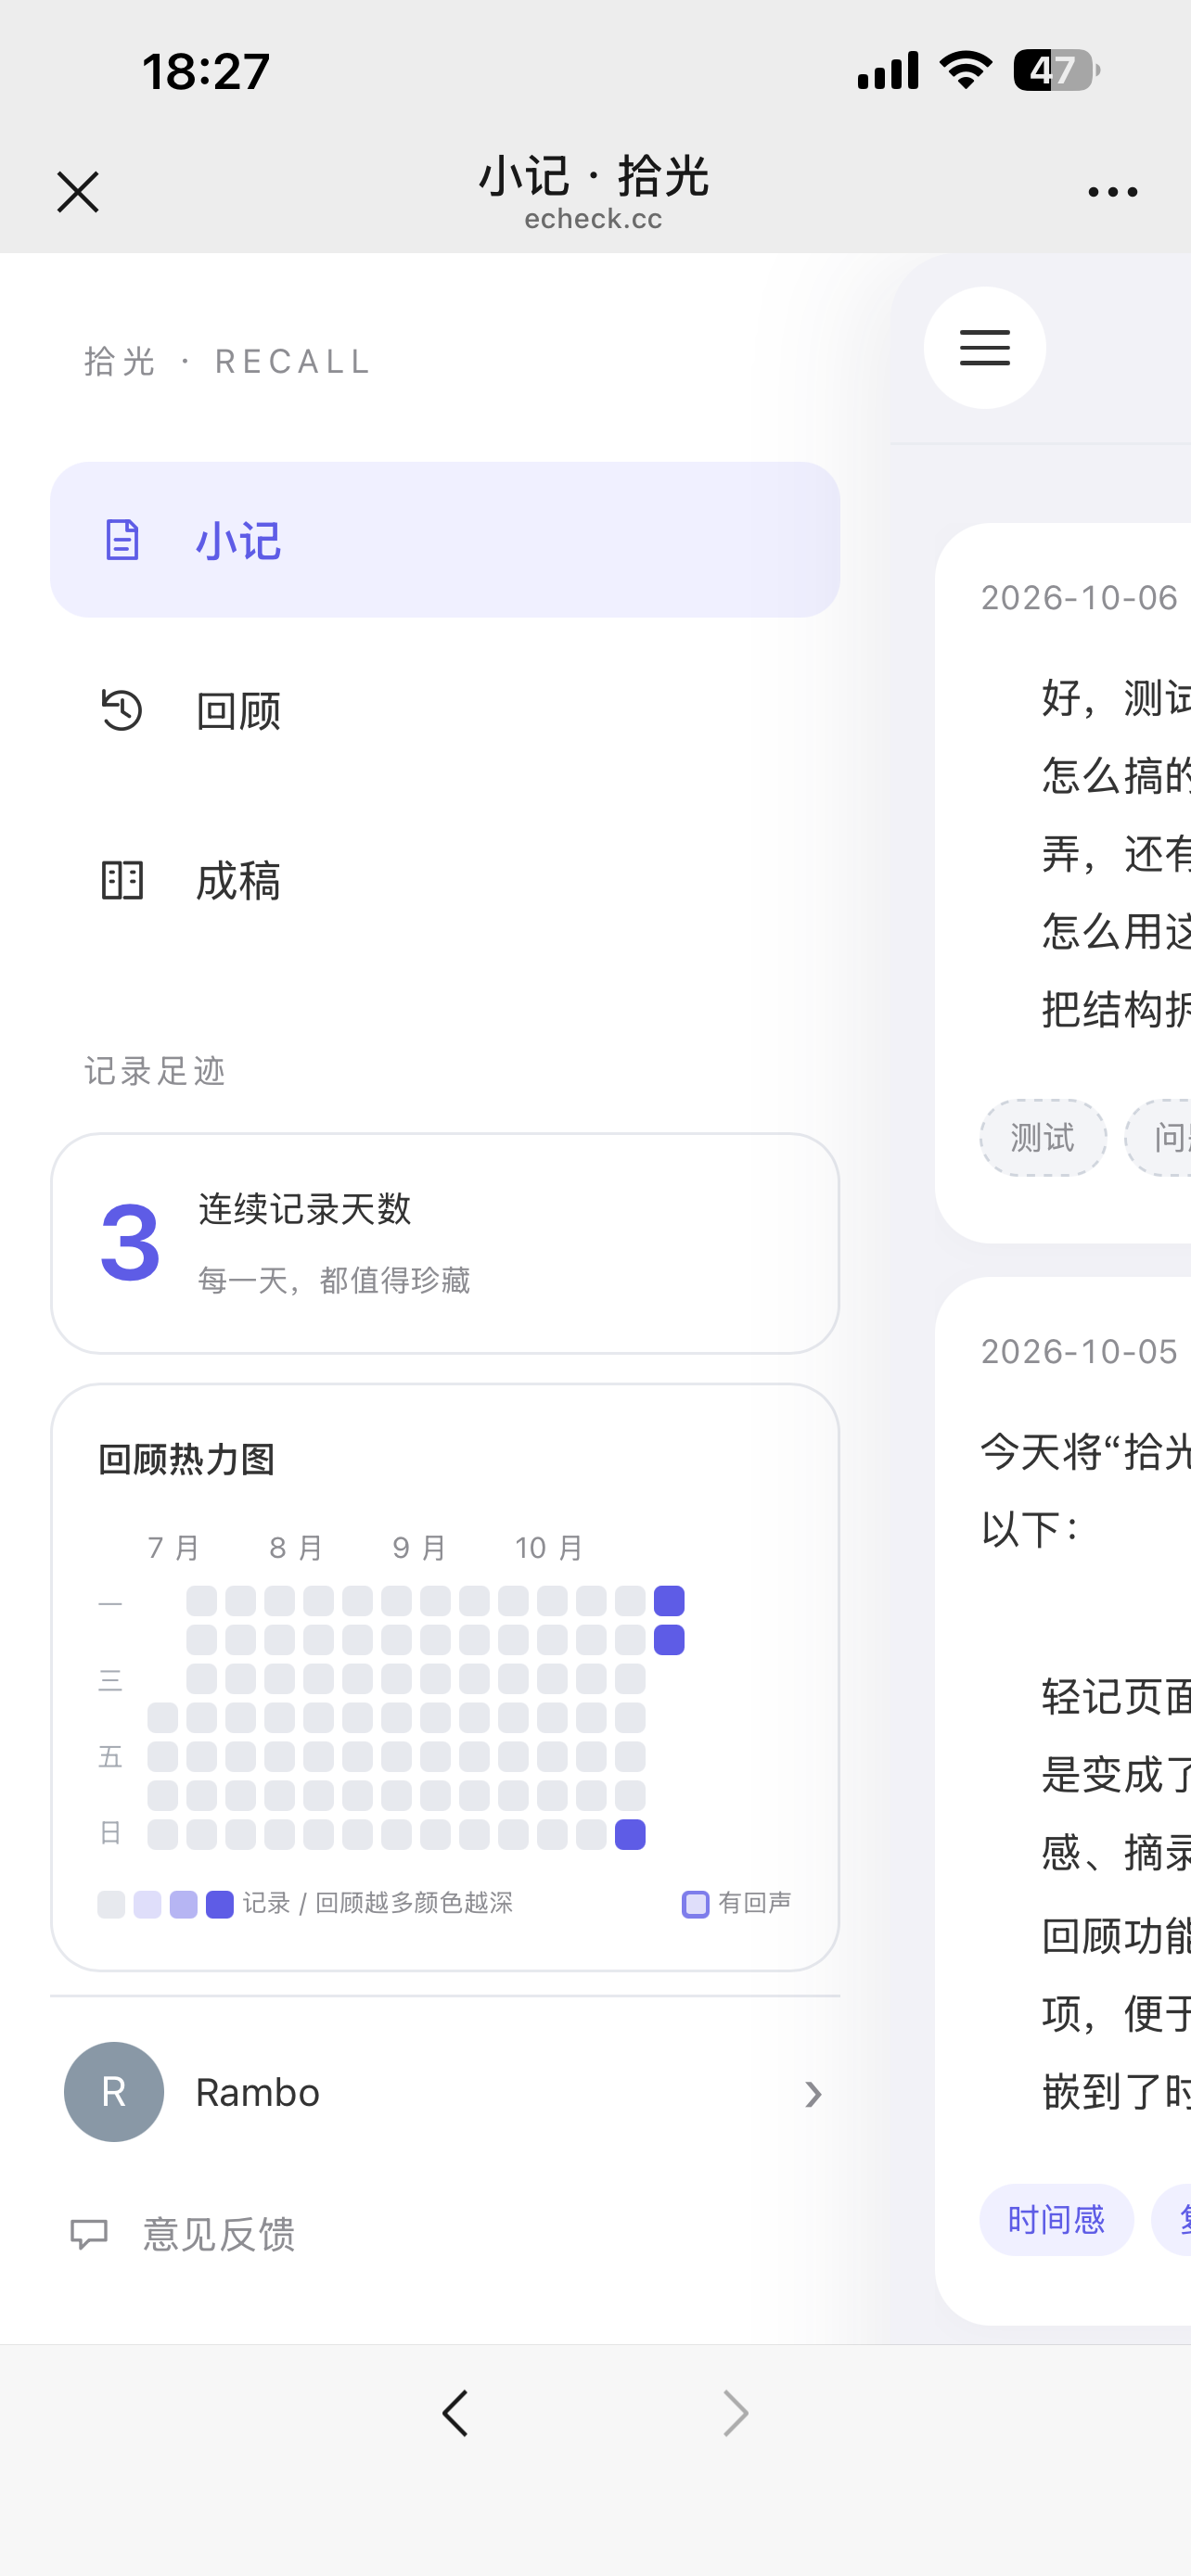
利用节假日,断断续续在 VSCode 的 CodeX 和 Code Buddy 之间来回切换,靠着免费的积分加上付费的 token 续命,开发了一款叫“拾光”的笔记工具,打算当作个人 Agent 模式来用。目前还在摸索阶段,持续迭代开发中。
全天耗在搞 App 端配色上了,真是折腾得心力交瘁!最开始是蓝色,后来改紫色,又换成浅绿色,现在又定稿了深绿色。各种“绿”色把我自己都绕晕了,选颜色真让人头大。
作为一款笔记+Agent 工具,核心绝对是阅读体验优先。最终参考了微信聊天配色,整体以偏深的绿色为基调(具体叫啥绿,各平台叫法不一,我也放弃了研究名字了)。另外还特意把之前纯黑的文字改成了深浅灰,以提升阅读舒适度。
搞 UI 和视觉设计真的是一门大学问,色系繁多,极其考验审美。虽然折磨,但收获满满,看着整体界面慢慢成型,整体还是挺满意的。
目前先拿旧网址顶着(www.echeck.cc),新域名还在备案中。不一定能稳定访问,大家随意感受一下。看着它一点点生长,希望它能像名字一样,让记录产生连接。
感谢这个充实的节假日,继续折腾,继续生长!✨
0 00
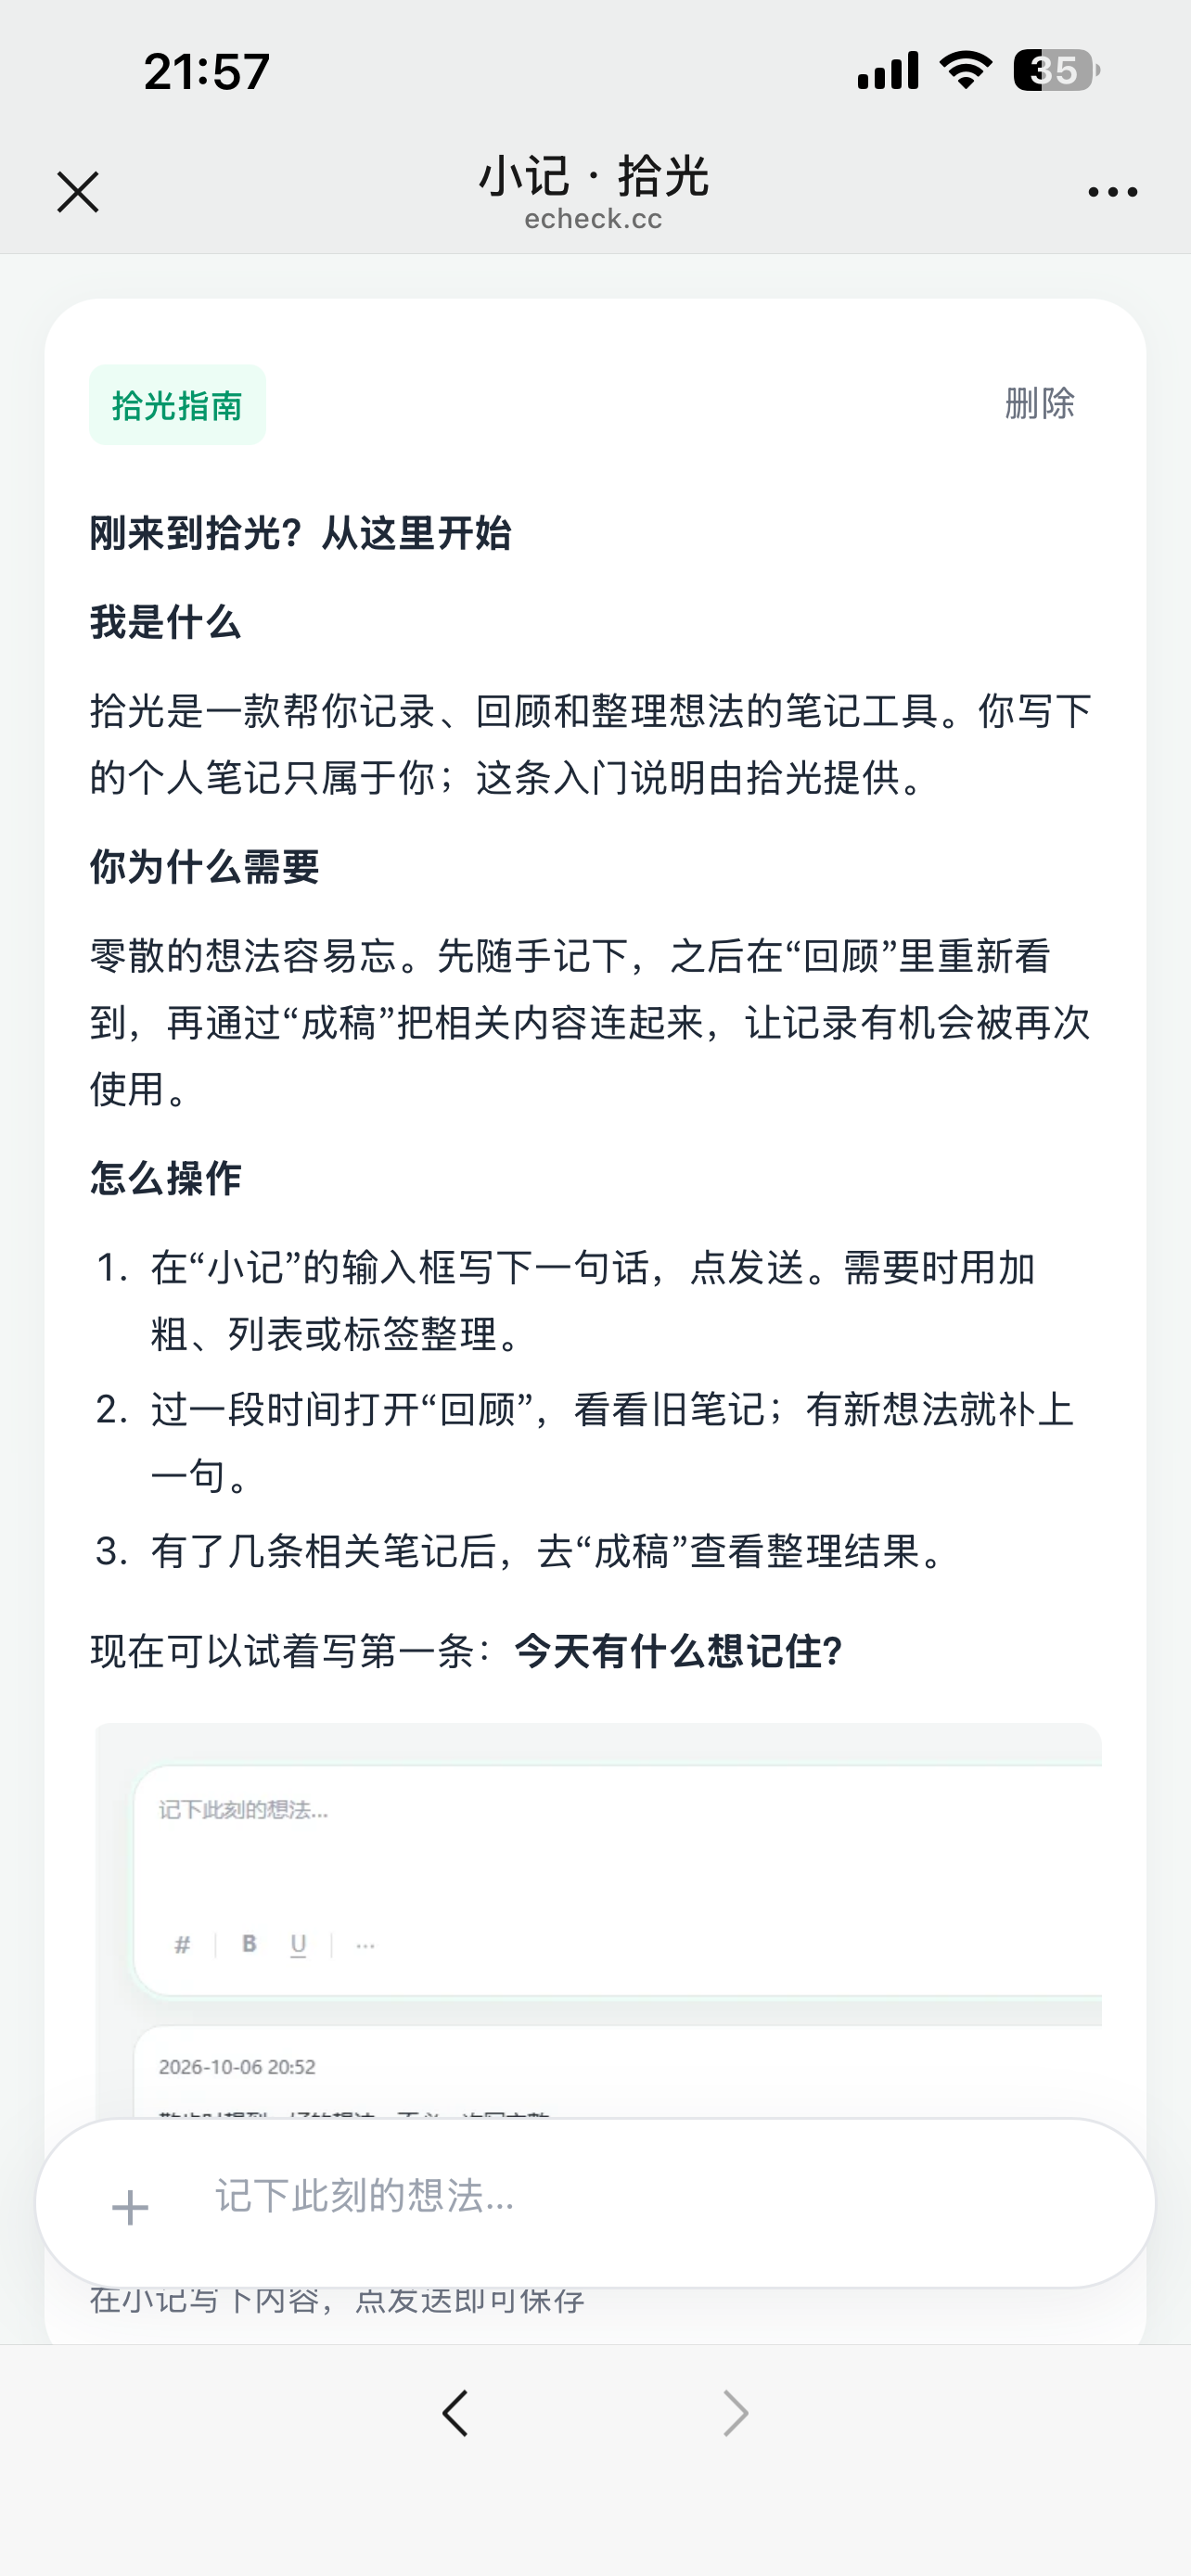
拾光 App 新手指南来了!它不是纯笔记工具,而是你的第二大脑。
1. 降低门槛。 我用 Dify 搭 RAG 知识库时发现,AI 编排和自定义工作流门槛太高,普通人根本玩不转。拾光要做的是把复杂留给自己,把简单留给你。
2. 挖掘盲区。 市面竞品要么做会议录音,要么做回忆录,都停留在“存”的层面。拾光要做的,是让知识彼此碰撞、主动连接。正如卢曼所说:“没有写作就不可能思考”——而拾光让写下的每一条笔记都成为连接网络的节点,像大脑神经元一样自然勾连。
3. 喂养 AI。 AI 再强大,没有专属资料库也只是空壳。OpenAI 官方就明确指出,用个人内容训练模型能显著提升其对用户具体问题的解决能力。而你日常记录的那些笔记,正是喂养 AI 最好的语料。
4. 瞄准特定垂直场景(如学术研究者的文献笔记流、产品经理的需求洞察流),用 AI Agent 深度嵌入你的工作流,而非做一个通用笔记助手。产品经理做需求洞察与垂直应用,学术研究者做报告分析与文献笔记,拾光都能帮你沉淀、连接、调用。
拾光:不只记录,更是生长。
0 00
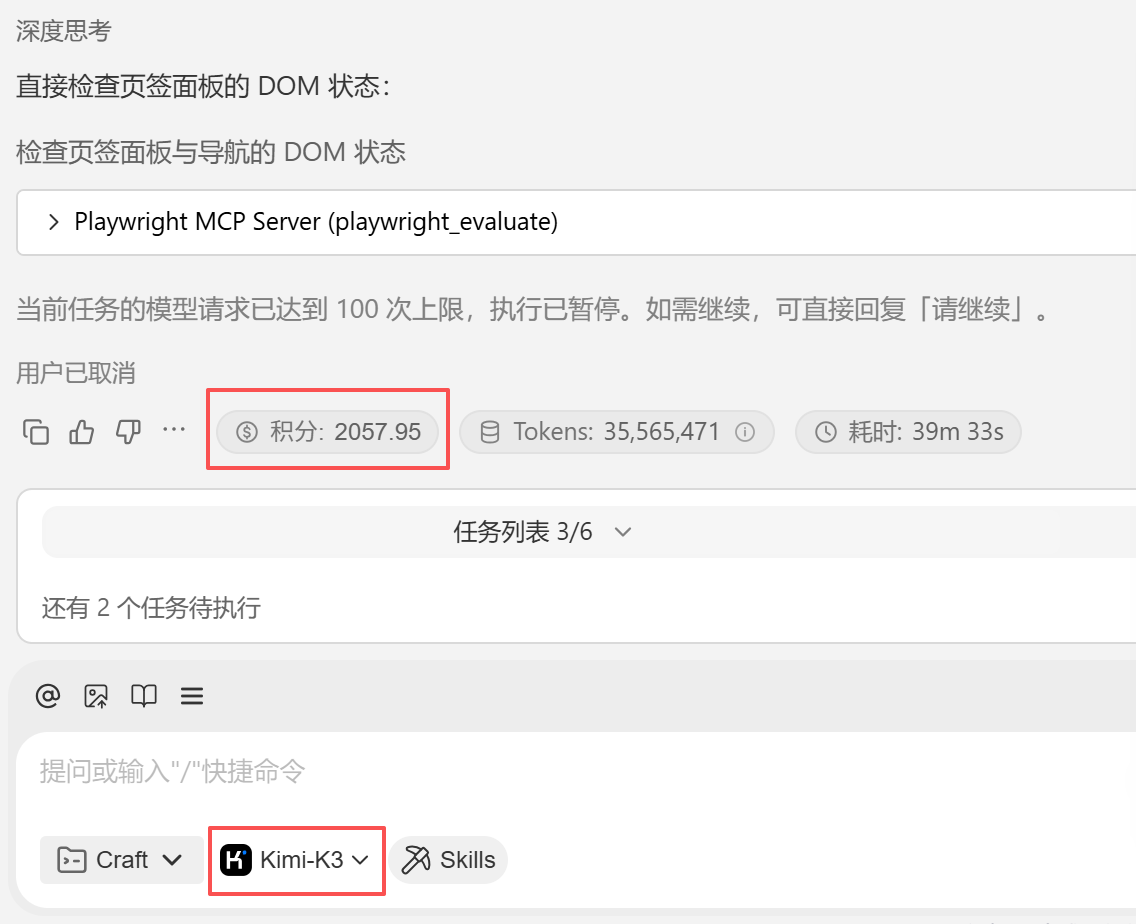
用workbuddy里面DS V4.1-Flash当日额度用光,本来切GLM5.3。
手贱用了Kimi-K3,一个并不复杂(SaaS租户套餐开发)任务花了2000+积分,换DS/GLM可能只需数十积分。
手贱用了Kimi-K3,一个并不复杂(SaaS租户套餐开发)任务花了2000+积分,换DS/GLM可能只需数十积分。
0 10
别把“同款模型”当“同款体验”:WorkBuddy 的 DeepSeek 为什么不如官方 API?
最近实测发现:WorkBuddy 自带的 DeepSeek-V4.1-Flash,和走官方 API 的 DSH 相比,产出文件质量明显差一截。换成官方 API 后,长文档、代码、复杂任务都稳很多。
查了来源才明白:WorkBuddy 里的模型不是直连 DeepSeek 官网,而是腾讯云托管的开源权重。权重同源,但服务不同。
核心差异有三层:
1. 调用路径不同
官方 API 走 api.deepseek.com,原厂直营;WorkBuddy 走云厂商内部端点,自部署、自运维。
2. 硬件与推理策略不同
V4.1-Flash 满血需 614GB 显存、8 卡 H200 级别。云厂商若压缩上下文、量化、共享算力,质量就会打折。WorkBuddy 只给 300k 上下文,而 CodeBuddy 给 1M,就是例子。
3. 服务层差距最大
官方有上下文硬盘缓存、深度推理优化、工具调用解析;云托管很难完全复现。同一模型在不同平台,GPQA 科学推理能差 15 分,TAU-Bench 工具调用能差 23 分——工具调用差 20 分,Agent 失败率可能翻倍。
所以,WorkBuddy 不是“李鬼”,是官方授权、云厂商自部署的托管版。但开源权重 ≠ 官方体验。权重决定下限,服务层决定上限。
建议:
· 轻量任务、原型验证:WorkBuddy 免费/低价额度够用。
· 复杂推理、长文档、Agent、文件产出:填官方 API Key,或直接用官方。
· 别被“同款模型”迷惑,同款权重,不同智能。
开源给了选择权,但选择之后,跑法才是关键。难怪 workbuddy 积分套餐消耗 token 比官方便宜,同名不同款,托管版会降智!
#DeepSeek #AI工具 #WorkBuddy #大模型 #开源模型
2 00
调研分析用国内模型,严谨的论证用海外模型。
日常用 Workbuddy 模型,现有积分可免费调用。用了 DeepSeek、智谱以及 Kimi,其中用 DeepSeek 的居多一点。后来发现,智谱的 GLM3 感觉也不错,但速度太慢了,而且智能程度也不一定比 DeepSeek 强很多。偶尔用了一下混元 4,输出结果有时候不如 DeepSeek。
从这些体验中,我发现“Agent如何编排”这点很关键。使用智能体,主要靠约束、规范以及 Agent 之间的上下文关系,这个点其实很重要,可以把模型的能力稍微放大。至于放大是 1 倍、2 倍还是 5 倍,这就看具体任务的难易程度及个人的操作方法来区别感受了。
日常用 Workbuddy 模型,现有积分可免费调用。用了 DeepSeek、智谱以及 Kimi,其中用 DeepSeek 的居多一点。后来发现,智谱的 GLM3 感觉也不错,但速度太慢了,而且智能程度也不一定比 DeepSeek 强很多。偶尔用了一下混元 4,输出结果有时候不如 DeepSeek。
从这些体验中,我发现“Agent如何编排”这点很关键。使用智能体,主要靠约束、规范以及 Agent 之间的上下文关系,这个点其实很重要,可以把模型的能力稍微放大。至于放大是 1 倍、2 倍还是 5 倍,这就看具体任务的难易程度及个人的操作方法来区别感受了。

Rambo_: 用AI Agent做To B小项目,我的心得体会 近半年用AI Agent做了几个小型项目,最大感受:别做大而全,先做裁剪和共识。 1. 0-1项目,调研文档和软件选型很重要。BRD、MRD、PRD可以靠AI快速完善,但到30%-40%后,真正卡住的是业务规则、业务知识、业务流程和真实调研数据。没这些,AI给的推荐往往是很细的规则点,不是框架,硬补全很耗时。 2. 所以要学会裁剪。To B软件,尤其商业软件/定制软件,可以按端、模块拆开做。早期上线不必强依赖大模型,AI Agent更多是提效工具,不是底座。 3. To B软件本质围绕流程、效率、成本、业财一体化。商业软件有营收压力,定制软件没有,它只服务业务方。方案不一定要绝对正确、合理,而要对齐组织当前认知水平,让老板、业务负责人、执行人达成共识。 4. 定制项目口碑来自两头:老板的认知,和一线执行人的操作体验。很多集成功能不是自上而下设计,而是自下而上长出来的。只要逻辑通、基本功能能实现,就要先满足他们的便捷操作。哪怕放到整体框架里不合适,也由产品/设计再平衡。 一句话总结:AI Agent做To B小项目,核心不是堆AI 多强大,而是裁剪范围、对齐认知、自下而上、快速达成共识并落地。 #AIAgent #ToB产品 #项目复盘 #产品思考
1 00
用AI Agent做To B小项目,我的心得体会
近半年用AI Agent做了几个小型项目,最大感受:别做大而全,先做裁剪和共识。
1. 0-1项目,调研文档和软件选型很重要。BRD、MRD、PRD可以靠AI快速完善,但到30%-40%后,真正卡住的是业务规则、业务知识、业务流程和真实调研数据。没这些,AI给的推荐往往是很细的规则点,不是框架,硬补全很耗时。
2. 所以要学会裁剪。To B软件,尤其商业软件/定制软件,可以按端、模块拆开做。早期上线不必强依赖大模型,AI Agent更多是提效工具,不是底座。
3. To B软件本质围绕流程、效率、成本、业财一体化。商业软件有营收压力,定制软件没有,它只服务业务方。方案不一定要绝对正确、合理,而要对齐组织当前认知水平,让老板、业务负责人、执行人达成共识。
4. 定制项目口碑来自两头:老板的认知,和一线执行人的操作体验。很多集成功能不是自上而下设计,而是自下而上长出来的。只要逻辑通、基本功能能实现,就要先满足他们的便捷操作。哪怕放到整体框架里不合适,也由产品/设计再平衡。
一句话总结:AI Agent做To B小项目,核心不是堆AI 多强大,而是裁剪范围、对齐认知、自下而上、快速达成共识并落地。
#AIAgent #ToB产品 #项目复盘 #产品思考
0 11

段永平买茅台,我看到了两种“光环”
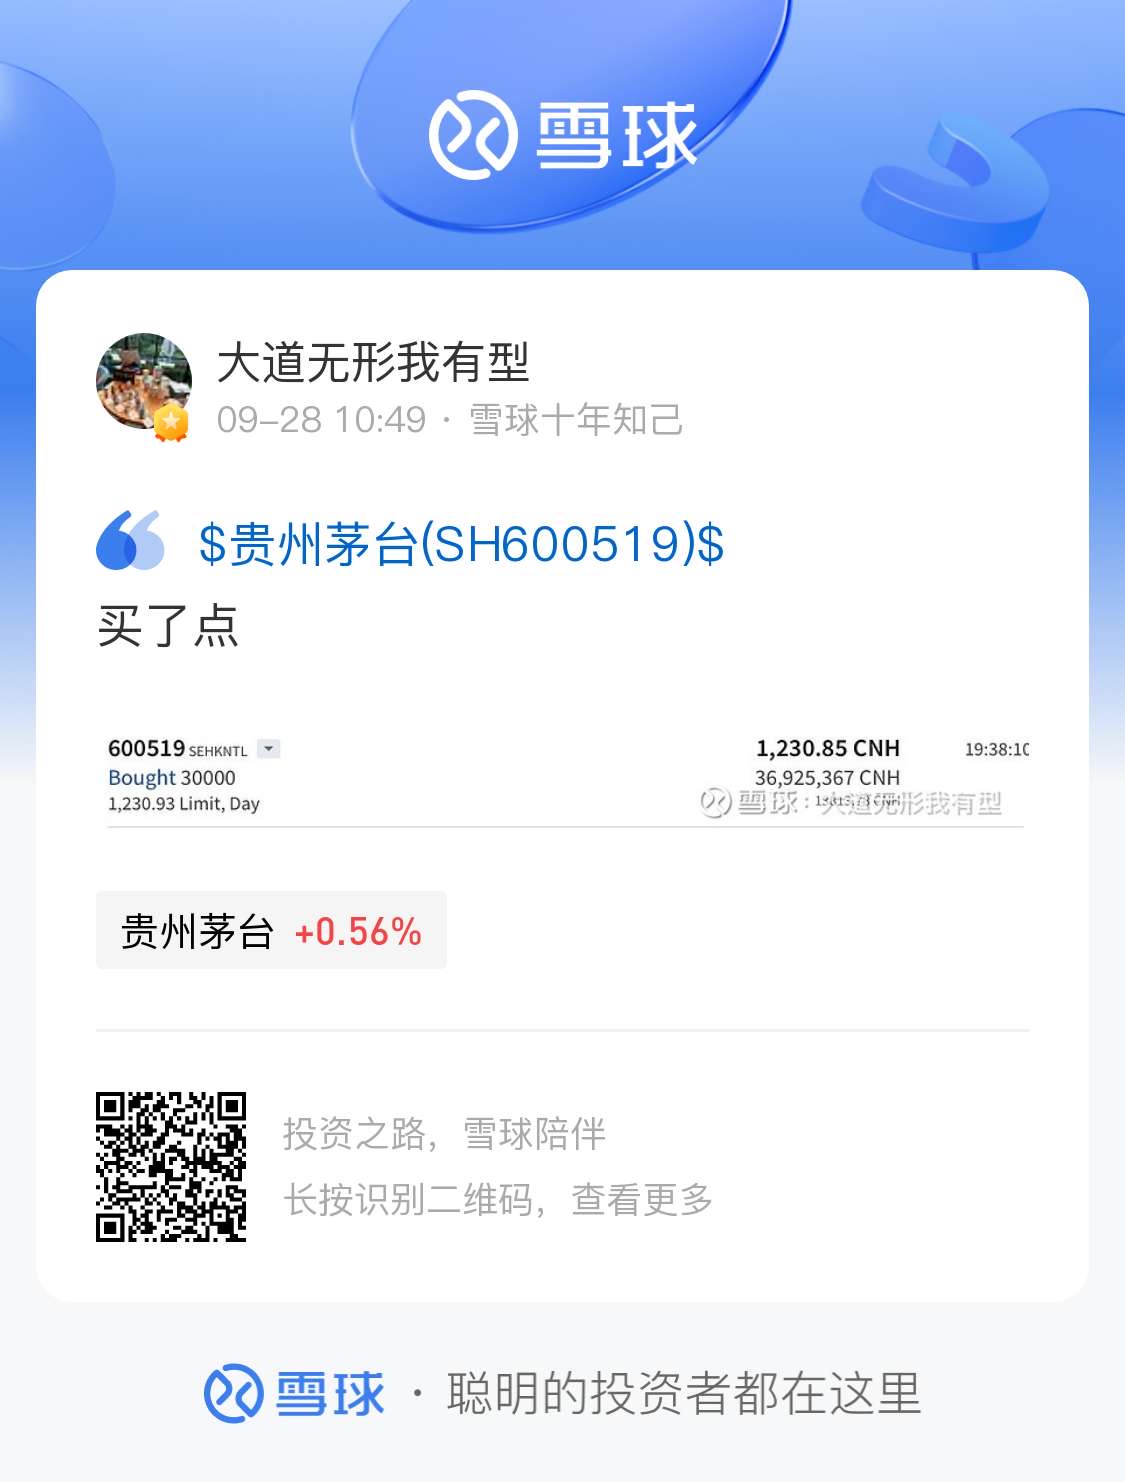
2026年9月28日,段永平在雪球发了一条简短帖子:“买了点贵州茅台。”交易截图显示,他以1230.85元/股买入3万股,耗资约3692.54万元。
消息发出后,茅台午后拉升翻红,收盘涨0.56%。一笔不到四千万的买入,撬动了一家1.55万亿市值公司的股价异动。这就是“光环效应”的当代版本。
但有意思的是,段永平自己可能不这么想。
他不是“短线”,他只是没在等
外界最爱贴的标签是“长期价值投资者却出现了短期行为”。但翻看他的公开表态,逻辑其实一以贯之。
今年5月,有投资者问他全仓茅台半年要不要调仓,他直接回了一句:“我今天还买了茅台啊,你会凌乱吗?”更早之前他放话:“我敢抱着茅台跟任何国内基金赌一个亿人民币,以十年为限。”
他的核心逻辑不是“茅台会涨”,而是“拿着现金更难受”。他曾说过,自己在茅台2600块时就想卖,但真正阻止他的不是对公司判断的改变,而是“卖了之后买什么”的机会成本权衡。他是个满仓主义者,宁可拿着“知道早晚会回来”的东西。
所以这3692万,在他自己的框架里,是一次基于十年尺度的机会成本决策,而不是一次短线博反弹。
但市场不这么读。市场读的是:段永平买了。然后跟。
光环效应:当一个人的判断力被“溢出”了
心理学上有个概念叫光环效应(Halo Effect)。最早是美国军方发现的:士兵如果在一项品质上得了高分(比如整洁),评估者会连带给其他完全不相关的品质(比如忠诚、体能)也打高分。
这个认知偏差搬到投资市场,就变成了一个更危险的东西:当一个人被贴上“成功投资者”的标签后,他做的任何事都会被默认是对的。 他买的股票会被认为“有前途”,他说的话会被当成“信号”,甚至他的沉默都会被解读出某种含义。
巴菲特是这方面的经典案例。2011年,巴菲特宣布向美国银行投资50亿美元,消息一出,美银股价盘中飙升,市值一度增加180亿美元。更夸张的是,花旗和富国等其他银行的股价也跟着涨了——仅仅因为市场推测“巴菲特看好银行板块”。
段永平在中国投资圈的处境类似。他没有华尔街的光环,也不常上财经头条,但雪球账号上寥寥数语,就足以“引发市场震荡与散户跟风”。这次买入茅台,帖子发出后茅台股价午后翻红,几乎是同一个机制的复刻。
“黑红也是红”的陷阱
现在把镜头拉远一点。
“光环效应”在当下的极端形态,是“黑红也是红”。有品牌故意触碰底线制造争议,赌的是“关注度本身就是资产”。但数据很残酷:行业研究显示,“黑流量”的转化率远低于“红流量”——骂你的人不会为你买单,围观者的注意力下一秒就会被新热点带走。
更深层的问题是,黑红消耗的是一种不可再生资源:信任。永和豆浆做了40多年国民早餐,一条几十秒的擦边视频就足以让消费者说“再没有买的兴致了”。
段永平的光环恰恰是另一种东西。他通过雪球分享投资思考的方式是“不荐股、不预测、不煽动,只讲逻辑与常识”。他的影响力建立在二十多年积累的“判断力记录”上——网易、苹果、茅台,每一次都是在别人恐慌或看不懂的时候出手,然后用时间证明判断。
这种光环不是靠争议赚来的,也因此不会因为一次争议而崩塌。
为什么段永平的光环“拉不下来”
回到用户提出的那个洞察:一个人成了之后,光环效应一旦具备,就轻易不会拉下来。
这个判断对了一半。
光环效应确实有惯性。思科在2000年巅峰时被媒体誉为“信息高速公路的微软”,CEO钱伯斯被称作“天才CEO”。泡沫破裂后,同一批媒体立刻改口,说他“傲慢自大、抗拒变化”。光环没有消失,它翻转了方向。
真正的区别在于,光环的底座是什么。如果底座是短期的业绩数字或流量数据,那光环会随着数字波动而剧烈摇摆。但如果底座是一套可验证的、长期一致的判断逻辑,光环就有了抗周期能力。
段永平在茅台股价腰斩时的态度是:“一个股票要是扛不住掉50%,就不应该买入。”这句话本身也是一种光环——它传递的不是“茅台一定会涨”,而是“这个人知道自己为什么持有”。前者会被证伪,后者很难。
人人都向往光环加身,出名要趁早。但值得想清楚的是:你想要的光环,是让别人的注意力停留在你身上的那种,还是让别人的判断力愿意托付给你的那种?
前者靠一次热点就能获得,也靠一次热点就能失去。
后者,需要很多年。
1 00