即刻App年轻人的同好社区
下载
全天录音③:想白嫖输入法,白折腾两天!
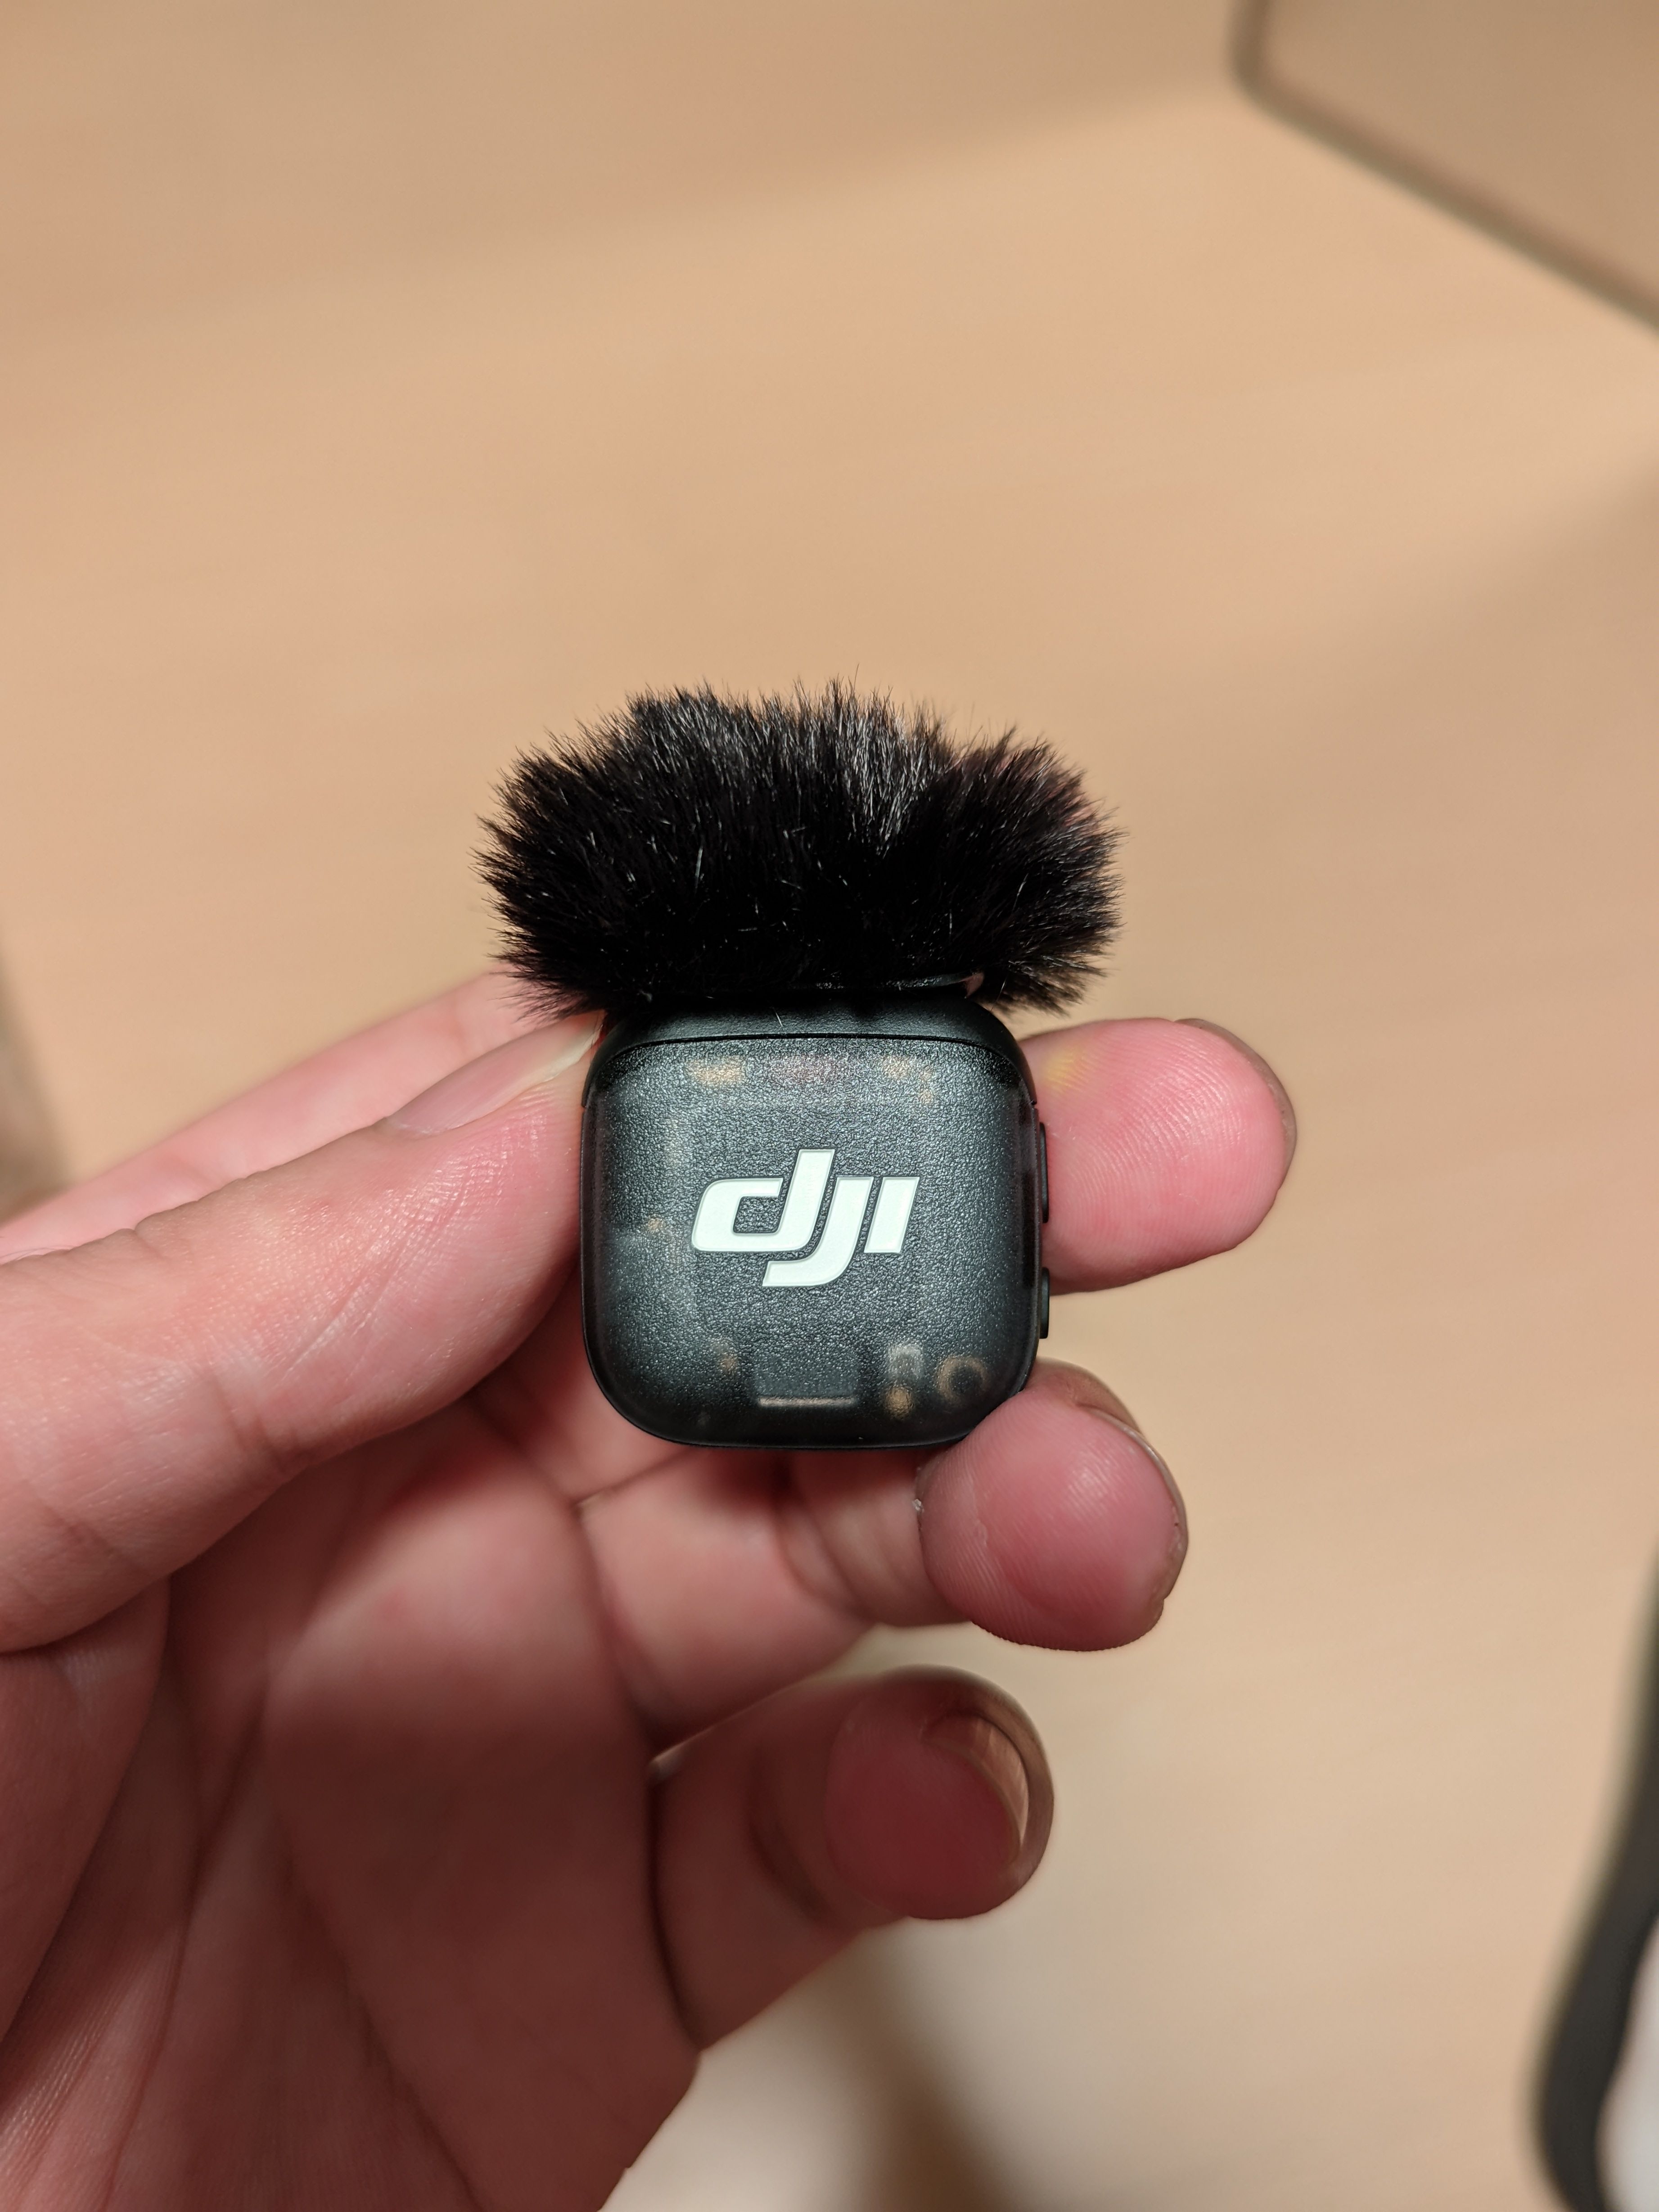
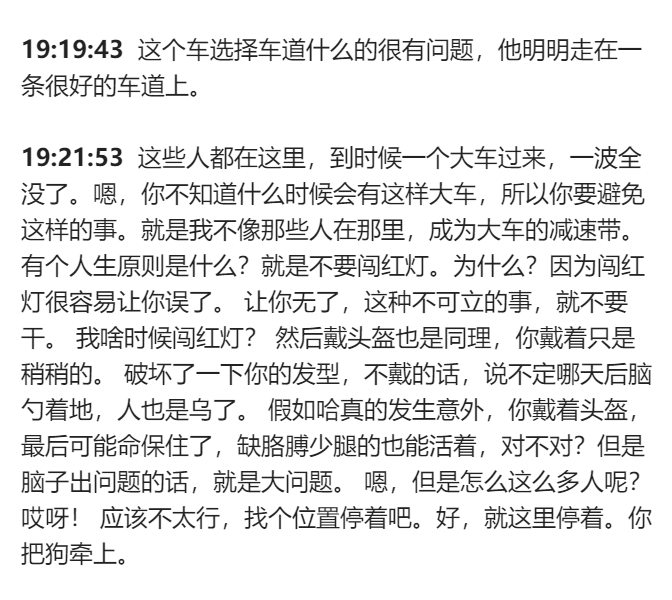
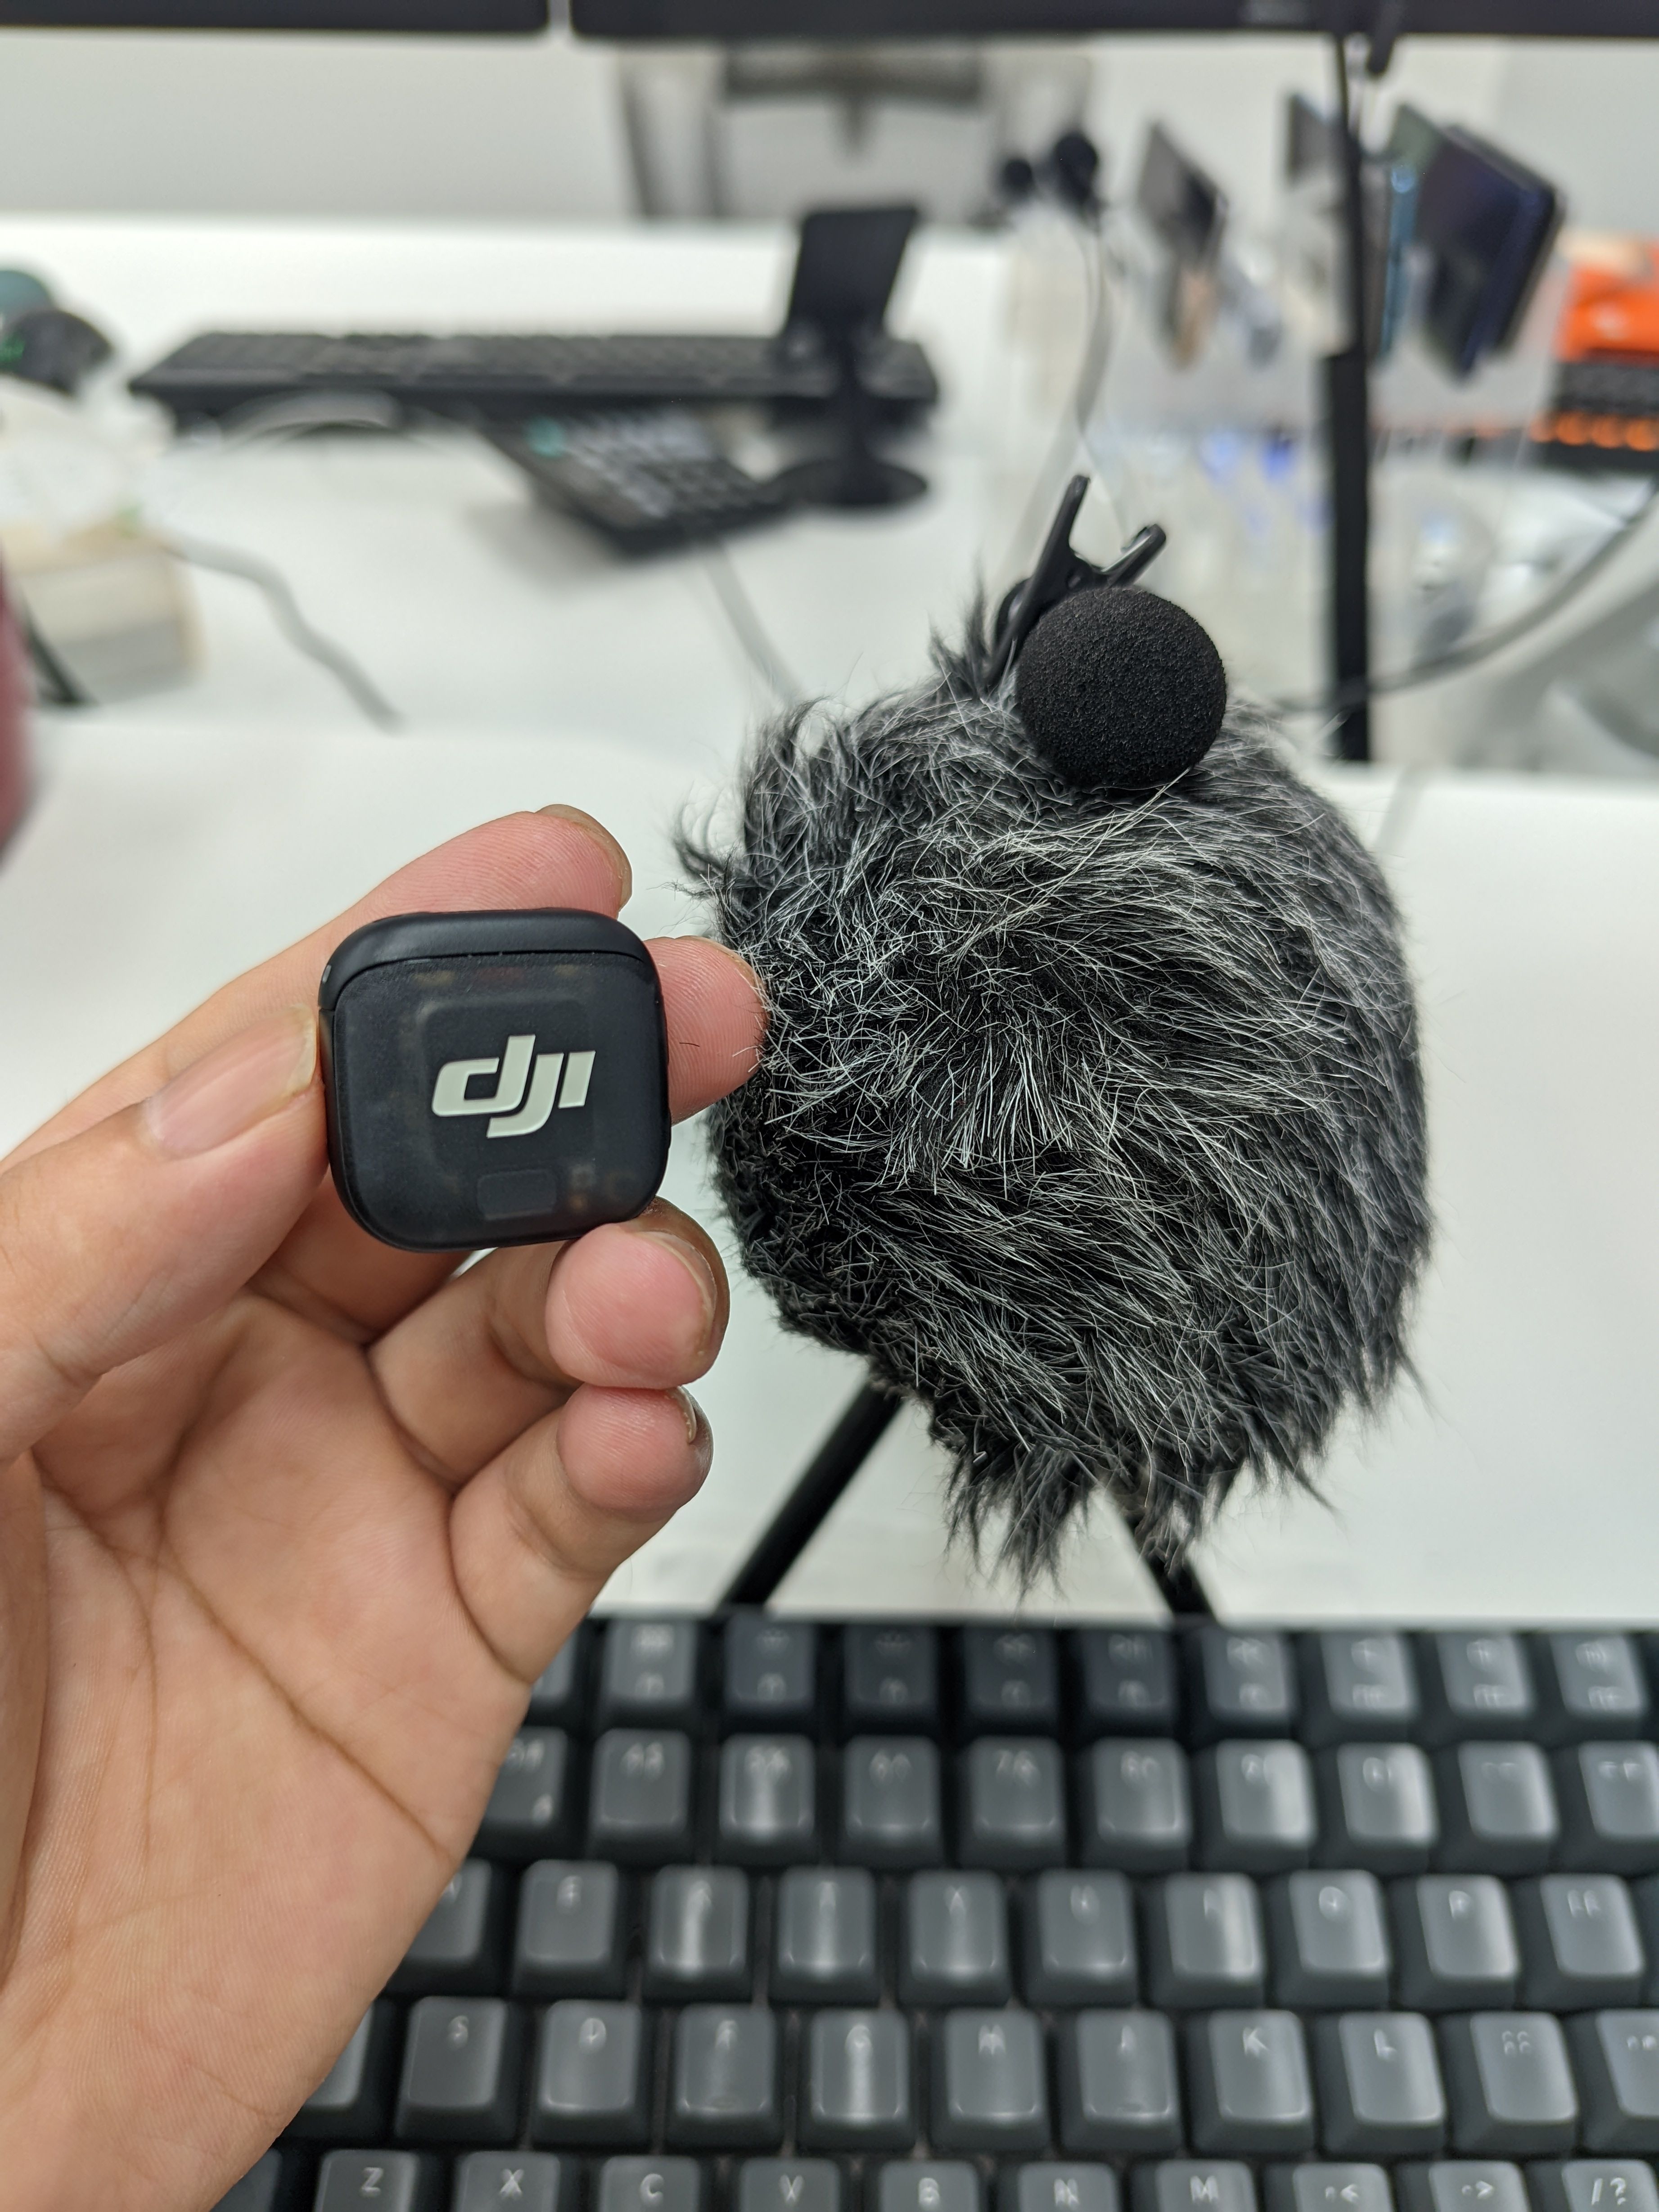
上回折腾大疆 Mic 3 和电脑有线麦克风,终于把日常录音接进了自己的语音日记,用 Mac mini 上的千问模型转成文字。
本来已经能用了,我又突然冒出个骚操作:
豆包、微信语音输入法平时听写不是挺准的吗?而且还免费!
那能不能把录好的音频文件直接喂给它们,白嫖大厂的语音识别能力?说不定效果更好,连本地模型都不用跑了。
越想越觉得有搞头,感觉叫 Codex 来干活。
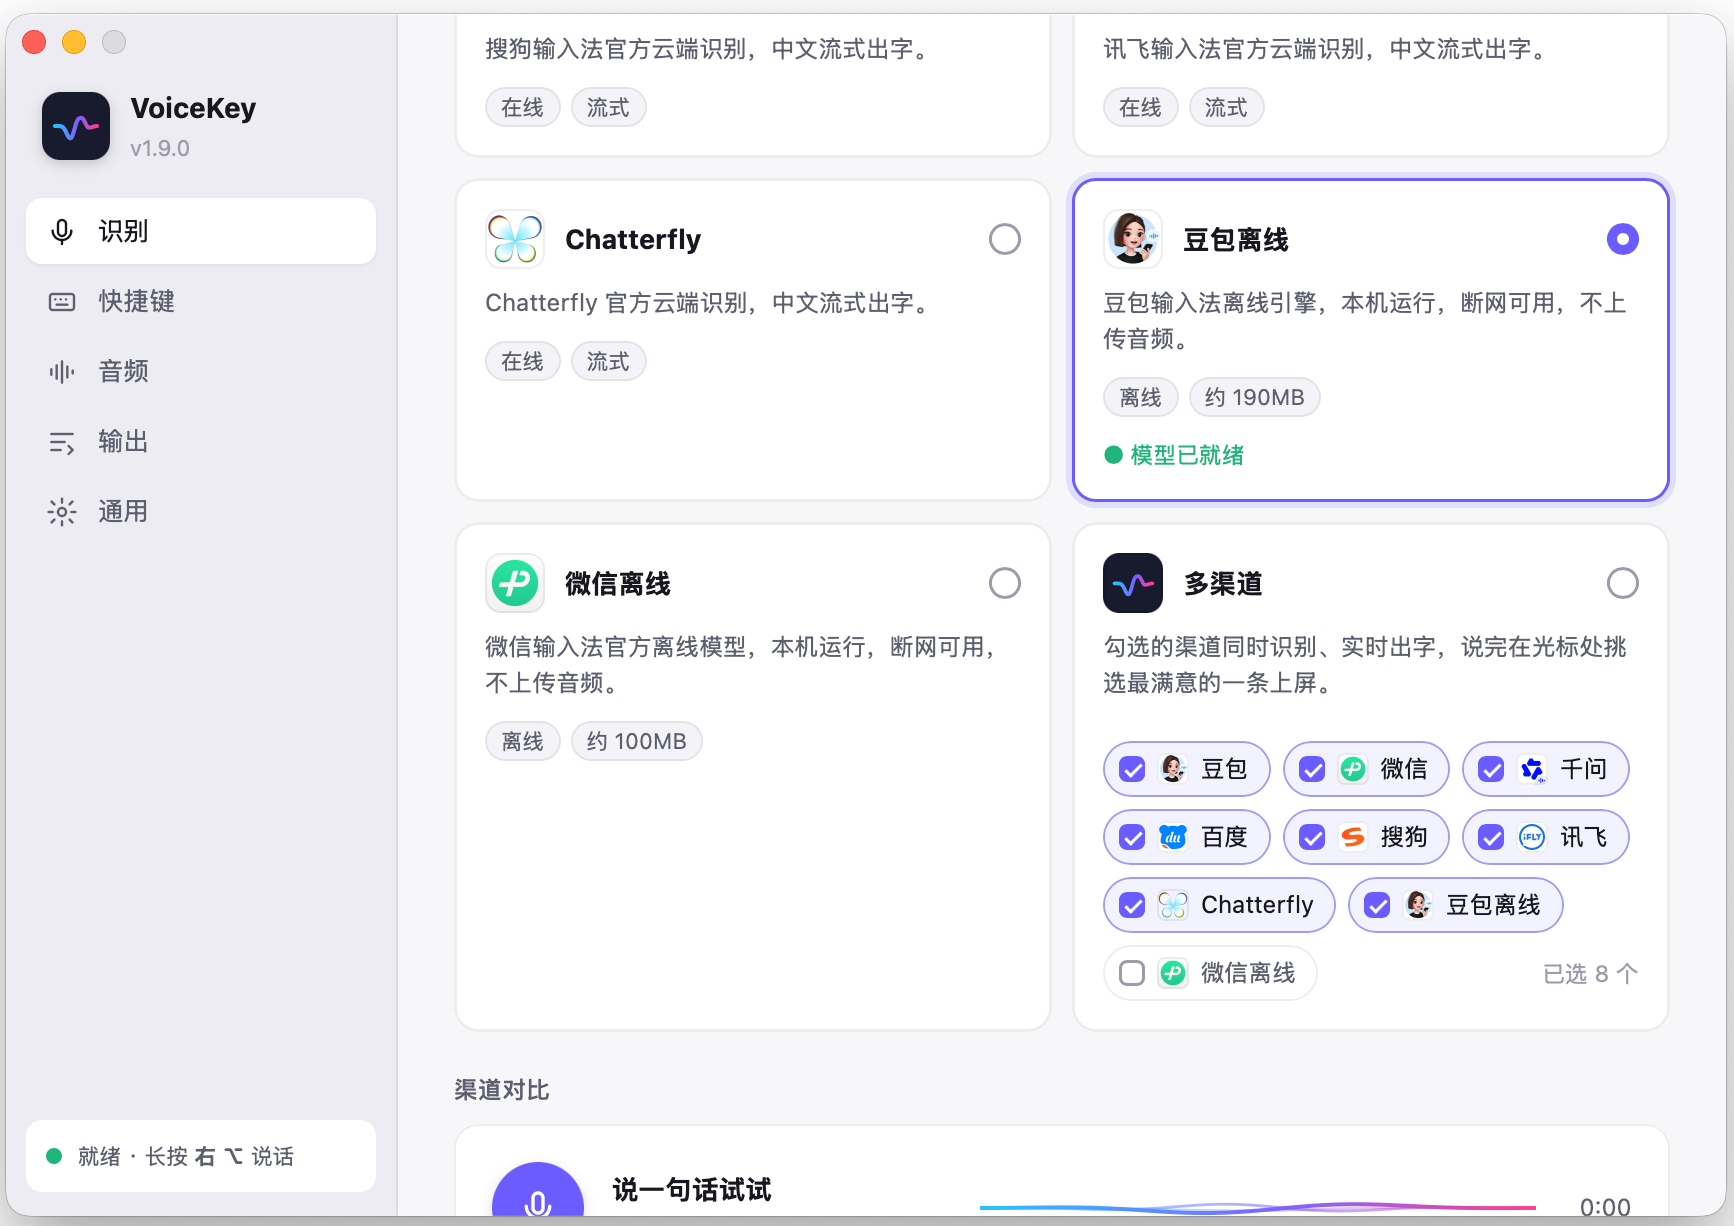
没想到网上还真有人搞出了类似的开源项目,可以直接调用识别通道;甚至还找到了能在本地跑的豆包、微信离线模型。
一开始还挺兴奋,居然真的能跑!
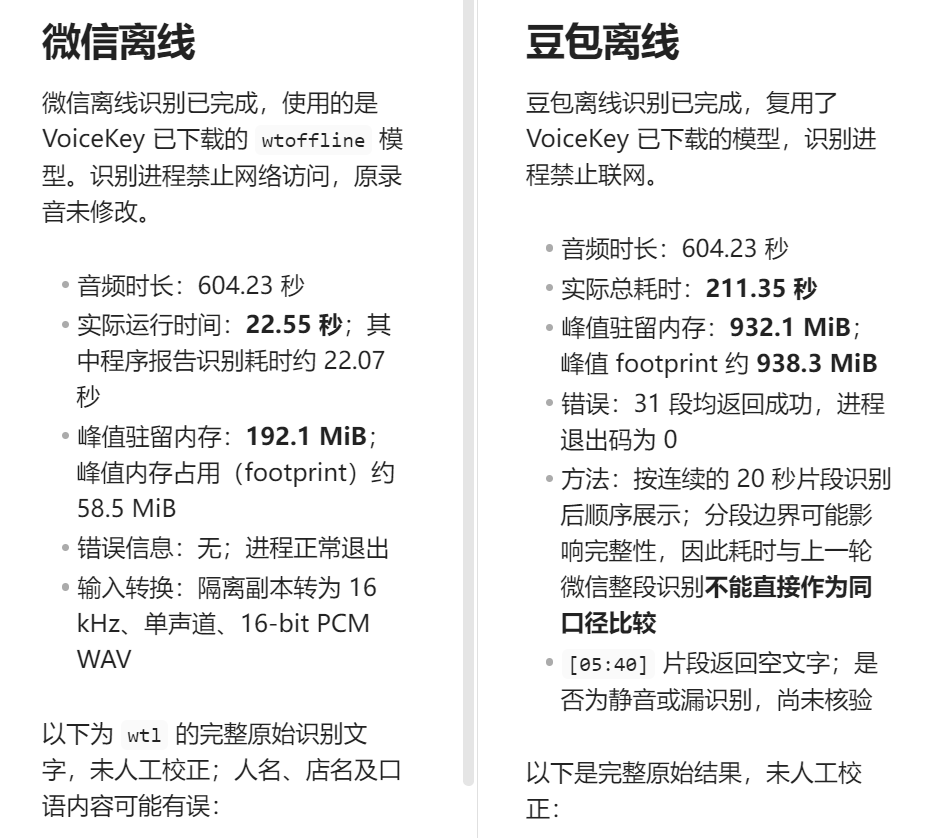
10 分钟录音,微信在线大约 168 秒就处理完了;微信离线甚至只花了 22 秒多。
结果一测长录音,开始露馅了。
豆包在线会提前结束,微信在线虽然能出稿,但有些内容对不上。
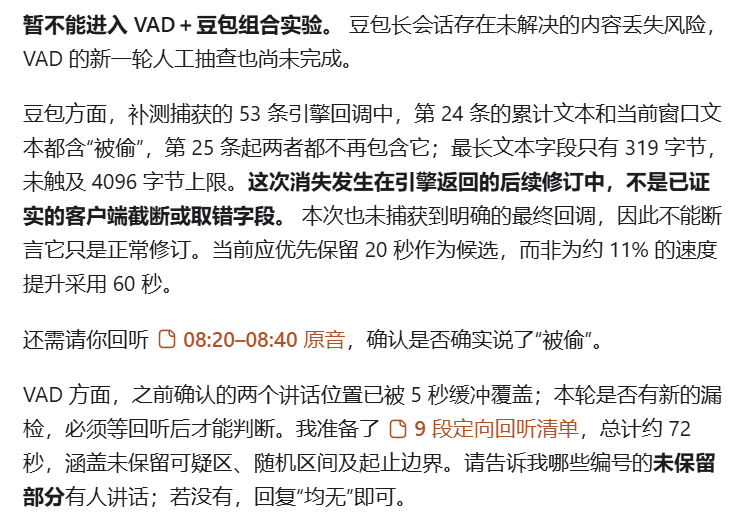
折腾豆包离线时更离谱:我有一句话正好聊到“被偷”,明明在中间识别结果里出现了,后面却被它自己修订没了。
好家伙,连“被偷”都能给我偷没了!
后来不死心,又折腾了更长的文件、自动分段、结果拼接,还拿同一段 30 分钟录音做对照。
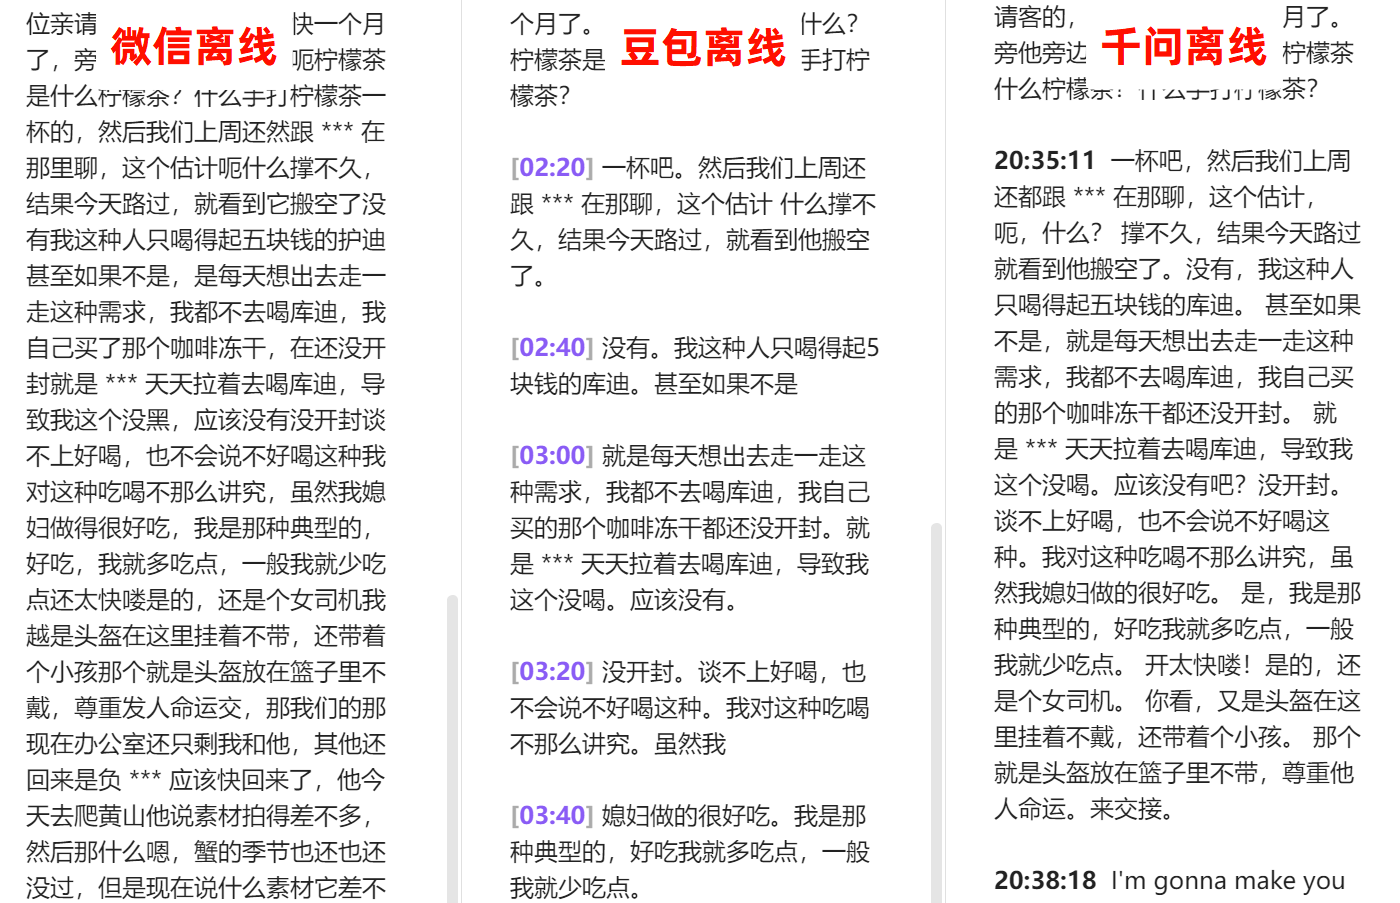
豆包离线花了 13 分多钟,原来的千问只要不到 4 分钟。豆包输出的文字还更少,部分内容也存在明显分歧,没有证明能补回什么重要信息。
折腾了差不多两天,最后还是算了,继续用千问吧,省心够用。
不得不说,偷鸡不成蚀把米。
上次录音程序吞声音,这次语音输入法吞文字。
想给自己造个不会忘事的系统,结果这两天净在找它到底忘了什么……
上回折腾大疆 Mic 3 和电脑有线麦克风,终于把日常录音接进了自己的语音日记,用 Mac mini 上的千问模型转成文字。
本来已经能用了,我又突然冒出个骚操作:
豆包、微信语音输入法平时听写不是挺准的吗?而且还免费!
那能不能把录好的音频文件直接喂给它们,白嫖大厂的语音识别能力?说不定效果更好,连本地模型都不用跑了。
越想越觉得有搞头,感觉叫 Codex 来干活。
没想到网上还真有人搞出了类似的开源项目,可以直接调用识别通道;甚至还找到了能在本地跑的豆包、微信离线模型。
一开始还挺兴奋,居然真的能跑!
10 分钟录音,微信在线大约 168 秒就处理完了;微信离线甚至只花了 22 秒多。
结果一测长录音,开始露馅了。
豆包在线会提前结束,微信在线虽然能出稿,但有些内容对不上。
折腾豆包离线时更离谱:我有一句话正好聊到“被偷”,明明在中间识别结果里出现了,后面却被它自己修订没了。
好家伙,连“被偷”都能给我偷没了!
后来不死心,又折腾了更长的文件、自动分段、结果拼接,还拿同一段 30 分钟录音做对照。
豆包离线花了 13 分多钟,原来的千问只要不到 4 分钟。豆包输出的文字还更少,部分内容也存在明显分歧,没有证明能补回什么重要信息。
折腾了差不多两天,最后还是算了,继续用千问吧,省心够用。
不得不说,偷鸡不成蚀把米。
上次录音程序吞声音,这次语音输入法吞文字。
想给自己造个不会忘事的系统,结果这两天净在找它到底忘了什么……
1 00
上回折腾大疆 Mic 3,想把每天说的话都录下来,交给 Mac mini 上的本地 AI 转写,再存进 Obsidian。
后来又琢磨,坐在电脑前总不能还一直挂着大疆麦吧?就利用之前给电脑豆包语音输入法接的有线麦克风,打算一键开录,直接走同一套转写流程,还不用拷贝录音文件。
没想到第一次就翻车了!
录了104分钟,文件却只有88分钟,还时不时滋滋响。差不多15%的声音被吞了,文件明明还好好的。
一查是 FFmpeg 的录音采集的问题。感觉换修复版,再让另一套 CoreAudio 方案同步录了31分钟,时长和波形总算对上了。
还搞了个快捷指令能一键启停,录音也接进了原来的本地 AI 处理流程。
不过转写的内容,如何分离出灵感、代办和生活习惯等,还没完全整好。
多少还是有些离谱:给自己造个能记住一切的系统,差点第一步就把话记丢了。
后来又琢磨,坐在电脑前总不能还一直挂着大疆麦吧?就利用之前给电脑豆包语音输入法接的有线麦克风,打算一键开录,直接走同一套转写流程,还不用拷贝录音文件。
没想到第一次就翻车了!
录了104分钟,文件却只有88分钟,还时不时滋滋响。差不多15%的声音被吞了,文件明明还好好的。
一查是 FFmpeg 的录音采集的问题。感觉换修复版,再让另一套 CoreAudio 方案同步录了31分钟,时长和波形总算对上了。
还搞了个快捷指令能一键启停,录音也接进了原来的本地 AI 处理流程。
不过转写的内容,如何分离出灵感、代办和生活习惯等,还没完全整好。
多少还是有些离谱:给自己造个能记住一切的系统,差点第一步就把话记丢了。
1 20