即刻App年轻人的同好社区
下载
 置顶
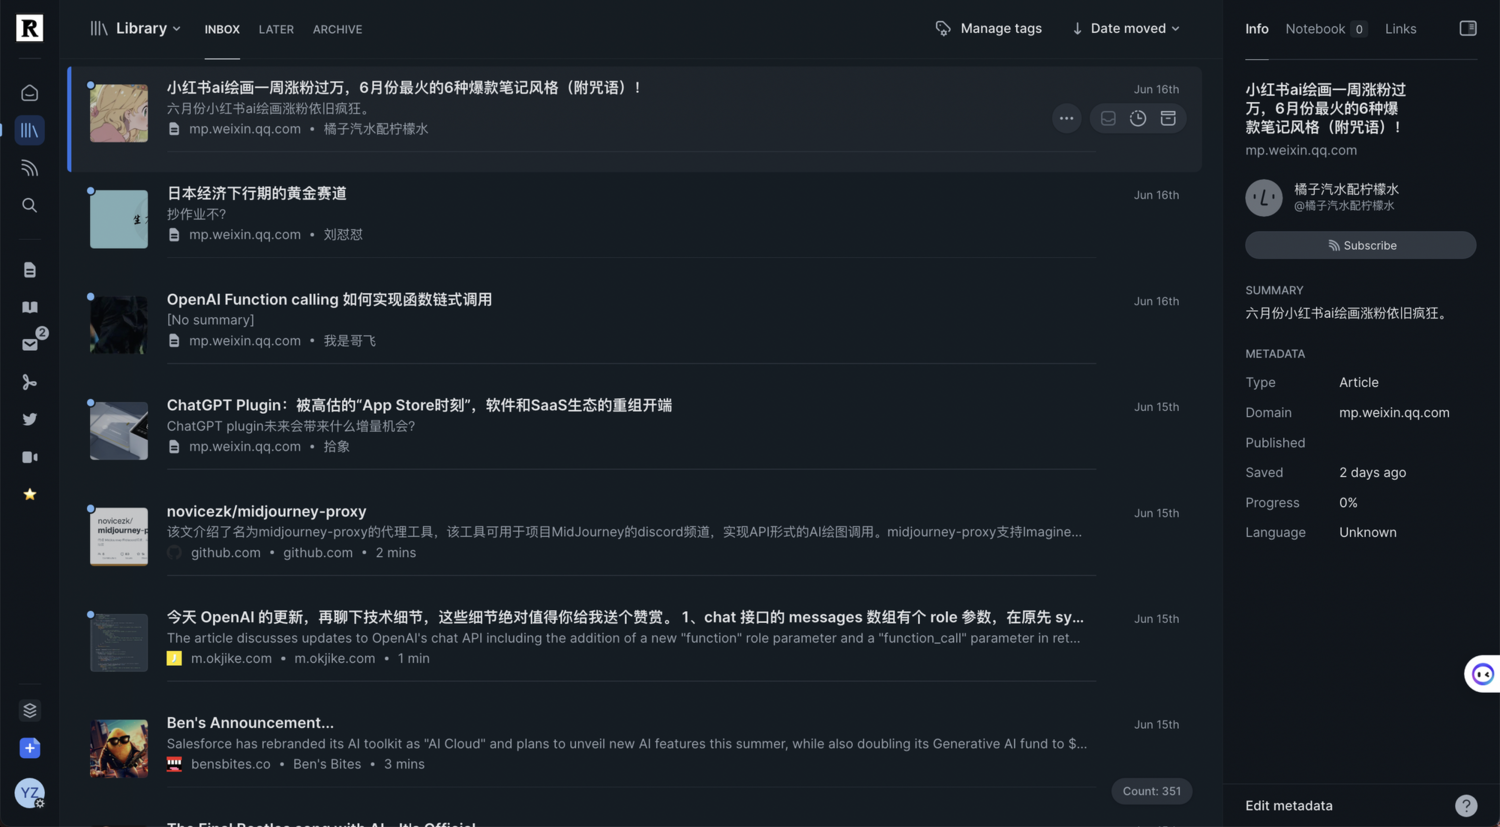
Readwise Reader 是最好用的阅读软件之一。
但作为一款海外产品,Readwise Reader 在中国有些许水土不服。
为了让你更好地使用 Readwise Reader ,我们做了一款小工具—— wechat 2 reader
这款小工具解决了两个问题:
1. 让收藏文章更加便捷,在微信内转发文章或链接,即可以收藏文章。
2. 解决了Readwise Reader 在收藏中文文章时,图片丢失的问题。
但作为一款海外产品,Readwise Reader 在中国有些许水土不服。
为了让你更好地使用 Readwise Reader ,我们做了一款小工具—— wechat 2 reader
这款小工具解决了两个问题:
1. 让收藏文章更加便捷,在微信内转发文章或链接,即可以收藏文章。
2. 解决了Readwise Reader 在收藏中文文章时,图片丢失的问题。
46 3020


我用 Kimi 最新的模型 Kimi-K2.8-preview 制作了 deepseek-v4.1-flash 的架构显示。
和 OpenAI 的 GPT-3 的架构进行对比。
transformer-vs-deepseek-3d.zhangyu12375.workers.dev
和 OpenAI 的 GPT-3 的架构进行对比。
transformer-vs-deepseek-3d.zhangyu12375.workers.dev
00:45
3 00
如果你能在 @Tabbit浏览器 里使用 Terminal 终端,你会____
01:31
2 01
明天要去看赵雷演唱会
今天一直在循环他的歌
然后居然发现
汽水音乐的歌就是听着比网易云的舒服很多,
音质很好。
但我想着不应该啊,
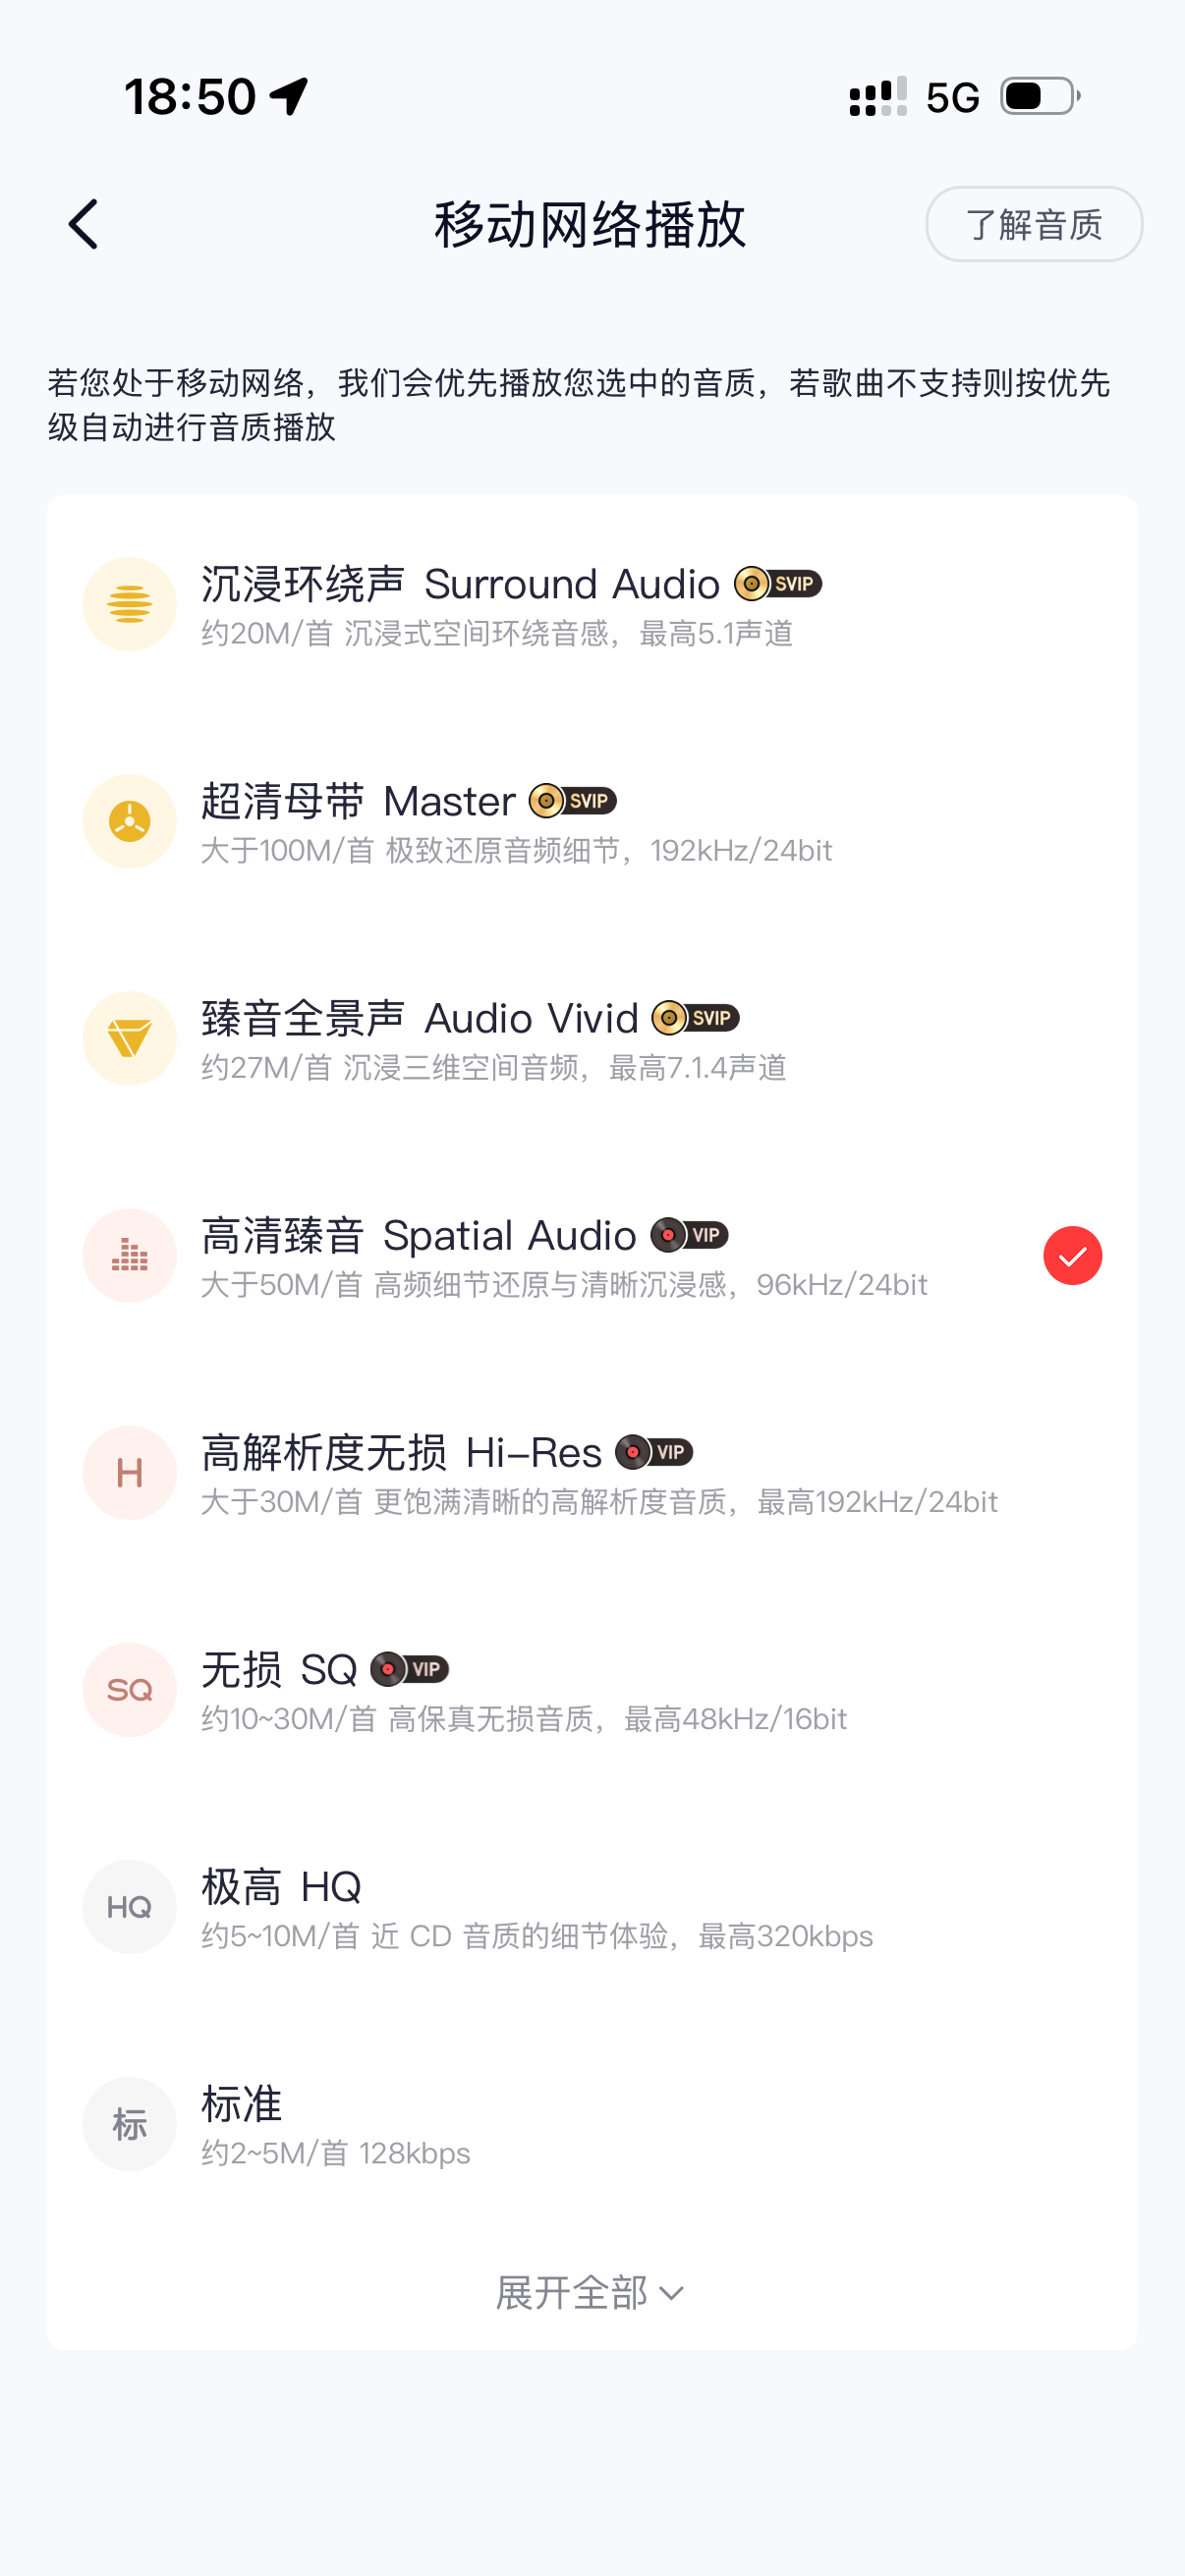
我网易云的音质一直开的是"极高"
然后我点进网易云一看👀
和这我这么好几年的会员都白开了。。。
在极高上面还有
• 沉浸环绕声 Surround Audio
• 超清母带 Master
• 臻音全景声 Audio Vivid
• 高清臻音 Spatial Audio
• 高解析度无损 Hi-Res
• 无损 SQ
• 极高 HQ
• 标准
我真服了啊,网易云的产品经理🫠
整天给我推音质会员,然后我开着黑胶会员给我用最烂的音质
今天一直在循环他的歌
然后居然发现
汽水音乐的歌就是听着比网易云的舒服很多,
音质很好。
但我想着不应该啊,
我网易云的音质一直开的是"极高"
然后我点进网易云一看👀
和这我这么好几年的会员都白开了。。。
在极高上面还有
• 沉浸环绕声 Surround Audio
• 超清母带 Master
• 臻音全景声 Audio Vivid
• 高清臻音 Spatial Audio
• 高解析度无损 Hi-Res
• 无损 SQ
• 极高 HQ
• 标准
我真服了啊,网易云的产品经理🫠
整天给我推音质会员,然后我开着黑胶会员给我用最烂的音质
5 11
如果我是飞书的产品经理,我就给每个私聊群聊都增加一个 git 仓库。
老实说,云端 Agent 的市场份额有没有本地 Agent 市场空间大还需要验证。
Agent 的市场份额,就是上下文在哪里的问题?
现阶段的上下文,大部分都在用户本地,因为最开始用起来的都是 pro-C 用户。大部分任务的上下文在用户本地,所以本地的 Agent 最先发展起来。
下一个阶段,大家都在说 Agent 要上云。
那么问题就是,有多少上下文需要上云呢?
上云的场景有几个
1. 本地空间不足,云端存储;
2. 需要协同或者分享;
而针对协作的需求,飞书,钉钉,企业微信这样的 IM 确实就是最好的载体。
但是需要协同的上下文,真的有那么多吗?这里用打个问号?
1. 我在本地编辑了很久的 PPT 准备了很久的稍等,最终上云的只有 PPT。
2. 我用 AI 抽卡视频很多次,最终需要上云分享和协作的,只有成功的那一次。
类比地来看。
实际上在线文档发展了很多年,飞书云文档,google docs 等等这么多平台加起来的数据量,数据量才慢慢超过 office 的传输。
市场空间有多大,
所以需要上云的上下文有没有那么多,要打个问号?
老实说,云端 Agent 的市场份额有没有本地 Agent 市场空间大还需要验证。
Agent 的市场份额,就是上下文在哪里的问题?
现阶段的上下文,大部分都在用户本地,因为最开始用起来的都是 pro-C 用户。大部分任务的上下文在用户本地,所以本地的 Agent 最先发展起来。
下一个阶段,大家都在说 Agent 要上云。
那么问题就是,有多少上下文需要上云呢?
上云的场景有几个
1. 本地空间不足,云端存储;
2. 需要协同或者分享;
而针对协作的需求,飞书,钉钉,企业微信这样的 IM 确实就是最好的载体。
但是需要协同的上下文,真的有那么多吗?这里用打个问号?
1. 我在本地编辑了很久的 PPT 准备了很久的稍等,最终上云的只有 PPT。
2. 我用 AI 抽卡视频很多次,最终需要上云分享和协作的,只有成功的那一次。
类比地来看。
实际上在线文档发展了很多年,飞书云文档,google docs 等等这么多平台加起来的数据量,数据量才慢慢超过 office 的传输。
市场空间有多大,
所以需要上云的上下文有没有那么多,要打个问号?
原动态已删除
3 20
Deepseek-V4.1-Flash 这个模型
感觉是 Deepseek 的阶段性成果的集大成者了:
这次把此前公开论文里的技术几乎都塞到这个模型里了。
🔹mHC 流形约束超连接:这次升级成 Single-Pass mHC,激活内存流量减半 arxiv.org
🔹Engram 条件记忆:把"记忆"从"计算"里解耦的稀疏查表模块,196B 参数,放在第 1、14 层,推理时从主机内存 RDMA 预取 arxiv.org
🔹DSpark 投机解码:半自回归草稿 + 置信度调度验证,3 层草稿器一次前向并行算 5 个草稿位置 arxiv.org
🔹DeepSeek-ViT:从零训的 ViT 补齐原生多模态(2D-RoPE、3×3 pixel-unshuffle 把视觉 token 压到 1/9)。之前发布了论文,但后来又悄悄删除了。
当然也有不少新东西,这次新增的主架构:
🔸CED 因果编解码器:40 层切成 20 层编码器 + 20 层解码器,解码器的全局 KV 不再自己算,直接用逐层投影权重从编码器末层隐状态投影出来。所以读输入只跑 20 层(8B 激活),写输出要跑 40 层(16B)。
类似 YOCO:arxiv.org
🔸CSA2 压缩稀疏注意力:前代 CSA 的升级版。每层静态指定 Full / Reindex / Reuse 三种模式,跨层共享 main KV 和 indexer K,并可复用 Top-K 稀疏索引。全局 KV 压到 890 bytes/token,约 V4-Flash 的 1/4。
同源思路见 IndexCache:arxiv.org
🔸 SWA Bounded Replay:滑动窗口有界重放,部署层的优化。使得持久化 KV 占用进一步降到 V4-Flash 的约 1/8。
这次的论文真的看爽了了
新模型介绍:www.deepseek.com
技术报告:huggingface.co
感觉是 Deepseek 的阶段性成果的集大成者了:
这次把此前公开论文里的技术几乎都塞到这个模型里了。
🔹mHC 流形约束超连接:这次升级成 Single-Pass mHC,激活内存流量减半 arxiv.org
🔹Engram 条件记忆:把"记忆"从"计算"里解耦的稀疏查表模块,196B 参数,放在第 1、14 层,推理时从主机内存 RDMA 预取 arxiv.org
🔹DSpark 投机解码:半自回归草稿 + 置信度调度验证,3 层草稿器一次前向并行算 5 个草稿位置 arxiv.org
🔹DeepSeek-ViT:从零训的 ViT 补齐原生多模态(2D-RoPE、3×3 pixel-unshuffle 把视觉 token 压到 1/9)。之前发布了论文,但后来又悄悄删除了。
当然也有不少新东西,这次新增的主架构:
🔸CED 因果编解码器:40 层切成 20 层编码器 + 20 层解码器,解码器的全局 KV 不再自己算,直接用逐层投影权重从编码器末层隐状态投影出来。所以读输入只跑 20 层(8B 激活),写输出要跑 40 层(16B)。
类似 YOCO:arxiv.org
🔸CSA2 压缩稀疏注意力:前代 CSA 的升级版。每层静态指定 Full / Reindex / Reuse 三种模式,跨层共享 main KV 和 indexer K,并可复用 Top-K 稀疏索引。全局 KV 压到 890 bytes/token,约 V4-Flash 的 1/4。
同源思路见 IndexCache:arxiv.org
🔸 SWA Bounded Replay:滑动窗口有界重放,部署层的优化。使得持久化 KV 占用进一步降到 V4-Flash 的约 1/8。
这次的论文真的看爽了了
新模型介绍:www.deepseek.com
技术报告:huggingface.co
DeepSeek V4.1 Flash:更强、更快、更普惠
10 01
相比起能不能实现 AGI,我更关心的是,什么模型能够又好又快地,完成我的工作。
所以
Kimi 什么时候发布 K3-Flash ?
OpenAI 什么时候发布 GPT-6-luna 啊!
所以
Kimi 什么时候发布 K3-Flash ?
OpenAI 什么时候发布 GPT-6-luna 啊!
大模型的最大价值,是蒸馏出更聪明的小模型
3 00