即刻App年轻人的同好社区
下载
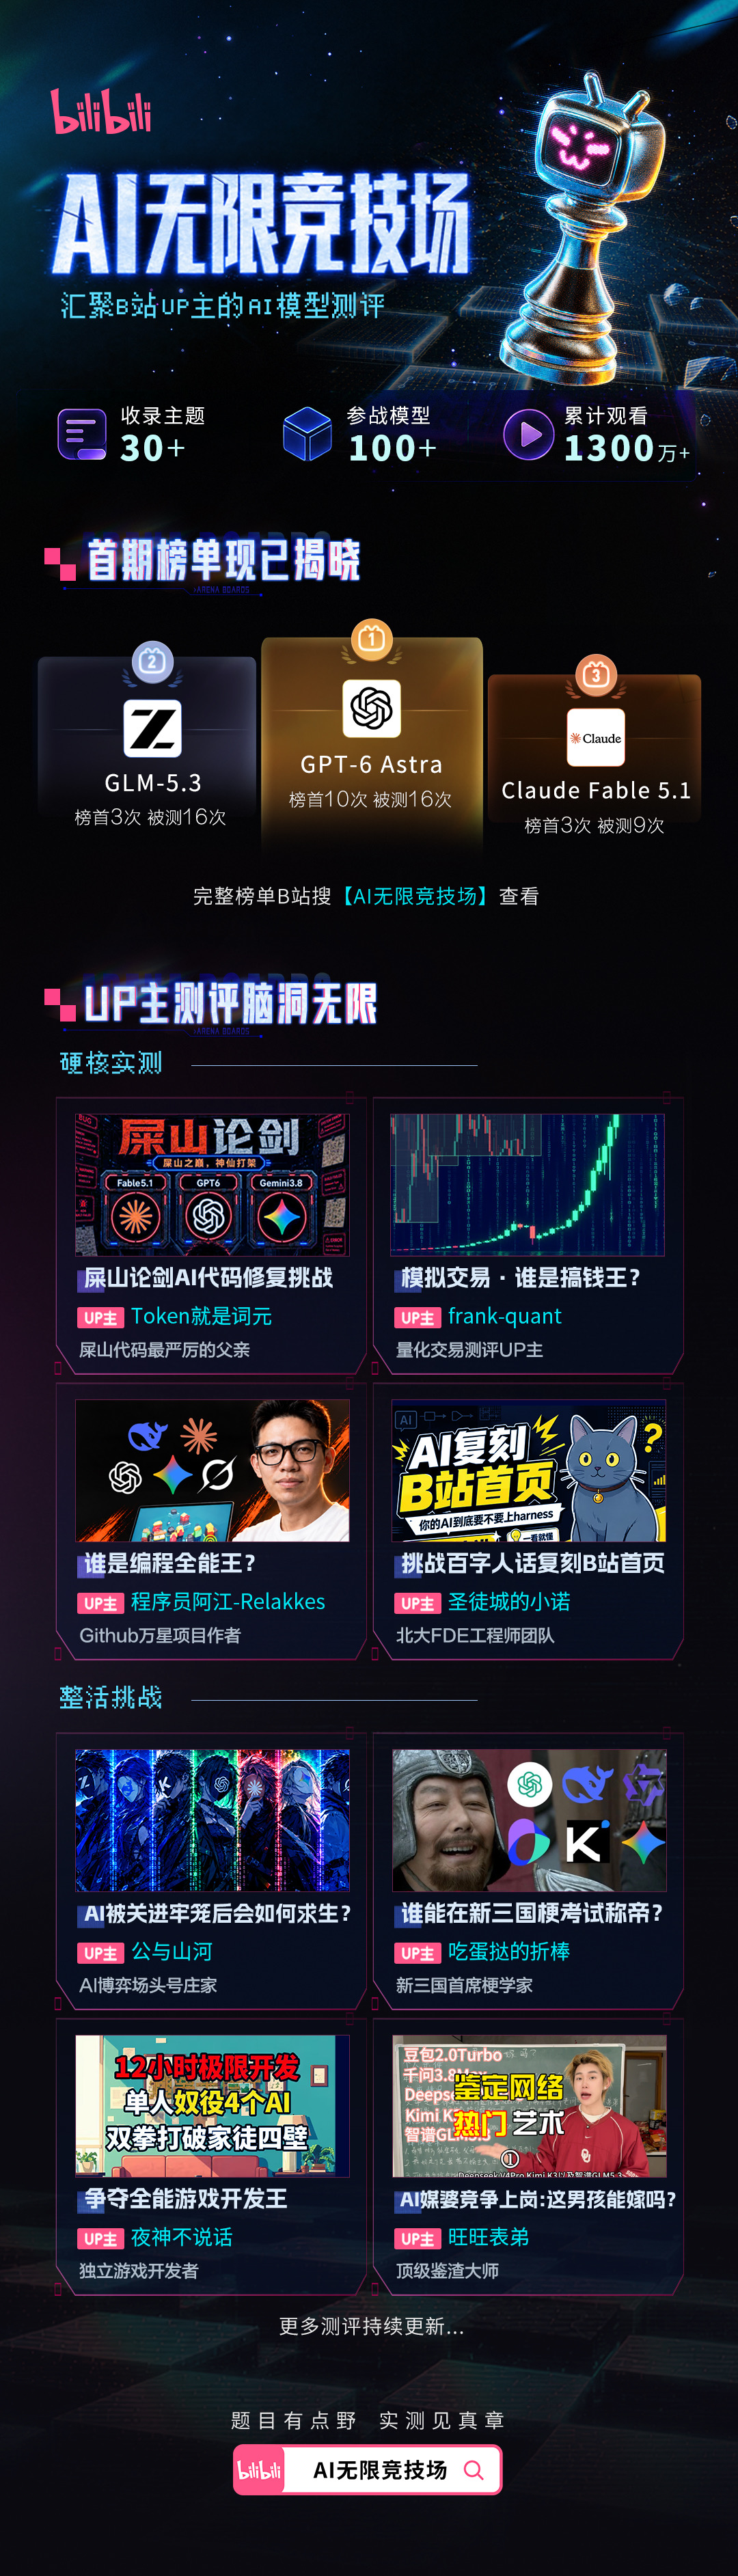
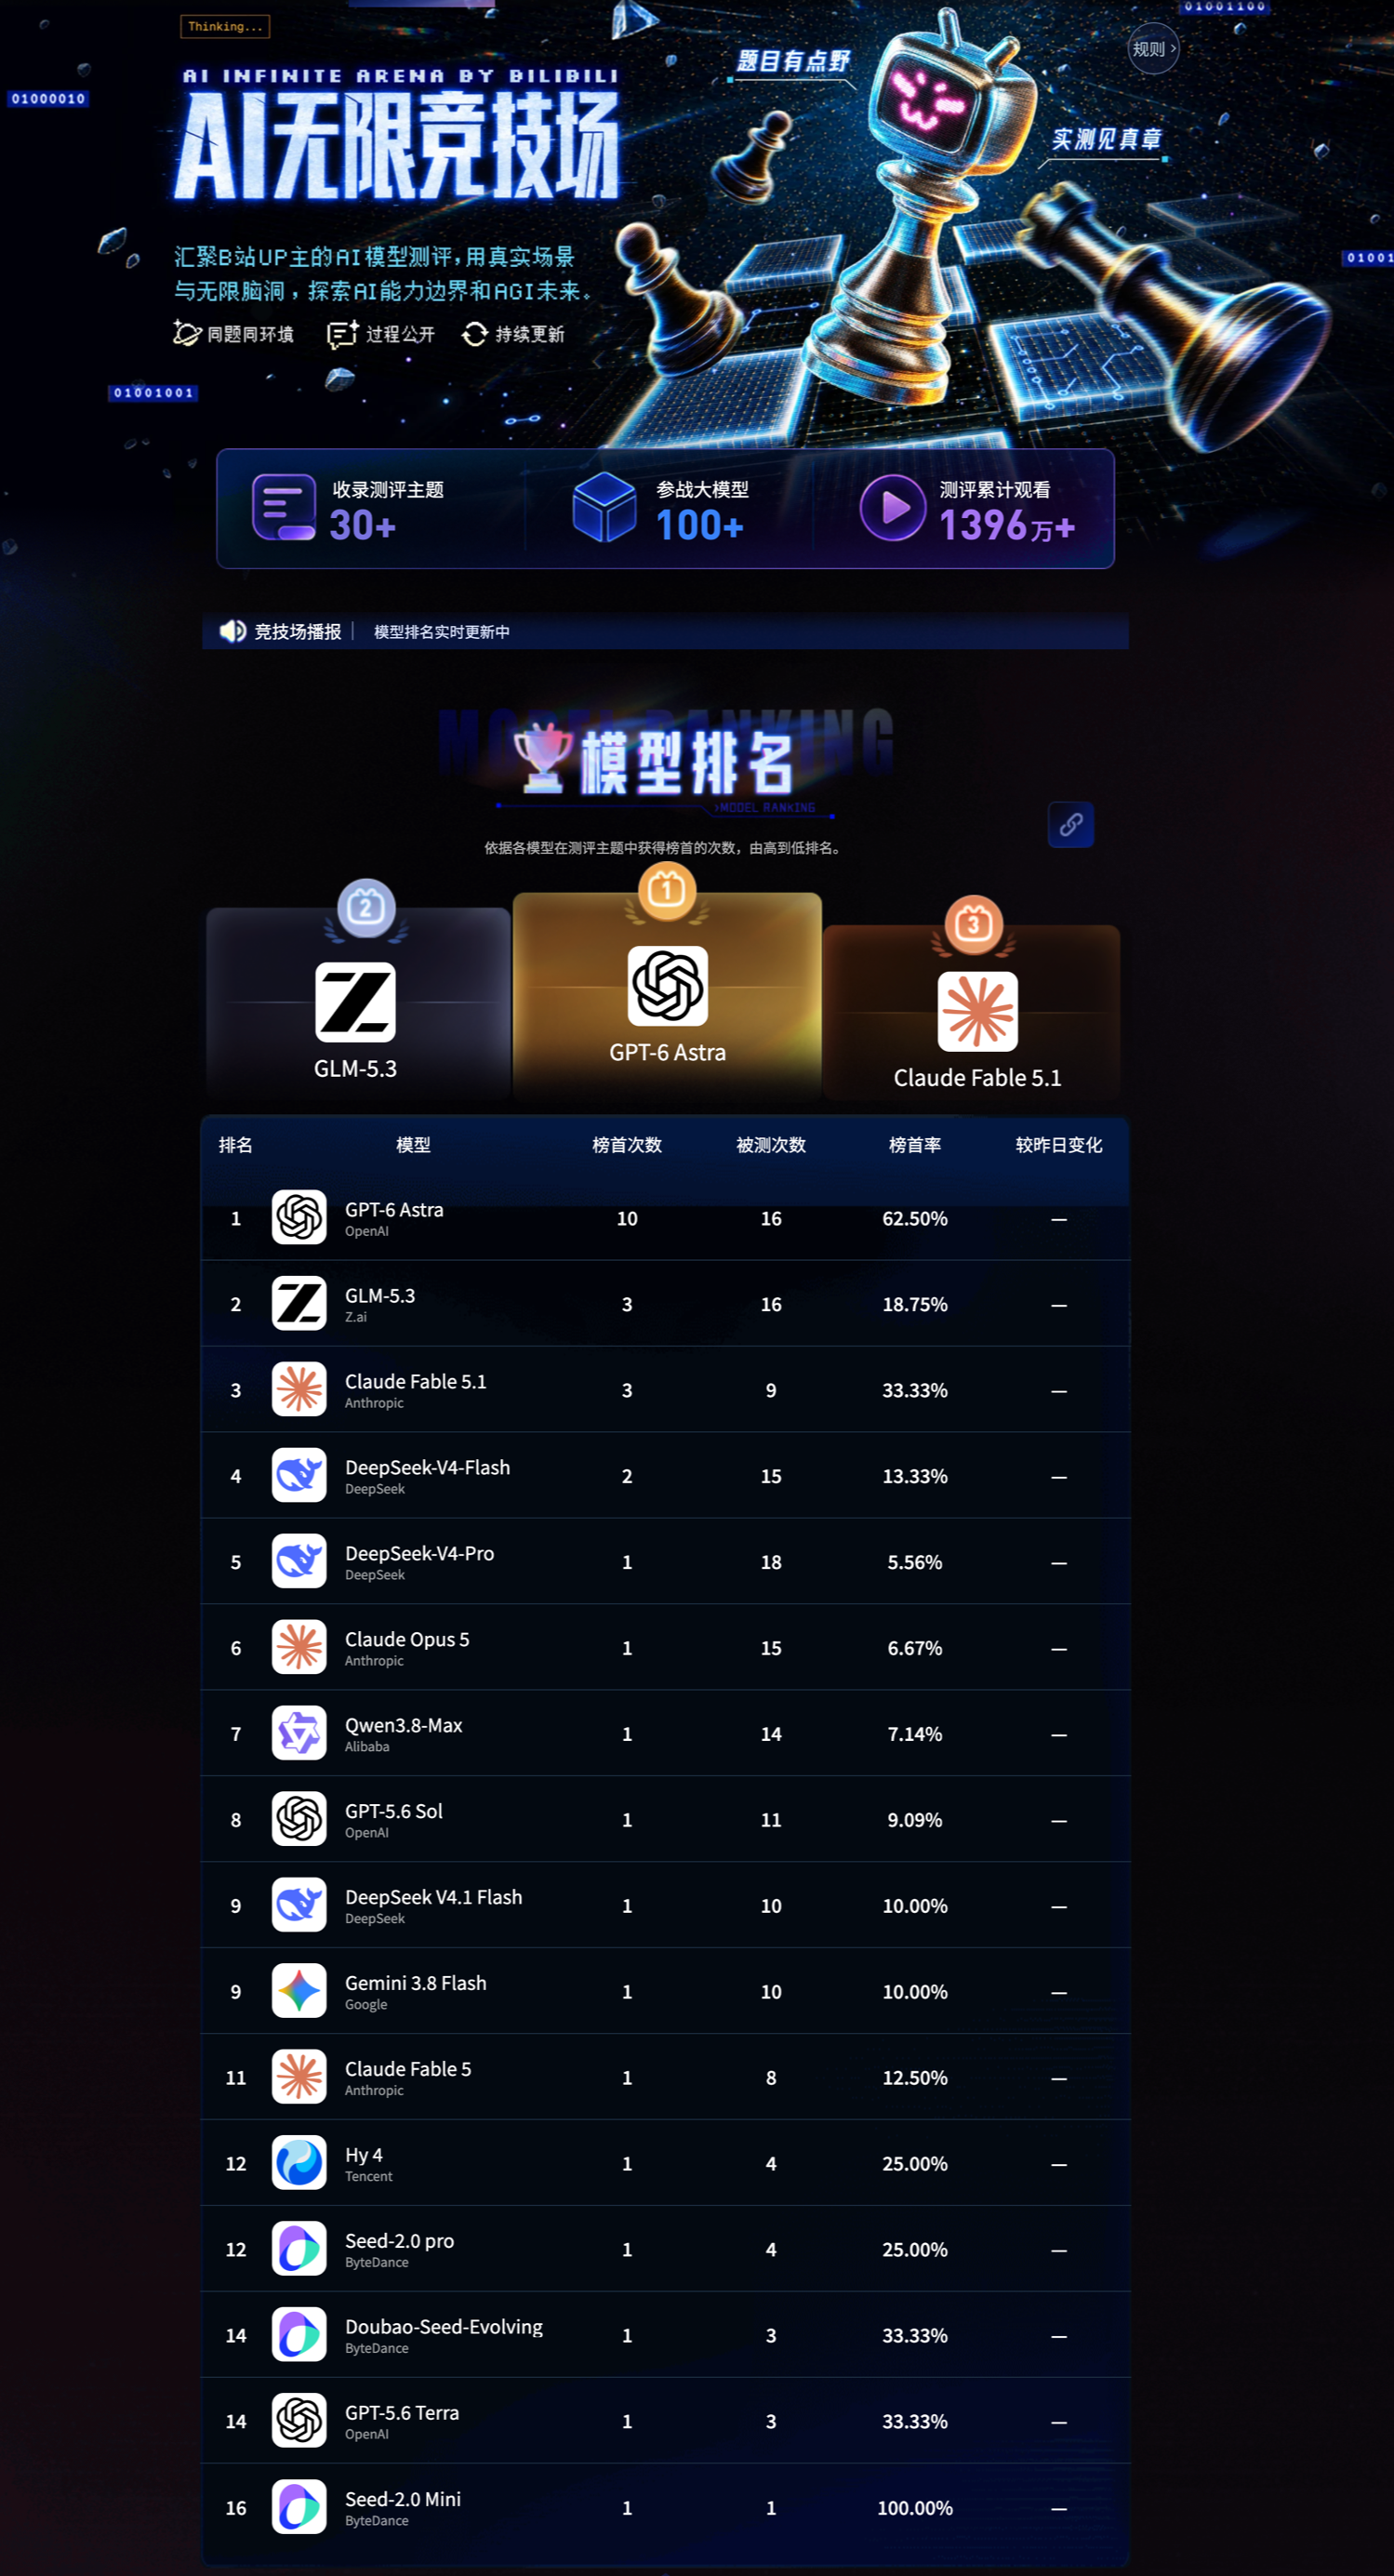
今天看到B站「AI无限竞技场」上线,首期大模型榜单也出了。第一期就有30+测评主题、100+模型。
尤其屎山论剑这类编程开发评测,也算是B站AI区UP主的传统艺能了。估计只有天天在祖传代码里挣扎的UP主才会这么整活,大模型好不容易走出实验室,发现外面的“屎山”更难越啊。
也正因为够野、够具体,模型能不能把事办成,一眼就看出来了。
我一直觉得,B站正在变成大模型的分布式测评节点。
每个UP主都是一个真实场景考官,专业不同、脑洞不同、折磨模型的方式也不同。传统跑分像体检,B站竞技场像直接拉去上工。
体检漂亮不代表好用,上工不翻车才是口碑。
对厂商,这里是越来越不能忽视的舆论场和检验场;对普通用户,这里能看到AI能力边界,也能降低学AI、用AI的门槛。
让我觉得在阿B上AI的平权的,是民间的,是很创意包容的,大家真的在拿AI干活、吐槽、复盘,还有各种整活。
榜单会实时更新,还开放全站UP主报名。我已经开始期待下一批刁钻命题了。
链接在这,很好玩:
www.bilibili.com
7 00
来自圈子
AI探索站
119432人已经加入