即刻App年轻人的同好社区
下载
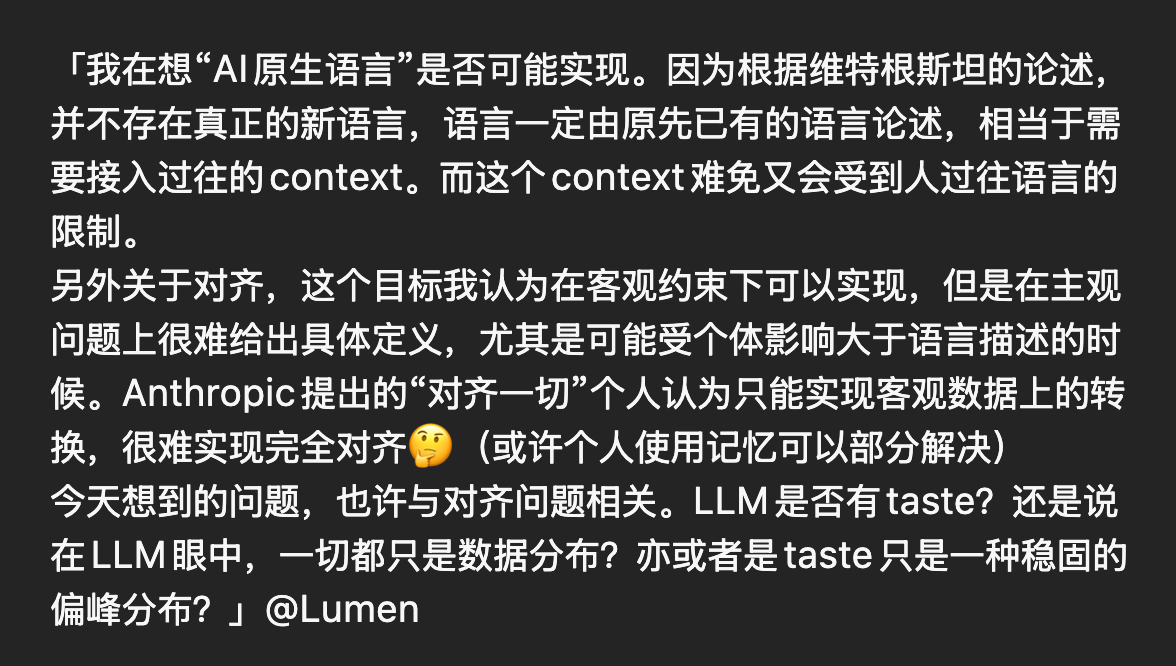
维特根斯坦的论述确实有趣,不过并非先验的
比如「语言一定由原先已有的语言论述」这句
逻辑上会形成无限后退:第一种语言从何而来?
然后从对齐这个问题而言的话,如何定义客观和主观呢?
所谓「主观主体」存在本身是一个客观存在的物理实现
那么所谓「个体影响」是否能用某种符号体系客观量化?
因为所谓「语言描述」是符合人类个体算力主要用于交流的符号
除了不少「历史遗留」问题关键在于这种符号本质上是约定俗成
所以基于人类语言的模型也许仅仅只是在对齐「人类群体记录」
综上回到「LLM是否有taste」这便是一个具体的好问题
关键在于你所定义的「taste」是否是「人类群体记录」的子集?
如果不是的话,这样的数据如何采集、编码且是否支持反向传播训练?
如果是的话,你如何评测「taste」本身,如何确认评测的信度和效度?
总而言之,模型所采用的符号体系也许决定了对齐的上限
因为模型的参数规模决定的是隐空间的尺寸,即「图书馆的建筑尺寸」
而语义空间取决于数据符号体系与表征信息,即「书籍构建的知识体系」
「北人不梦象」,对齐的前提是对齐的信息存在于这个「知识体系」中
从而有个有趣的问题是:
什么样的符号体系和内容能够生长出能够形成自洽逻辑的人工智能?
比如「语言一定由原先已有的语言论述」这句
逻辑上会形成无限后退:第一种语言从何而来?
然后从对齐这个问题而言的话,如何定义客观和主观呢?
所谓「主观主体」存在本身是一个客观存在的物理实现
那么所谓「个体影响」是否能用某种符号体系客观量化?
因为所谓「语言描述」是符合人类个体算力主要用于交流的符号
除了不少「历史遗留」问题关键在于这种符号本质上是约定俗成
所以基于人类语言的模型也许仅仅只是在对齐「人类群体记录」
综上回到「LLM是否有taste」这便是一个具体的好问题
关键在于你所定义的「taste」是否是「人类群体记录」的子集?
如果不是的话,这样的数据如何采集、编码且是否支持反向传播训练?
如果是的话,你如何评测「taste」本身,如何确认评测的信度和效度?
总而言之,模型所采用的符号体系也许决定了对齐的上限
因为模型的参数规模决定的是隐空间的尺寸,即「图书馆的建筑尺寸」
而语义空间取决于数据符号体系与表征信息,即「书籍构建的知识体系」
「北人不梦象」,对齐的前提是对齐的信息存在于这个「知识体系」中
从而有个有趣的问题是:
什么样的符号体系和内容能够生长出能够形成自洽逻辑的人工智能?
2 00
来自圈子
AI探索站
120753人已经加入