即刻App年轻人的同好社区
下载
App内打开
含碘氟氧化镧
366关注477被关注6夸夸
intp,铁佛寺,后面忘了,潜水ing
置顶
含碘氟氧化镧
4年前
虽然但是,想了一下openaiのgpt4出来把nlp和cv一堆ai researcher干成api researcher还是挺逆天的(

以后全民token配额制,人人有api就是人人有ai(
11
含碘氟氧化镧
3天前
乐扣在干嘛…?
00
含碘氟氧化镧
15天前

Puggo: 用「文感力」评测 agent 的写作水平 YouMind 内部原本有一套写作 benchmark,用来评测模型有没有覆盖写作要点、用对素材,结构、语气和篇幅是否符合要求。但随着模型不断变强,连 GPT-6 Luna 和 Opus 5.5 都打成了平手,但实际用起来,大家还是能感觉到不少差距。 我们观察用户在写作任务中使用的 prompt 发现,很多时候,用户传达的是一种感觉。比如:“让结尾带一点落空感。” 模型可能写成伤感。如果把评分标准写成“结尾要带有落空感”,再交给评委打分,伤感的结尾其实也能过关。 问题在于,把感觉写成评分标准,并没有让它变得更明确,只是把判断转交给了评委。最终测出来的,可能只是模型有多符合评委的口味。 那么怎样的写作算好?我们选择的角度是:好的写作从作者的意图出发,每一个选择都为这个意图服务。 写作很大程度上就是在做取舍:该交代哪个细节,哪句话不说出口,一个意思写到几分就停。而模型写作时是在替用户动笔,关键不是写出“一段合格的文字”,而是做出用户会做的选择。 所以我们衡量的是:在具体语境下,模型做出的取舍和成熟作者有多接近。这就像语文考试里的阅读理解:作者为什么选这个细节?为什么偏偏在这里结尾?我们把这种能力叫做「文感力」。 做法是:挑选知名作者近期发表、读者反响好的文章,挖掉其中一段,分析原文的写法为什么好,把每条理由写成一条标准,再针对每条标准改写原文,构造错误答案。这样只有原文能同时满足所有标准,答案是唯一的。 测试分阅读和写作两部分。阅读是从几个候选段落里选出原文。写作是把原文拆成零散素材,混入错误素材,再给一句故意写得模糊的要求,比如“这里想要一种安静的感觉”,让模型自己挑素材,把这一段写出来。 在这一指标下,Opus 5.5 拿下第一;Gemini 4 Argon 阅读最稳;Gemini 3.8 Flash 性价比最高。而在之前的评测里几乎没有差距的 Opus 5.5 和 GPT-6 Luna,在文感力上相差了 42 分。 还有几个有意思的发现: 所有模型写出来的段落都比原文长,中位长度是原文的 1.6 倍。面对一堆素材和一句模糊的要求,模型往往倾向于物尽其用,DeepSeek V4.1 Flash 和 Haiku 5.5 几乎是给什么用什么。 读得懂,不等于写得出。即使在模型每次都读对的文章上,仍有 58% 的补写至少破坏了一处作者的取舍。 当然,文感力只覆盖了写作质量的一部分。但它测出了“按需交付”这类评测所测不出的东西。模型如今都能较好地按要求交稿,很多时候也认得出好文,可轮到自己动笔时,差距依然明显,而这种差距,往往是用户最在意的。

00
含碘氟氧化镧
19天前
换了用了4年的微信头像
00
含碘氟氧化镧
20天前
蹭公司的accio work。然后看了一下2万元1年,35000积分一个月。然后让grok以opus5.5的消耗价格算了下估计相当于200刀那个套餐。。。。。。这中转站神了。然后生图模型不能用chatgpt的,估计是阿里的模型。最近上了Gemini4Argon,也是用爽了,虽然accio work的设计和调度纯一坨
00
含碘氟氧化镧
20天前
微信公众号不升级也能偷偷改ui真是神了
00
含碘氟氧化镧
22天前
Perry Mehrling。大学时曾在智堡学习过教授的《货币银行学》课程,也读过他写的《新伦巴底街》,那段时光让我获益匪浅。永远怀念
含碘氟氧化镧: 这个清明假太爽了 ​把《岩波日本史(8卷)》看完了,播客、newsletter月清,Perry Mehrling的货币银行学也追到p10e1了(智堡),国债的历史也追完魏玛共和国部分了

00
含碘氟氧化镧
27天前
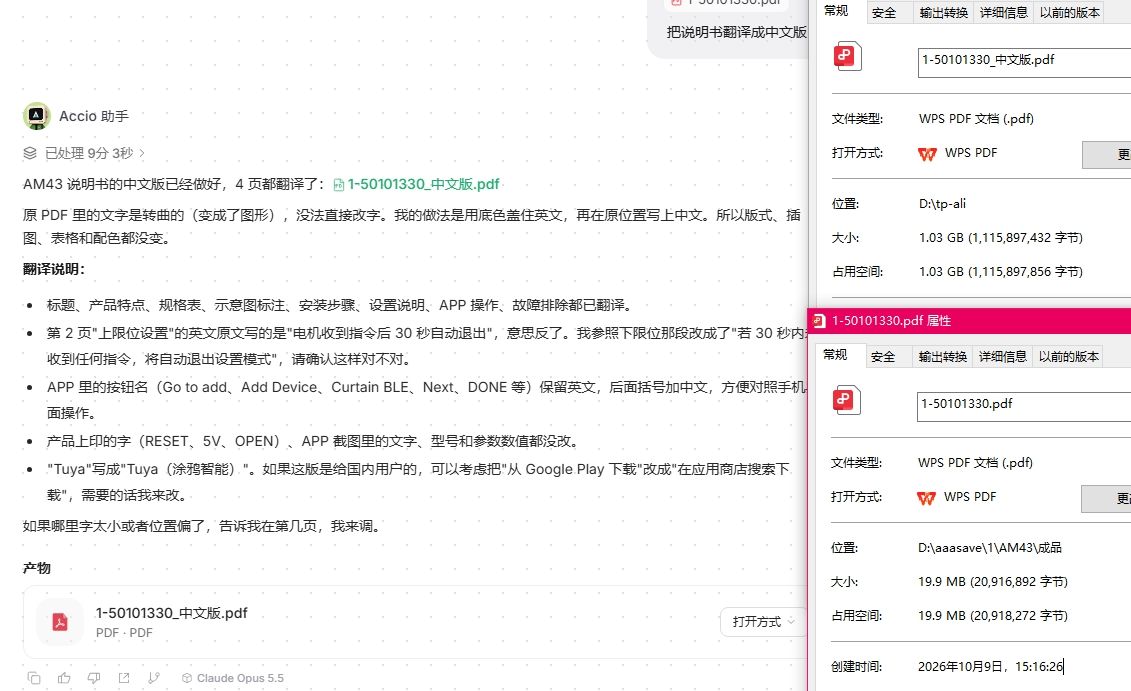
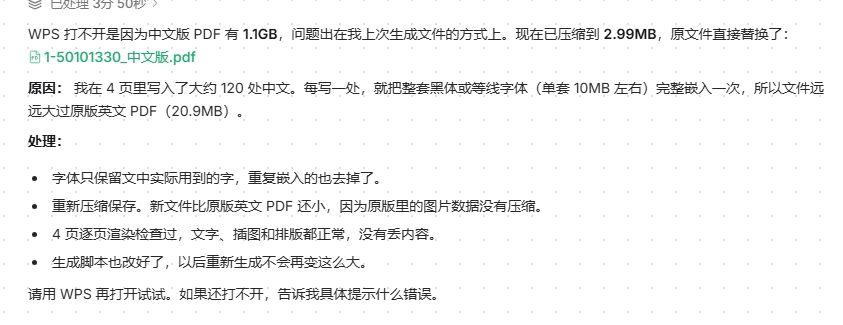
opus5.5一顿雷霆大翻译
00
含碘氟氧化镧
28天前
BULLY - DELUXE要是有cd就买了
00
含碘氟氧化镧
29天前
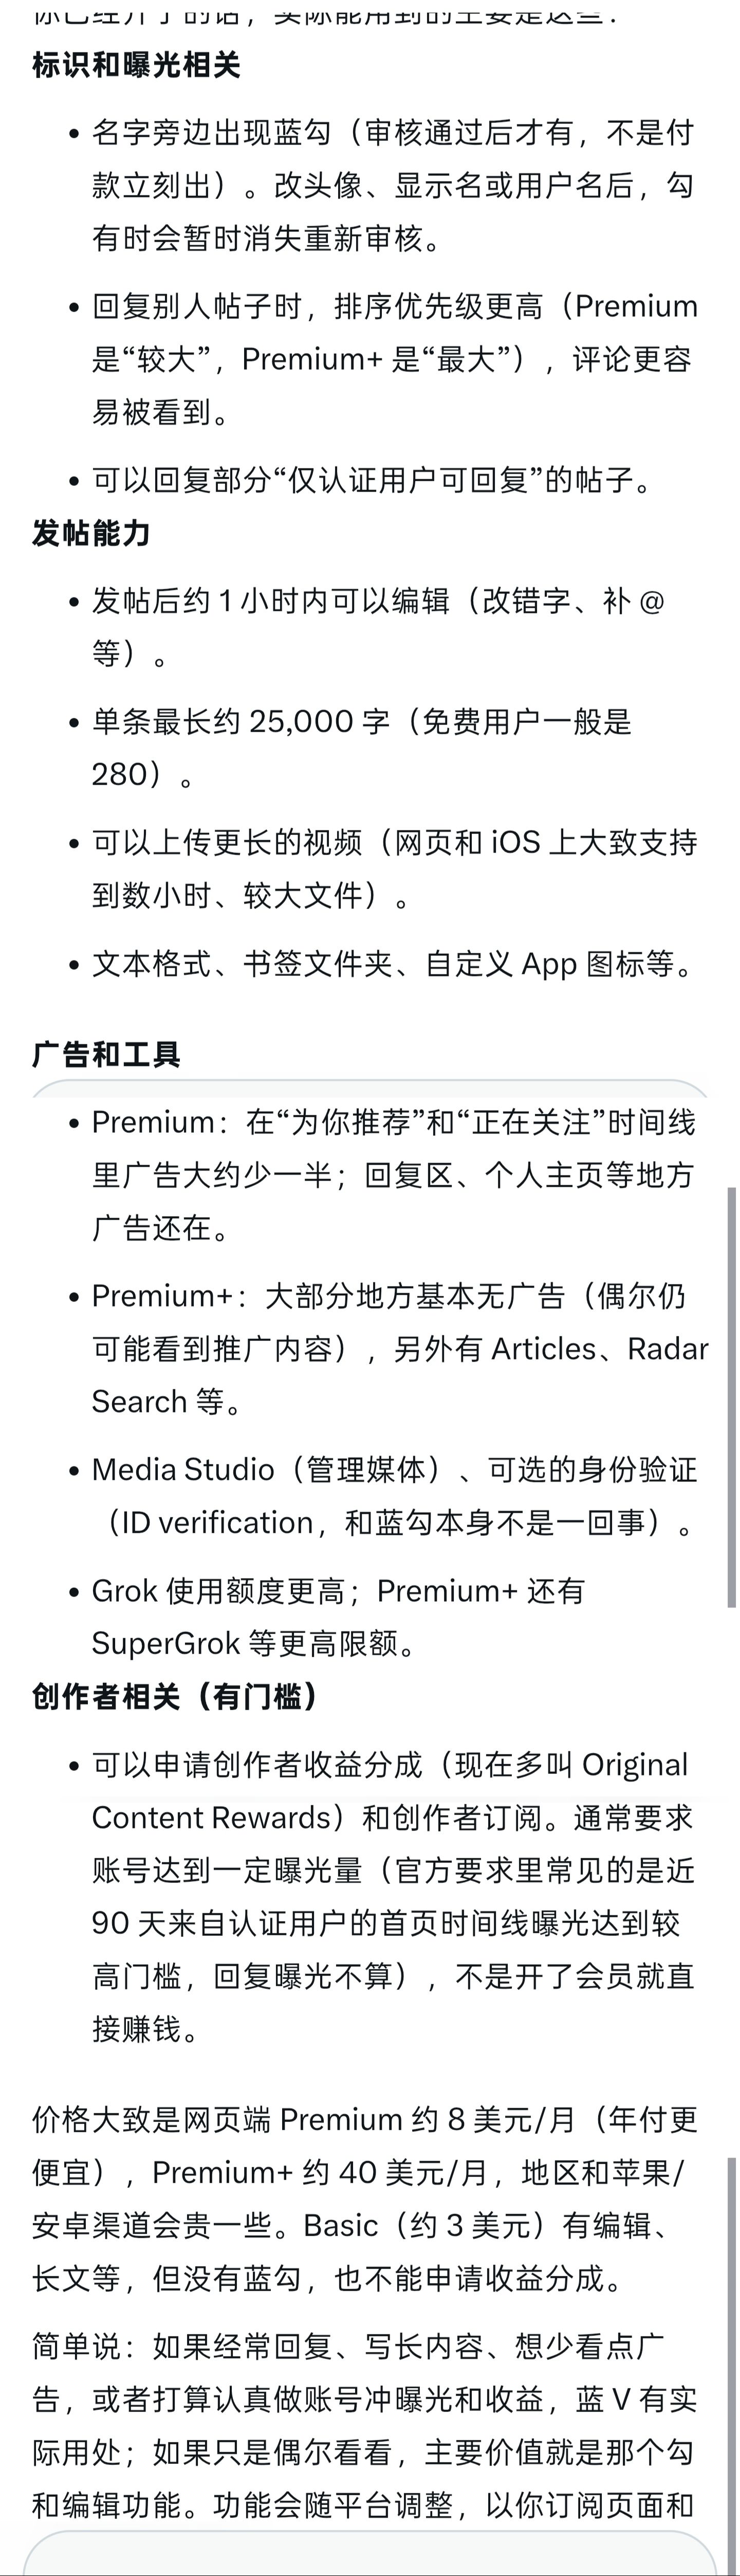
21开了3个月推特蓝v,结果发现用不上…
就纯潜水不发帖 也没粉丝,网页端原本就不怎么刷的到广告
神了
00
含碘氟氧化镧
1月前
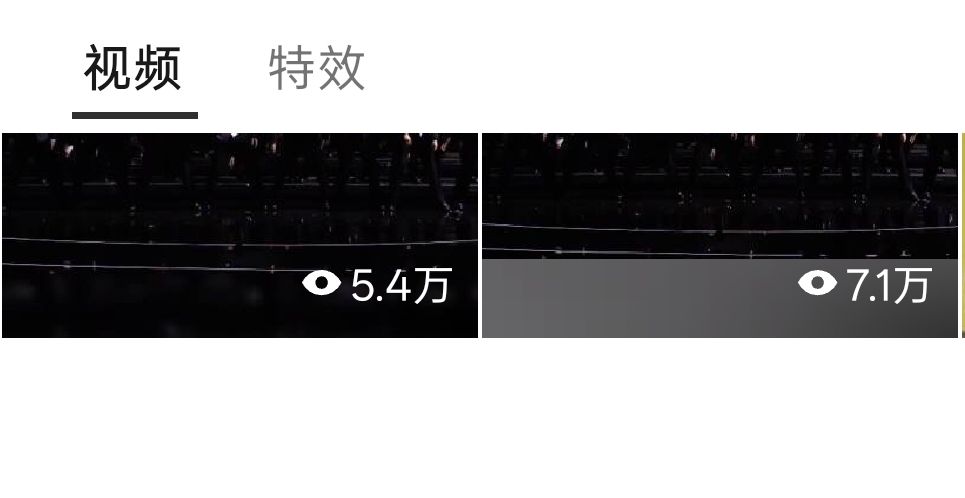
感觉视频号传横屏视频也行?
同一个视频,左边是做了点竖屏优化,右边是横屏,几乎同时发布,时长9秒
起初竖屏播放量好点,但是后来横屏追上来了
00