即刻App年轻人的同好社区
下载
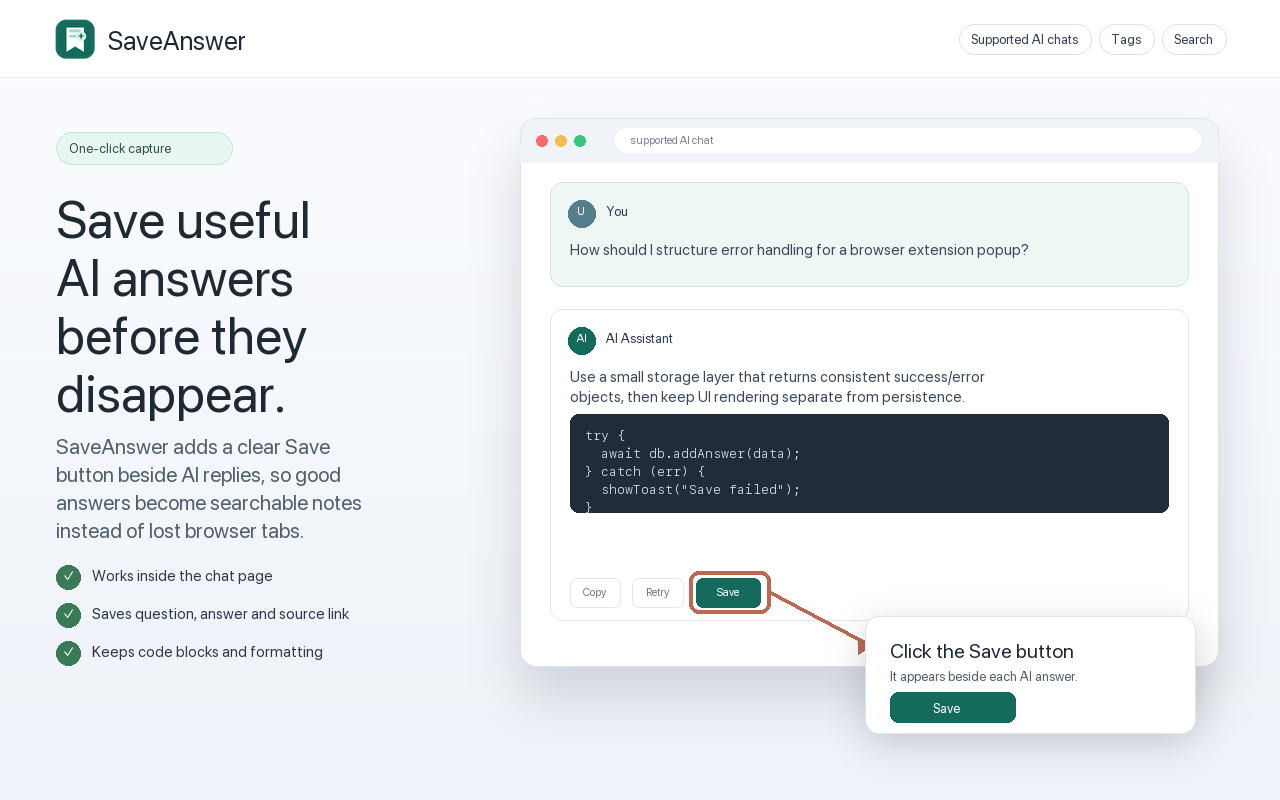
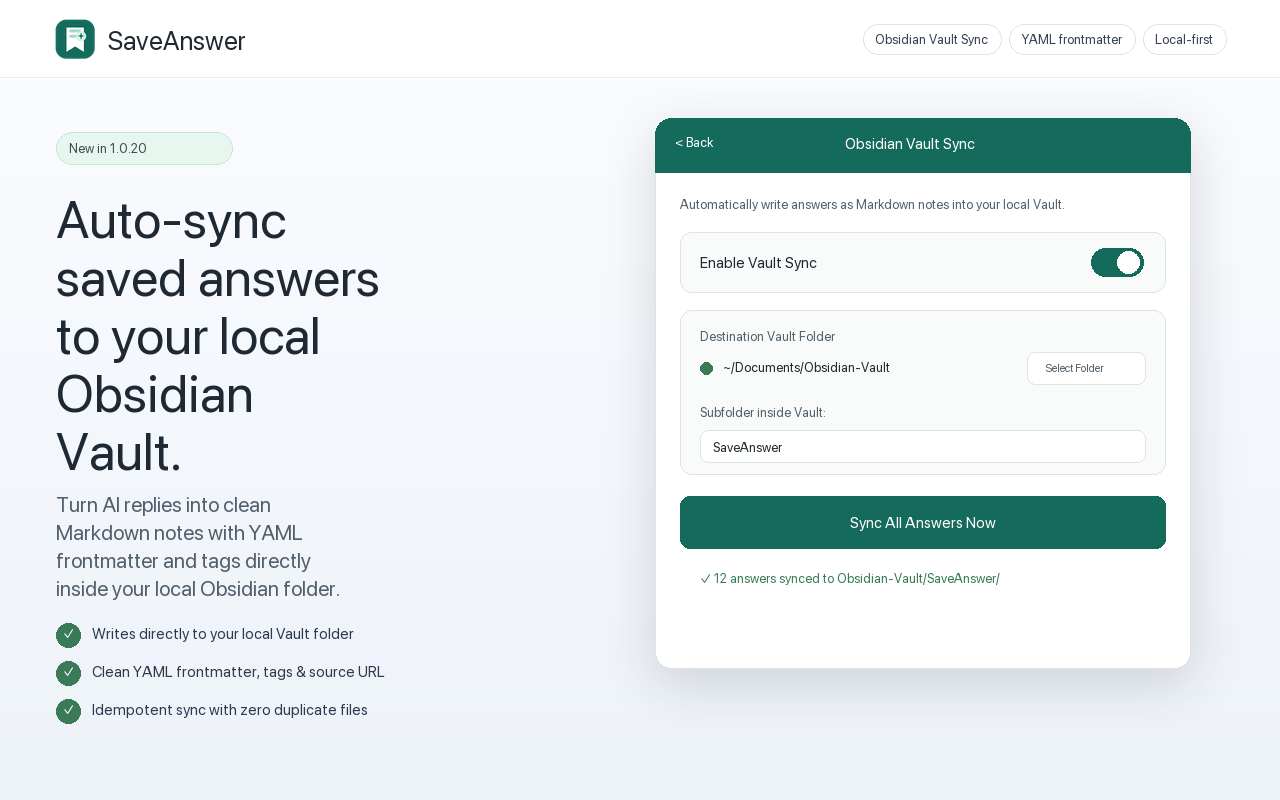
独立开发日常:为什么我们坚决把「纯本地隐私优先(Local-First)」刻进 SaveAnswer 的骨子里?\n\n很多做 AI 工具的朋友第一反应是买云服务器、搭后端、建用户系统。但在过去两周与大量深度用户的交流中,我们愈发坚信:对于沉淀个人知识库而言,中心化服务器反而是最大的隐患。\n\n大家在 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问 7 大主流 AI 平台里推演的内容,往往包含:\n• 公司的核心业务代码与架构排错\n• 尚未公开的商业规划与产品设想\n• 极具个人价值的定制 Prompt 与思考心流\n\n如果存个好回答还要上传到第三方云服务器,谁敢放心把核心资产交托出去?\n\n所以 SaveAnswer 从第一行代码起就坚守物理本地:\n1. 100% Local-First(纯本地无后端):基于 chrome.storage.local,零中心化服务器、不设账号注册、零数据采集,即便完全断网也能毫秒级离线全文检索。\n2. Obsidian 本地库直通同步:基于现代浏览器原生 File System Access API,将保存的高价值回答以规范 YAML frontmatter 实时写入本地 Obsidian 目录,不经过任何云端中转。\n3. 极简 1 秒留存:7 大平台回答操作栏旁原生嵌入 32px Save 按钮,原生长代码高亮、缩进排版与原对话追问链接 100% 完整捕获。\n\n真正的安全感,是数据永远物理留存在你自己的机器上。\n\n官网落地页(含 7 幕动图演示):charmlynn.github.io\nGitHub 开源仓库:github.com
0 00
独立开发日常:为什么我们坚决把「纯本地隐私优先(Local-First)」刻进 SaveAnswer 的骨子里?
很多做 AI 工具的朋友第一反应是买云服务器、搭后端、建用户系统。但在过去两周与大量深度用户的交流中,我们愈发坚信:对于沉淀个人知识库而言,中心化服务器反而是最大的隐患。
大家在 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问 7 大主流 AI 平台里推演的内容,往往包含:
• 公司的核心业务代码与架构排错
• 尚未公开的商业规划与产品设想
• 极具个人价值的定制 Prompt 与思考心流
如果存个好回答还要上传到第三方云服务器,谁敢放心把核心资产交托出去?
所以 SaveAnswer 从第一行代码起就坚守物理本地:
1. 100% Local-First(纯本地无后端):基于 chrome.storage.local,零中心化服务器、不设账号注册、零数据采集,即便完全断网也能毫秒级离线全文检索。
2. Obsidian 本地库直通同步:基于现代浏览器原生 File System Access API,将保存的高价值回答以规范 YAML frontmatter 实时写入本地 Obsidian 目录,不经过任何云端中转。
3. 极简 1 秒留存:7 大平台回答操作栏旁原生嵌入 32px Save 按钮,原生长代码高亮、缩进排版与原对话追问链接 100% 完整捕获。
真正的安全感,是数据永远物理留存在你自己的机器上。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
很多做 AI 工具的朋友第一反应是买云服务器、搭后端、建用户系统。但在过去两周与大量深度用户的交流中,我们愈发坚信:对于沉淀个人知识库而言,中心化服务器反而是最大的隐患。
大家在 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问 7 大主流 AI 平台里推演的内容,往往包含:
• 公司的核心业务代码与架构排错
• 尚未公开的商业规划与产品设想
• 极具个人价值的定制 Prompt 与思考心流
如果存个好回答还要上传到第三方云服务器,谁敢放心把核心资产交托出去?
所以 SaveAnswer 从第一行代码起就坚守物理本地:
1. 100% Local-First(纯本地无后端):基于 chrome.storage.local,零中心化服务器、不设账号注册、零数据采集,即便完全断网也能毫秒级离线全文检索。
2. Obsidian 本地库直通同步:基于现代浏览器原生 File System Access API,将保存的高价值回答以规范 YAML frontmatter 实时写入本地 Obsidian 目录,不经过任何云端中转。
3. 极简 1 秒留存:7 大平台回答操作栏旁原生嵌入 32px Save 按钮,原生长代码高亮、缩进排版与原对话追问链接 100% 完整捕获。
真正的安全感,是数据永远物理留存在你自己的机器上。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
0 00
独立开发日常:为什么我们坚决把「纯本地隐私优先(Local-First)」刻进 SaveAnswer 的骨子里?
很多做 AI 工具的朋友第一反应是买云服务器、搭后端、建用户系统。但在过去两周与大量深度用户的交流中,我们愈发坚信:对于沉淀个人知识库而言,中心化服务器反而是最大的隐患。
大家在 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问 7 大主流 AI 平台里推演的内容,往往包含:
• 公司的核心业务代码与架构排错
• 尚未公开的商业规划与产品设想
• 极具个人价值的定制 Prompt 与思考心流
如果存个好回答还要上传到第三方云服务器,谁敢放心把核心资产交托出去?
所以 SaveAnswer 从第一行代码起就坚守物理本地:
1. 100% Local-First(纯本地无后端):基于 chrome.storage.local,零中心化服务器、不设账号注册、零数据采集,即便完全断网也能毫秒级离线全文检索。
2. Obsidian 本地库直通同步:基于现代浏览器原生 File System Access API,将保存的高价值回答以规范 YAML frontmatter 实时写入本地 Obsidian 目录,不经过任何云端中转。
3. 极简 1 秒留存:7 大平台回答操作栏旁原生嵌入 32px Save 按钮,原生长代码高亮、缩进排版与原对话追问链接 100% 完整捕获。
真正的安全感,是数据永远物理留存在你自己的机器上。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
很多做 AI 工具的朋友第一反应是买云服务器、搭后端、建用户系统。但在过去两周与大量深度用户的交流中,我们愈发坚信:对于沉淀个人知识库而言,中心化服务器反而是最大的隐患。
大家在 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问 7 大主流 AI 平台里推演的内容,往往包含:
• 公司的核心业务代码与架构排错
• 尚未公开的商业规划与产品设想
• 极具个人价值的定制 Prompt 与思考心流
如果存个好回答还要上传到第三方云服务器,谁敢放心把核心资产交托出去?
所以 SaveAnswer 从第一行代码起就坚守物理本地:
1. 100% Local-First(纯本地无后端):基于 chrome.storage.local,零中心化服务器、不设账号注册、零数据采集,即便完全断网也能毫秒级离线全文检索。
2. Obsidian 本地库直通同步:基于现代浏览器原生 File System Access API,将保存的高价值回答以规范 YAML frontmatter 实时写入本地 Obsidian 目录,不经过任何云端中转。
3. 极简 1 秒留存:7 大平台回答操作栏旁原生嵌入 32px Save 按钮,原生长代码高亮、缩进排版与原对话追问链接 100% 完整捕获。
真正的安全感,是数据永远物理留存在你自己的机器上。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
0 00
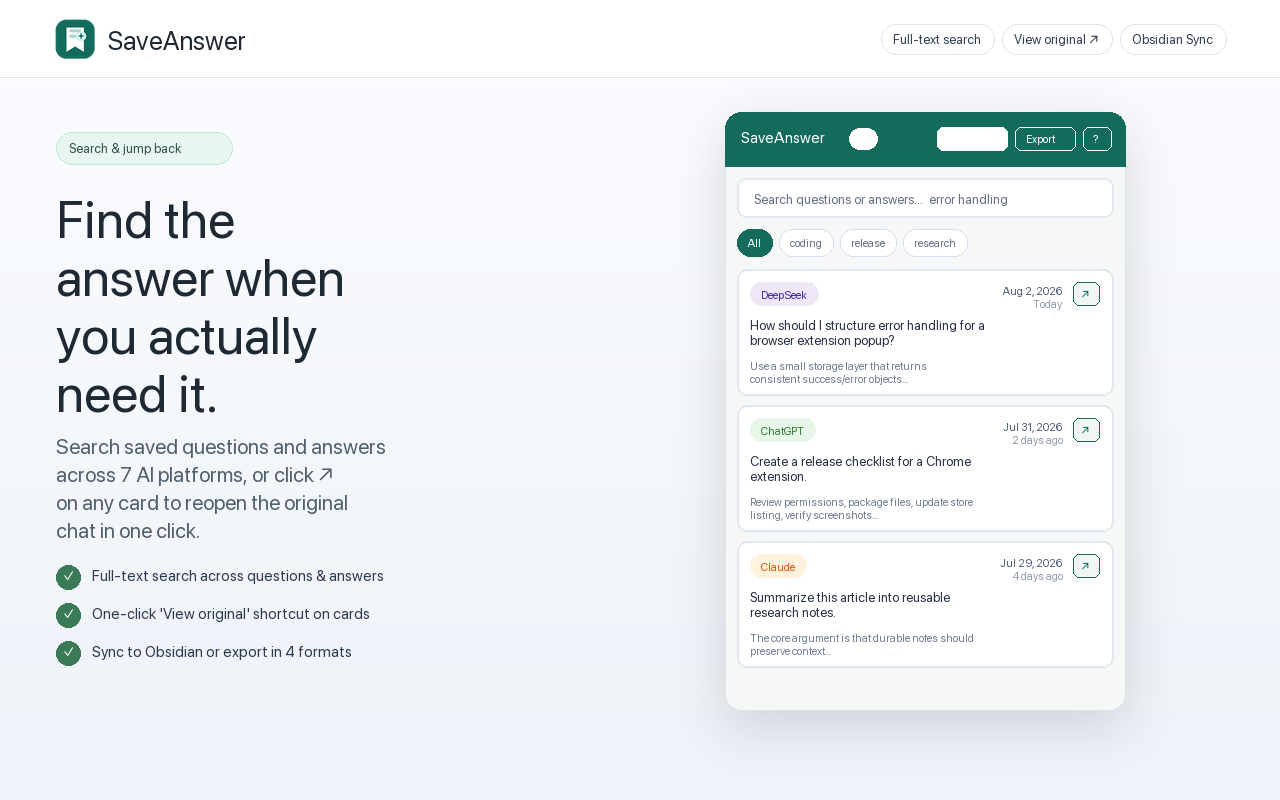
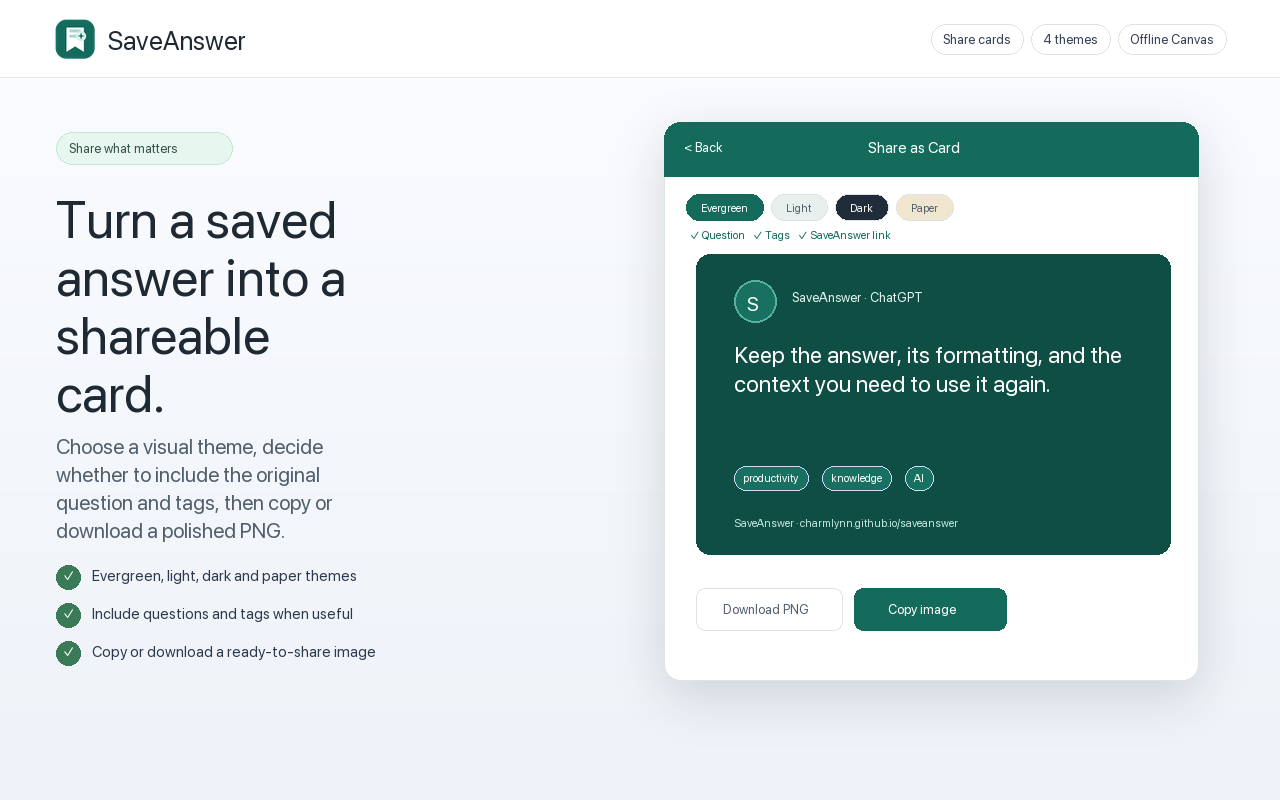
这几天和几位重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的朋友交流,大家普遍聊到一个特别共鸣的场景:存下好回答只是第一步,但很多传统笔记存完之后就成了“死文本”——过了两周你想顺着当时的推演继续追问细节,早已找不到原会话;或者你只模糊记得让 AI 写过某个算法,却完全想不起到底是在哪个平台的对话列表里。所以我们在 SaveAnswer 里死磕了两个关键体验:1. 跨 7 大平台毫秒级全文检索:不管是哪家 AI 聊出的优质内容,全部汇集在本地同一个资料库。弹窗输入关键词,毫秒级正文检索并保真呈现代码高亮。2. 卡片右上角的「一键原路追问(↗)」:每条留存的回答自动长效绑定原始对话链接。点击即可直达原会话窗口,无缝顺着当时的心流继续深聊。依然坚守 Local-First(纯本地隐私优先):零中心化服务器、不设账号体系、数据 100% 物理留存本地(chrome.storage.local)。支持本地 Obsidian Vault 自动同步,也可导出纯净 Markdown、Word、PDF 与 2D Canvas 离线长图。先把好答案存得住、找得到、能追问,知识资产才会真正产生长期复利。官网落地页(含 7 幕动图演示):charmlynn.github.io 开源仓库:github.com
0 00
独立开发日常:为什么我们坚决把「跨平台全文检索 + 一键跳回原对话」做成 SaveAnswer 的核心体验?
这几天和几位重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的朋友交流,大家普遍聊到一个特别共鸣的场景:
存下好回答只是第一步,但很多传统笔记存完之后就成了“死文本”——过了两周你想顺着当时的推演继续追问细节,早已找不到原会话;或者你只模糊记得让 AI 写过某个算法,却完全想不起到底是在哪个平台的对话列表里。
所以我们在 SaveAnswer 里死磕了两个关键体验:
1. 跨 7 大平台毫秒级全文检索:不管是哪家 AI 聊出的优质内容,全部汇集在本地同一个资料库。弹窗输入关键词,毫秒级正文检索并保真呈现代码高亮。
2. 卡片右上角的「一键原路追问(↗)」:每条留存的回答自动长效绑定原始对话链接。点击即可直达原会话窗口,无缝顺着当时的心流继续深聊。
依然坚守 Local-First(纯本地隐私优先):零中心化服务器、不设账号体系、数据 100% 物理留存本地(chrome.storage.local)。支持本地 Obsidian Vault 自动同步,也可导出纯净 Markdown、Word、PDF 与 2D Canvas 离线长图。
先把好答案存得住、找得到、能追问,知识资产才会真正产生长期复利。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
这几天和几位重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的朋友交流,大家普遍聊到一个特别共鸣的场景:
存下好回答只是第一步,但很多传统笔记存完之后就成了“死文本”——过了两周你想顺着当时的推演继续追问细节,早已找不到原会话;或者你只模糊记得让 AI 写过某个算法,却完全想不起到底是在哪个平台的对话列表里。
所以我们在 SaveAnswer 里死磕了两个关键体验:
1. 跨 7 大平台毫秒级全文检索:不管是哪家 AI 聊出的优质内容,全部汇集在本地同一个资料库。弹窗输入关键词,毫秒级正文检索并保真呈现代码高亮。
2. 卡片右上角的「一键原路追问(↗)」:每条留存的回答自动长效绑定原始对话链接。点击即可直达原会话窗口,无缝顺着当时的心流继续深聊。
依然坚守 Local-First(纯本地隐私优先):零中心化服务器、不设账号体系、数据 100% 物理留存本地(chrome.storage.local)。支持本地 Obsidian Vault 自动同步,也可导出纯净 Markdown、Word、PDF 与 2D Canvas 离线长图。
先把好答案存得住、找得到、能追问,知识资产才会真正产生长期复利。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
0 00
独立开发日常:为什么我们坚持把 SaveAnswer 做成「无感嵌入」与「纯本地优先」?
这几个月在打磨 SaveAnswer 的过程中,收到很多重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的朋友反馈。大家普遍提到一个共同的困扰:
在 AI 里聊出了特别惊艳的架构代码或排查思路,当时觉得很有用,但过几天再想找时,早已淹没在上百条对话列表里;如果每次都手动切屏、建笔记、调代码缩进,存两条就会因为心流被打断而彻底放弃。
所以我们从第一天起就定下了两个极度克制的原则:
1. 坚决不做常驻大侧边栏或悬浮球,不遮挡视线、不占内存。而是在 7 大主流 AI 平台每条回答底部,规范嵌入一个原生自适应的 32px Save 按钮。看到好答案随手一点,1 秒无感留存,原生长代码高亮、缩进与原始对话链接无损保留。
2. 坚守 Local-First(纯本地隐私优先)。数据只保存在浏览器本地(chrome.storage.local),不建中心化服务器、不设账号体系、零数据追踪。日常提问里的业务代码与商业 Prompt,100% 物理留存在自己的设备上。
同时为了满足深度沉淀需求,打通了 Obsidian Vault 本地自动同步(带规范 YAML frontmatter 与标签),支持一键导出纯净 Markdown、Word、PDF,或内置 Canvas 2D 离线生成长图。
先把「好答案能 1 秒存下且不丢、随时能找回并追问」这件最基础的事情做好,你的专属知识资产才会真正自然生长出来。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
这几个月在打磨 SaveAnswer 的过程中,收到很多重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的朋友反馈。大家普遍提到一个共同的困扰:
在 AI 里聊出了特别惊艳的架构代码或排查思路,当时觉得很有用,但过几天再想找时,早已淹没在上百条对话列表里;如果每次都手动切屏、建笔记、调代码缩进,存两条就会因为心流被打断而彻底放弃。
所以我们从第一天起就定下了两个极度克制的原则:
1. 坚决不做常驻大侧边栏或悬浮球,不遮挡视线、不占内存。而是在 7 大主流 AI 平台每条回答底部,规范嵌入一个原生自适应的 32px Save 按钮。看到好答案随手一点,1 秒无感留存,原生长代码高亮、缩进与原始对话链接无损保留。
2. 坚守 Local-First(纯本地隐私优先)。数据只保存在浏览器本地(chrome.storage.local),不建中心化服务器、不设账号体系、零数据追踪。日常提问里的业务代码与商业 Prompt,100% 物理留存在自己的设备上。
同时为了满足深度沉淀需求,打通了 Obsidian Vault 本地自动同步(带规范 YAML frontmatter 与标签),支持一键导出纯净 Markdown、Word、PDF,或内置 Canvas 2D 离线生成长图。
先把「好答案能 1 秒存下且不丢、随时能找回并追问」这件最基础的事情做好,你的专属知识资产才会真正自然生长出来。
官网落地页(含 7 幕动图演示):charmlynn.github.io
GitHub 开源仓库:github.com
0 00
独立开发思考:为什么很多 AI 知识管理工具看似功能强大,用户却用不起来?——从 SaveAnswer 的「极简低阻力设计」聊起
做 SaveAnswer 这段时间,和很多日常重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的开发者交流,发现一个普遍的痛点:
很多人都曾试图用复杂 Notion 数据库、本地向量库或重型 RAG 搭建个人知识库,但折腾了一两个周末,最后几乎无一例外沦为了“落灰死仓库”。
为什么会这样?核心原因往往在于两点:
1. 单次录入摩擦力过高:在 AI 里聊出一段绝妙的架构或排查代码时,正处于深度思考心流中。如果必须切屏、建页面、调代码缩进排版,存一次要半分钟,存两次你的大脑就会下意识放弃。
2. 断离了可交互的动态上下文:纯文本截图或死笔记一旦存下来,过几天就忘了当时具体的约束,也无法顺着原对话继续追问。
所以我们在打磨 SaveAnswer 时,坚决不做花哨的常驻大侧边栏或悬浮球,把所有精力放在「把阻力降到 1 秒」:
• 原生 32px 规范嵌入:在 7 大主流 AI 平台每条回答底部静默嵌入规范 Save 按钮,随手一点,1 秒无感留存,原生长代码高亮、格式与原始对话链接无损保留。
• 跨平台毫秒级全文检索:所有 AI 平台存下的好回答统一归集在浏览器本地库。输入关键词毫秒级正文检索,卡片右上角一键跳回原始对话继续追问。
• 拥抱成熟知识生态:支持开启 Obsidian Vault 本地自动同步(规范 YAML frontmatter 与标签),支持一键导出纯净 Markdown、Word、PDF,或内置 Canvas 2D 离线生成长图。
• 坚守 Local-First 纯本地隐私:零外部服务器、不建账号体系、零数据追踪。日常提问里的业务代码与商业 Prompt,100% 物理留存在本地设备。
先把「好答案能 1 秒存下且不丢、随时能找回并追问」这件最基础的事情做好,你的专属知识资产才会真正自然生长出来。
体验落地页:charmlynn.github.io
GitHub 源码:github.com
做 SaveAnswer 这段时间,和很多日常重度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问的开发者交流,发现一个普遍的痛点:
很多人都曾试图用复杂 Notion 数据库、本地向量库或重型 RAG 搭建个人知识库,但折腾了一两个周末,最后几乎无一例外沦为了“落灰死仓库”。
为什么会这样?核心原因往往在于两点:
1. 单次录入摩擦力过高:在 AI 里聊出一段绝妙的架构或排查代码时,正处于深度思考心流中。如果必须切屏、建页面、调代码缩进排版,存一次要半分钟,存两次你的大脑就会下意识放弃。
2. 断离了可交互的动态上下文:纯文本截图或死笔记一旦存下来,过几天就忘了当时具体的约束,也无法顺着原对话继续追问。
所以我们在打磨 SaveAnswer 时,坚决不做花哨的常驻大侧边栏或悬浮球,把所有精力放在「把阻力降到 1 秒」:
• 原生 32px 规范嵌入:在 7 大主流 AI 平台每条回答底部静默嵌入规范 Save 按钮,随手一点,1 秒无感留存,原生长代码高亮、格式与原始对话链接无损保留。
• 跨平台毫秒级全文检索:所有 AI 平台存下的好回答统一归集在浏览器本地库。输入关键词毫秒级正文检索,卡片右上角一键跳回原始对话继续追问。
• 拥抱成熟知识生态:支持开启 Obsidian Vault 本地自动同步(规范 YAML frontmatter 与标签),支持一键导出纯净 Markdown、Word、PDF,或内置 Canvas 2D 离线生成长图。
• 坚守 Local-First 纯本地隐私:零外部服务器、不建账号体系、零数据追踪。日常提问里的业务代码与商业 Prompt,100% 物理留存在本地设备。
先把「好答案能 1 秒存下且不丢、随时能找回并追问」这件最基础的事情做好,你的专属知识资产才会真正自然生长出来。
体验落地页:charmlynn.github.io
GitHub 源码:github.com
0 00
把 SaveAnswer 1.0.20 的完整演示视频重新做了一遍(24 秒走完 7 幕核心能力):
1. 7 大主流 AI 平台(ChatGPT 2026 新架构、Claude、Gemini、DeepSeek、Grok、豆包、通义千问)统一 32px 原生 Save 按钮,1 秒留存;
2. 列表卡片右上角新增「查看原文 ↗」快捷入口,不用先点进详情就能一键跳回原对话;
3. 新增 Obsidian Vault 本地自动同步:自动将保存的回答按 YAML frontmatter 写入本地 Obsidian 文件夹;
4. 四格式导出(Markdown / Word / PDF / HTML)支持自选任意本地文件夹;
5. 内置 4 套主题的离线 Canvas 2D 高清分享卡片;
6. 依然坚持 100% Local-First:存本地 chrome.storage.local,无账号、无云端、零埋点。
官网体验与动图演示:charmlynn.github.io
24 秒高清演示视频:charmlynn.github.io
1. 7 大主流 AI 平台(ChatGPT 2026 新架构、Claude、Gemini、DeepSeek、Grok、豆包、通义千问)统一 32px 原生 Save 按钮,1 秒留存;
2. 列表卡片右上角新增「查看原文 ↗」快捷入口,不用先点进详情就能一键跳回原对话;
3. 新增 Obsidian Vault 本地自动同步:自动将保存的回答按 YAML frontmatter 写入本地 Obsidian 文件夹;
4. 四格式导出(Markdown / Word / PDF / HTML)支持自选任意本地文件夹;
5. 内置 4 套主题的离线 Canvas 2D 高清分享卡片;
6. 依然坚持 100% Local-First:存本地 chrome.storage.local,无账号、无云端、零埋点。
官网体验与动图演示:charmlynn.github.io
24 秒高清演示视频:charmlynn.github.io
0 00
独立开发做 SaveAnswer 的技术思考:为什么做 AI 工具,我们坚持「零服务器、不建账号体系、Local-First 纯本地存储」?
很多朋友做 AI 扩展,第一反应往往是起个后端、接 Supabase、建一套用户中心,再加各种云同步。
但当我们自己日常深度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问时,发现最大的顾虑其实是「隐私安全」:
我们在 AI 里聊的,往往是公司核心业务代码、未公开的架构设计、私密 Prompt 或灵感草稿。把这些数据同步到第三方云端服务器,不仅用户有心理负担,作为独立开发者也时刻面临数据安全合规和服务器账单的压力。
所以我们把 SaveAnswer 设计成彻头彻尾的 Local-First(本地优先):
1. 物理级隐私安全:100% 依赖浏览器本地存储(chrome.storage.local),不建账号、不设服务器、零数据采集与上报。断网状态下也能毫秒级全文检索。
2. 零心流打扰:坚决不做常驻大侧边栏或悬浮球。在 7 大主流 AI 平台每条回答下方,原生嵌入一个规范的 32px Save 按钮,顺手点一下,1 秒留存。
3. 数据资产自由流转:按需一键导出为纯净 Markdown(直接入 Obsidian / VS Code)、Word、PDF,或前端 Canvas 2D 离线生成长图。
把数据主权完整还给用户,工具才能让人真正放心长久用下去。
体验落地页:charmlynn.github.io
GitHub 源码:github.com
很多朋友做 AI 扩展,第一反应往往是起个后端、接 Supabase、建一套用户中心,再加各种云同步。
但当我们自己日常深度混用 ChatGPT、Claude、DeepSeek、Gemini、Grok、豆包、通义千问时,发现最大的顾虑其实是「隐私安全」:
我们在 AI 里聊的,往往是公司核心业务代码、未公开的架构设计、私密 Prompt 或灵感草稿。把这些数据同步到第三方云端服务器,不仅用户有心理负担,作为独立开发者也时刻面临数据安全合规和服务器账单的压力。
所以我们把 SaveAnswer 设计成彻头彻尾的 Local-First(本地优先):
1. 物理级隐私安全:100% 依赖浏览器本地存储(chrome.storage.local),不建账号、不设服务器、零数据采集与上报。断网状态下也能毫秒级全文检索。
2. 零心流打扰:坚决不做常驻大侧边栏或悬浮球。在 7 大主流 AI 平台每条回答下方,原生嵌入一个规范的 32px Save 按钮,顺手点一下,1 秒留存。
3. 数据资产自由流转:按需一键导出为纯净 Markdown(直接入 Obsidian / VS Code)、Word、PDF,或前端 Canvas 2D 离线生成长图。
把数据主权完整还给用户,工具才能让人真正放心长久用下去。
体验落地页:charmlynn.github.io
GitHub 源码:github.com
0 00