即刻App年轻人的同好社区
下载
昨天我们发表了一篇2026年模型竞赛的文章,有一些信息存量,我总结下。
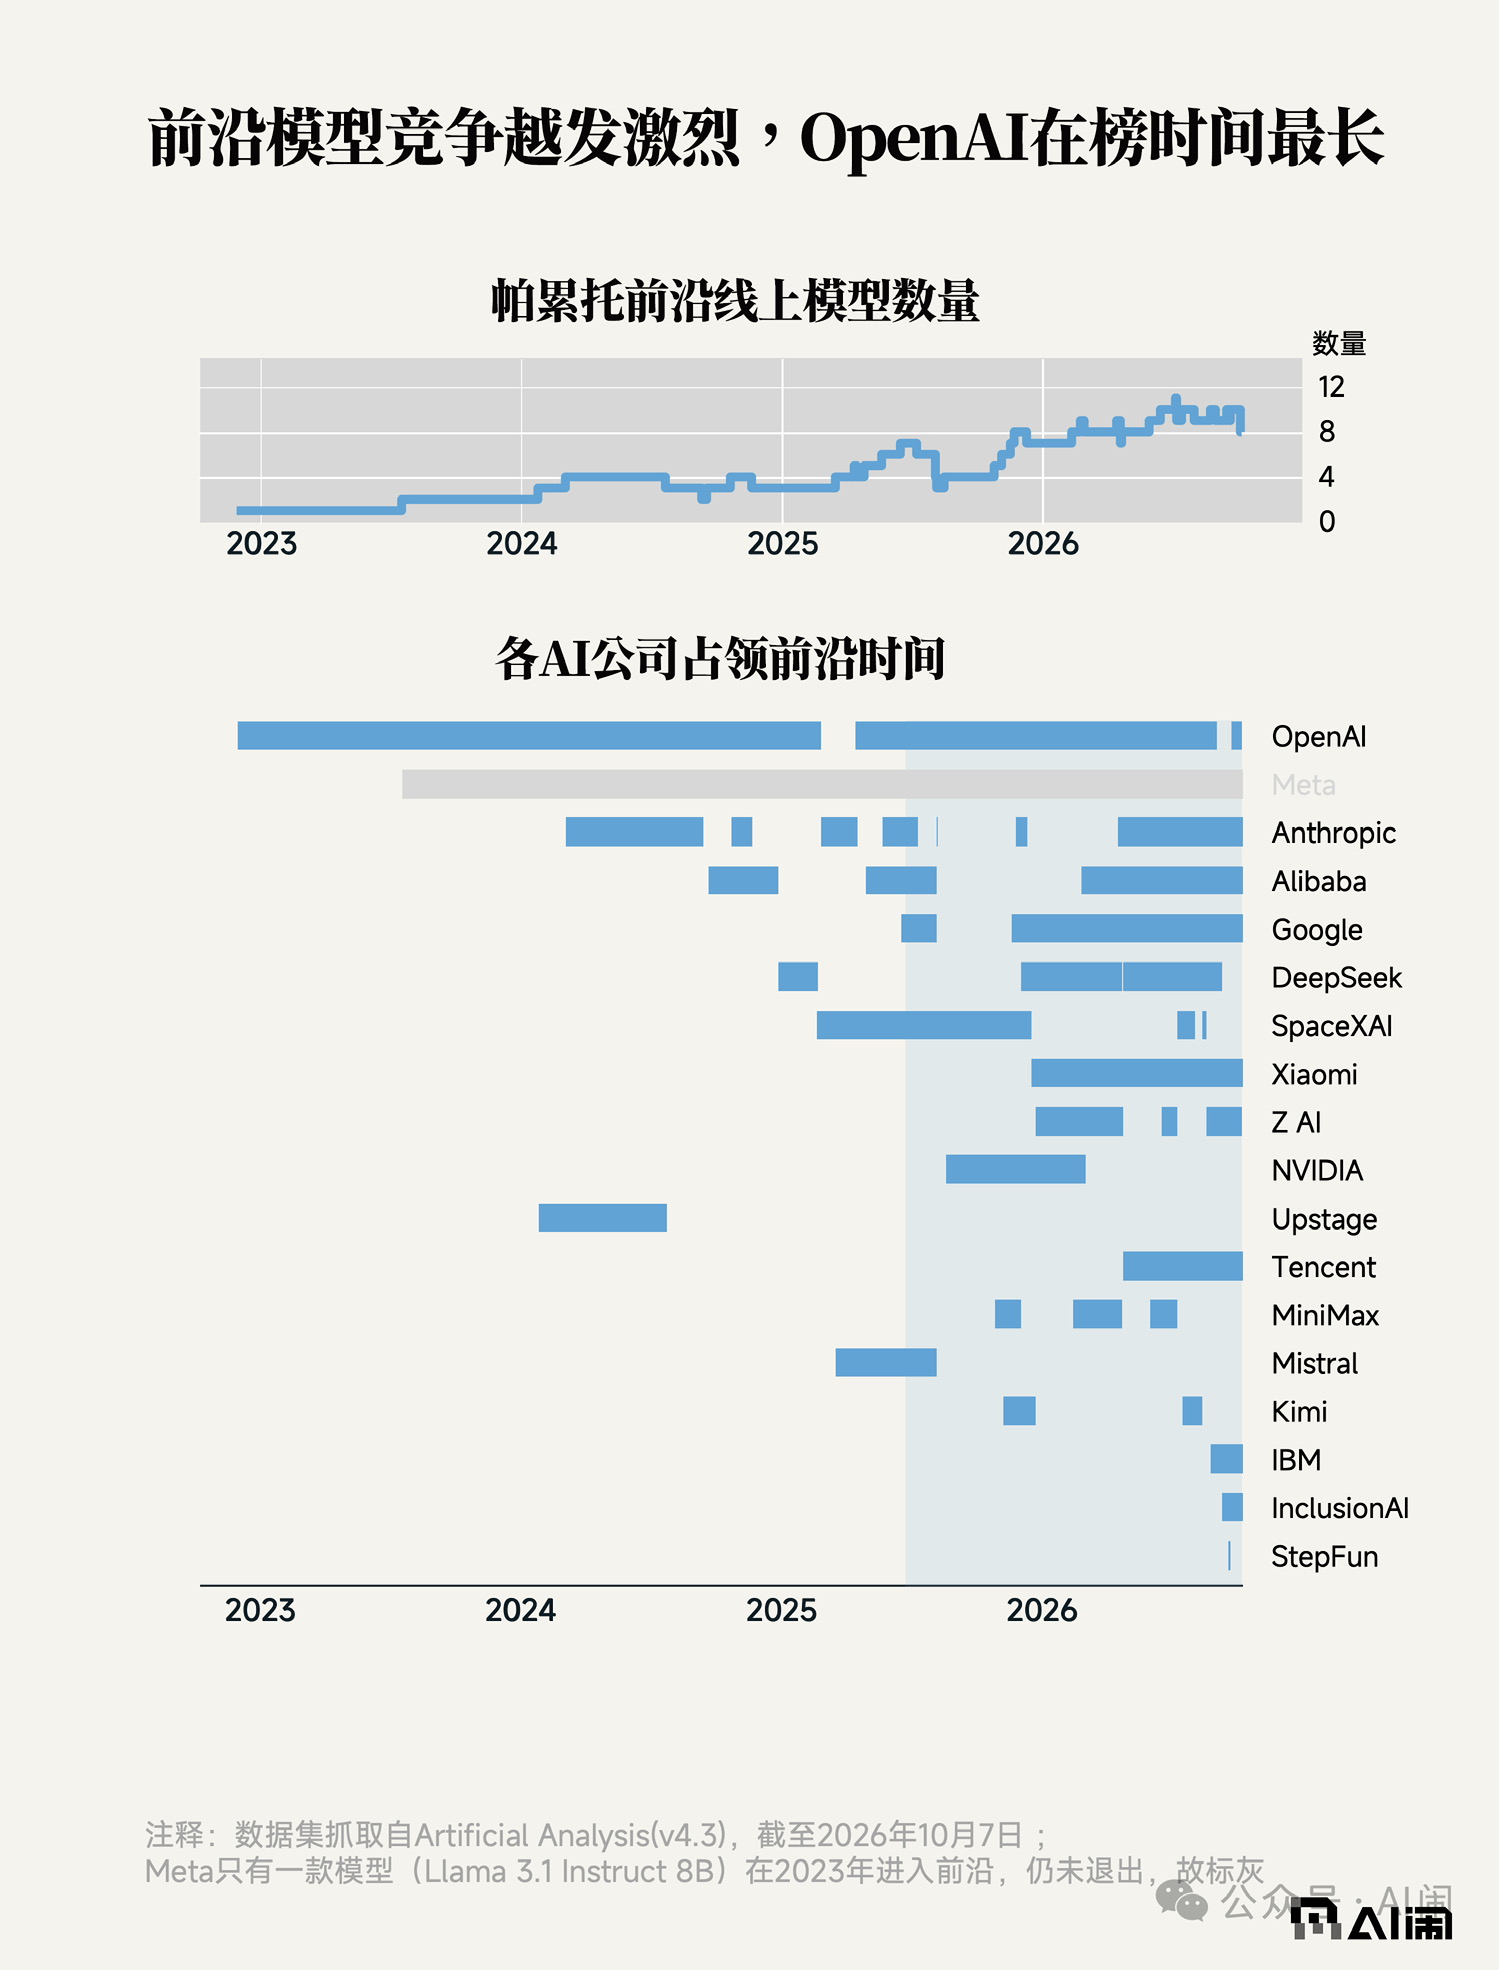
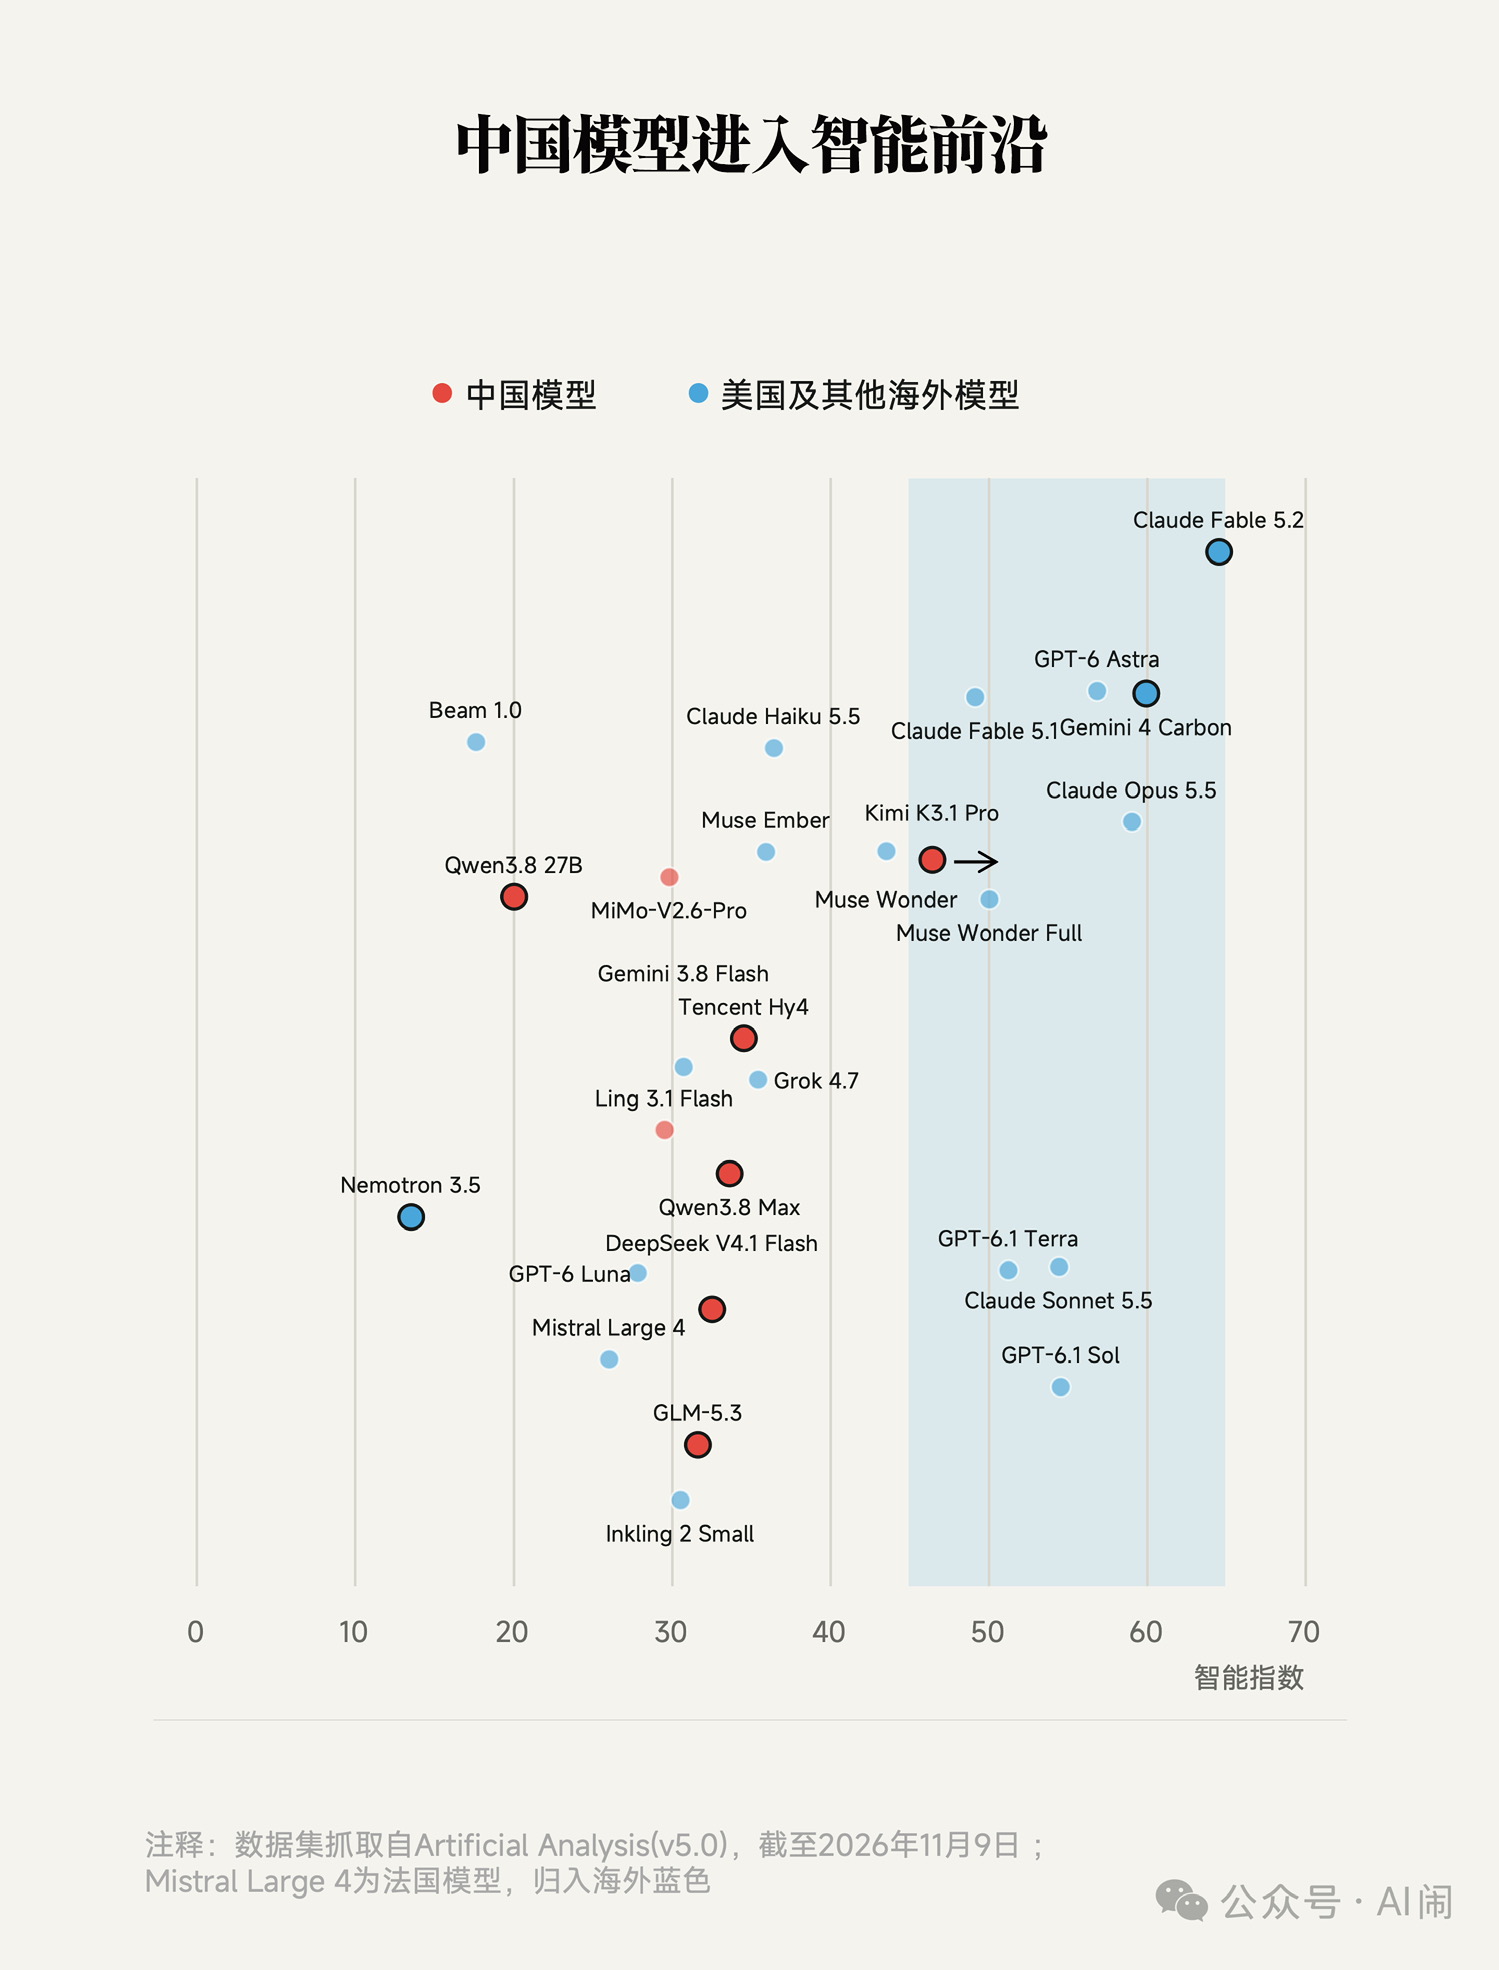
1、今年,中国模型追上美国模型的平均时间已经缩短到 3.4 个月——而一年前,这个时间差还是 6.5 个月。
时间窗口被压缩到一个季度。这意味着,一家公司刚刚把技术领先转化为产品和合同,竞争者就拿出了接近的分数。
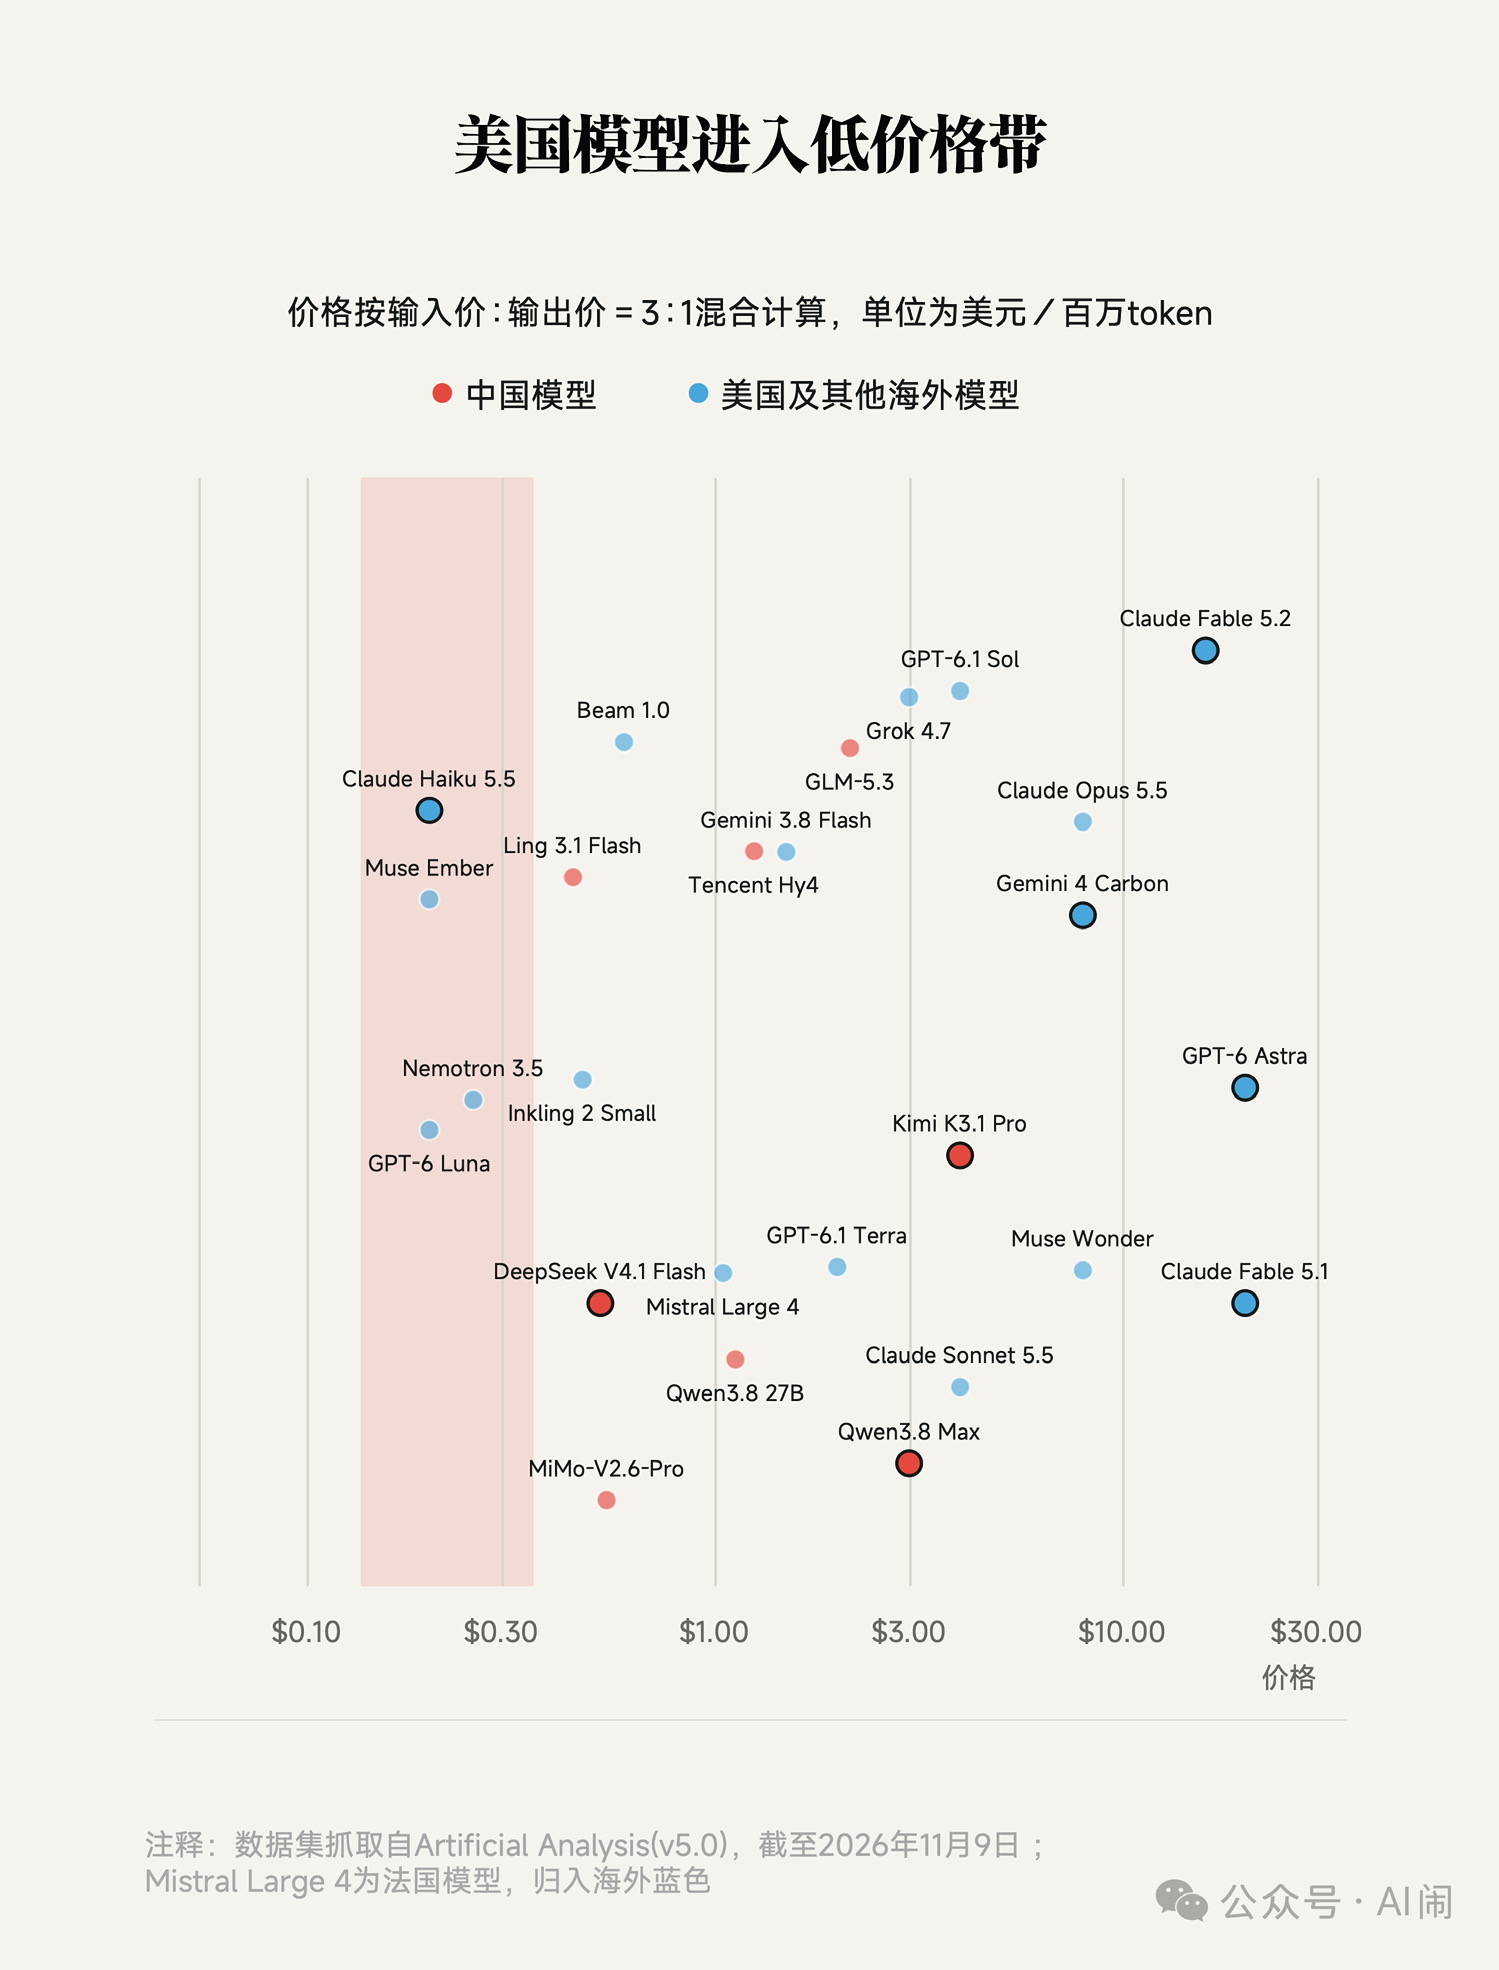
2、技术能力拉不开绝对优势,各家便大打价格战。
例如,OpenAI 的 GPT-6 Luna API 标价为每百万输入 token 0.10 美元、输出 0.50 美元;Anthropic 的 Claude Haiku 5.5 在提示词不超过 10 万 token 时,也采用同一价位。
对照之下,向来以性价比取胜的 DeepSeek,其 V4.1 Flash 的公开价格为高峰时段输入 0.30 美元、输出 1.20 美元,非高峰时段分别为 0.15 和 0.60 美元。
这也是最近半年,许多模型厂商开始宣传「斩杀线」概念的原因。
3、另一方面,美国开始制裁「蒸馏」。据我们采访的受访者预估,原本中国模型厂商通过蒸馏快速复现海外模型的路径,今年显然走不通了——蒸馏成本上涨了 5 到 10 倍,极端情况下甚至达到 20 倍。
蒸馏不再是低成本、低风险的捷径。
4、那么,各家模型建立起自己的品牌效应了吗?答案是:没有。
一位推理服务商人士王普(化名)告诉我们,在中低价格带,国内模型厂商通常会提前 DeepSeek 半个月发布新模型,确保 DeepSeek 发布时,自己能完成一轮开发者转化和客户签约。「因为客户没有忠诚度。」王普根据服务后台的数据流量判断,个人用户切换模型的成本约等于零,企业端的切换成本「短则一两周,长则半年」。
5、根据美国 AI 研究机构 Epoch AI 的最新统计:中国六家领先 AI 公司的 AI 相关收入合计,仅约为 OpenAI 与 Anthropic 合计收入的十分之一。
6、元理智能创始人张帆(曾任智谱 COO)在接受采访时认为,平台的定价权往往来自正向循环,但通用模型目前没有形成移动互联网同等强度的网络效应——大量日常对话数据对模型训练未必有用,且存在合规问题。Anthropic 正在探索长程智能体任务,让模型跨越多步骤持续行动并从结果中改进,但这种循环能否形成可持续的产品优势,仍待观察。
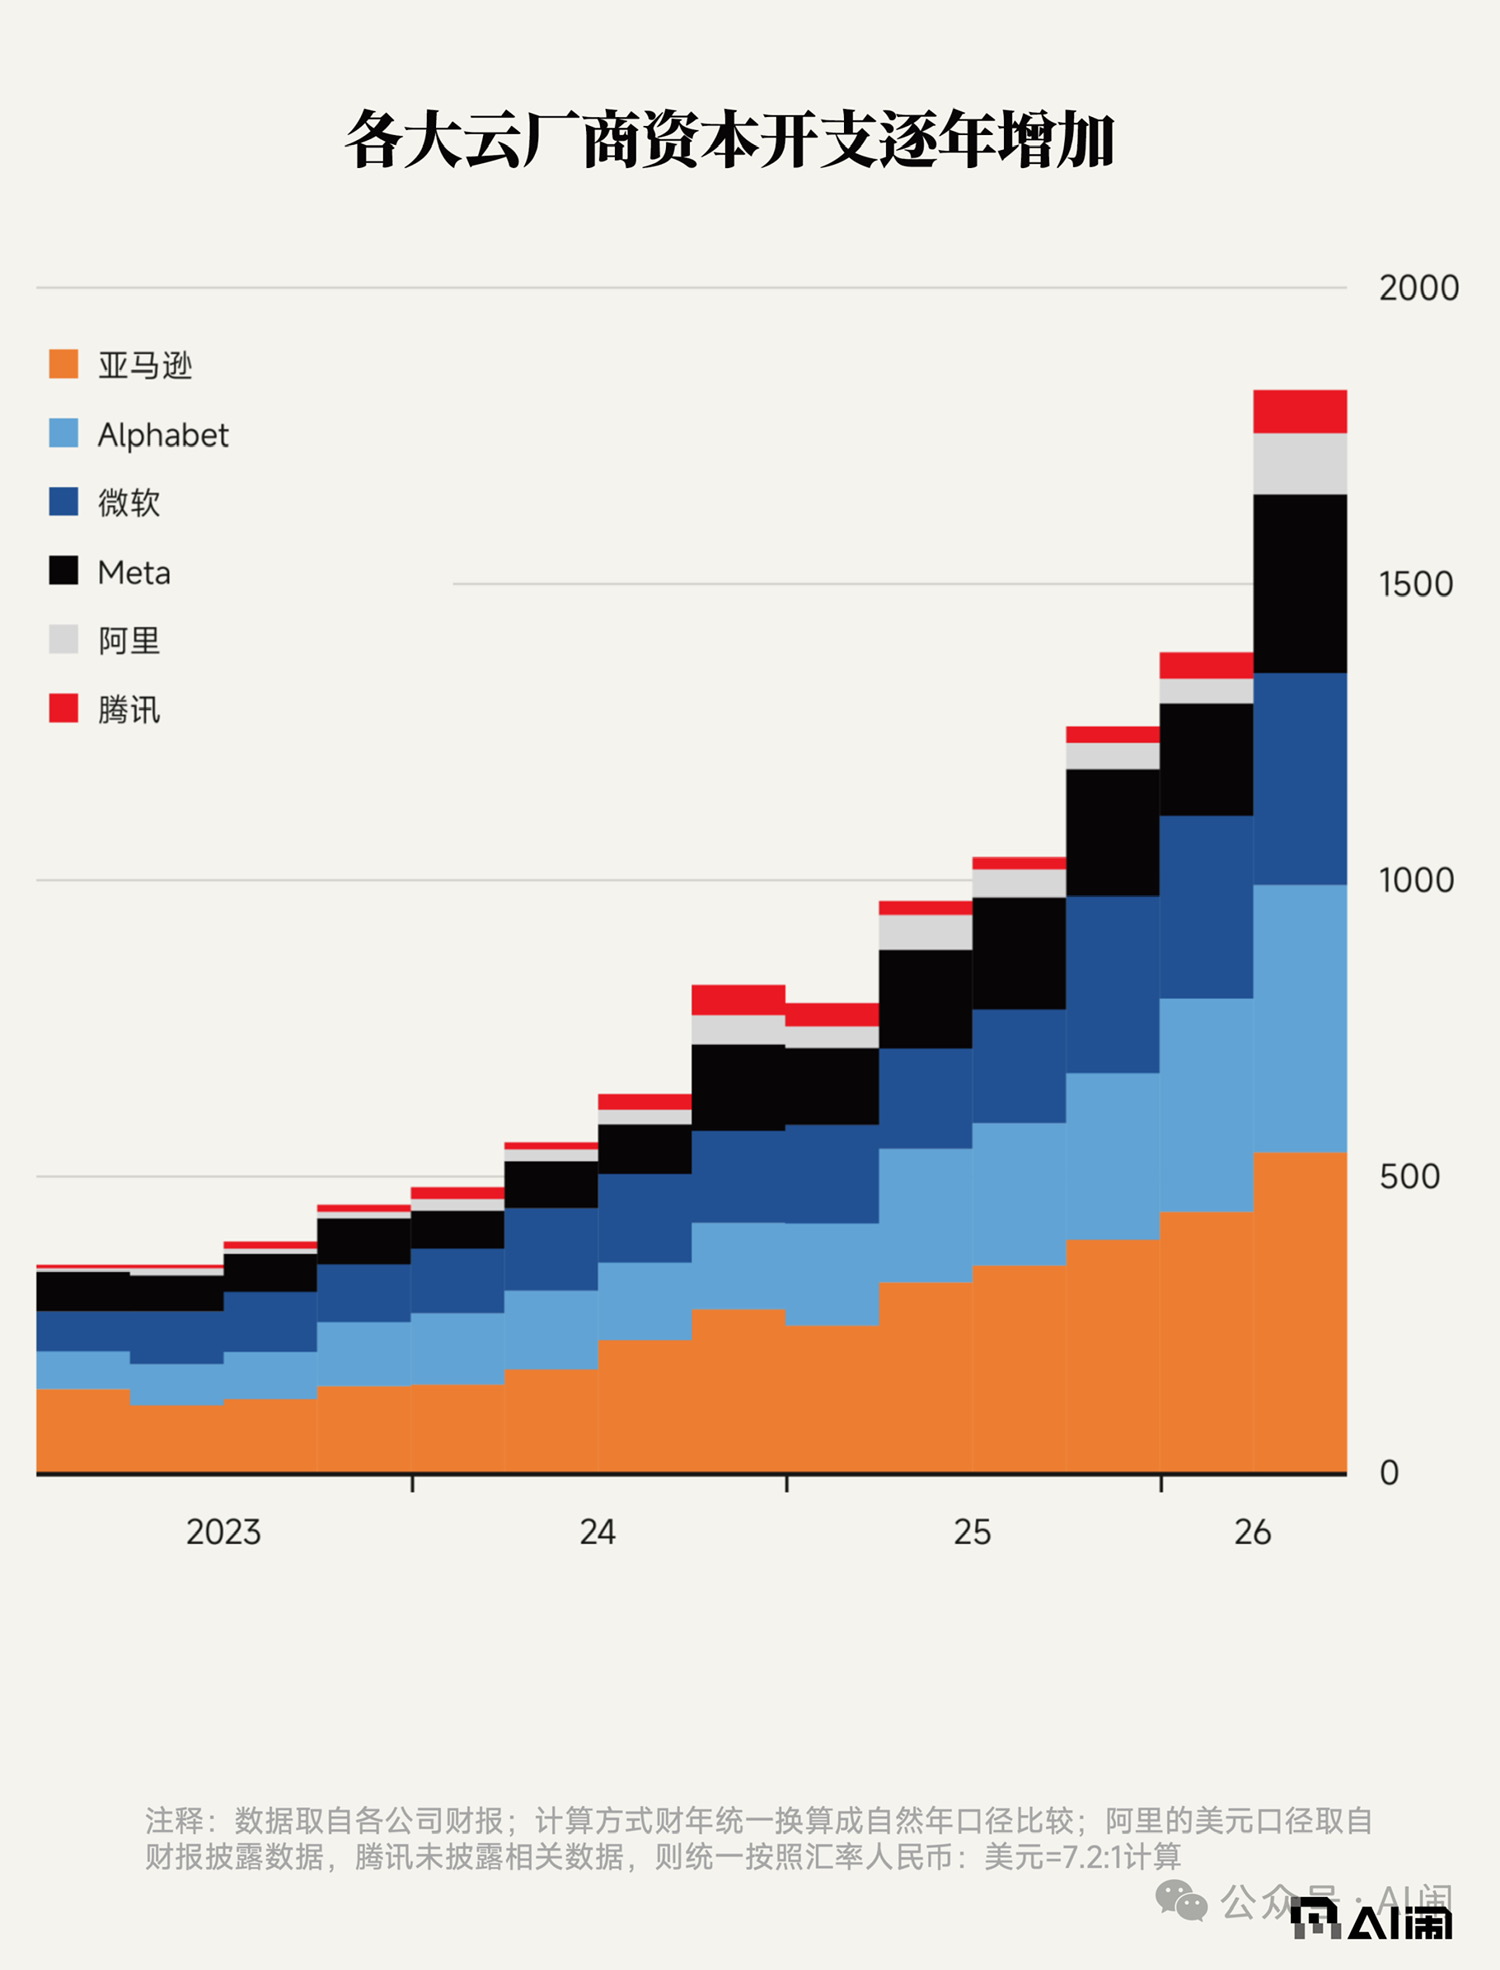
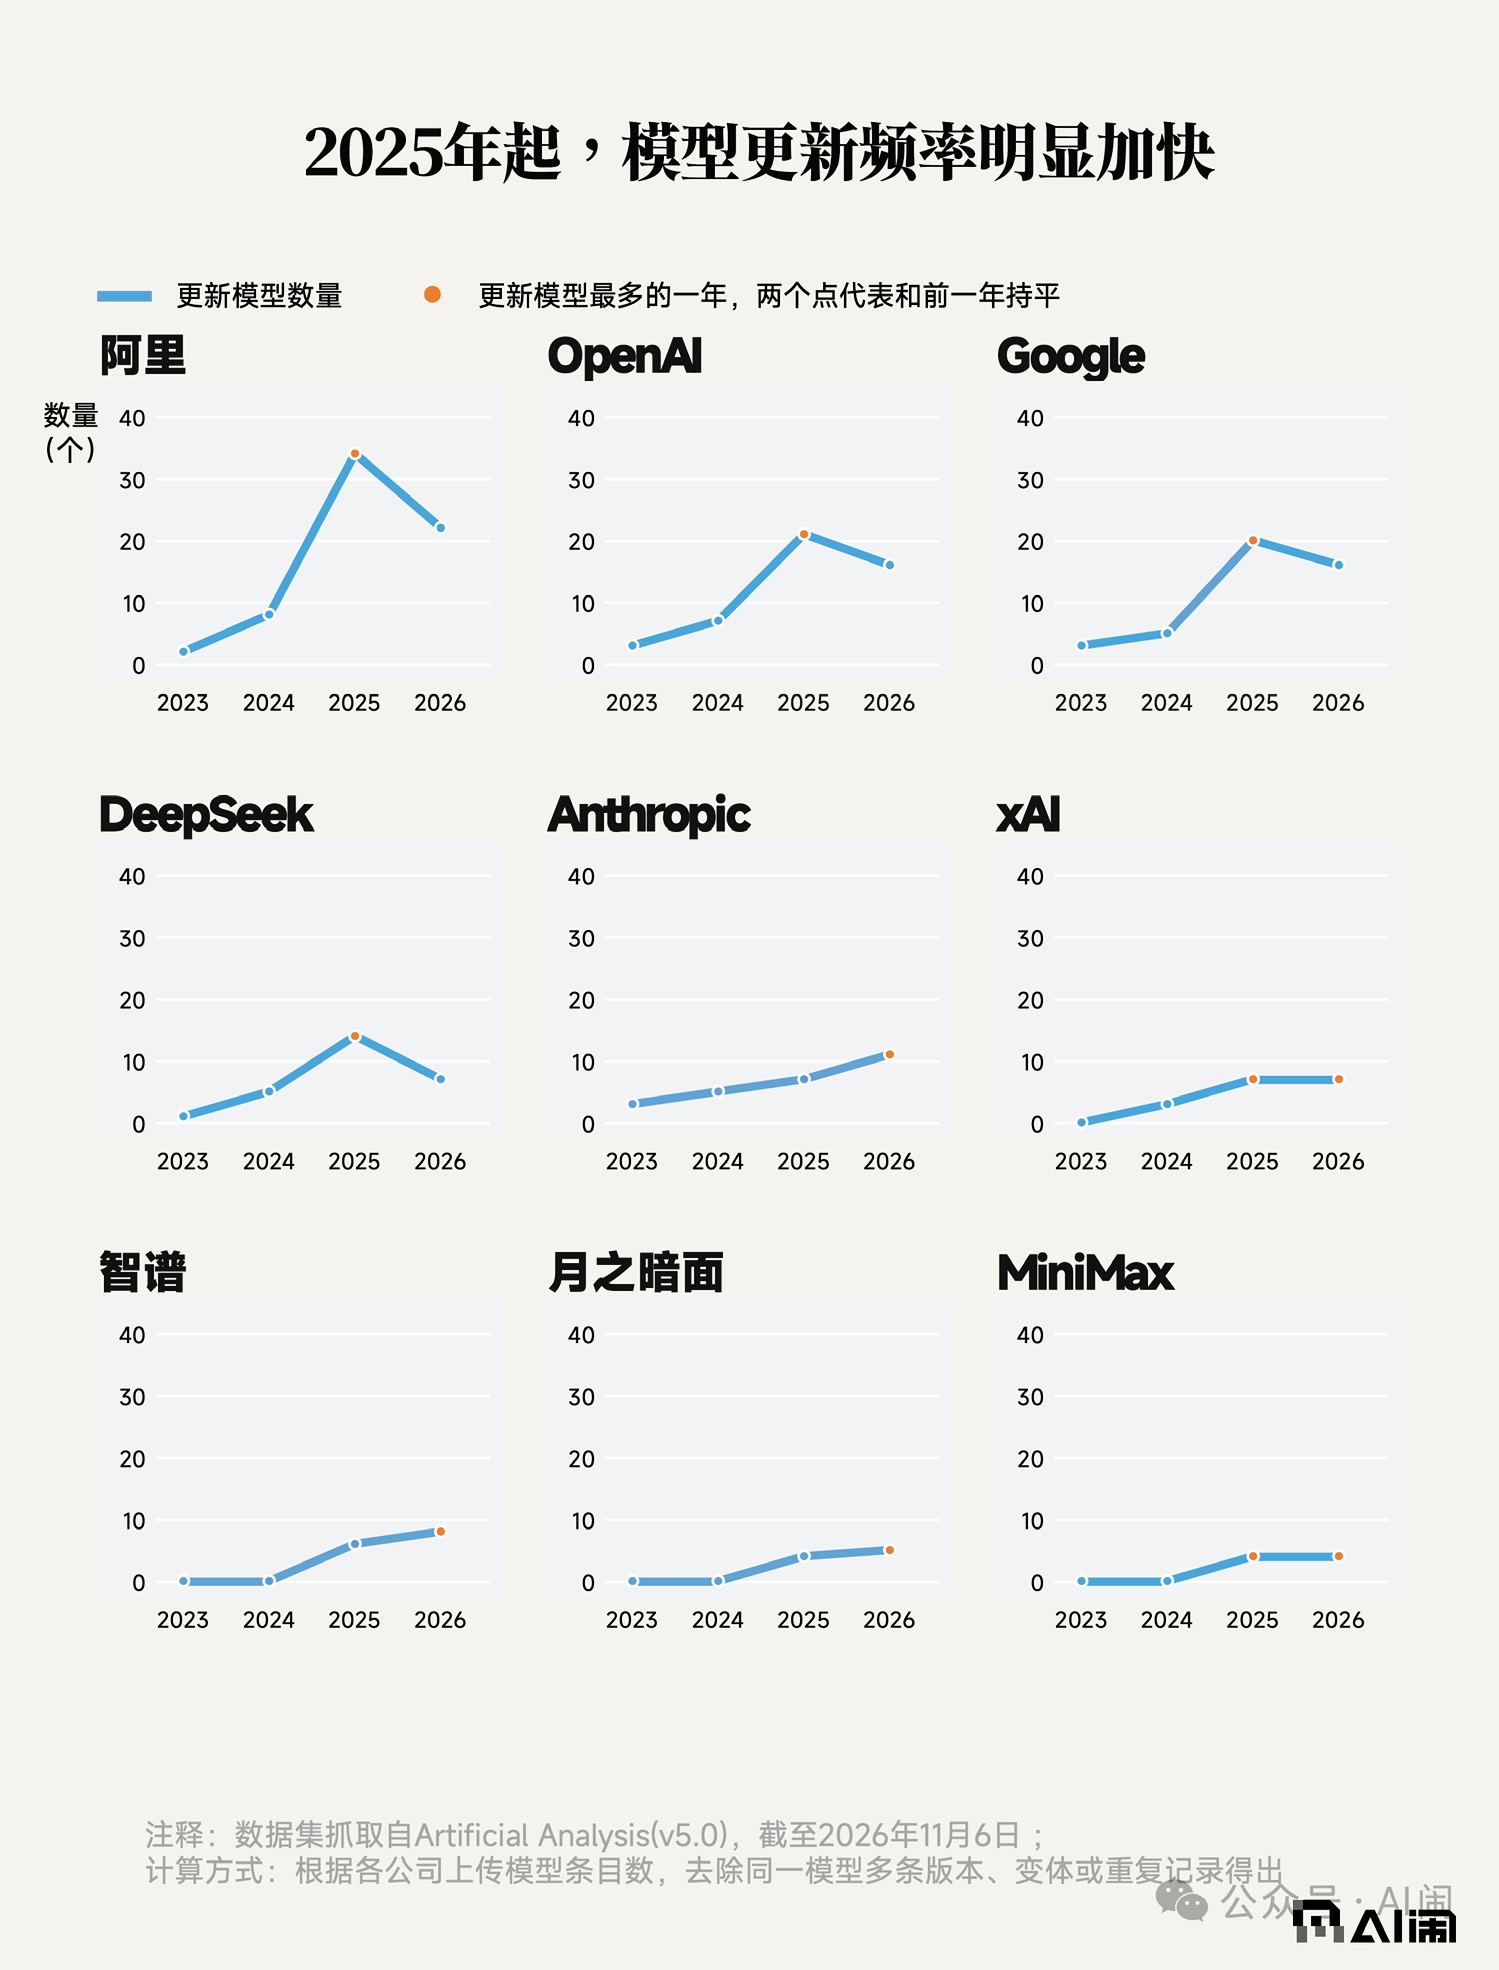
7、即便如此,今年各大模型厂商在2026年的投入仍在成倍增长:模型每完整经历一次迭代,成本可能是上一次的两倍,资源投入也相应成倍提高。
越来越大的参数,越来越贵的投入。各家都不想停手,尽管短期内谁也没找到赚钱的方式。
8、这些投入涵盖算力与基础设施、数据,以及整套基建。其中数据的需求在今年呈井喷式增长。一位数据采集服务商告诉我们:「现在市面提供的数据,大概只够模型需求量的百分之一。」
9、张帆把当下的竞争形容为:「就得像疯子一样无条件地信,才有机会,且速度是唯一的选项。」然后,「要不停地跑,直到跑不动。」
一位曾投资过基础模型公司的投资人预测:中国市场不太可能容纳十家基础模型公司,资源是有限的,「最后可能就剩两到三家。」
1、今年,中国模型追上美国模型的平均时间已经缩短到 3.4 个月——而一年前,这个时间差还是 6.5 个月。
时间窗口被压缩到一个季度。这意味着,一家公司刚刚把技术领先转化为产品和合同,竞争者就拿出了接近的分数。
2、技术能力拉不开绝对优势,各家便大打价格战。
例如,OpenAI 的 GPT-6 Luna API 标价为每百万输入 token 0.10 美元、输出 0.50 美元;Anthropic 的 Claude Haiku 5.5 在提示词不超过 10 万 token 时,也采用同一价位。
对照之下,向来以性价比取胜的 DeepSeek,其 V4.1 Flash 的公开价格为高峰时段输入 0.30 美元、输出 1.20 美元,非高峰时段分别为 0.15 和 0.60 美元。
这也是最近半年,许多模型厂商开始宣传「斩杀线」概念的原因。
3、另一方面,美国开始制裁「蒸馏」。据我们采访的受访者预估,原本中国模型厂商通过蒸馏快速复现海外模型的路径,今年显然走不通了——蒸馏成本上涨了 5 到 10 倍,极端情况下甚至达到 20 倍。
蒸馏不再是低成本、低风险的捷径。
4、那么,各家模型建立起自己的品牌效应了吗?答案是:没有。
一位推理服务商人士王普(化名)告诉我们,在中低价格带,国内模型厂商通常会提前 DeepSeek 半个月发布新模型,确保 DeepSeek 发布时,自己能完成一轮开发者转化和客户签约。「因为客户没有忠诚度。」王普根据服务后台的数据流量判断,个人用户切换模型的成本约等于零,企业端的切换成本「短则一两周,长则半年」。
5、根据美国 AI 研究机构 Epoch AI 的最新统计:中国六家领先 AI 公司的 AI 相关收入合计,仅约为 OpenAI 与 Anthropic 合计收入的十分之一。
6、元理智能创始人张帆(曾任智谱 COO)在接受采访时认为,平台的定价权往往来自正向循环,但通用模型目前没有形成移动互联网同等强度的网络效应——大量日常对话数据对模型训练未必有用,且存在合规问题。Anthropic 正在探索长程智能体任务,让模型跨越多步骤持续行动并从结果中改进,但这种循环能否形成可持续的产品优势,仍待观察。
7、即便如此,今年各大模型厂商在2026年的投入仍在成倍增长:模型每完整经历一次迭代,成本可能是上一次的两倍,资源投入也相应成倍提高。
越来越大的参数,越来越贵的投入。各家都不想停手,尽管短期内谁也没找到赚钱的方式。
8、这些投入涵盖算力与基础设施、数据,以及整套基建。其中数据的需求在今年呈井喷式增长。一位数据采集服务商告诉我们:「现在市面提供的数据,大概只够模型需求量的百分之一。」
9、张帆把当下的竞争形容为:「就得像疯子一样无条件地信,才有机会,且速度是唯一的选项。」然后,「要不停地跑,直到跑不动。」
一位曾投资过基础模型公司的投资人预测:中国市场不太可能容纳十家基础模型公司,资源是有限的,「最后可能就剩两到三家。」
26 16
如果2026年只收藏一篇理解大模型竞争的文章,肯定是这一篇。
不停奔跑,直到跑不动:一场昂贵、焦灼的大模型竞速
15 51

认领下,我昨天的哀嚎。but我觉得现在vc像公务员,表面光鲜,但既不务实也不求真。在中国,公务员的精神风貌确实是最符合意识形态的。

julian: neo lab是不是骗子,尤其是这些cos成偶像剧里少年黑客的二十多岁“科学家们”两年后到底能交付出什么?
29 29