即刻App年轻人的同好社区
下载
【agent-desktop 是什么?它怎么操作电脑】
操作电脑(computer-use)是 agent 的一项能力:你定一个目标,它自己看屏幕、点鼠标、敲键盘。
之前这个能力最强的是 OpenAI 的 GPT 模型,它训练得最好。OpenAI 最新的 GPT-6 Astra 在 OSWorld 2.0 这个操作电脑的测试里拿到 72.6%,上一代 GPT-5.6 Sol 是 65.7%,同一张表里 Claude Opus 5 是 70.2%。
所以之前用别的 LLM,基本上都要在某一个节点接上 GPT,才能用上操作电脑的能力。现在 Vercel 开源了 agent-desktop 这个库,各家 LLM 都可以直接用了。
以前让大模型操作电脑,基本都得靠能看图的大模型:先用工具截一张图,把图送给大模型,让它看图上哪个是保存按钮。然后它把图上的位置换算成坐标,猜出按钮在屏幕上的位置。比如要保存一个文件,它得先猜保存按钮在屏幕哪儿。
这时候它才真的去点:按猜出来的坐标点一下,点完再截一次图,确认点出来的结果对不对。所以以前操作电脑的路径就是截图、操作、再截图确认。截图很慢,消耗的 token 也很多,一直有人在找更省的办法。
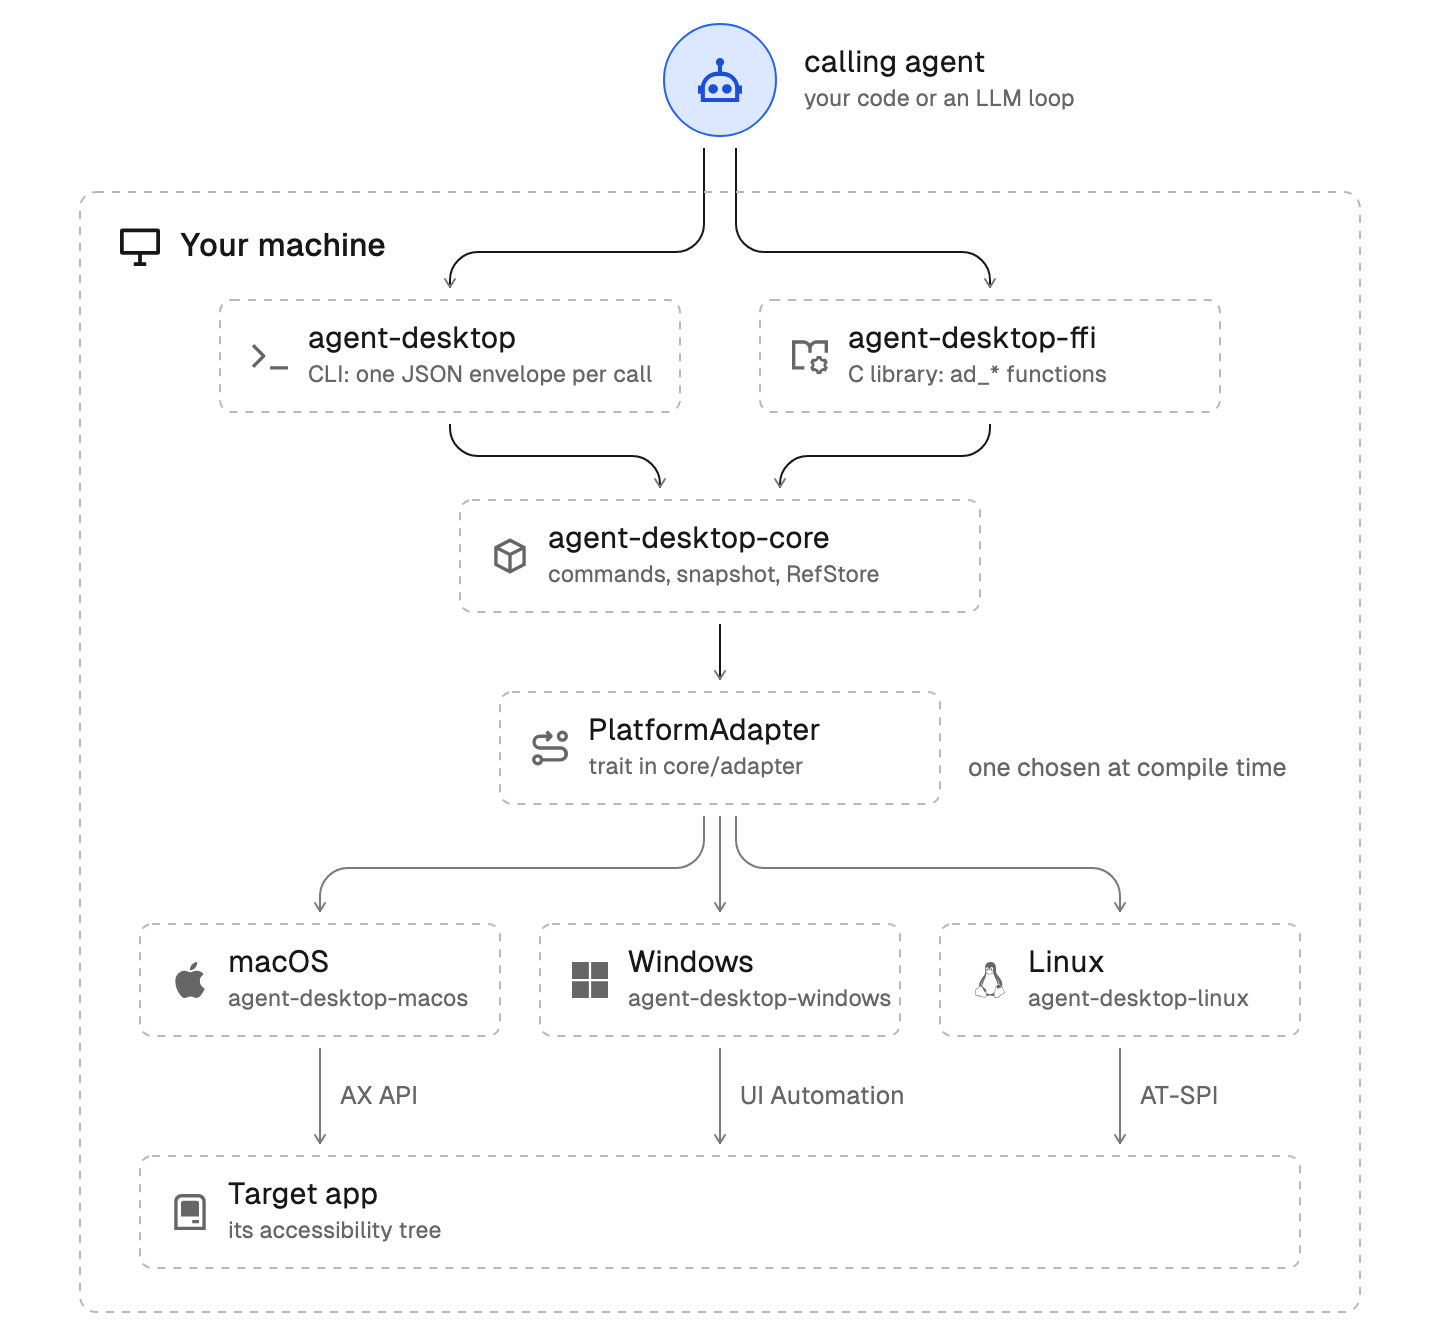
现在 Vercel 的 agent-desktop 提供了三种用法:
1. CLI。
2. Skill。
3. MCP Server。
所以不管你的 agent 是哪种形态,都能直接用它。
它的原理是优先调用系统 API 来操作界面,不走截图。
举个例子。它会通过 UIA 接口,也就是 UI Automation 接口读界面。这个接口本来是为了给屏幕阅读器用的,很多 APP 都实现了。
它先通过 UIA 接口找出系统里正在运行的进程,这些进程不一定都显示在屏幕上。一个进程映射成一个窗口,一个窗口就是一个 GUI 程序。
每个窗口读一遍 UIA,会拿到一棵 JSON 格式的控件树,里面写着界面在哪、标题栏在哪、每个按钮在哪。你说要操作哪个 APP,它就先去进程列表里认出是哪一个。
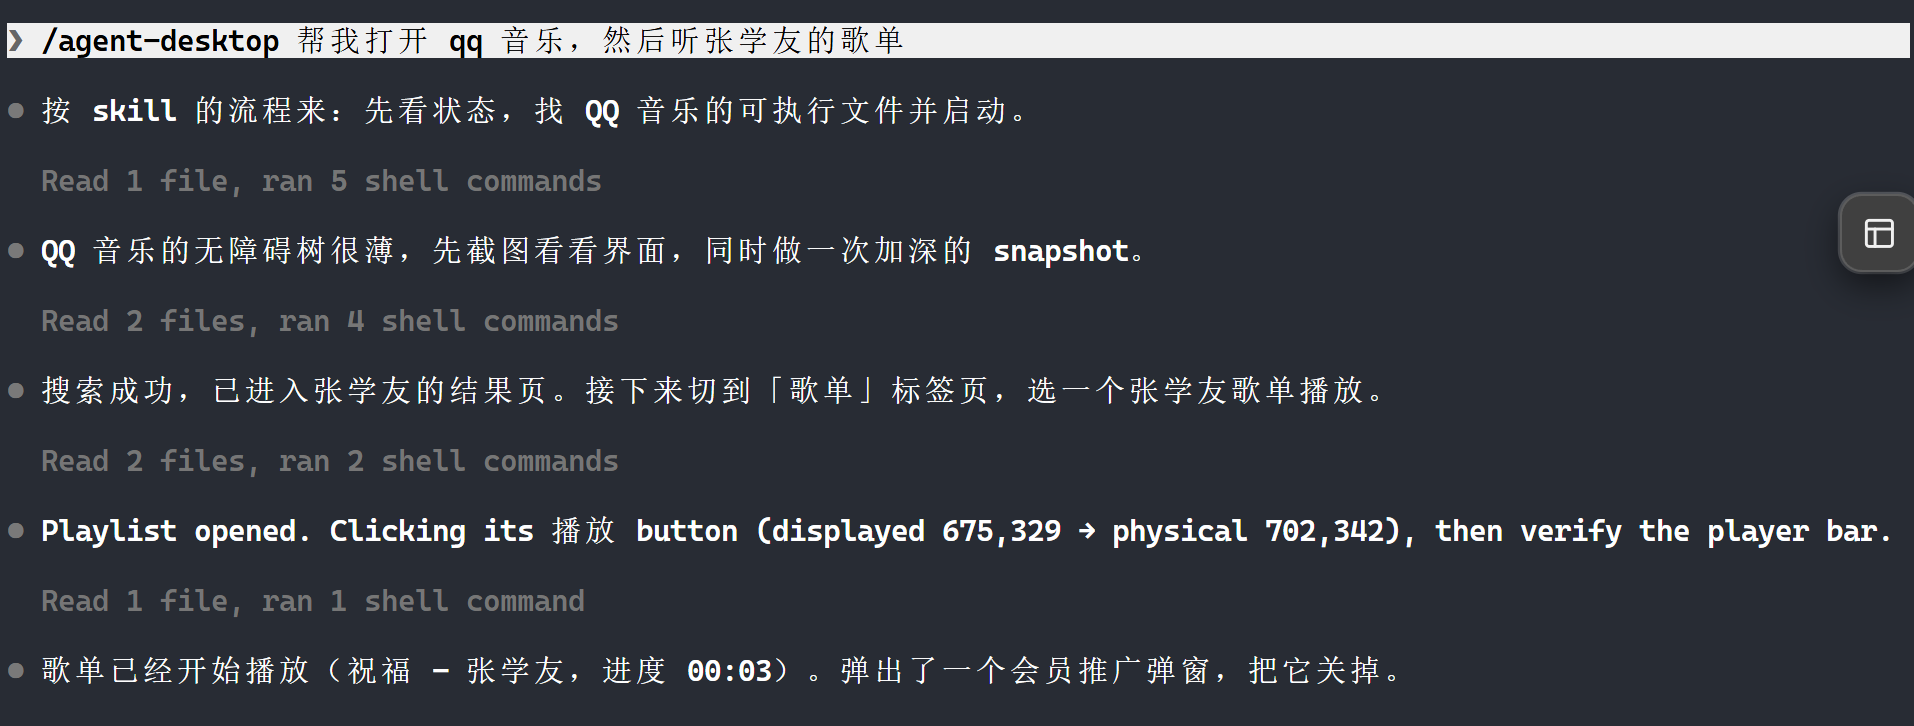
认出 APP 之后,它拿到这个 APP 的控件树,再按你的意图去点。比如你想打开 QQ 音乐听张学友的歌,只要 QQ 音乐能被 UIA 读出控件树,它就找到这个进程,先搜张学友,再点播放按钮,全程不用截图。
所以这个库说的 snapshot,拿到的是通过 UIA 这类系统接口读出来的控件树,不是截一张图。每个控件都有一个 reference ID,点哪个控件,它靠遍历这棵控件树找到,不再用截图算坐标。不过它还有一个 fallback:不是所有应用都实现了 UIA,遇到没有的,它就回到老办法——截图送给视觉大模型,模型给出坐标,点完再截一次图确认。
那么 QQ 音乐很不幸,就落在后一条路上。这时候如果你接的大模型本身没有视觉能力,这条路就断了,这个 APP 也就没法靠它操作。
操作电脑(computer-use)是 agent 的一项能力:你定一个目标,它自己看屏幕、点鼠标、敲键盘。
之前这个能力最强的是 OpenAI 的 GPT 模型,它训练得最好。OpenAI 最新的 GPT-6 Astra 在 OSWorld 2.0 这个操作电脑的测试里拿到 72.6%,上一代 GPT-5.6 Sol 是 65.7%,同一张表里 Claude Opus 5 是 70.2%。
所以之前用别的 LLM,基本上都要在某一个节点接上 GPT,才能用上操作电脑的能力。现在 Vercel 开源了 agent-desktop 这个库,各家 LLM 都可以直接用了。
以前让大模型操作电脑,基本都得靠能看图的大模型:先用工具截一张图,把图送给大模型,让它看图上哪个是保存按钮。然后它把图上的位置换算成坐标,猜出按钮在屏幕上的位置。比如要保存一个文件,它得先猜保存按钮在屏幕哪儿。
这时候它才真的去点:按猜出来的坐标点一下,点完再截一次图,确认点出来的结果对不对。所以以前操作电脑的路径就是截图、操作、再截图确认。截图很慢,消耗的 token 也很多,一直有人在找更省的办法。
现在 Vercel 的 agent-desktop 提供了三种用法:
1. CLI。
2. Skill。
3. MCP Server。
所以不管你的 agent 是哪种形态,都能直接用它。
它的原理是优先调用系统 API 来操作界面,不走截图。
举个例子。它会通过 UIA 接口,也就是 UI Automation 接口读界面。这个接口本来是为了给屏幕阅读器用的,很多 APP 都实现了。
它先通过 UIA 接口找出系统里正在运行的进程,这些进程不一定都显示在屏幕上。一个进程映射成一个窗口,一个窗口就是一个 GUI 程序。
每个窗口读一遍 UIA,会拿到一棵 JSON 格式的控件树,里面写着界面在哪、标题栏在哪、每个按钮在哪。你说要操作哪个 APP,它就先去进程列表里认出是哪一个。
认出 APP 之后,它拿到这个 APP 的控件树,再按你的意图去点。比如你想打开 QQ 音乐听张学友的歌,只要 QQ 音乐能被 UIA 读出控件树,它就找到这个进程,先搜张学友,再点播放按钮,全程不用截图。
所以这个库说的 snapshot,拿到的是通过 UIA 这类系统接口读出来的控件树,不是截一张图。每个控件都有一个 reference ID,点哪个控件,它靠遍历这棵控件树找到,不再用截图算坐标。不过它还有一个 fallback:不是所有应用都实现了 UIA,遇到没有的,它就回到老办法——截图送给视觉大模型,模型给出坐标,点完再截一次图确认。
那么 QQ 音乐很不幸,就落在后一条路上。这时候如果你接的大模型本身没有视觉能力,这条路就断了,这个 APP 也就没法靠它操作。
0 00
【harness 之 agent 长程工作流。】
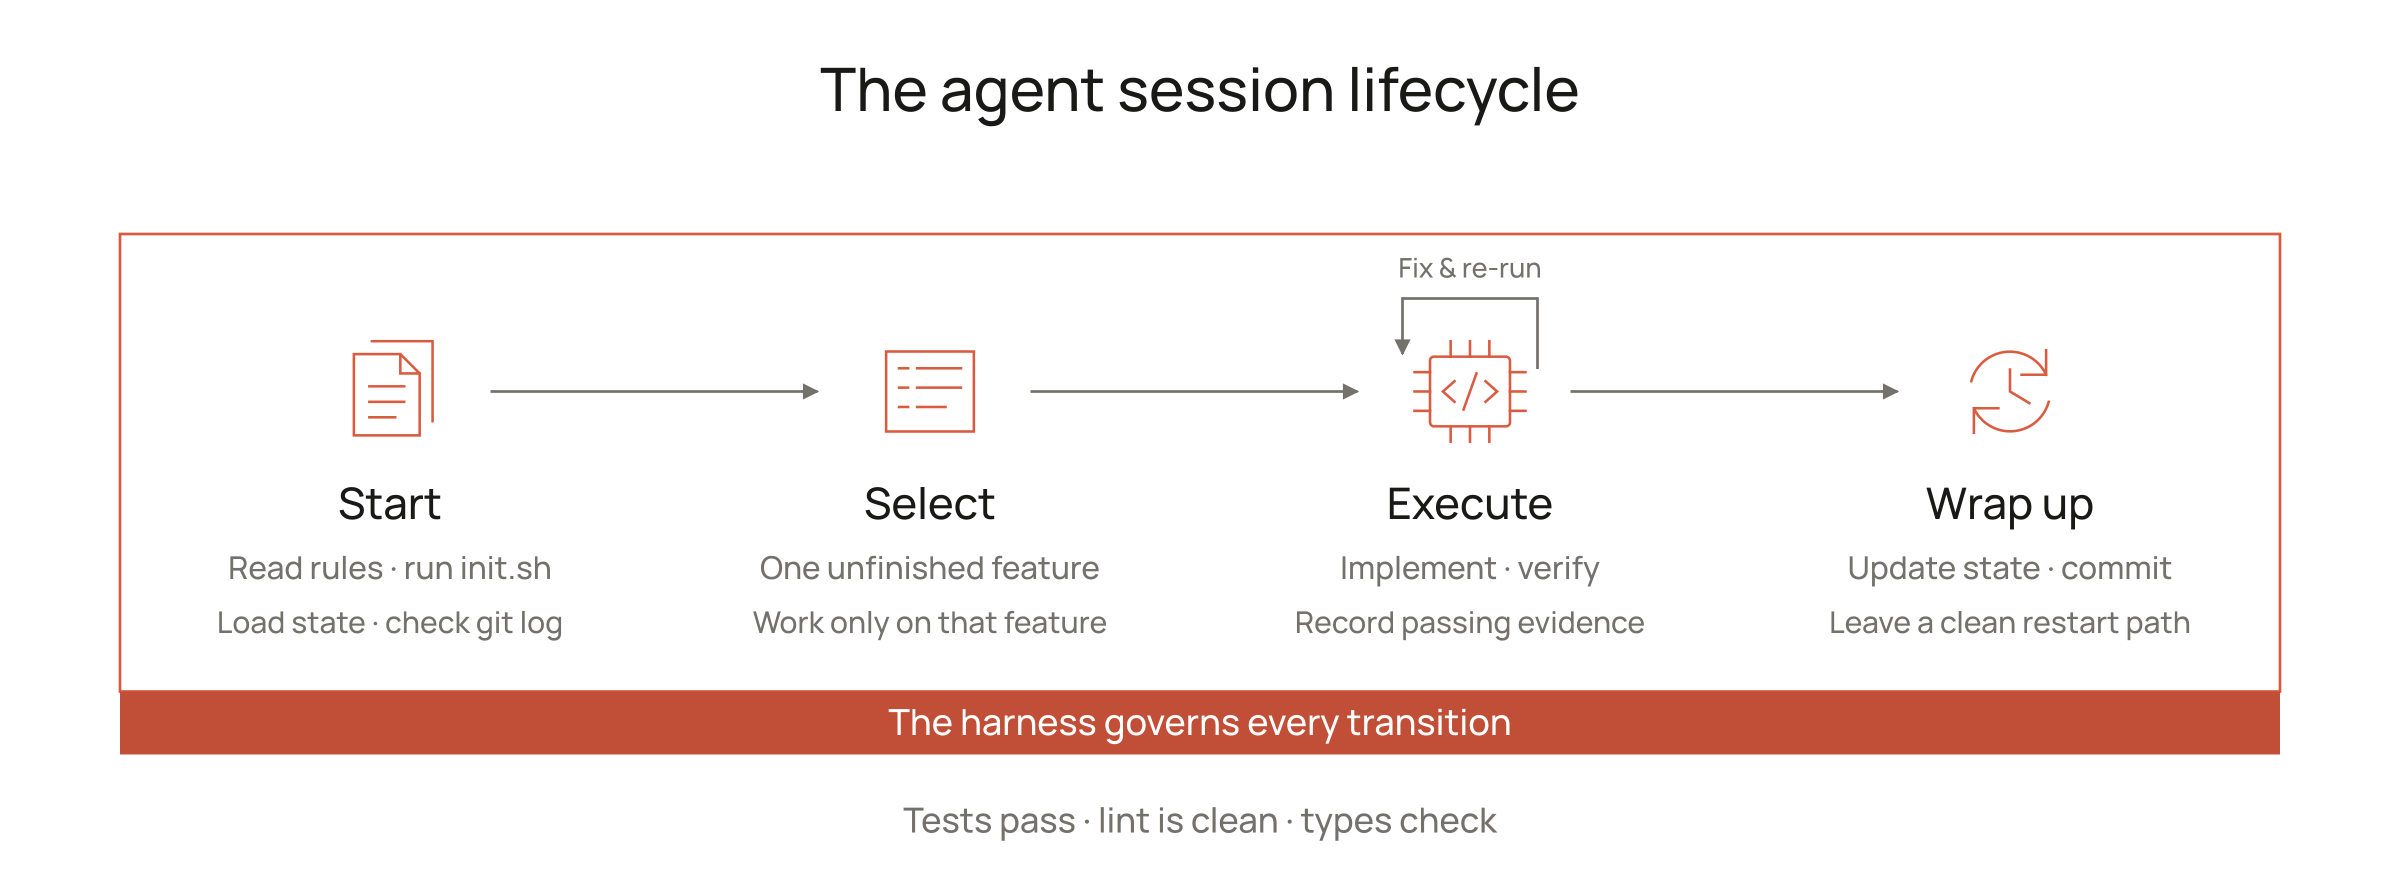
harness 其实有一个主要的目的,那就是怎么让 agent 可以稳定的长时间工作。哪怕是因为网络断了,或者切换 session 会话了,那么也可以成功的续上接着做。
而一个最简单的实现是,通过 4 个文件来串起来一个工作流。我们先假设,你需要实现一个从 0 到 1 的应用,它可能包括十几个功能,需要 agent 至少要干一长段时间才能完成的。
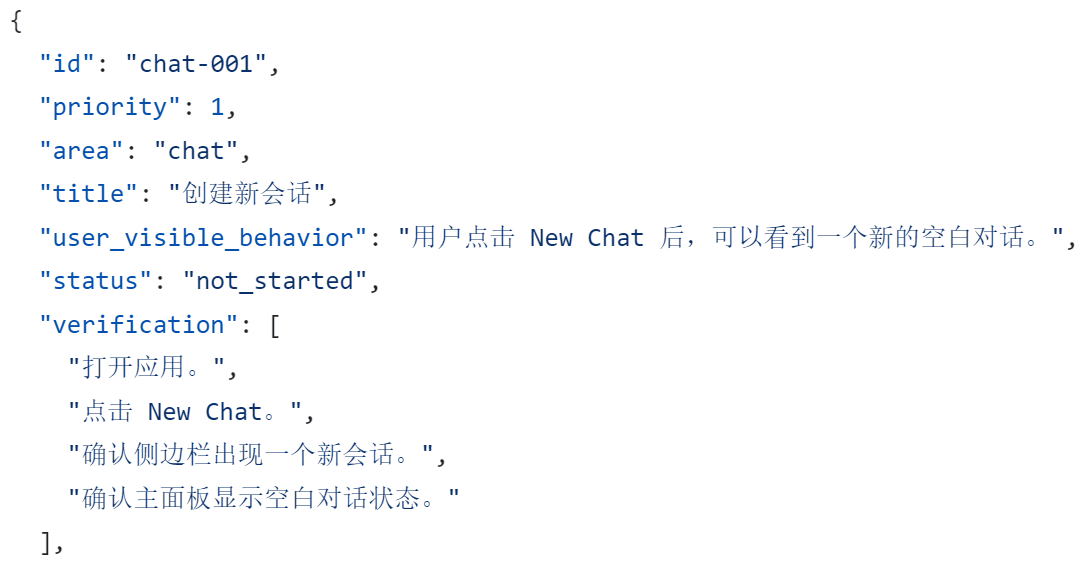
先初始化代码仓库(这个是 agent 能看到的全部),然后需要使用 claude code 的 plan 模式,先聊好功能需求(人要参与),最终得到第一个文件 feature-list.json, 里面包括了所有功能和验证的步骤和状态。
然后就需要开始编写 agent 的入口文件 AGENTS.md (或 Claude.md), 这里要把它当做是一个路由和中心流程控制文件。之前我们也聊过这个文件可以包含简短的架构,技术栈等,这里为了讲解长程工作流,那么会忽略这些基础部分。
所以 AGENTS.md 会是一个地图,制定工作流然后把其他文件串起来。开头需要先指明有几个文件,分别做什么的。
1. feature-list.json:功能需求的唯一来源。
2. progress.md: 会话进度以及当前验证的状态。
3. hands-off.md: 较长会话需要的摘要,说明整体都做到什么程度了。接下来要做什么。
罗列完必要文件,那么就是定义工作流。
1. 读取 progress.md, 了解最新状态和进度,下一步是什么。
2. 读取 feature-list.json , 选择最高优先级,且 status 不等于 passing 的功能进行开发和测试。
3. 使用 git log 来查看最近的 5 次提交。
4. 开发任何功能前,保证 smoke test 都跑过。如果有测试失败的,先修复错误再继续开发新功能。
定义完工作流,那就是收尾,什么时候更新这些文件。对于 progress.md 文件,实际上就是记录每个会话的历史,都做了什么,验证了什么。能给 Agent 一个完整的历史上下文。
而对于 hands-off.md 文件,它更像是对于 feature-list.json 和 progress.md 文件的汇总摘要,然后要递交给 subagent 的时候,subagent 要接着开发新功能的场景。
而且一个有用的技巧就是,这些文件,一开始可以只给模板,就是定义好要填写什么内容和字段,Agent 会自己理解后来进行填空。
而最后的结尾指令,还是需要写在 AGENTS.md 文件中,指示 agent 进行文件的更新。
1. 每一项功能完成后,都需要更新 featurel-list.json, 同时更新 progress.md
2. 同时使用 git commit 进行功能的提交。
harness 其实有一个主要的目的,那就是怎么让 agent 可以稳定的长时间工作。哪怕是因为网络断了,或者切换 session 会话了,那么也可以成功的续上接着做。
而一个最简单的实现是,通过 4 个文件来串起来一个工作流。我们先假设,你需要实现一个从 0 到 1 的应用,它可能包括十几个功能,需要 agent 至少要干一长段时间才能完成的。
先初始化代码仓库(这个是 agent 能看到的全部),然后需要使用 claude code 的 plan 模式,先聊好功能需求(人要参与),最终得到第一个文件 feature-list.json, 里面包括了所有功能和验证的步骤和状态。
然后就需要开始编写 agent 的入口文件 AGENTS.md (或 Claude.md), 这里要把它当做是一个路由和中心流程控制文件。之前我们也聊过这个文件可以包含简短的架构,技术栈等,这里为了讲解长程工作流,那么会忽略这些基础部分。
所以 AGENTS.md 会是一个地图,制定工作流然后把其他文件串起来。开头需要先指明有几个文件,分别做什么的。
1. feature-list.json:功能需求的唯一来源。
2. progress.md: 会话进度以及当前验证的状态。
3. hands-off.md: 较长会话需要的摘要,说明整体都做到什么程度了。接下来要做什么。
罗列完必要文件,那么就是定义工作流。
1. 读取 progress.md, 了解最新状态和进度,下一步是什么。
2. 读取 feature-list.json , 选择最高优先级,且 status 不等于 passing 的功能进行开发和测试。
3. 使用 git log 来查看最近的 5 次提交。
4. 开发任何功能前,保证 smoke test 都跑过。如果有测试失败的,先修复错误再继续开发新功能。
定义完工作流,那就是收尾,什么时候更新这些文件。对于 progress.md 文件,实际上就是记录每个会话的历史,都做了什么,验证了什么。能给 Agent 一个完整的历史上下文。
而对于 hands-off.md 文件,它更像是对于 feature-list.json 和 progress.md 文件的汇总摘要,然后要递交给 subagent 的时候,subagent 要接着开发新功能的场景。
而且一个有用的技巧就是,这些文件,一开始可以只给模板,就是定义好要填写什么内容和字段,Agent 会自己理解后来进行填空。
而最后的结尾指令,还是需要写在 AGENTS.md 文件中,指示 agent 进行文件的更新。
1. 每一项功能完成后,都需要更新 featurel-list.json, 同时更新 progress.md
2. 同时使用 git commit 进行功能的提交。
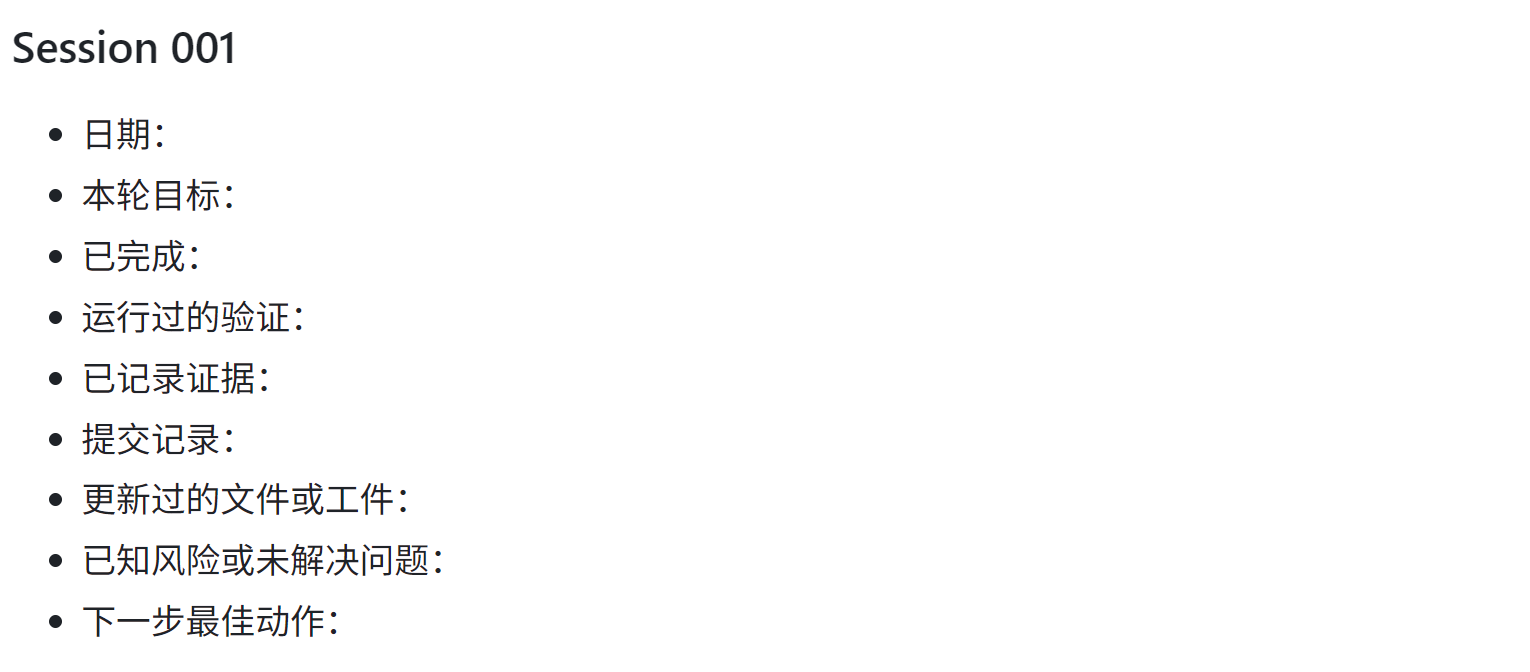
0 00
【harness 之上下文优化。】
上下文很重要,有没有 harness 这个概念都一样,日常用 agent 就得优化上下文。harness 的作用是把这件事变得可重复、可工程化。
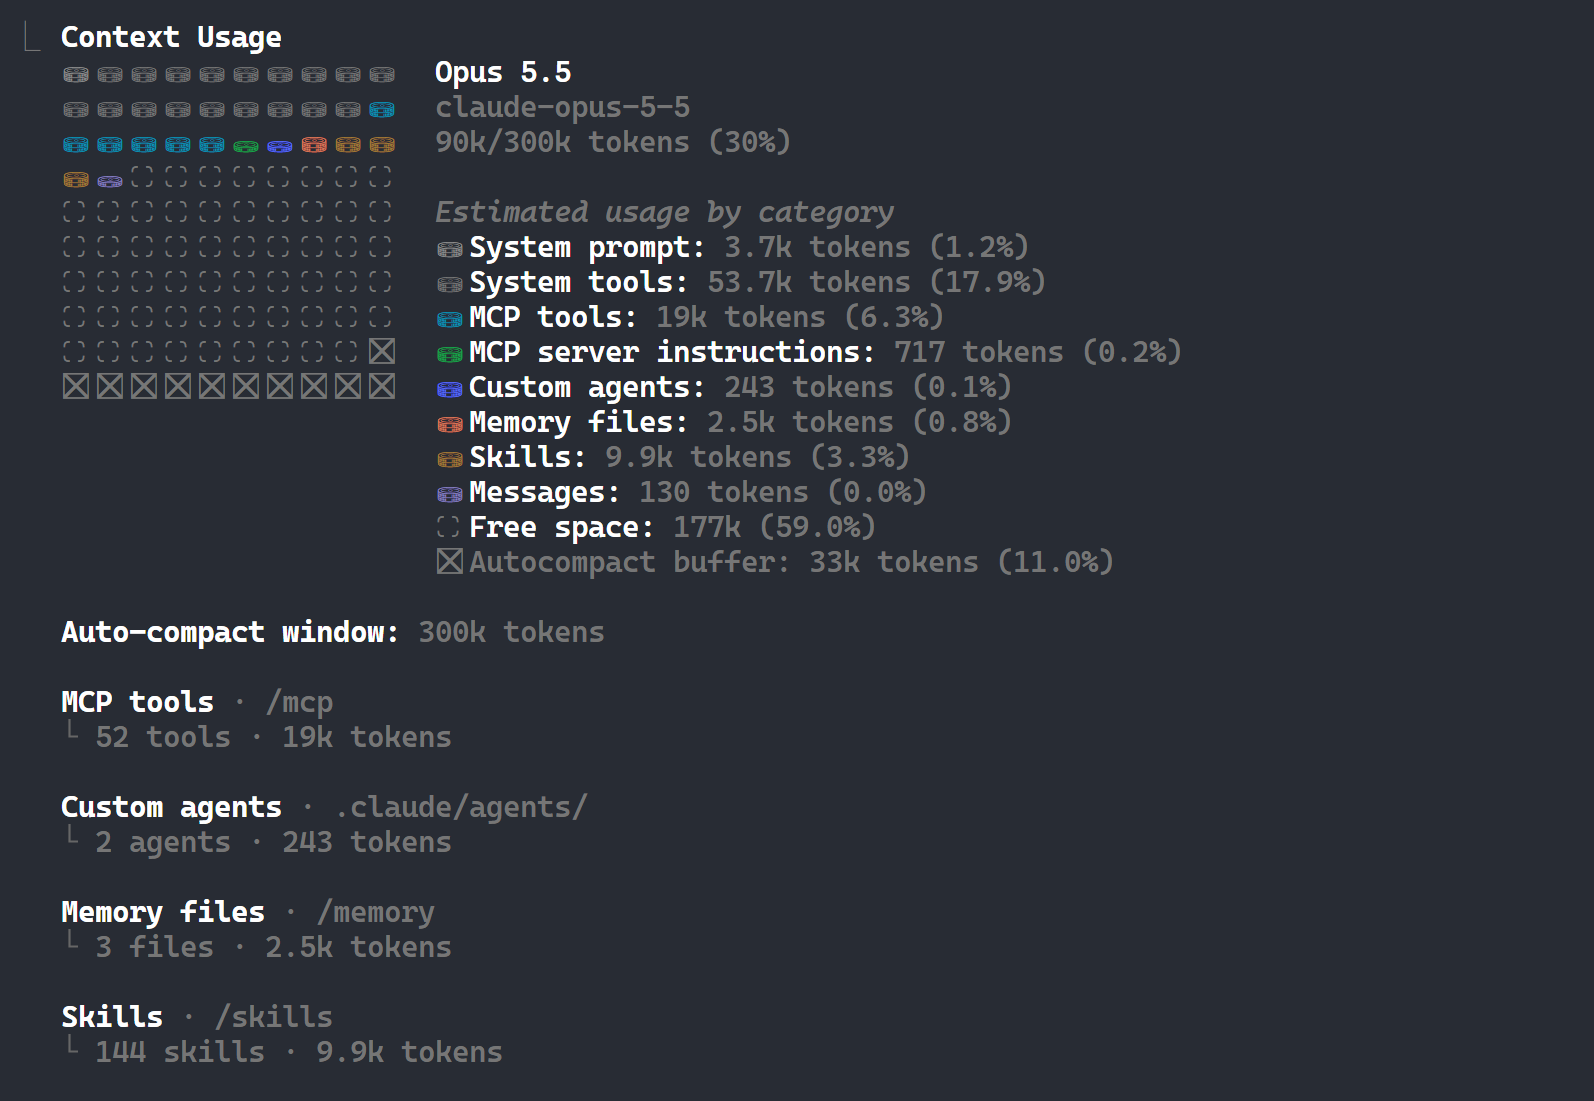
下面是我 claude code 清空 session 后的上下文占用:
清空 session 之后,先被吃掉的是工具和 skill 的描述,对话还没开始。
1. 你什么都没干,可能只剩 59% 的可用上下文了。(窗口我刻意设成了 300k,太长容易有 lost in the middle 的问题)
2. 其中 mcp 工具和系统工具就占用将近 25%
3. skill 有 144 个,才占 3.3%
据此在构建 harness 时,有几件事值得做。
一是系统工具太多。我以前也一直用 claude code 的 headless 模式构建 agent,现在可以用 pi agent,它的系统工具只有 4 个。
二是 mcp tool。mcp server 的存在没法避免,有些是其他软件服务提供的,但为了少占上下文,可以把你要用的 mcp tool 直接转成 cli 用。
Github 上现成有两个好用的转换工具:knowsuchagency/mcp2cli 和 openclaw/mcporter,都能满足需求。
三是善用 skill。agent 加载 skill 是渐进式的,一开始只读名字和很少的描述,144 个 skill 只占 3.3% 就是这个原因。skill 用得对,本身就是在省上下文。
最后一点我每次优化上下文都会强调:做任务尽量用 subagent。主 agent 只把任务内容交给它,subagent 从干净的上下文开始,读什么文件、调什么工具都留在它自己的上下文里,最后只把结果和必要的引用文件交回来。
这样搭出来的 harness,主 agent 的上下文留给判断和推进,不会被工具返回和文件内容挤满。
上下文很重要,有没有 harness 这个概念都一样,日常用 agent 就得优化上下文。harness 的作用是把这件事变得可重复、可工程化。
下面是我 claude code 清空 session 后的上下文占用:
清空 session 之后,先被吃掉的是工具和 skill 的描述,对话还没开始。
1. 你什么都没干,可能只剩 59% 的可用上下文了。(窗口我刻意设成了 300k,太长容易有 lost in the middle 的问题)
2. 其中 mcp 工具和系统工具就占用将近 25%
3. skill 有 144 个,才占 3.3%
据此在构建 harness 时,有几件事值得做。
一是系统工具太多。我以前也一直用 claude code 的 headless 模式构建 agent,现在可以用 pi agent,它的系统工具只有 4 个。
二是 mcp tool。mcp server 的存在没法避免,有些是其他软件服务提供的,但为了少占上下文,可以把你要用的 mcp tool 直接转成 cli 用。
Github 上现成有两个好用的转换工具:knowsuchagency/mcp2cli 和 openclaw/mcporter,都能满足需求。
三是善用 skill。agent 加载 skill 是渐进式的,一开始只读名字和很少的描述,144 个 skill 只占 3.3% 就是这个原因。skill 用得对,本身就是在省上下文。
最后一点我每次优化上下文都会强调:做任务尽量用 subagent。主 agent 只把任务内容交给它,subagent 从干净的上下文开始,读什么文件、调什么工具都留在它自己的上下文里,最后只把结果和必要的引用文件交回来。
这样搭出来的 harness,主 agent 的上下文留给判断和推进,不会被工具返回和文件内容挤满。
0 00
【继续聊聊 harness, 构建一个简单的 harness】
之前聊过什么是 harness,但是如果让大家来对着一个大模型开始做 harness,可能基本都不知道怎么做。
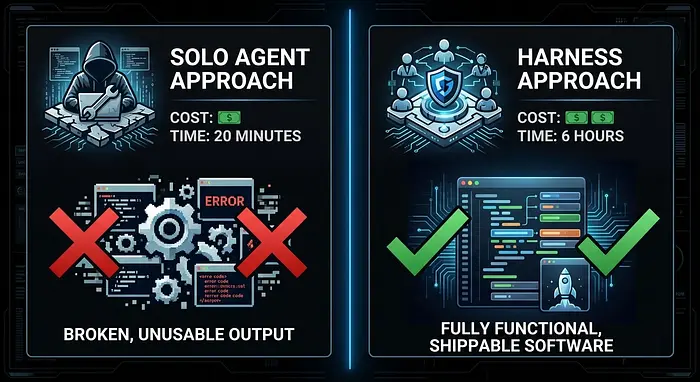
最早 Anthropic 做过实验,同一个大模型 Opus,同一个提示词,但是一个有 harness,一个裸跑,比如“做一个 2D 复古游戏编辑器”,最终的结果是裸跑的大模型 Opus 花费很少,大概$9,但是交付出来的编辑器完全不能用,但是有着 harness 的,花费很多,$200, 但是交付出来一个可以使用的编辑器。
拿我们开发一个项目来做,那么最简单和最基本的 harness 应该怎么做?按照我个人的使用经验,只需要最简单几步。
1. 使用最好的模型,比如 opus 5.5, 如果你能用上最好的模型,那么就不要用第二的模型。道理很简单,模型弱一档,你就需要 harness 强上一档。就像早两年,如果模型比较弱的时候,那么就需要写上大量的提示词,去引导模型和规范模型一个道理。
2. 所有的功能开发都需要一个 spec,这里最简单的就是使用 matt-pocock 的 grill-me 技能,基本要梳理很多问题,但是聊完落地为 spec 文档后,agent 是可以干活很长时间的。这步其实很关键,也很花时间,但是想要长程任务的基本上都是这种方式。关于 Spec,也可以看看最近比较火热的 Jetbrains 开源的 Thinkrail,它的基石基本也是 spec。
3. 开发是 agent 的强项,所以很多人说下一步就是验证,但是没有人会写很多的测试用例给 AI 的,而且不管是 unit test 还是 e2e,实际上还是 AI 的擅长领域,这一块基本上只需要 tdd 和让 AI 实现 e2e 就差不多了。唯一要加的是,有一些重要结果的校验,就像是测试集,比如原价是多少,各种打折后,最终价格是多少。一般我会根据需求提供一份来作为关键逻辑的校验。剩下的校验都是 AI 根据 spec 来进行的。再一次强调,spec 很重要。
4. 代码写完了,要做什么?重点是提供 lint 检查,比如代码风格,代码坏味,安全检查,bugs 检查等等,类似之前 Java 世界里面的 PMD,Checkstyle,SpotBugs etc, 每个技术栈都有自己的 linter。但是大家往往忘记的是,写代码前,更好的做法是先给一个代码的参考,让 AI 先根据参考代码写。
5. 最后一点,是最重要的,让 agent 看到你可以看到的一切,通过自建的工具。agent 能看到日志吗,能看到 tracing logs 吗,可以看到所有的数据和文档吗,可以看到运行环境吗,这些都是需要你提供工具给它的。
所以,如果你在项目开发,需要先构建一个最简的 harness,上面就是一个模板。
之前聊过什么是 harness,但是如果让大家来对着一个大模型开始做 harness,可能基本都不知道怎么做。
最早 Anthropic 做过实验,同一个大模型 Opus,同一个提示词,但是一个有 harness,一个裸跑,比如“做一个 2D 复古游戏编辑器”,最终的结果是裸跑的大模型 Opus 花费很少,大概$9,但是交付出来的编辑器完全不能用,但是有着 harness 的,花费很多,$200, 但是交付出来一个可以使用的编辑器。
拿我们开发一个项目来做,那么最简单和最基本的 harness 应该怎么做?按照我个人的使用经验,只需要最简单几步。
1. 使用最好的模型,比如 opus 5.5, 如果你能用上最好的模型,那么就不要用第二的模型。道理很简单,模型弱一档,你就需要 harness 强上一档。就像早两年,如果模型比较弱的时候,那么就需要写上大量的提示词,去引导模型和规范模型一个道理。
2. 所有的功能开发都需要一个 spec,这里最简单的就是使用 matt-pocock 的 grill-me 技能,基本要梳理很多问题,但是聊完落地为 spec 文档后,agent 是可以干活很长时间的。这步其实很关键,也很花时间,但是想要长程任务的基本上都是这种方式。关于 Spec,也可以看看最近比较火热的 Jetbrains 开源的 Thinkrail,它的基石基本也是 spec。
3. 开发是 agent 的强项,所以很多人说下一步就是验证,但是没有人会写很多的测试用例给 AI 的,而且不管是 unit test 还是 e2e,实际上还是 AI 的擅长领域,这一块基本上只需要 tdd 和让 AI 实现 e2e 就差不多了。唯一要加的是,有一些重要结果的校验,就像是测试集,比如原价是多少,各种打折后,最终价格是多少。一般我会根据需求提供一份来作为关键逻辑的校验。剩下的校验都是 AI 根据 spec 来进行的。再一次强调,spec 很重要。
4. 代码写完了,要做什么?重点是提供 lint 检查,比如代码风格,代码坏味,安全检查,bugs 检查等等,类似之前 Java 世界里面的 PMD,Checkstyle,SpotBugs etc, 每个技术栈都有自己的 linter。但是大家往往忘记的是,写代码前,更好的做法是先给一个代码的参考,让 AI 先根据参考代码写。
5. 最后一点,是最重要的,让 agent 看到你可以看到的一切,通过自建的工具。agent 能看到日志吗,能看到 tracing logs 吗,可以看到所有的数据和文档吗,可以看到运行环境吗,这些都是需要你提供工具给它的。
所以,如果你在项目开发,需要先构建一个最简的 harness,上面就是一个模板。
0 00
【什么是 harness?】
这可能是我见过写的最通俗的解释 agent 和 harness 的描述了。
所谓的 agent,就是助理。他要做的事情跟 Chatbot 不一样的是,你给他一个任务,比如帮我分析一下当前的芯片市场,写一个分析报告。
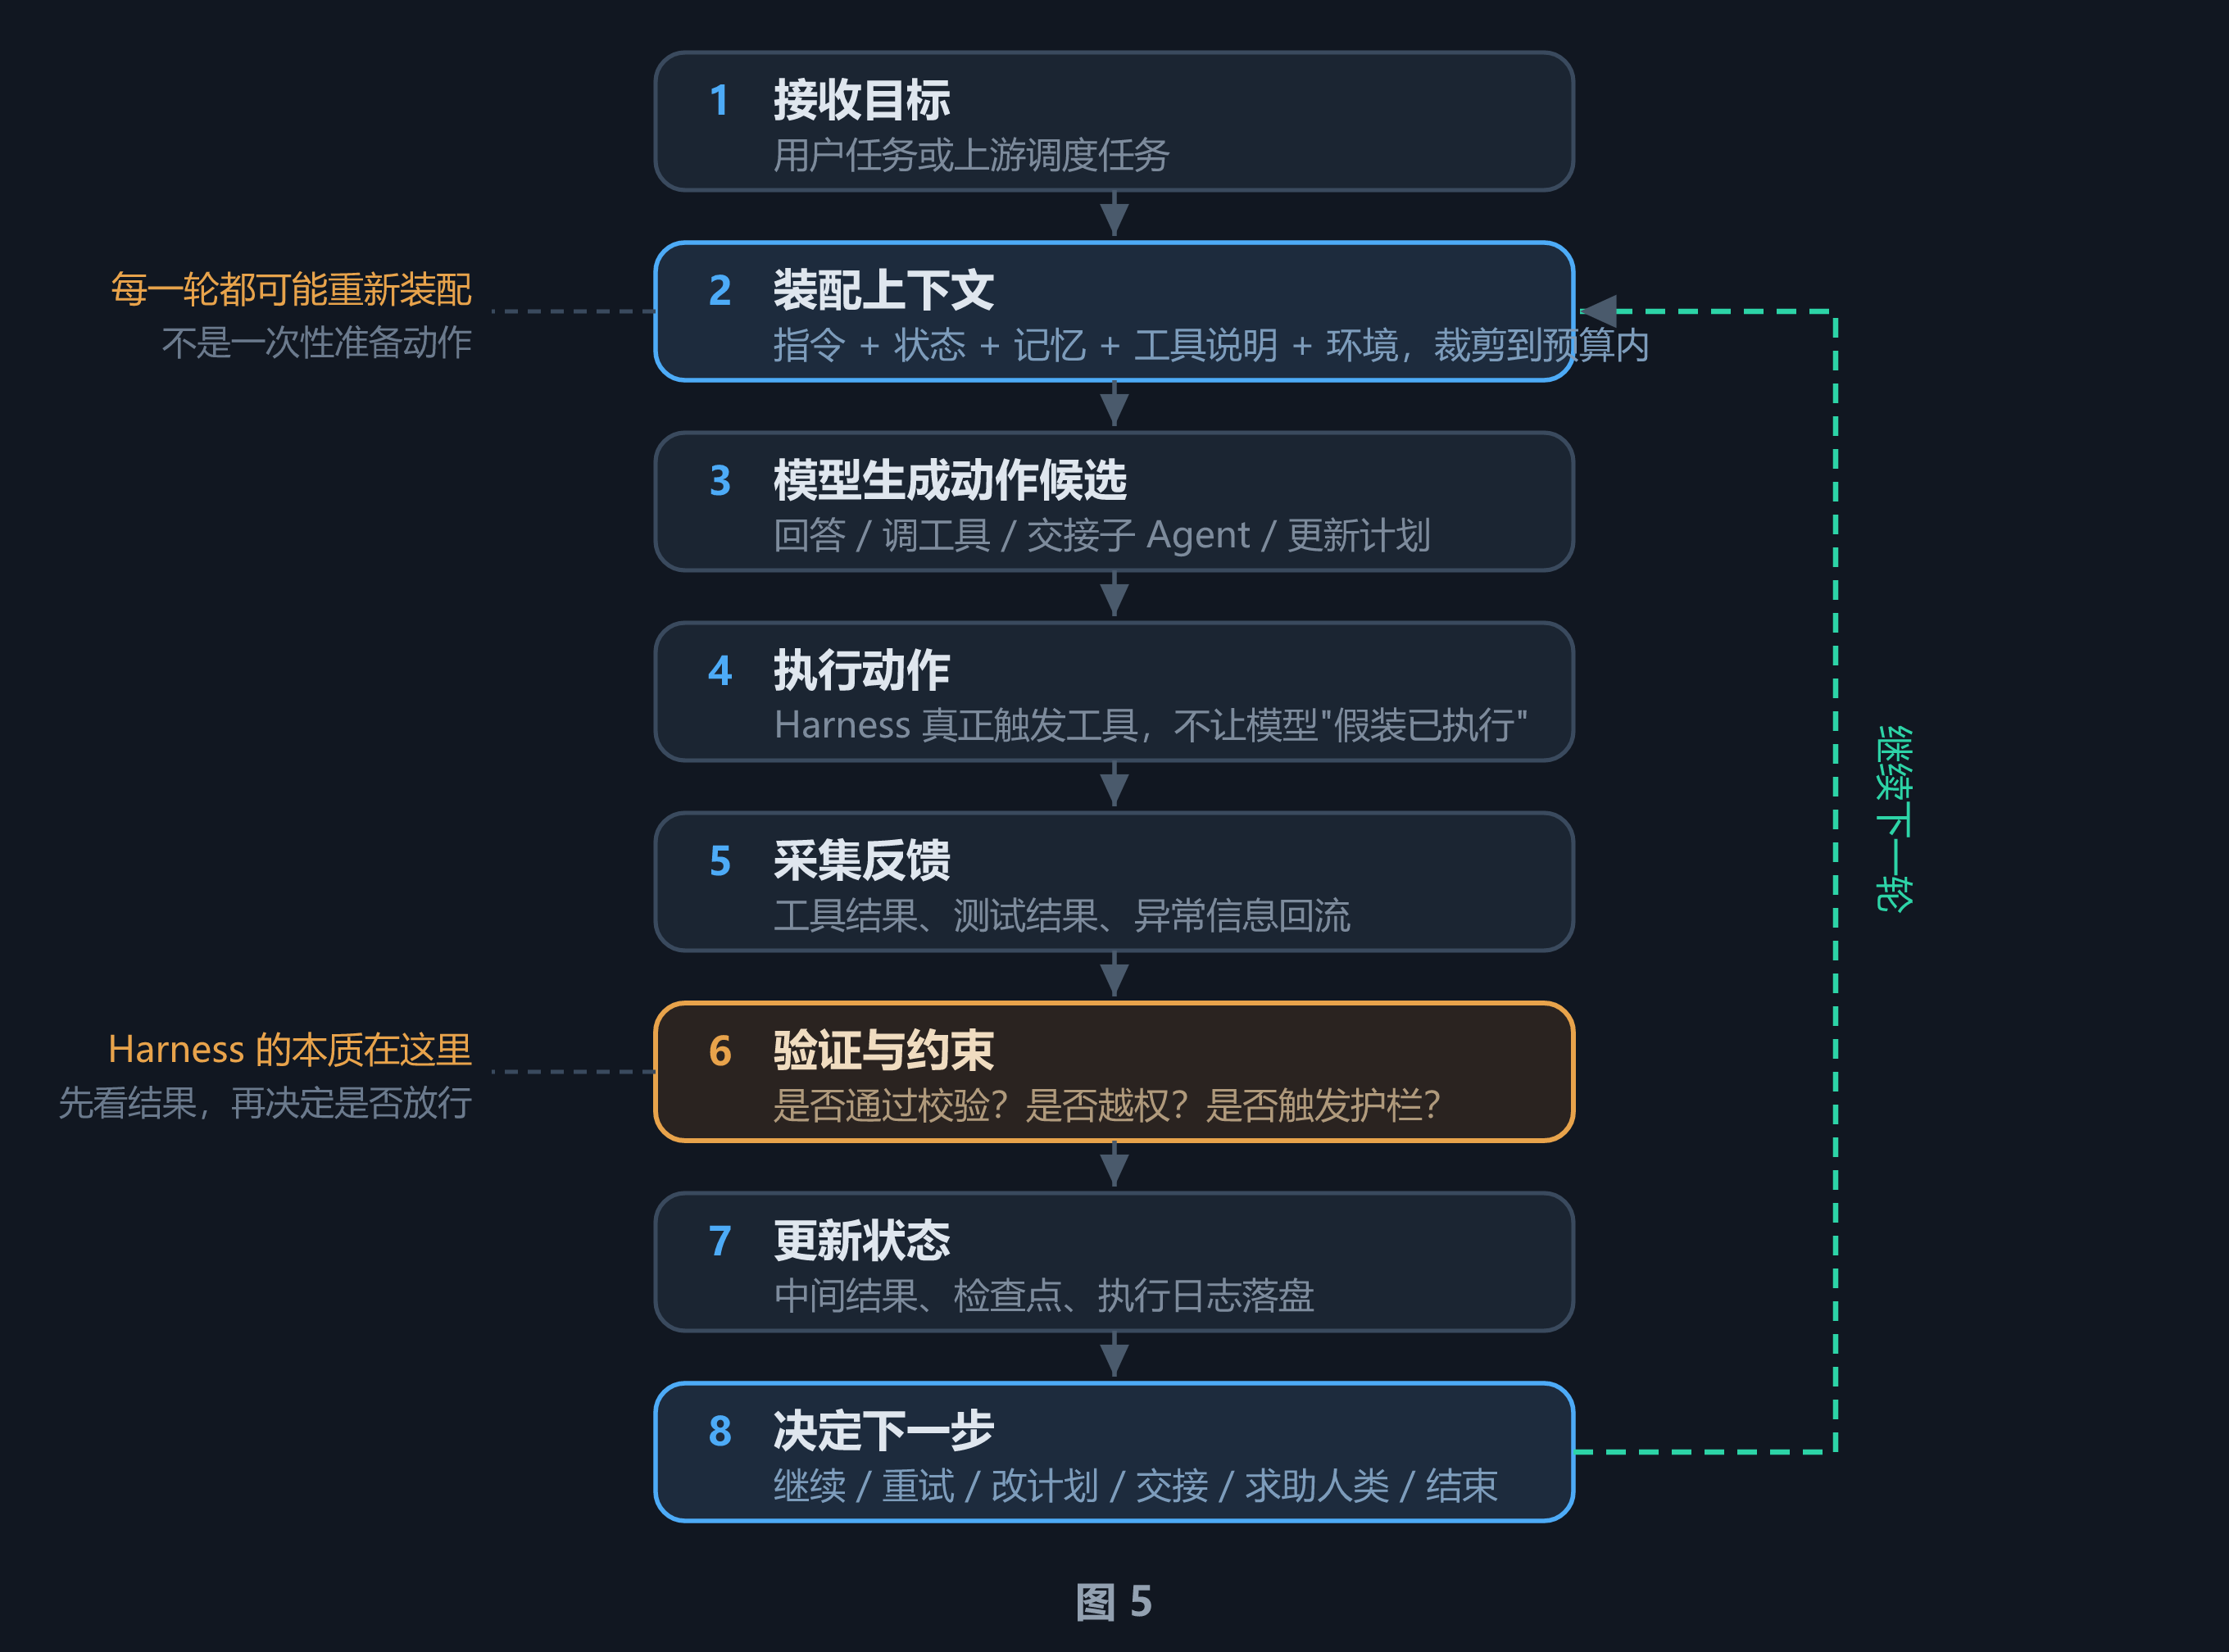
那么 agent 就会自己思考,分析要使用什么工具,比如网页搜索,去获取什么类型的信息,最后根据结果来思考下一步,是不是继续搜索网页等。
而 agent 最简单的公式就是 agent = llm + tool + harness 了。大模型就是大脑,思考用的。工具就是手和脚,让大脑看到额外的信息的,方便做下一步的决策。
那 harness 呢?其实就是怎么把大脑 ,手和脚先组合起来,像个机器人。然后还要添加上一些额外的功能来保证这个机器人是可以稳定的运行的。例如,机器人都做了什么(日志),它出错了怎么办(容错和恢复),什么事情可以做(权限管理)等等。
如果这些额外的功能是为了保证 agent 可以平稳的,不出错的运行的,那这套机制其实就叫做 harness。
这可能是我见过写的最通俗的解释 agent 和 harness 的描述了。
所谓的 agent,就是助理。他要做的事情跟 Chatbot 不一样的是,你给他一个任务,比如帮我分析一下当前的芯片市场,写一个分析报告。
那么 agent 就会自己思考,分析要使用什么工具,比如网页搜索,去获取什么类型的信息,最后根据结果来思考下一步,是不是继续搜索网页等。
而 agent 最简单的公式就是 agent = llm + tool + harness 了。大模型就是大脑,思考用的。工具就是手和脚,让大脑看到额外的信息的,方便做下一步的决策。
那 harness 呢?其实就是怎么把大脑 ,手和脚先组合起来,像个机器人。然后还要添加上一些额外的功能来保证这个机器人是可以稳定的运行的。例如,机器人都做了什么(日志),它出错了怎么办(容错和恢复),什么事情可以做(权限管理)等等。
如果这些额外的功能是为了保证 agent 可以平稳的,不出错的运行的,那这套机制其实就叫做 harness。
0 00
【什么是 Jev?】
上个月 AI 圈最热的话题,不是 GPT 或者 Claude 又出了新版本,而是一家没多少人听过的公司 TypeSafe AI 发了一个新模型,叫 Jev。
Jev 模型的最大特点就是,其他模型返回文字,它返回一个浮点数,表示概率。
我的理解是,它本质上就是一个分类模型。比如使用场景是用来判断一个是非题(yes or no),或者多选题 ABCD,那它就是一个分类模型,返回的概率表示哪个选项更可能发生。
除了是一个分类模型,它还是一个评分模型。你给它一个评分标准,然后再给它一个内容,它会自动给这个内容打分。
所以 Jev 这个模型不是文本生成模型,它就是一个 ML 时代的分类器。它的输入只是文本,输出是一个浮点数,所以它也不是一个多模态的模型。
既然是分类器,那么在 LLM 时代,它就可以用来实现很多场景。比如意图识别:这个用户问的是什么,退货、换货还是退款?或者你给它一段文本,用来判断这个文本是否跟用户的问题相关。
这些场景 LLM 也可以做,只不过太慢,耗费也太高。Jev 就很好地切入了这个场景。
那怎么用 Jev 呢?它有几个概念比较重要。
一个是 state,表示当前系统的状态,其实就是当你要调用 Jev 模型前,你要喂给 Jev 的上下文。它可以是一段文本,也可以是一个 json,或者数组,跟 LLM 的上下文保持一致。
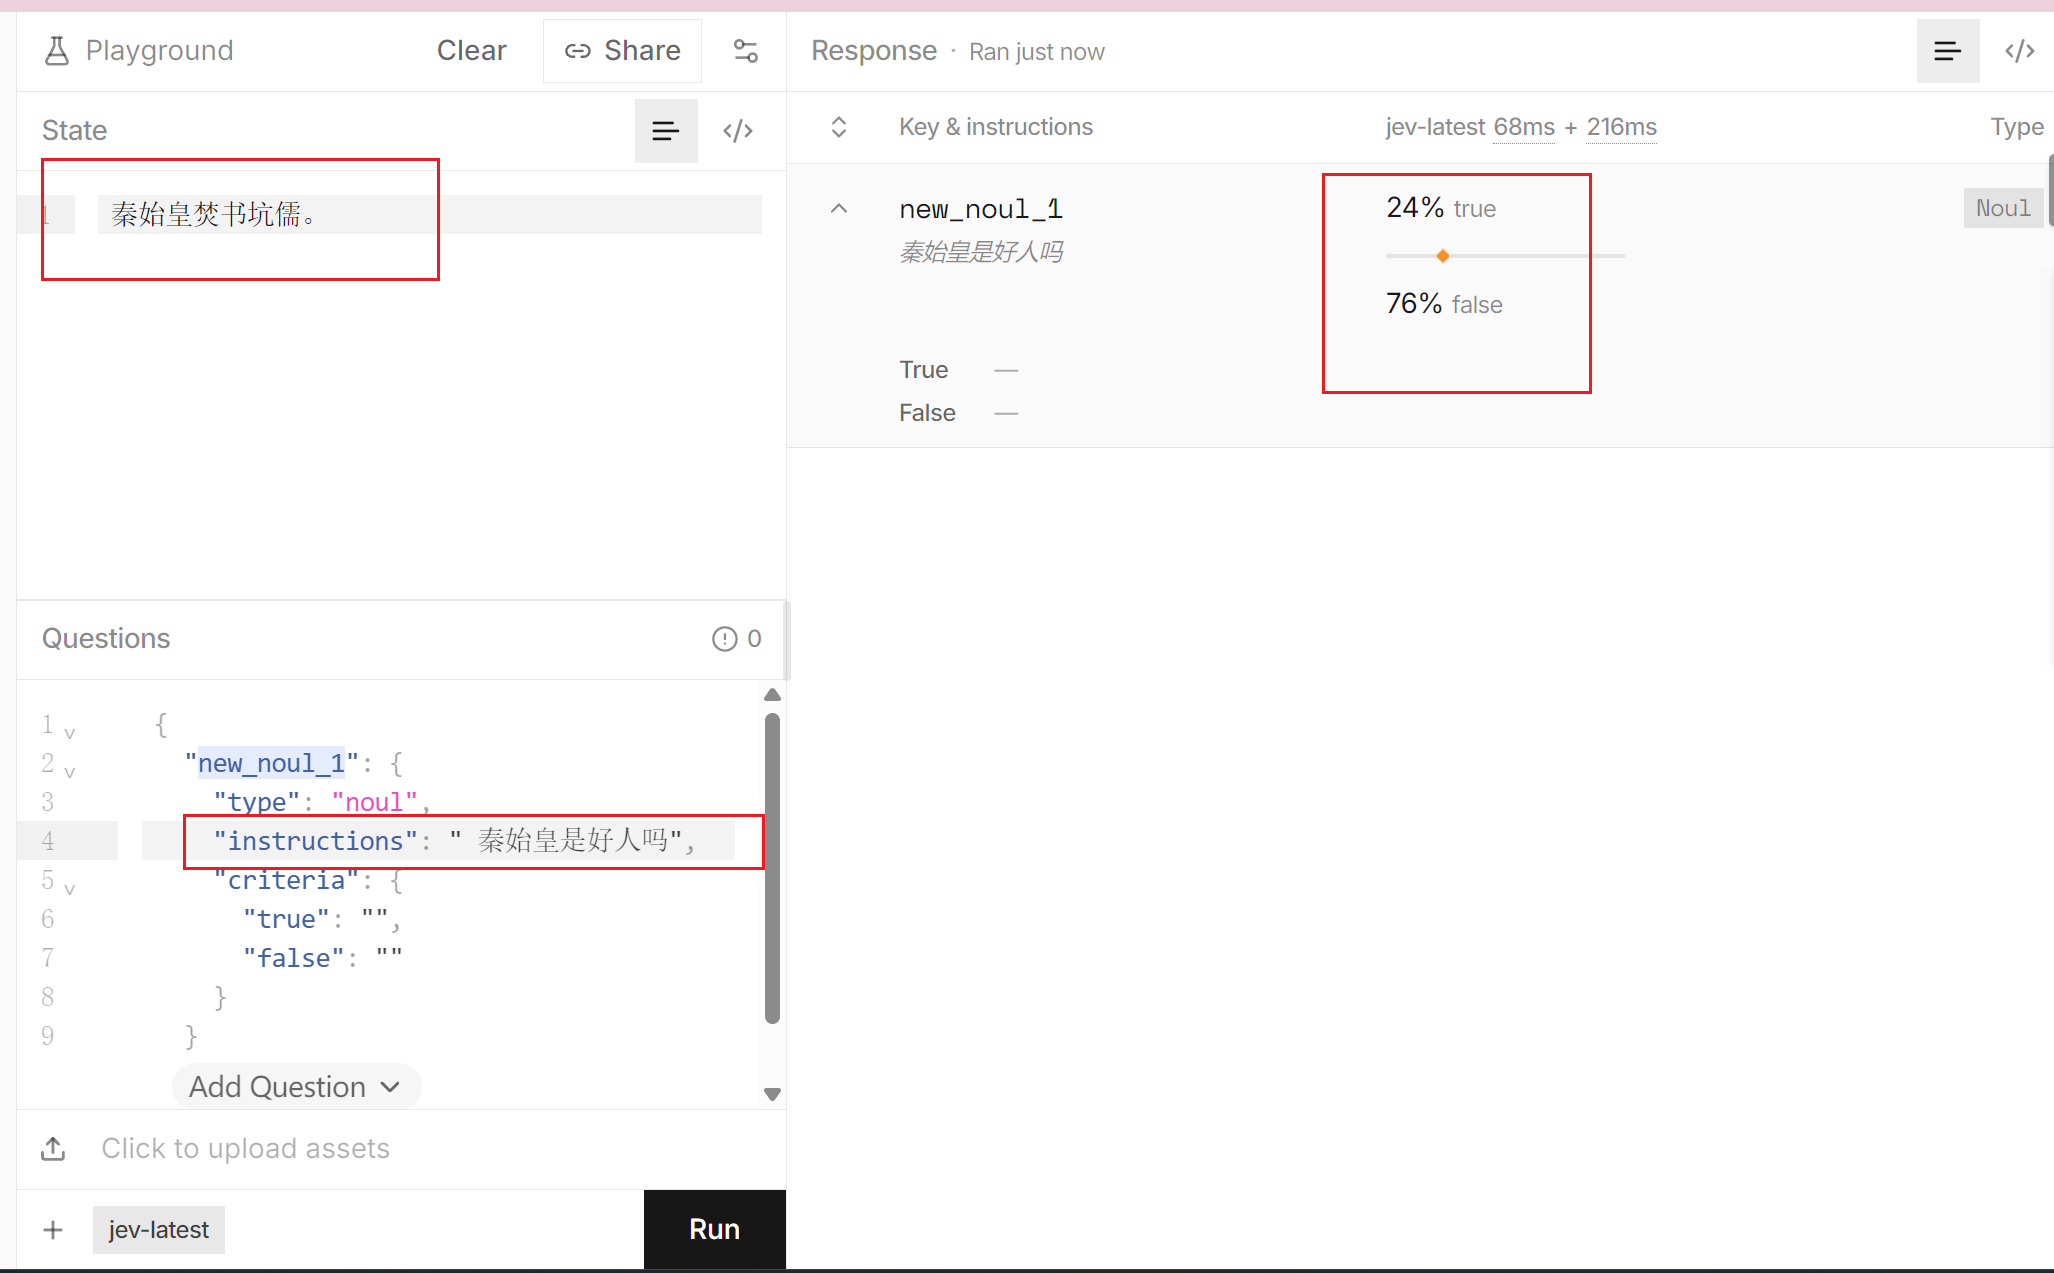
第二个概念是 questions,其实就是用户要问的问题,可以是多个。每个问题都有一个类型,比如是 noul(是非题)、choice(选择题)或者 score(评分)等。拿一个简单的 noul 问题举例,见下图。
可以看到,一次 Jev 的调用就包括三部分:state 是给 Jev 的上下文,questions 是用户的问题,返回就是一个 yes 或 no 的概率(因为这里选择的是 noul 问题类型)。
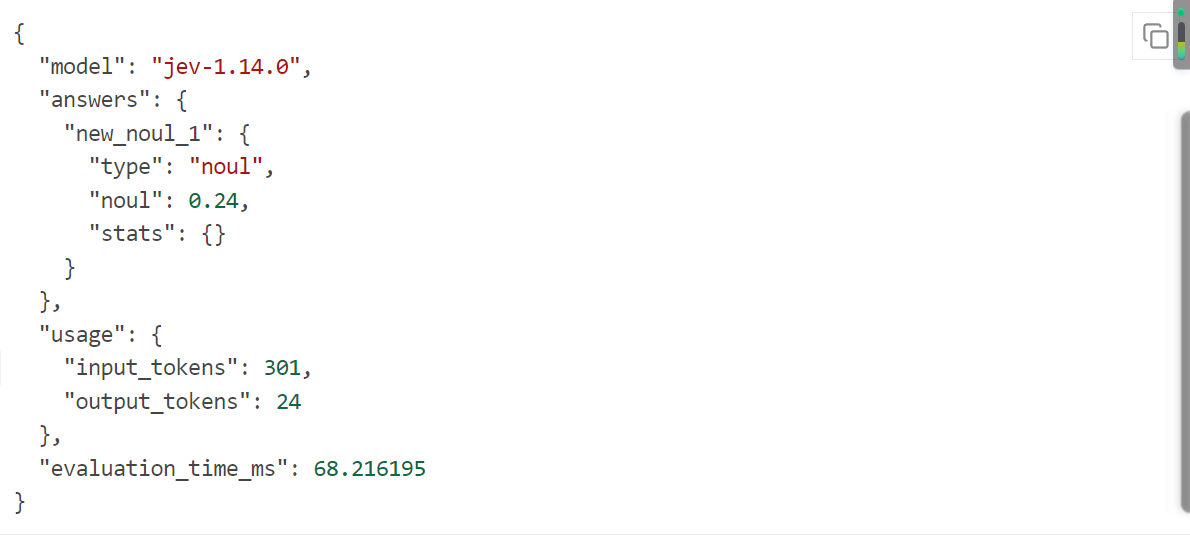
如果看 Jev 返回的 Noul 响应 JSON,大概就是下图这样。
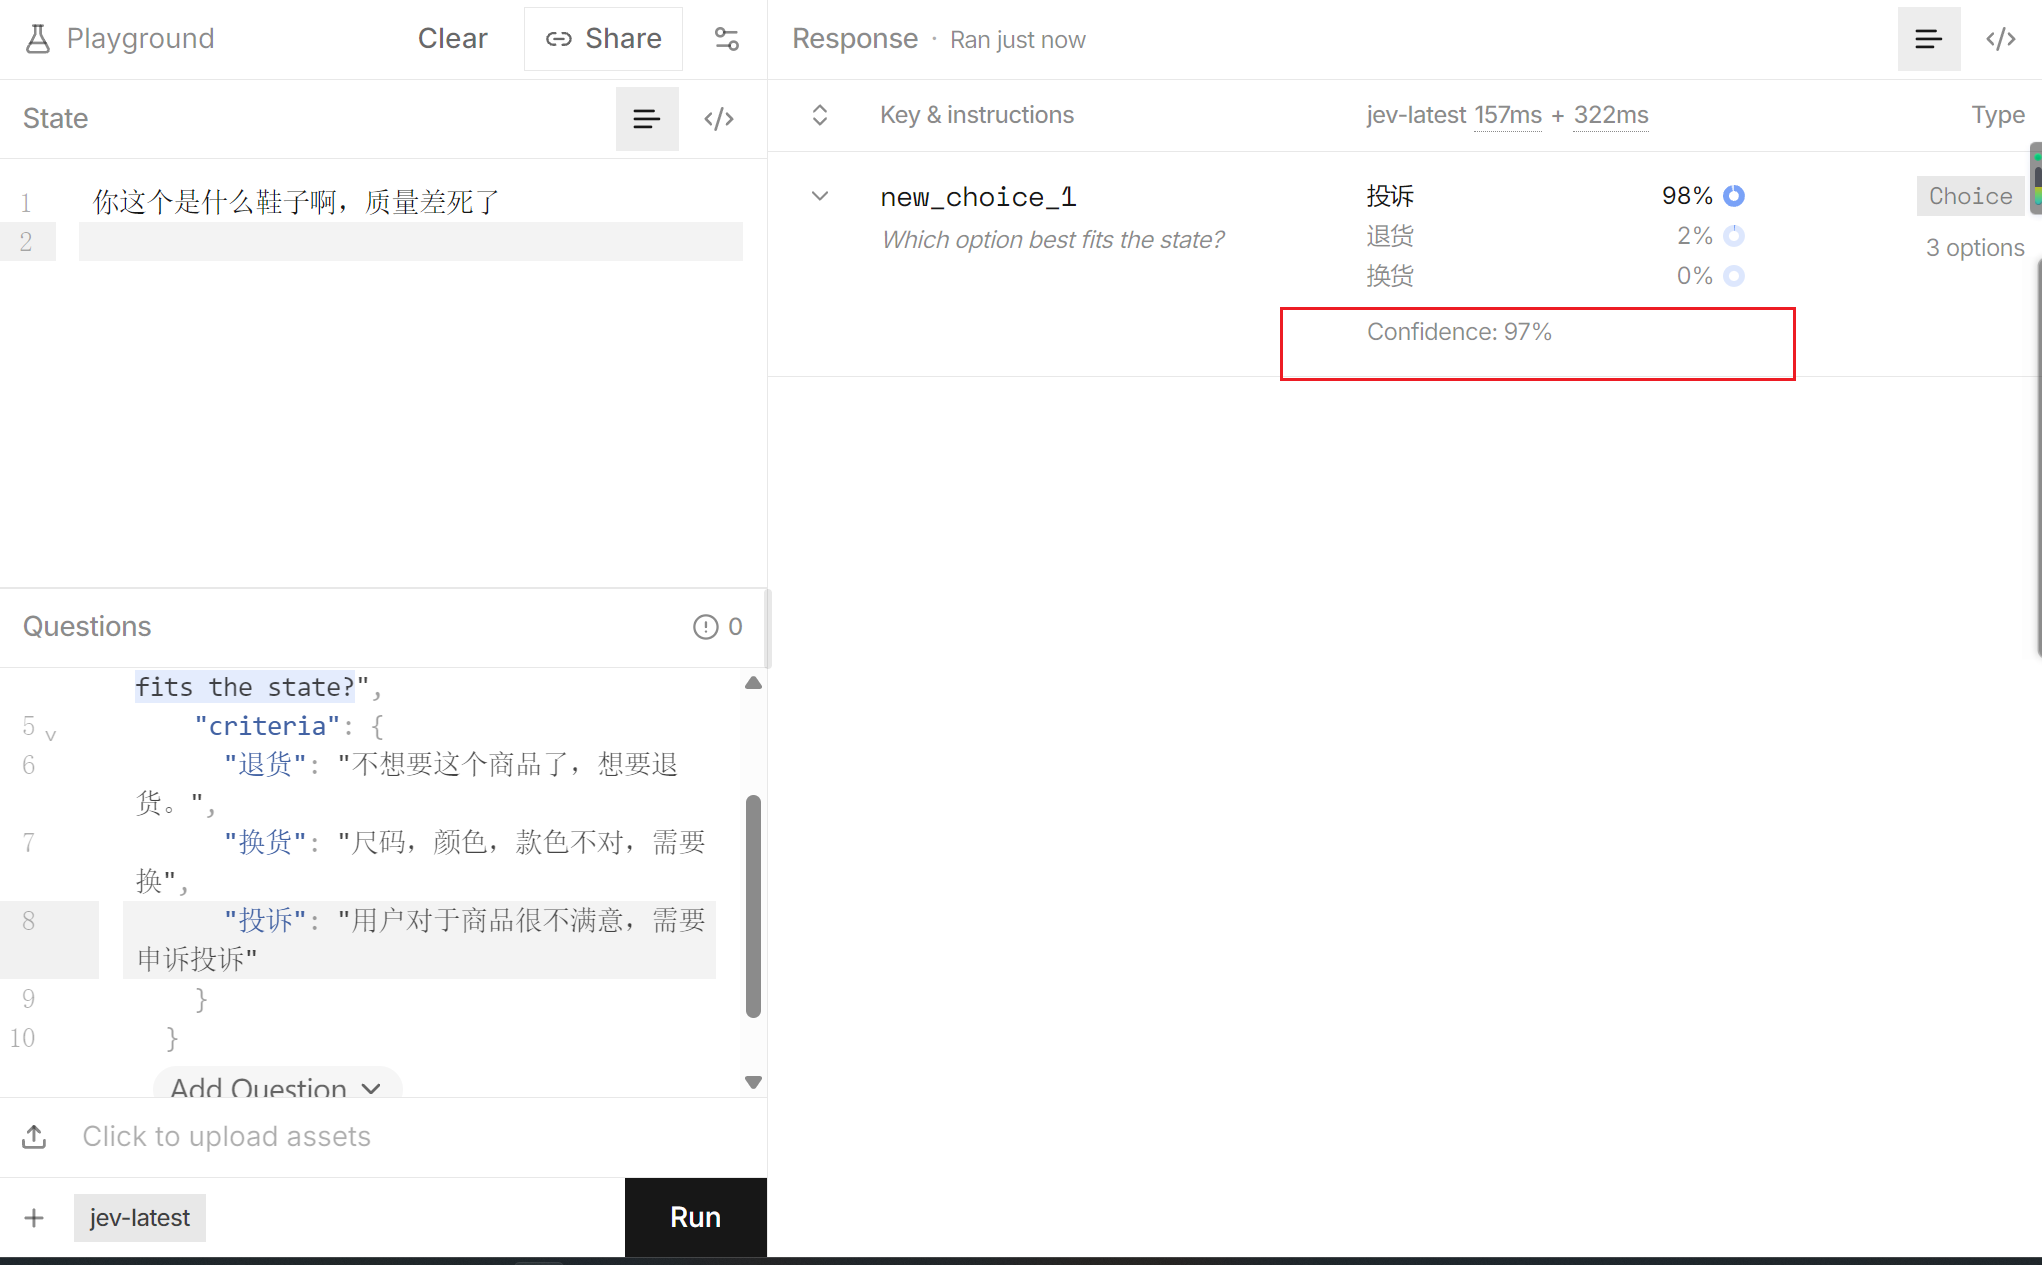
其实在 Jev 返回的内容里面,还有一个 confidence(置信度),意思是 Jev 对于这个回答的信心有多高,一般高于 90% 就是很有把握了。这个 confidence 在 noul 这个问题类型中没有,但是在 choice、score 这两类问题中是有的。
Jev 火了以后,这个方向上已经不止它一家。OpenAI 推出了 Decisions API,但它并没有专门训练一个经过校准的决策模型,而是把 ChatGPT Luna 改造了一下,把推理速度提上去、成本降下来,延迟从一两秒压到 100 到 180 毫秒,Box、Datadog、Ramp、Speak 这些客户已经拿它替掉了原来的 LLM。
还有一个值得注意的地方,现在各家的请求格式基本都照着 TypeSafe 那套来了:state 进去,带类型的问题进去,出来的是每个选项的概率加一个 confidence。也就是说,以后换模型,可能只是换个 endpoint 的事。
上个月 AI 圈最热的话题,不是 GPT 或者 Claude 又出了新版本,而是一家没多少人听过的公司 TypeSafe AI 发了一个新模型,叫 Jev。
Jev 模型的最大特点就是,其他模型返回文字,它返回一个浮点数,表示概率。
我的理解是,它本质上就是一个分类模型。比如使用场景是用来判断一个是非题(yes or no),或者多选题 ABCD,那它就是一个分类模型,返回的概率表示哪个选项更可能发生。
除了是一个分类模型,它还是一个评分模型。你给它一个评分标准,然后再给它一个内容,它会自动给这个内容打分。
所以 Jev 这个模型不是文本生成模型,它就是一个 ML 时代的分类器。它的输入只是文本,输出是一个浮点数,所以它也不是一个多模态的模型。
既然是分类器,那么在 LLM 时代,它就可以用来实现很多场景。比如意图识别:这个用户问的是什么,退货、换货还是退款?或者你给它一段文本,用来判断这个文本是否跟用户的问题相关。
这些场景 LLM 也可以做,只不过太慢,耗费也太高。Jev 就很好地切入了这个场景。
那怎么用 Jev 呢?它有几个概念比较重要。
一个是 state,表示当前系统的状态,其实就是当你要调用 Jev 模型前,你要喂给 Jev 的上下文。它可以是一段文本,也可以是一个 json,或者数组,跟 LLM 的上下文保持一致。
第二个概念是 questions,其实就是用户要问的问题,可以是多个。每个问题都有一个类型,比如是 noul(是非题)、choice(选择题)或者 score(评分)等。拿一个简单的 noul 问题举例,见下图。
可以看到,一次 Jev 的调用就包括三部分:state 是给 Jev 的上下文,questions 是用户的问题,返回就是一个 yes 或 no 的概率(因为这里选择的是 noul 问题类型)。
如果看 Jev 返回的 Noul 响应 JSON,大概就是下图这样。
其实在 Jev 返回的内容里面,还有一个 confidence(置信度),意思是 Jev 对于这个回答的信心有多高,一般高于 90% 就是很有把握了。这个 confidence 在 noul 这个问题类型中没有,但是在 choice、score 这两类问题中是有的。
Jev 火了以后,这个方向上已经不止它一家。OpenAI 推出了 Decisions API,但它并没有专门训练一个经过校准的决策模型,而是把 ChatGPT Luna 改造了一下,把推理速度提上去、成本降下来,延迟从一两秒压到 100 到 180 毫秒,Box、Datadog、Ramp、Speak 这些客户已经拿它替掉了原来的 LLM。
还有一个值得注意的地方,现在各家的请求格式基本都照着 TypeSafe 那套来了:state 进去,带类型的问题进去,出来的是每个选项的概率加一个 confidence。也就是说,以后换模型,可能只是换个 endpoint 的事。
1 10
全球AI用户使用情况漏斗分布现状分析
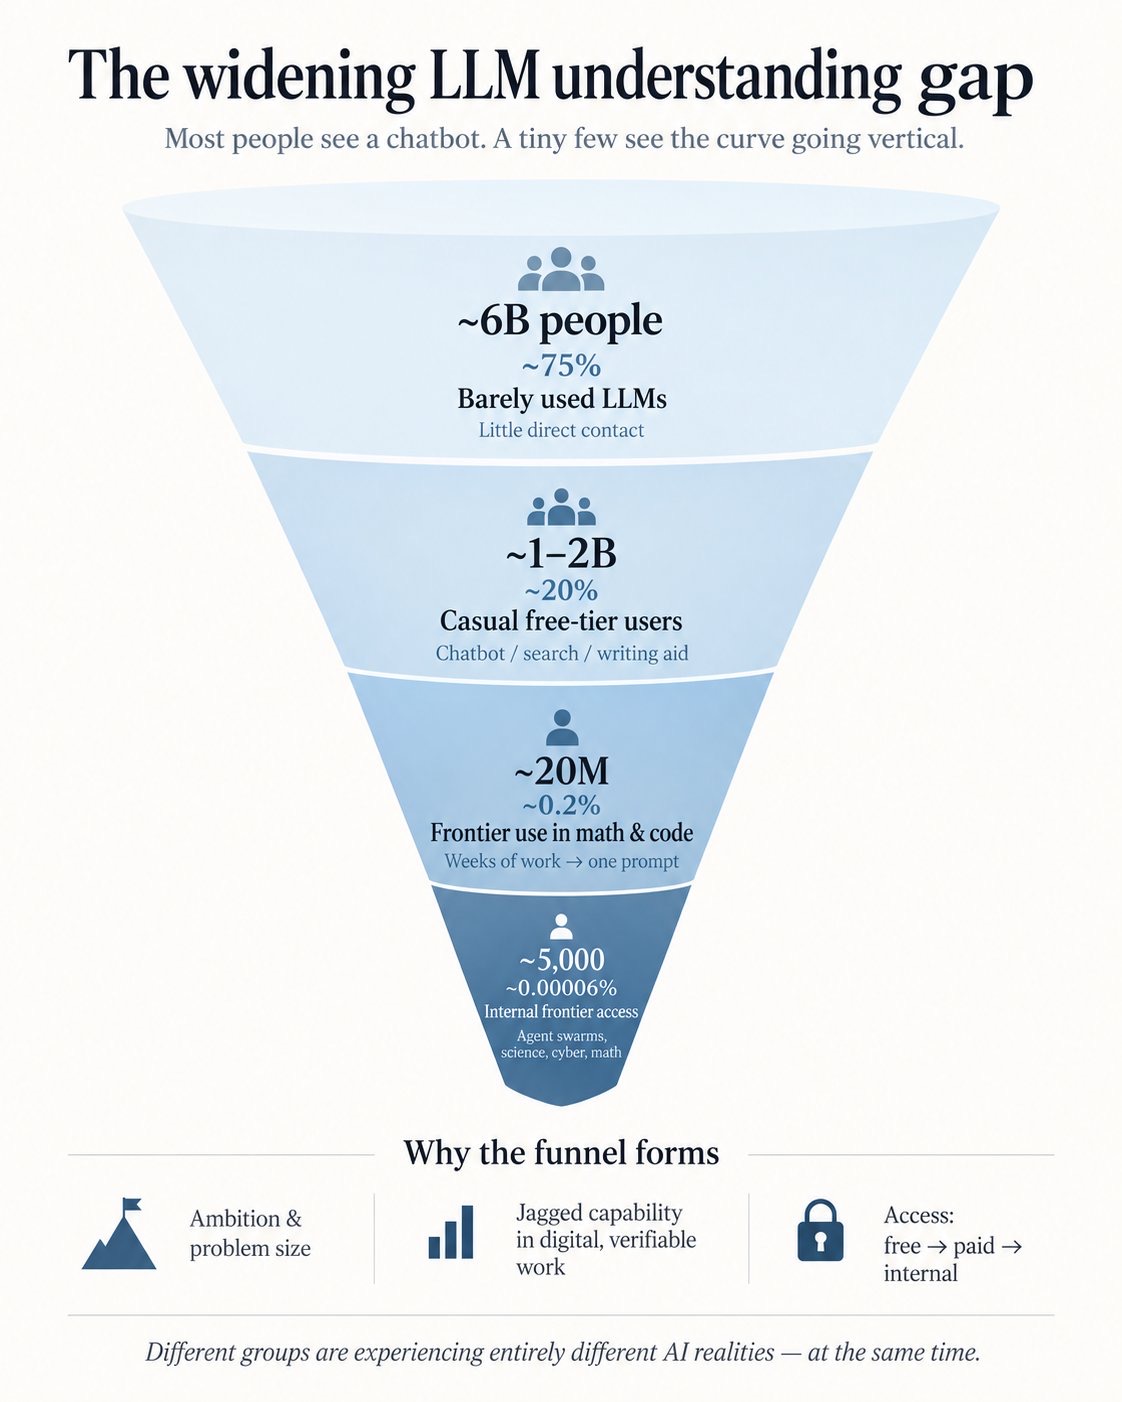
最近看到一个统计图,是关于全球用户如何使用AI的。这个图蛮有意思,呈漏斗状。
全球大概有80亿人口,其中约75%,也就是60亿人左右,基本没怎么用过大型模型,不管是ChatGPT还是国内的模型。
接下来大概20%的人能用到前沿模型,他们偶尔能用到比较前沿的大模型,会用ChatGPT,也会用Claude Code。国内的话,主要是用国内一些开源模型,他们更多是免费用户,甚至都不是付费用户。这跟另外一个报告是契合的:全球的付费用户当中,包括美国——美国算是起源地,那边的人应该用得比较多——但从付费比例来看,也是从去年的2.5%左右上升到4.5%。也就是说,绝大部分人使用AI、用ChatGPT这样的产品,都是不付费的。
再接下来是相对比较深度使用AI的人群,这部分人群大概有2000万,也就是说才占世界总人口的0.2%左右。对于这部分人群,我觉得大部分都集中在比较前沿的科技领域,包括……
特别是包括一些编程和数学领域,因为编程和数学领域能够自动验证。所以国内的程序员用得比较多。另外像医药行业做前沿算法的人,可能也在使用这些AI,而且比较重度地使用,消耗了很多token。
最后是整个漏斗最底部的部分,大概5000人,他们基本上能用上全球顶尖大模型内部的所谓内部版本。不过我觉得5000人可能有点少。因为不管是哪个大厂,包括国外的、国内的,他们内部在做研究、训练新一代模型的时候,内部肯定都会测试,所以我觉得应该远远不止这5000人。更不用说有些出于特殊目的的情况,比如之前Anthropic发布一个顶尖模型的时候,美国国防部内部实际上已经在使用了。
但不管怎么样,从这张图来看,大家可以真实地感受到:虽然有一些人每天都在用AI,媒体也都在宣传AI,营造出一种AI很火的氛围,但实际上真实的情况是,AI并没有大家想象中那么流行,还是有很多很多人没用上AI,或者觉得它没什么用。
因为没有深度使用,也没有那么大的场景和问题,所以AI想要成为之前大家说的“水跟电”,还有蛮长的一段路要走。
最近看到一个统计图,是关于全球用户如何使用AI的。这个图蛮有意思,呈漏斗状。
全球大概有80亿人口,其中约75%,也就是60亿人左右,基本没怎么用过大型模型,不管是ChatGPT还是国内的模型。
接下来大概20%的人能用到前沿模型,他们偶尔能用到比较前沿的大模型,会用ChatGPT,也会用Claude Code。国内的话,主要是用国内一些开源模型,他们更多是免费用户,甚至都不是付费用户。这跟另外一个报告是契合的:全球的付费用户当中,包括美国——美国算是起源地,那边的人应该用得比较多——但从付费比例来看,也是从去年的2.5%左右上升到4.5%。也就是说,绝大部分人使用AI、用ChatGPT这样的产品,都是不付费的。
再接下来是相对比较深度使用AI的人群,这部分人群大概有2000万,也就是说才占世界总人口的0.2%左右。对于这部分人群,我觉得大部分都集中在比较前沿的科技领域,包括……
特别是包括一些编程和数学领域,因为编程和数学领域能够自动验证。所以国内的程序员用得比较多。另外像医药行业做前沿算法的人,可能也在使用这些AI,而且比较重度地使用,消耗了很多token。
最后是整个漏斗最底部的部分,大概5000人,他们基本上能用上全球顶尖大模型内部的所谓内部版本。不过我觉得5000人可能有点少。因为不管是哪个大厂,包括国外的、国内的,他们内部在做研究、训练新一代模型的时候,内部肯定都会测试,所以我觉得应该远远不止这5000人。更不用说有些出于特殊目的的情况,比如之前Anthropic发布一个顶尖模型的时候,美国国防部内部实际上已经在使用了。
但不管怎么样,从这张图来看,大家可以真实地感受到:虽然有一些人每天都在用AI,媒体也都在宣传AI,营造出一种AI很火的氛围,但实际上真实的情况是,AI并没有大家想象中那么流行,还是有很多很多人没用上AI,或者觉得它没什么用。
因为没有深度使用,也没有那么大的场景和问题,所以AI想要成为之前大家说的“水跟电”,还有蛮长的一段路要走。
1 20
Claude Agent View 不一定比 Terminal 的多 tab 页好用。
Claude Code 最近出了一个新功能,Agent View。本意是当你启动了多个 agent 后,你不用频繁的切换多个 tab 页来看每个 agent 都分别干了什么,做完没有。
它就直接给你一个类似 agent 可视化大屏的功能,你可以一眼看到有几个 agent 以及它们的状态。出发点是好的,但是当你真正使用的时候,你会觉得,其实还不如使用 warp 的左侧标签页方便。
首先你需要通过点击各个 agent 进去操作的,操作完你还是需要通过 <- 箭头退出当前的 agent,然后再次看 agent view 这个面板,这个时候你会发现,由于 agent 的名字是 claude code 用了小一点的模型生成的总结(Haiku),这个不一定是你想要的,你还是需要反应一下,哪个 agent 是干嘛的。
而 Warp 的左侧标签页其实是可以自己命名的,同时也有一个动态的效果表明这个 tab 里的 agent 是不是还在工作。同时两者还有一个很大的不同就是,agent view 是动态的列表,如果你有工作的 agent,它会添加到 working (工作) 这个 list 中,如果 agent 干完活了,它会进入 completed (完成)这个 list 中。
所以这么操作一下来,你会发现你一直也是在各个 agent + 单个 agent 和 agent view 之间来切换,就跟之前的 terminal tab 也切换差不多。所以目前看,其实使用 warp 这个左边 tab 列表的方式反而是最好的。tab 页可以自定义名字,有显示动态的状态,同时 tab 页是固定的,更容易专注和找到。
但是 agent view 这个功能揭示了开发工作流的进一步发展,从单个 agent 到操作多个 agent 并行工作了。但不得不说,如果真需要并行操作 agent 进行开发,实际上还是很困难的。
Claude Code 最近出了一个新功能,Agent View。本意是当你启动了多个 agent 后,你不用频繁的切换多个 tab 页来看每个 agent 都分别干了什么,做完没有。
它就直接给你一个类似 agent 可视化大屏的功能,你可以一眼看到有几个 agent 以及它们的状态。出发点是好的,但是当你真正使用的时候,你会觉得,其实还不如使用 warp 的左侧标签页方便。
首先你需要通过点击各个 agent 进去操作的,操作完你还是需要通过 <- 箭头退出当前的 agent,然后再次看 agent view 这个面板,这个时候你会发现,由于 agent 的名字是 claude code 用了小一点的模型生成的总结(Haiku),这个不一定是你想要的,你还是需要反应一下,哪个 agent 是干嘛的。
而 Warp 的左侧标签页其实是可以自己命名的,同时也有一个动态的效果表明这个 tab 里的 agent 是不是还在工作。同时两者还有一个很大的不同就是,agent view 是动态的列表,如果你有工作的 agent,它会添加到 working (工作) 这个 list 中,如果 agent 干完活了,它会进入 completed (完成)这个 list 中。
所以这么操作一下来,你会发现你一直也是在各个 agent + 单个 agent 和 agent view 之间来切换,就跟之前的 terminal tab 也切换差不多。所以目前看,其实使用 warp 这个左边 tab 列表的方式反而是最好的。tab 页可以自定义名字,有显示动态的状态,同时 tab 页是固定的,更容易专注和找到。
但是 agent view 这个功能揭示了开发工作流的进一步发展,从单个 agent 到操作多个 agent 并行工作了。但不得不说,如果真需要并行操作 agent 进行开发,实际上还是很困难的。

0 00
这有点逆天了,codex 自己做了一个在 claude code 使用codex的插件。
突然发现在 claude code 里面已经可以直接调用 codex 了。之前其实一直也交叉在用这两个 coding agent,因为 claude code 确实强在代码编写,但是 codex(gpt 模型)主要强在代码 review 以及幻觉率和设计要更强一点。之前社区内的用法都是,同时在一个项目下面开启两个命令行窗口,一个是 cc,另一个是 codex,一边做完切换了到另一个命令行窗口,继续 codex 评审改动,查找 bug 以及修复。
不知道是奥特曼听到了社区的呼声还是自己能屈能伸,直接转头就做了一个claude code 的插件,方便用户直接在 cc 中调用 codex。这实在有点逆天。我今天就直接安装了这个插件,然后直接/codex:setup 检测一下是否可以用就可以开始了。
如果你仔细看看,codex 的 cc 插件,其实就支持了两个功能,一个是 code review,一个是 code review 后的 bug fix,它叫做 rescue。code review 本身分为两种, codex:review 就是一般功能完成后我们说的 code review,看看代码改动有什么错误,有什么没有考虑到的,有没有不符合最佳实践的等等,而另外一个 codex:adversarial-review, 那 review 的强度就上来了。
它都不是一般的 code review 了,它不仅 review 的方面更全、更深,甚至它还会挑战你改动代码的思路、方向可能全都错了。基本上就是从原理、本质上质疑你的改动。
不管是什么 review,做完后都需要修改,那就是一步到位的 codex:rescue, 妥妥的一个审阅 + 修复工作流,挺好用的。
突然发现在 claude code 里面已经可以直接调用 codex 了。之前其实一直也交叉在用这两个 coding agent,因为 claude code 确实强在代码编写,但是 codex(gpt 模型)主要强在代码 review 以及幻觉率和设计要更强一点。之前社区内的用法都是,同时在一个项目下面开启两个命令行窗口,一个是 cc,另一个是 codex,一边做完切换了到另一个命令行窗口,继续 codex 评审改动,查找 bug 以及修复。
不知道是奥特曼听到了社区的呼声还是自己能屈能伸,直接转头就做了一个claude code 的插件,方便用户直接在 cc 中调用 codex。这实在有点逆天。我今天就直接安装了这个插件,然后直接/codex:setup 检测一下是否可以用就可以开始了。
如果你仔细看看,codex 的 cc 插件,其实就支持了两个功能,一个是 code review,一个是 code review 后的 bug fix,它叫做 rescue。code review 本身分为两种, codex:review 就是一般功能完成后我们说的 code review,看看代码改动有什么错误,有什么没有考虑到的,有没有不符合最佳实践的等等,而另外一个 codex:adversarial-review, 那 review 的强度就上来了。
它都不是一般的 code review 了,它不仅 review 的方面更全、更深,甚至它还会挑战你改动代码的思路、方向可能全都错了。基本上就是从原理、本质上质疑你的改动。
不管是什么 review,做完后都需要修改,那就是一步到位的 codex:rescue, 妥妥的一个审阅 + 修复工作流,挺好用的。


0 00
后面的模型可能会越来越偏科,也可能会越来越有品味
月之暗面的创始人杨植麟最近有一个技术演讲,确实挺技术的,后半段的模型优化我基本没有理解。但是听完我第一个感受就是,模型后面要开始分化。
模型开始有着自己的偏好,有着自己的品味了。其实现在不同的模型已经开始有了,比如我们知道 Gemini 模型在 UI 前端工作就做的特别好。
但是听完了整个演讲,对于做应用开发的我还是有着不少的收获,毕竟是最前沿的思路。第一张图是,为什么 transformer 架构比 LSTM 要好?有两个维度的比较,一个是随着模型的参数越来越多(模型越来越大),为了让模型的性能更好,那么就必须要让 Loss 越小,从第一张图的第一个图表来看,LSTM 后续的 loss 一直下不去,曲线甚至要走平,不像 transformer 的曲线是平稳的下降,这就意味着 LSTM 需要更多的算力才行,不划算。
而第一张图的第二个图表表示的是,长上下文的支持。当上下文到了100个 token 的时候,LSTM 明显 loss 就下不去了。换个说法,如果超过100个 token 的长上下文,那么模型的性能就开始变差,导致幻觉了。
所以杨植麟觉得未来模型的发展方向是,往 token efficiency 和 long context 两个方向发展,token efficiency 越高,算力越省。长上下文越长,如果能保持每个 token 的 loss 也越低,那么意味了就能支持更长的上下文,能做更多的工作。(第二张图)
而第三张图有一句话很深刻,就是 agentic 推理本质上就是一个搜索。本来模型就是压缩的知识(之前用过模糊的图片来比喻),同时模型学习了内在的文本规律,所以可以让它以鲁迅的口吻来讲解化学概念。这个过程实际上就是搜索到鲁迅的文风,搜到化学概念,然后结合去生成。所以本质就是一种搜索,当然也可以在整个模型里面搜索,但是效率就低了,所以为了 token efficiency,那么搜索的方向就很重要。
对于长上下文,这个越来越重要的,现在记忆也成为了长上下文的一部分了,模型拥有的记忆越多,它就越能遵循你的指令做事,越懂你,不会刚做完某件事,转眼就忘记了,你又要重新跟它叨一遍。
而最后一张图,则关于品味,每个模型都不一样,就像是 Gemini 做的前端好看,minimax 做的差强人意,这也是一种品味,一种选择。如果你了解模型的原理,很难说这到底是不是一个刻意训练后的结果。
月之暗面的创始人杨植麟最近有一个技术演讲,确实挺技术的,后半段的模型优化我基本没有理解。但是听完我第一个感受就是,模型后面要开始分化。
模型开始有着自己的偏好,有着自己的品味了。其实现在不同的模型已经开始有了,比如我们知道 Gemini 模型在 UI 前端工作就做的特别好。
但是听完了整个演讲,对于做应用开发的我还是有着不少的收获,毕竟是最前沿的思路。第一张图是,为什么 transformer 架构比 LSTM 要好?有两个维度的比较,一个是随着模型的参数越来越多(模型越来越大),为了让模型的性能更好,那么就必须要让 Loss 越小,从第一张图的第一个图表来看,LSTM 后续的 loss 一直下不去,曲线甚至要走平,不像 transformer 的曲线是平稳的下降,这就意味着 LSTM 需要更多的算力才行,不划算。
而第一张图的第二个图表表示的是,长上下文的支持。当上下文到了100个 token 的时候,LSTM 明显 loss 就下不去了。换个说法,如果超过100个 token 的长上下文,那么模型的性能就开始变差,导致幻觉了。
所以杨植麟觉得未来模型的发展方向是,往 token efficiency 和 long context 两个方向发展,token efficiency 越高,算力越省。长上下文越长,如果能保持每个 token 的 loss 也越低,那么意味了就能支持更长的上下文,能做更多的工作。(第二张图)
而第三张图有一句话很深刻,就是 agentic 推理本质上就是一个搜索。本来模型就是压缩的知识(之前用过模糊的图片来比喻),同时模型学习了内在的文本规律,所以可以让它以鲁迅的口吻来讲解化学概念。这个过程实际上就是搜索到鲁迅的文风,搜到化学概念,然后结合去生成。所以本质就是一种搜索,当然也可以在整个模型里面搜索,但是效率就低了,所以为了 token efficiency,那么搜索的方向就很重要。
对于长上下文,这个越来越重要的,现在记忆也成为了长上下文的一部分了,模型拥有的记忆越多,它就越能遵循你的指令做事,越懂你,不会刚做完某件事,转眼就忘记了,你又要重新跟它叨一遍。
而最后一张图,则关于品味,每个模型都不一样,就像是 Gemini 做的前端好看,minimax 做的差强人意,这也是一种品味,一种选择。如果你了解模型的原理,很难说这到底是不是一个刻意训练后的结果。


1 11