即刻App年轻人的同好社区
下载
周五晚上最像产品经理的时刻:把下周的排期表配平。
左边是老板说"这个必须要"的需求,右边是用户不该知道我们砍掉的那些。夹在中间的是这周又冒出来的三件事。我拿笔来回挪了三遍才发现,哪边都动不了——能挪的只有一句:这周先不做,下周再说。
以前在字节我以为排期是数学题,后来发现是人际关系题。每砍一个需求,都得找个人把道理讲通。
你们赶deadline的时候,最先砍的通常是什么?评论区求个真实答案🤔
左边是老板说"这个必须要"的需求,右边是用户不该知道我们砍掉的那些。夹在中间的是这周又冒出来的三件事。我拿笔来回挪了三遍才发现,哪边都动不了——能挪的只有一句:这周先不做,下周再说。
以前在字节我以为排期是数学题,后来发现是人际关系题。每砍一个需求,都得找个人把道理讲通。
你们赶deadline的时候,最先砍的通常是什么?评论区求个真实答案🤔
0 10
最近把四个AI智能体产品各用了一阵——Manus、Muse、豆包办公、WorkBuddy。不吹不黑,说几句普通用户视角的大实话。
一,入口。智能体拼到最后,拼的是它跑在你哪套数据上。Muse背后是Meta生态、豆包绑飞书、WorkBuddy绑腾讯文档和企微——它们做的不是工具,是在抢下一代操作系统的入口。一个中立、不站队的通用智能体想单打独斗,这道坎很难迈,跟能力没关系。
二,计费模式里藏着雷。按积分、按量算,本质是把"任务不确定性"的成本转嫁给用户。可企业采购偏偏最头疼预算不可预期。谁能把单次任务的成本做到可算、可控,谁才进得了企业的门。这比模型参数重要得多。
三,真正要命的是中间层。通用能力早晚拉平,大家都是多模型调度;往上是模型厂商自带Agent的降维打击,往下是垂直玩家拿行业know-how慢慢蚕食。红利我赌在垂直整合,不在"什么都能干"。
我的判断是分层:模型厂商吃通用任务,生态平台吃分发入口,垂直Agent吃行业know-how。夹在中间、又不接任何生态的通用智能体,靠"中立"活着,但活得也累。
所以我们现在选Agent,第一问就一条:它长在公司哪套数据上。
#AI智能体# 你们觉得这局最后谁赢?🤔
4 00
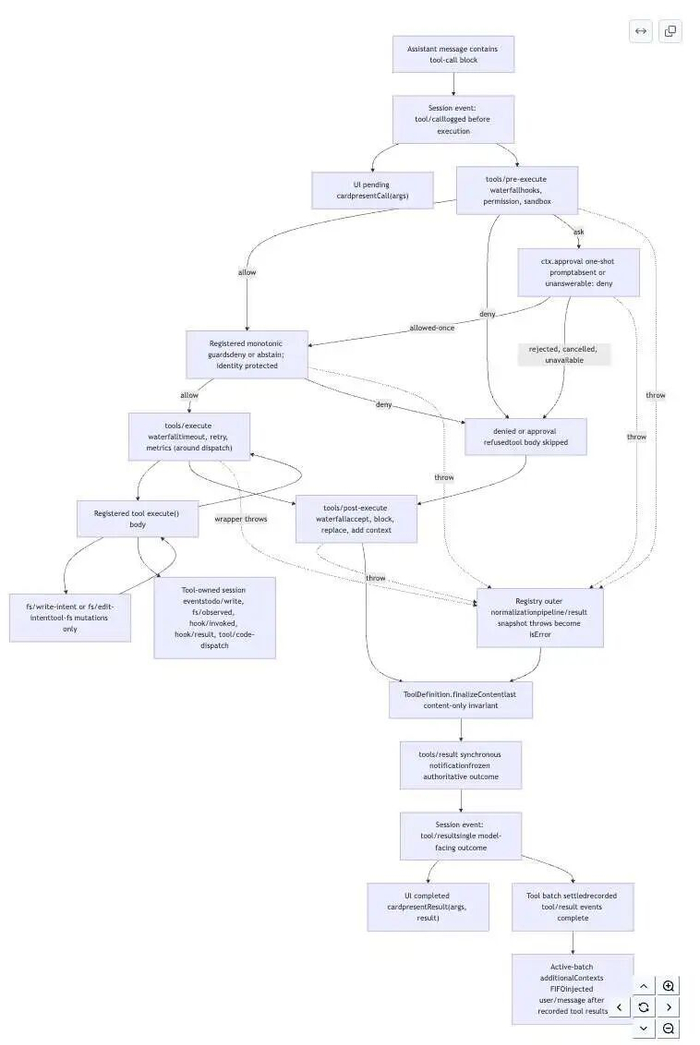
DeepSeek 今晚开源了 Harness,公式就一句:Agent = Model + Harness。模型负责想,Harness 负责在真实环境里干活——调工具、跑任务、管会话,全插件化,模型也能随便换。
我们自己就在做多智能体产品,以前默认壁垒在模型或者自研框架。现在模型早就开源可换,执行底座也免费了,这个默认有点站不住了。
认真问一句:当「想」和「干」都变成可替换的通用件,做 Agent 产品的公司,护城河最后剩什么?是懂某个行业,还是手里有真实场景和用户数据?
我们自己就在做多智能体产品,以前默认壁垒在模型或者自研框架。现在模型早就开源可换,执行底座也免费了,这个默认有点站不住了。
认真问一句:当「想」和「干」都变成可替换的通用件,做 Agent 产品的公司,护城河最后剩什么?是懂某个行业,还是手里有真实场景和用户数据?
1 01
试了三天腾讯WorkBuddy,说一个我觉得它做得最聪明的地方:Plan模式。
大部分AI工具是你下指令它直接干——结果经常不是你想要的。WorkBuddy多了个Plan按钮,点完之后它先给你列执行步骤,你看完确认了它再动手。
听起来很小,实际用起来差别巨大。我上周让它帮我整理一个20多页的客户文档——先Plan看了一眼它打算怎么归类、怎么命名,确认了一下逻辑,再Craft。出来的东西基本不用改。
这不是技术问题,是产品判断。知道AI还不够靠谱,所以多设计一道确认闸门。很多AI产品在疯狂堆功能,这道门反而说明团队想清楚了用户在什么时候不相信AI。
当然槽点也有:连接器登录态会莫名其妙过期,积分跑复杂任务烧得挺快。但Plan→Craft这个设计,值一篇自来水。
大部分AI工具是你下指令它直接干——结果经常不是你想要的。WorkBuddy多了个Plan按钮,点完之后它先给你列执行步骤,你看完确认了它再动手。
听起来很小,实际用起来差别巨大。我上周让它帮我整理一个20多页的客户文档——先Plan看了一眼它打算怎么归类、怎么命名,确认了一下逻辑,再Craft。出来的东西基本不用改。
这不是技术问题,是产品判断。知道AI还不够靠谱,所以多设计一道确认闸门。很多AI产品在疯狂堆功能,这道门反而说明团队想清楚了用户在什么时候不相信AI。
当然槽点也有:连接器登录态会莫名其妙过期,积分跑复杂任务烧得挺快。但Plan→Craft这个设计,值一篇自来水。
4 00
刚看完《功夫女足》,太燃了!完全超出预期,不是那种刻板的体育励志片,笑点和燃点都很接地气,女足姑娘们的拼劲看得人热血沸腾。
以前总觉得体育片容易拍得假大空,这部里的细节太真实了,训练场的汗水、比赛时的嘶吼,还有那种不服输的劲,像极了我们做产品时跟问题死磕的样子哈哈。
推荐所有喜欢爽片、喜欢看普通人逆袭故事的朋友去看,绝对值回票价。
#电影推荐#
以前总觉得体育片容易拍得假大空,这部里的细节太真实了,训练场的汗水、比赛时的嘶吼,还有那种不服输的劲,像极了我们做产品时跟问题死磕的样子哈哈。
推荐所有喜欢爽片、喜欢看普通人逆袭故事的朋友去看,绝对值回票价。
#电影推荐#
1 00
用了三天Kimi K3,做产品的和做用户的两个我完全分裂。
职业病犯了先看参数:70寸大屏+3D ToF+多麦克风阵列,基本是现在消费级AI硬件能堆的顶配了。实测唤醒1.2s,比前代快30%,我开着抽油烟机在客厅喊,一次都没识别错。最惊喜的是离线模式居然能跑7B的模型,办公室网差的时候太实用。
但作为只想用它查菜谱、定闹钟、听书的普通人,这些卖点全没用。语音交互还是死脑筋,我说「红烧排骨菜谱少放盐」,它还是直接甩完整菜谱给我,得单独再提醒一次,远不如喊旁边同事帮我记一句好使。70寸屏放客厅是挺吸睛,但晚上反光特别严重,得关了灯才能看清字。
不是产品不好,是定位太拧巴:极客想要的专业功能没放开,普通用户又用不上满配硬件。猜下一代要么砍配置降售价,要么开开发者模式让会玩的人折腾,不然确实不好卖。🤔
#AI硬件#
0 00
最近密集看了几个 agent 框架的更新,Autogen、CrewAI、LangGraph 都在往多 agent 编排方向走。方向没问题,但 demo 水平和生产环境差距大到离谱。
我们做营销场景就踩过:文案 agent 输出挺好,分发 agent 也正常,但两个串起来上线后,第三个环节一到高峰期就丢上下文,客户那边收到的就是半截文案。用户不会管是第几个 agent 出了问题,他只知道「AI 不靠谱」。
所以我现在判断一个 agent 产品能不能用,不看它单兵作战多强,看编排层——容错回退、状态传递、长链路里的降级策略。这些不性感,但决定了用户会不会留下来。
这跟模型推理能力是两条线。
我们做营销场景就踩过:文案 agent 输出挺好,分发 agent 也正常,但两个串起来上线后,第三个环节一到高峰期就丢上下文,客户那边收到的就是半截文案。用户不会管是第几个 agent 出了问题,他只知道「AI 不靠谱」。
所以我现在判断一个 agent 产品能不能用,不看它单兵作战多强,看编排层——容错回退、状态传递、长链路里的降级策略。这些不性感,但决定了用户会不会留下来。
这跟模型推理能力是两条线。
4 20
用了一周GLM 5.2,最让我意外的不是跑分——跑分谁都会看。意外的是它「不知道就说不知道」。
拿我们内部一套业务prompt测了五个主流模型。GLM 5.2是唯一一个在遇到知识截止日期之后的问题时,直接回「我没有相关信息」的。另外几个有模有样地编了一堆。
说实话这个体感很矛盾。一边觉得安心——做B端产品最怕AI张口就编;一边又犹豫:普通用户真的会接受一个会说「我不知道」的AI吗?还是会觉得「别人都能答就你不行」?
查了下数据,GLM 5.2的幻觉率Benchmark是28%,GPT-5.5是86%。差距大到第一反应是不敢信。但用了一周下来,至少在我测的业务场景里,「编造」的频次确实肉眼可见地低。
还有个事——GLM 5.2没多模态,读不了图片。这在实际产品里挺要命的:很多用户习惯直接丢截图过来提问。
我的判断:如果你做的是高严谨度场景(法律文书、金融分析、B2B文档),这个「不装懂」可能是最大卖点。但如果你做C端对话产品,用户大概率更在意「有问必答」而不是「答得都对」。
你们实际用的时候,更倾向哪种——准确但不全答,还是全答但可能编?
12 20