即刻App年轻人的同好社区
下载
离开拉斯维加斯,再也不会有这么温柔的钢琴曲了!

Ben and Sera - Theme - Mike Figgis - 单曲 - 网易云音乐
0 00
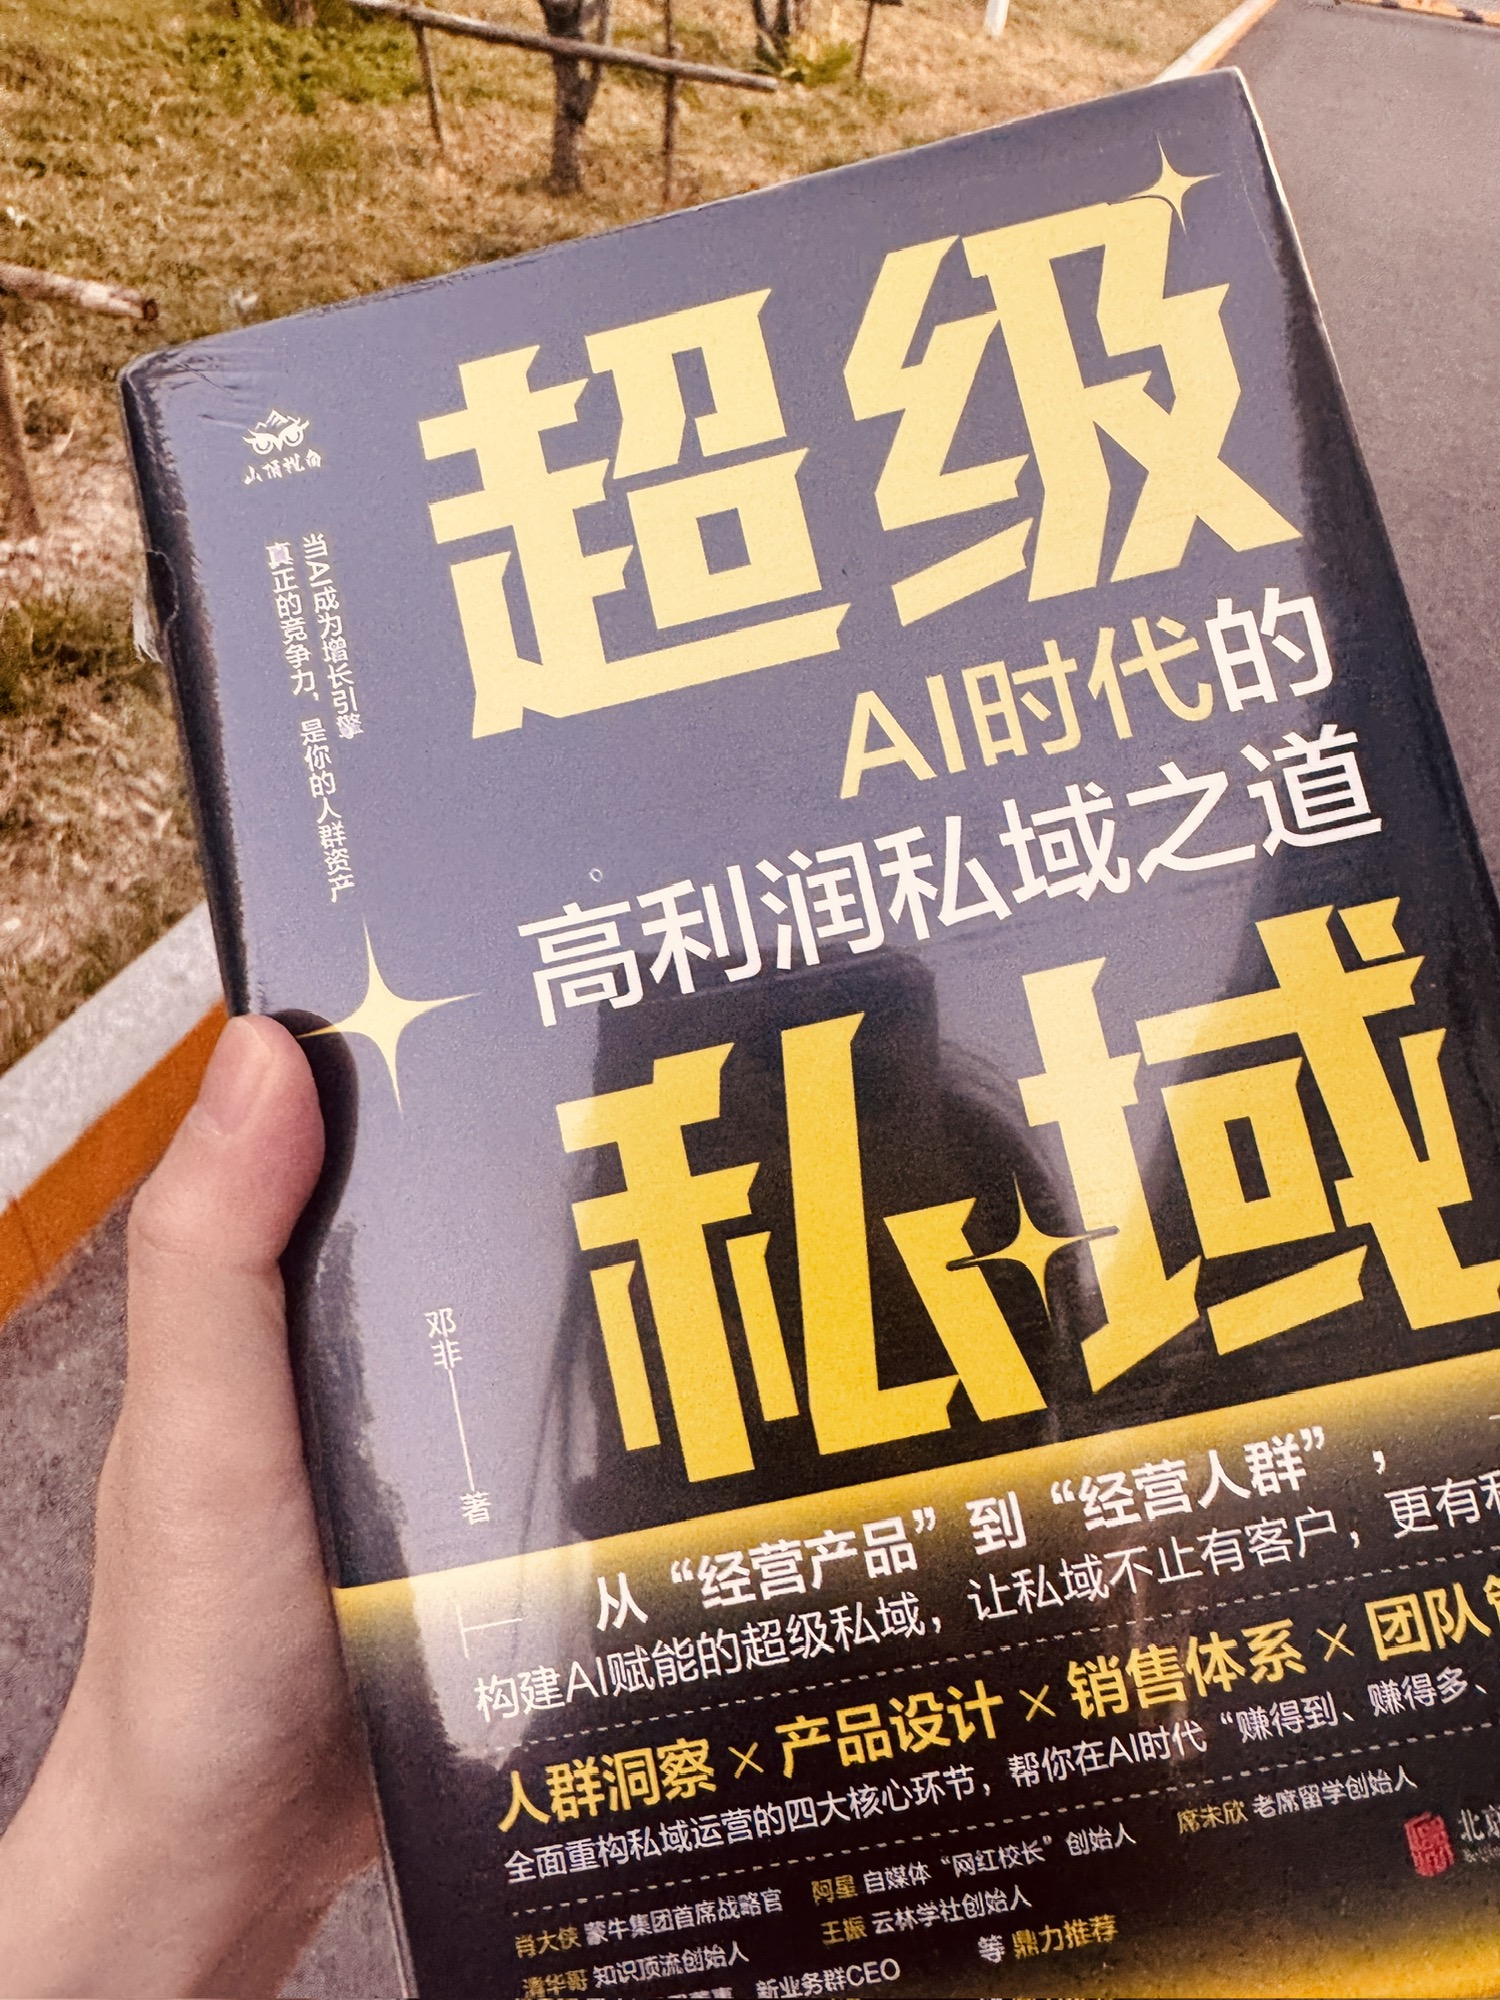
买了一本书,最近搞知识库搞的上头,顺便查了一下,怎么高效蒸馏纸质书到知识库,分享给大家~
-------------------------------
要把纸质书高质量蒸馏到Obsidian知识库,兼顾内容准确性、信息密度和个人化属性,非常适配你刚开始做
Obsidian纸质书整理的需求,你可以按照以下5步落地:
### 第一步:纸质书高精度数字化,从源头避免信息损耗
这一步是高质量的基础,不要用普通拍照的方式,最大程度保留原文和你的批注信息:
1. 用手机自带的文档扫描功能逐页拍摄,自动切边、去除页面阴影,比普通拍照识别准确率高30%以上,有特殊划线、手写批注的页面可以单独标记出来,后续优先提取。
2. 不需要手动把所有图片转成PDF再做OCR,你可以直接把所有扫描后的图片批量投喂给支持图片识别的AI工具(比如iMA、NotebookLM),工具会自动读取图片上的全部文字,跳过手动转文本的繁琐步骤。
3. 如果你只需要提炼书中重点章节,也可以用微信自带的图片提取文字功能,直接提取你划线标记过的核心页面内容,不用整本书全部扫描,节省时间。
### 第二步:AI深度结构化蒸馏,过滤冗余信息
不要让AI笼统总结全书内容,用精准提示词定向提炼高价值信息,避免产出大段无用的流水账:
1. 把全部数字化内容投喂给AI后,不要问「这本书讲了什么」,而是定向输出指令:「请列举书中所有可落地的操作步骤整理成清单,列出书中所有真实案例,梳理全书按痛点场景拆分的目录大纲」,先拉出来整本书的结构化框架。
2. 针对每个章节的内容,额外加提示词要求:「不要使用专业术语,全部用大白话输出,搭配生活化案例辅助讲解」,提前把AI生成内容的晦涩感降到最低。
3. 如果想要内容更丰富不同质化,你可以找3-5本同领域的经典纸质书,全部扫描投喂给AI,让它取长补短整合成一套更系统的内容,还能避免单本书内容的版权风险。
### 第三步:人工校验注入个人属性,打造专属内容
这一步是你蒸馏的内容区别于普通AI生成内容的核心,也是高质量的关键:
1. 对照纸质书原文,核对AI提炼的核心数据、关键定义,修正AI幻觉产生的错误内容,确保所有输出信息100%准确。
2. 用费曼学习法把AI生成的内容用你自己的话重新改写,加入你读这本书时的个人感悟、实际应用的实操经验,这些独有的内容是你知识库最有价值的部分。
### 第四步:自动化批量导入Obsidian,避免手动重复劳动
利用自动化工具把整理好的内容一键入库,不用逐篇手动复制粘贴:
1. 你可以用「Obsidian知识库整理助手」Skill,指定你存放整理好的纸质书内容的源文件夹,再选择目标Obsidian库,AI会自动提取内容,生成带来源信息、创建时间的Frontmatter,自动给笔记打上对应分类标签。
2. 更简单的方法是让Codex和Obsidian指向同一个本地文件夹,你把所有整理好的Markdown笔记直接扔进这个共享文件夹,Obsidian会自动识别入库,不需要额外配置复杂的插件。
3. 导入时自动开启去重机制,按书籍ID、原文链接校验,避免重复生成相同笔记,保持知识库内容干净无冗余。
### 第五步:搭建专属知识网络,把内容变成长期资产
入库之后不要让笔记孤零零躺在文件夹里,把它和你已有的知识库打通:
1. 参考三层分离架构整理:第一层是「human层」,存放你自己写的核心感悟、实操经验,只有你可以编辑,AI只能提供灵感;第二层是「review层」,存放你已经校验确认过的AI生成内容;第三层是「auto层」,存放自动生成的标签、索引、交叉引用,方便后续AI快速调用。
2. 用Obsidian的双向链接功能,把这本书里的知识点和你之前知识库中相关的笔记关联起来,比如你之前存过育儿实操笔记,就把这本育儿书里的辅食知识点和对应实操笔记做链接,形成完整的知识网络,还可以生成全书的内容索引页,后续查找相关内容一键直达。
3 00
感受到一种人和人之间非常深刻又稀缺的连接,是她过得好你也会觉得很欣慰的little love~
又是被 girls help girls无限治愈的一天~
在非常微小的充满杂乱的空间里也要寻找到那些有缝隙阳光能钻进来的地方呀~
又是被 girls help girls无限治愈的一天~
在非常微小的充满杂乱的空间里也要寻找到那些有缝隙阳光能钻进来的地方呀~
0 00