即刻App年轻人的同好社区
下载
今天用 LibTV 花了 70 块做了个 1 分钟的 AI 短剧,发现一个挺有意思的变化。
之前体验 OiiOii、Medeo 时,Video Agent 基本都是固定的 Pipeline:剧本 → 分镜 → 首尾帧 → 视频生成 → TTS 配音 → 剪辑。
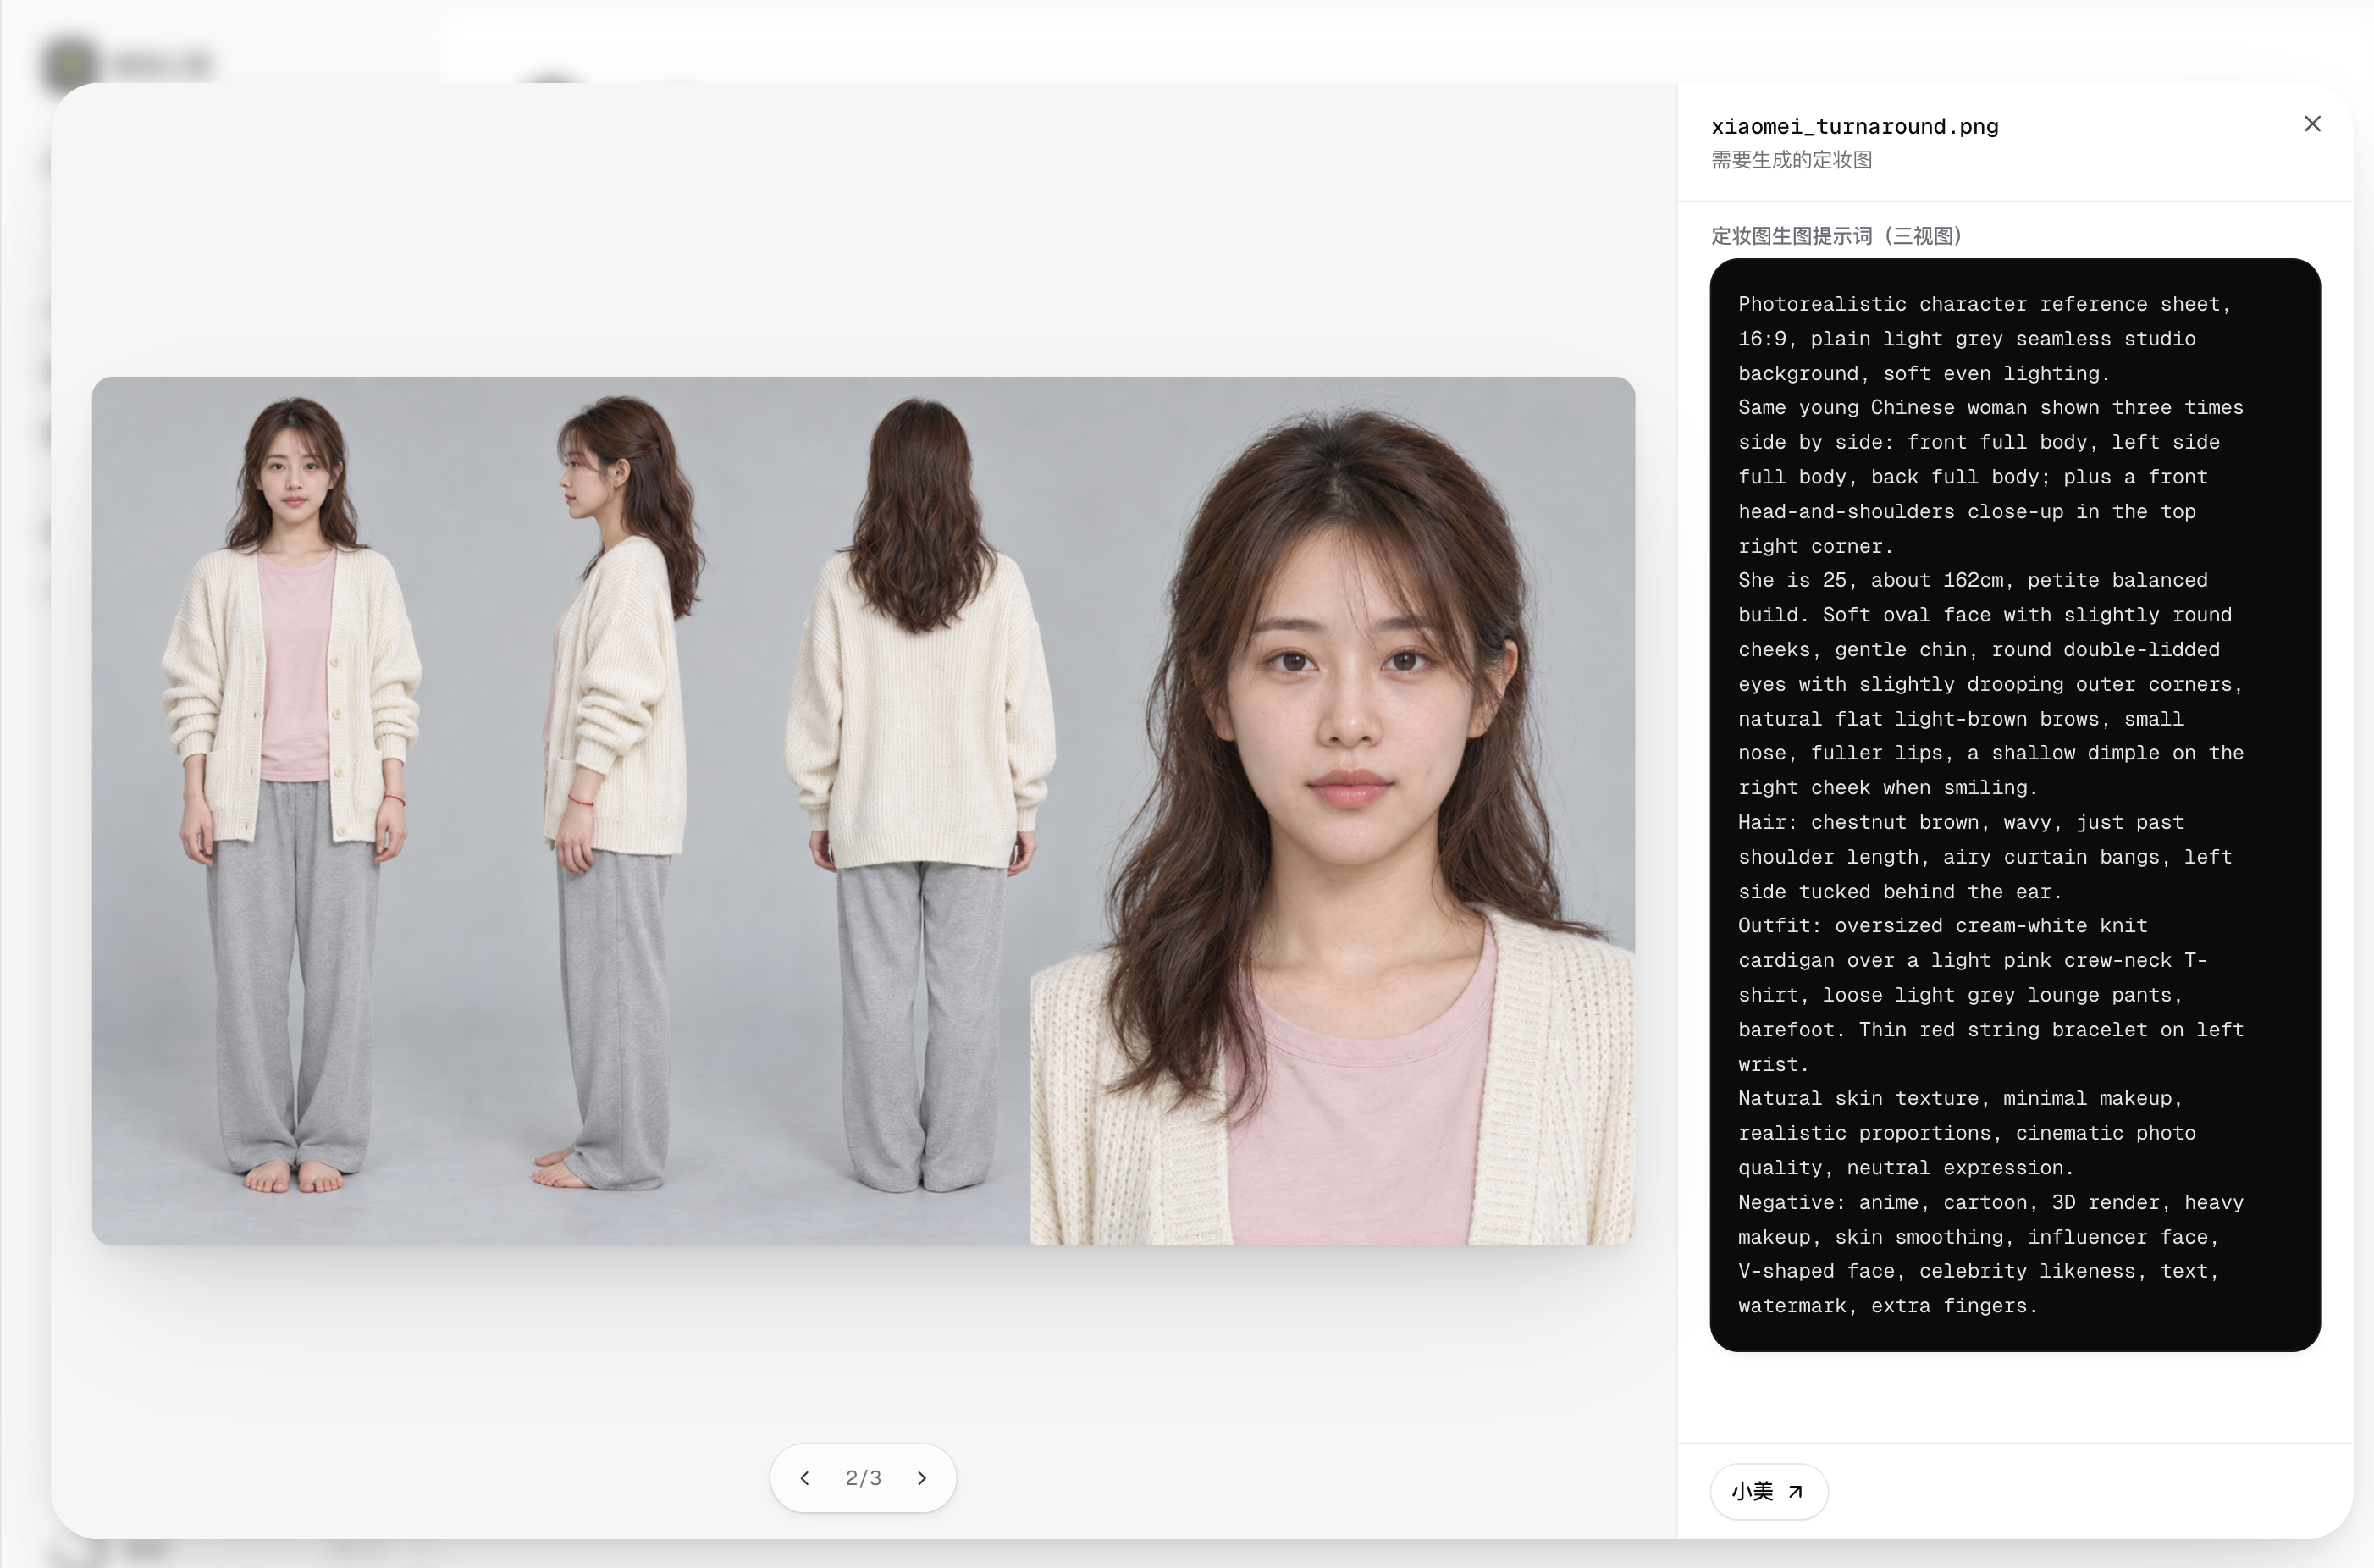
LibTV 的思路不太一样,先生成 2 秒的角色声音,后续每个镜头通过 Omni 全能参考复用音色,直接生成声画一体的视频,连首尾帧都省了。
好处是流程简单了很多,角色声音更容易保持一致;坏处是台词准确率、镜头衔接的可控性会弱一些。
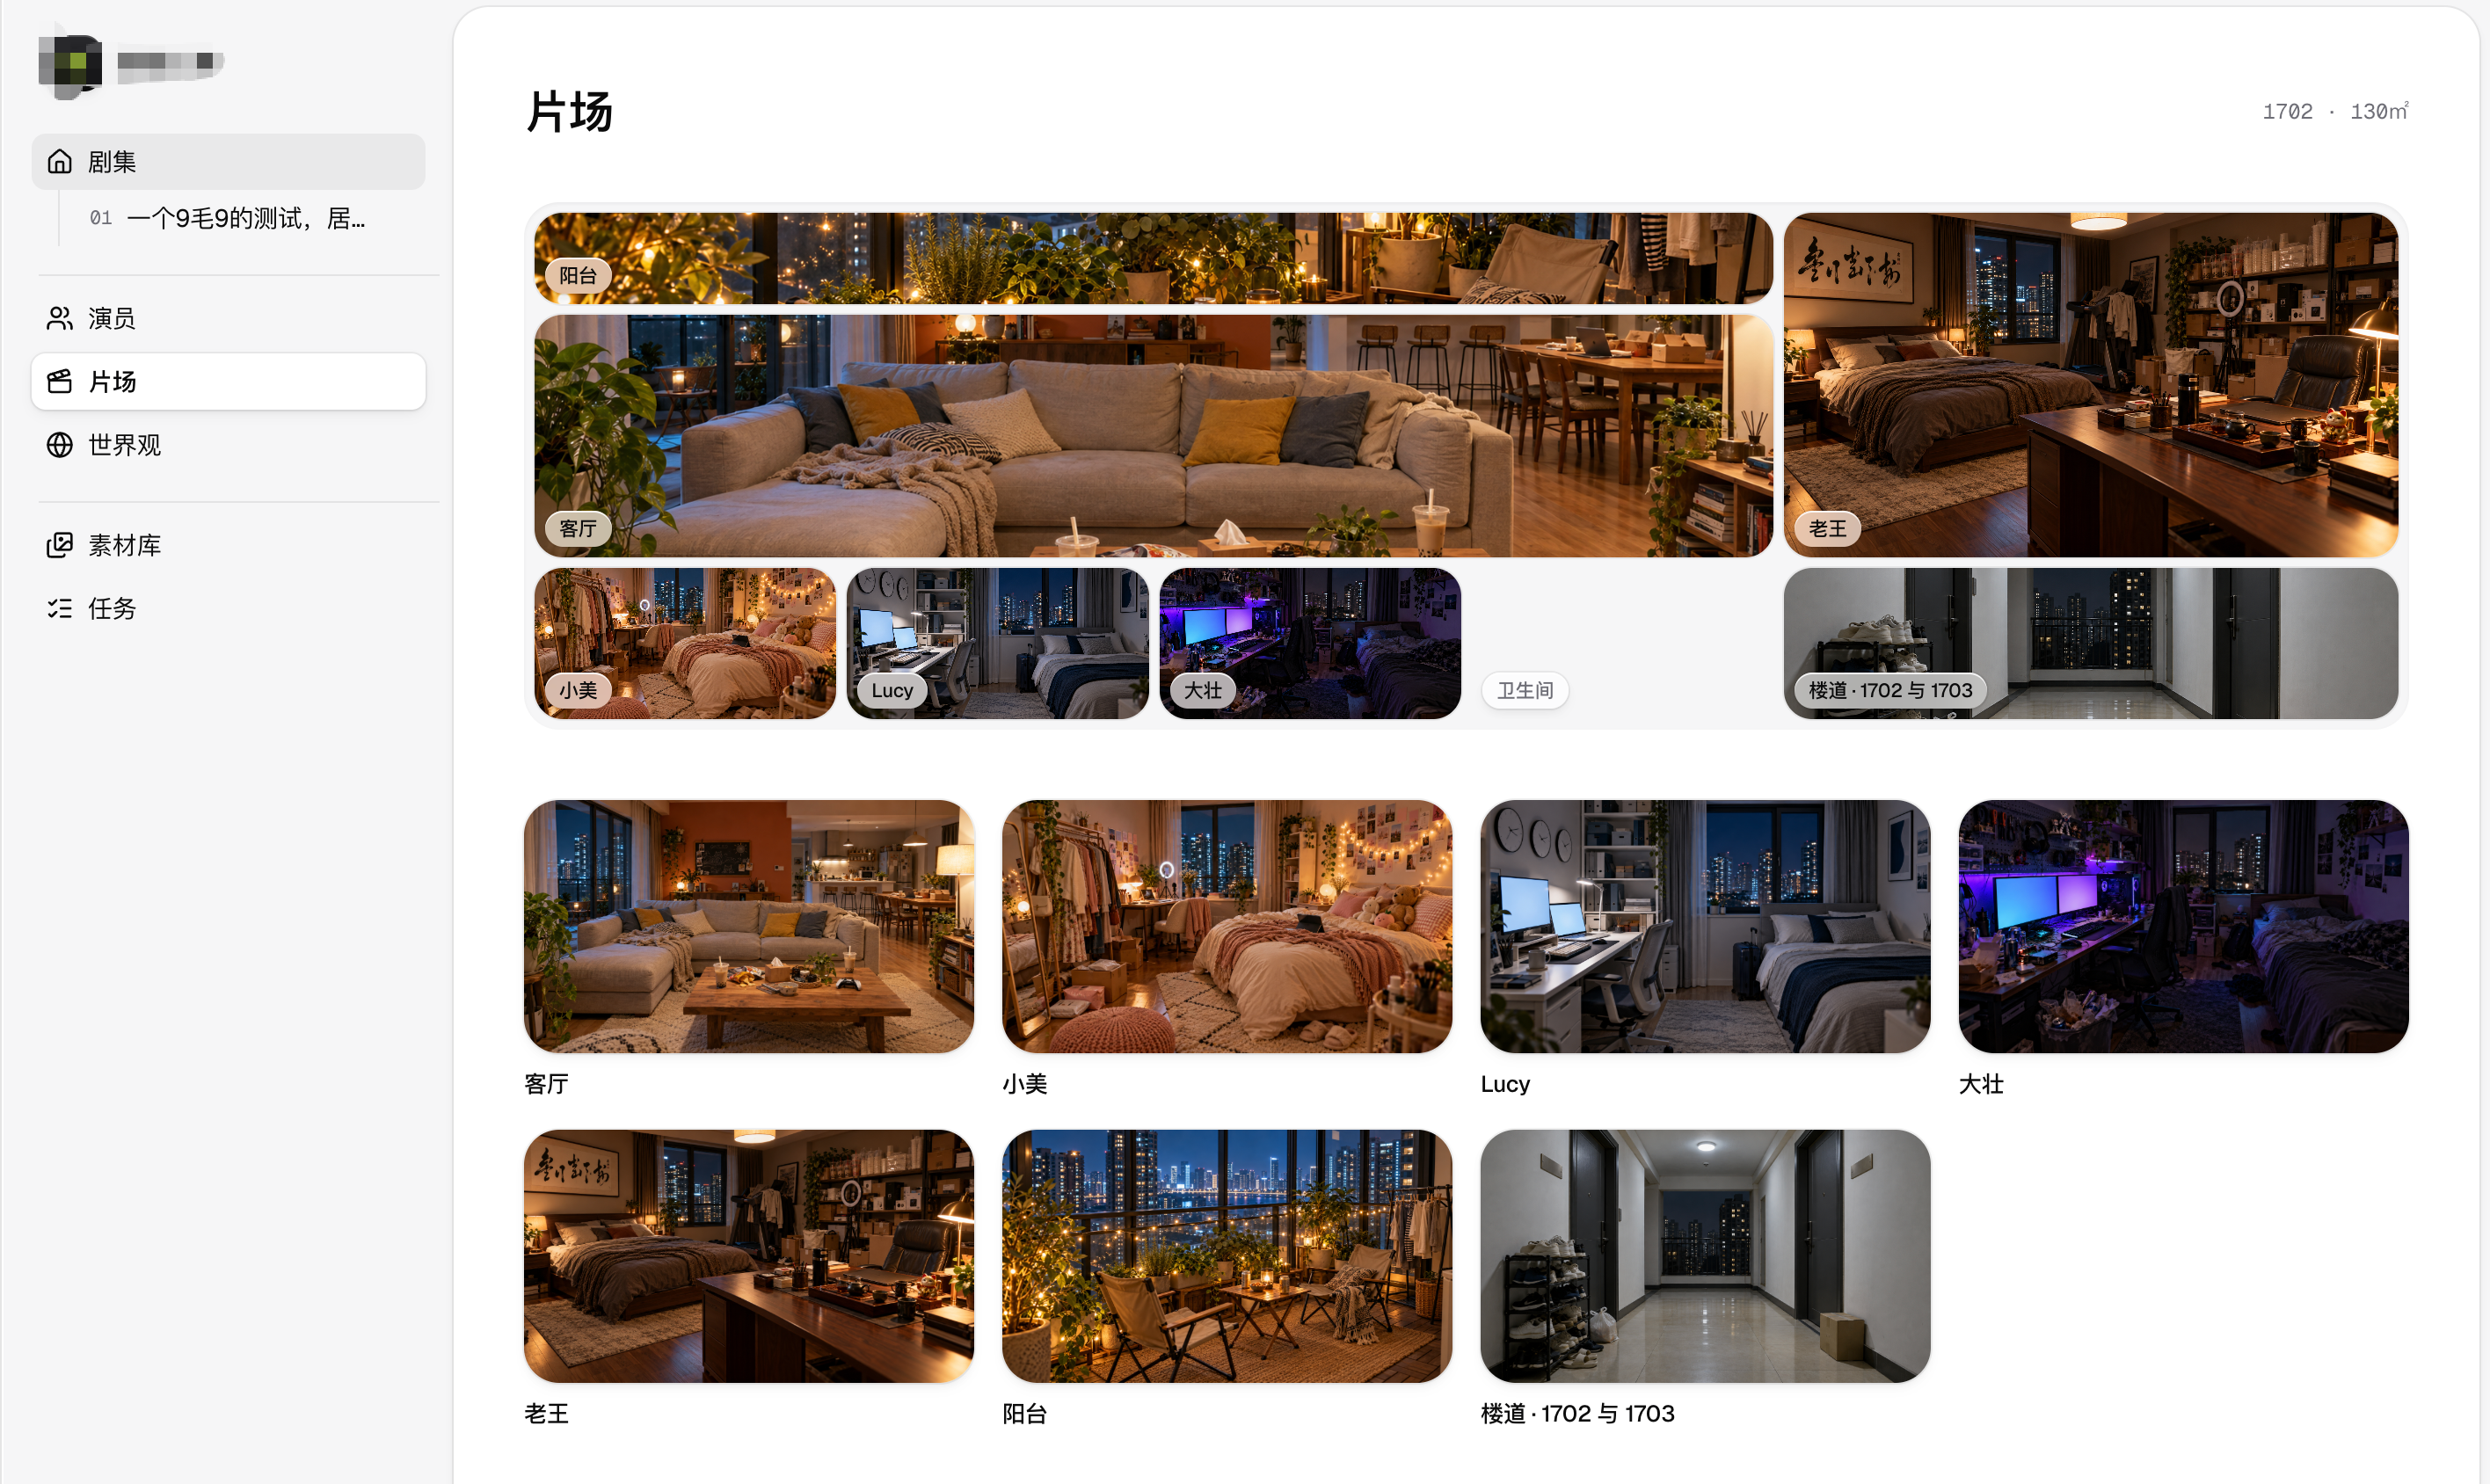
感觉 Video Agent 正在从编排固定工作流,转向管理角色、声音、场景等参考资产,让模型自己完成生成。
也可能是太久没做 AI 视频,我的认知落后了 😂
之前体验 OiiOii、Medeo 时,Video Agent 基本都是固定的 Pipeline:剧本 → 分镜 → 首尾帧 → 视频生成 → TTS 配音 → 剪辑。
LibTV 的思路不太一样,先生成 2 秒的角色声音,后续每个镜头通过 Omni 全能参考复用音色,直接生成声画一体的视频,连首尾帧都省了。
好处是流程简单了很多,角色声音更容易保持一致;坏处是台词准确率、镜头衔接的可控性会弱一些。
感觉 Video Agent 正在从编排固定工作流,转向管理角色、声音、场景等参考资产,让模型自己完成生成。
也可能是太久没做 AI 视频,我的认知落后了 😂
0 00
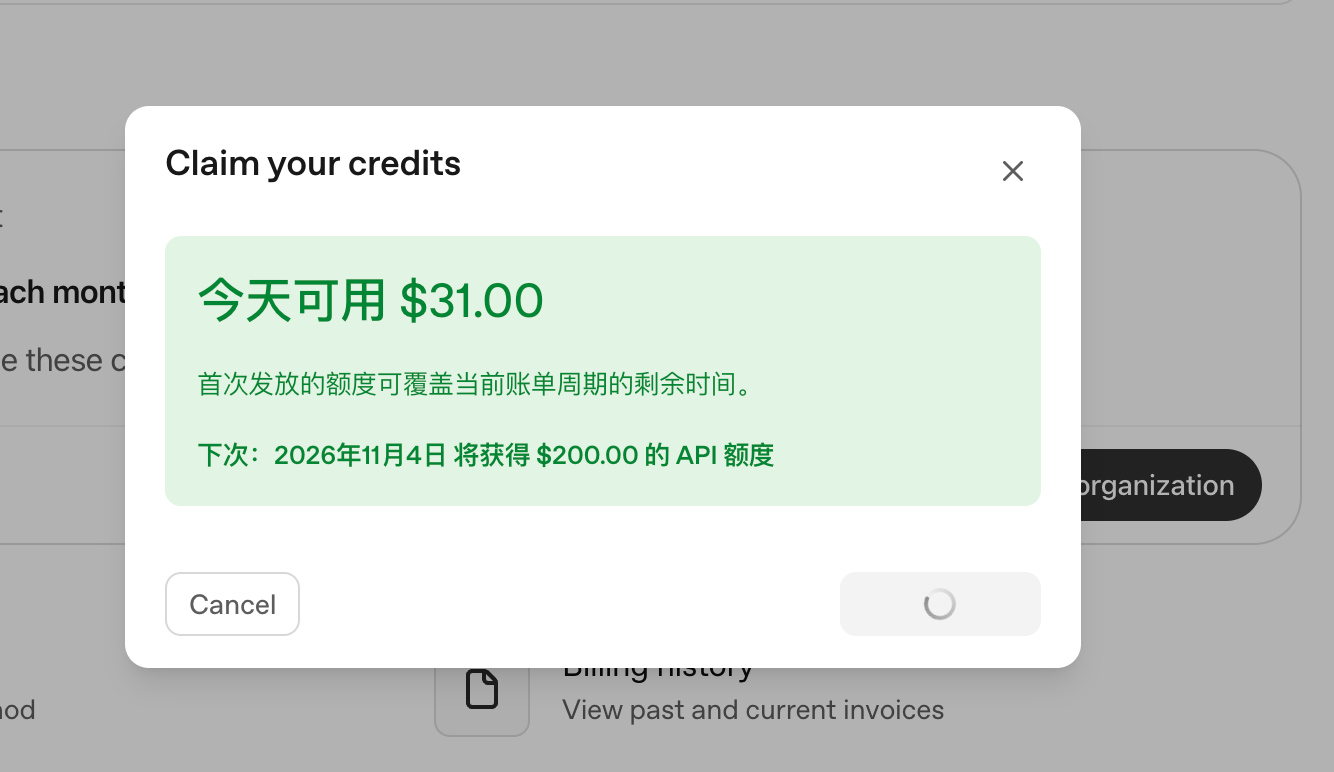
领到了OpenAI的鸡蛋。后续每个月200USD的API额度。
我只能说奇招,之前产品上线还得用其他中转的API做产品。
领取方式:
ChatGPT API credit 两种领取方式:
1. 把官方文章链接发给 Codex,说:“看这篇文章,用我的浏览器帮我领取 API credit。”
2. 自己打开 ChatGPT 网页 → 设置 → API 订阅权益 → 关联。
符合条件的 Pro / Business 用户可领,Plus 不适用。
help.openai.com
我只能说奇招,之前产品上线还得用其他中转的API做产品。
领取方式:
ChatGPT API credit 两种领取方式:
1. 把官方文章链接发给 Codex,说:“看这篇文章,用我的浏览器帮我领取 API credit。”
2. 自己打开 ChatGPT 网页 → 设置 → API 订阅权益 → 关联。
符合条件的 Pro / Business 用户可领,Plus 不适用。
help.openai.com
2 00