即刻App年轻人的同好社区
下载
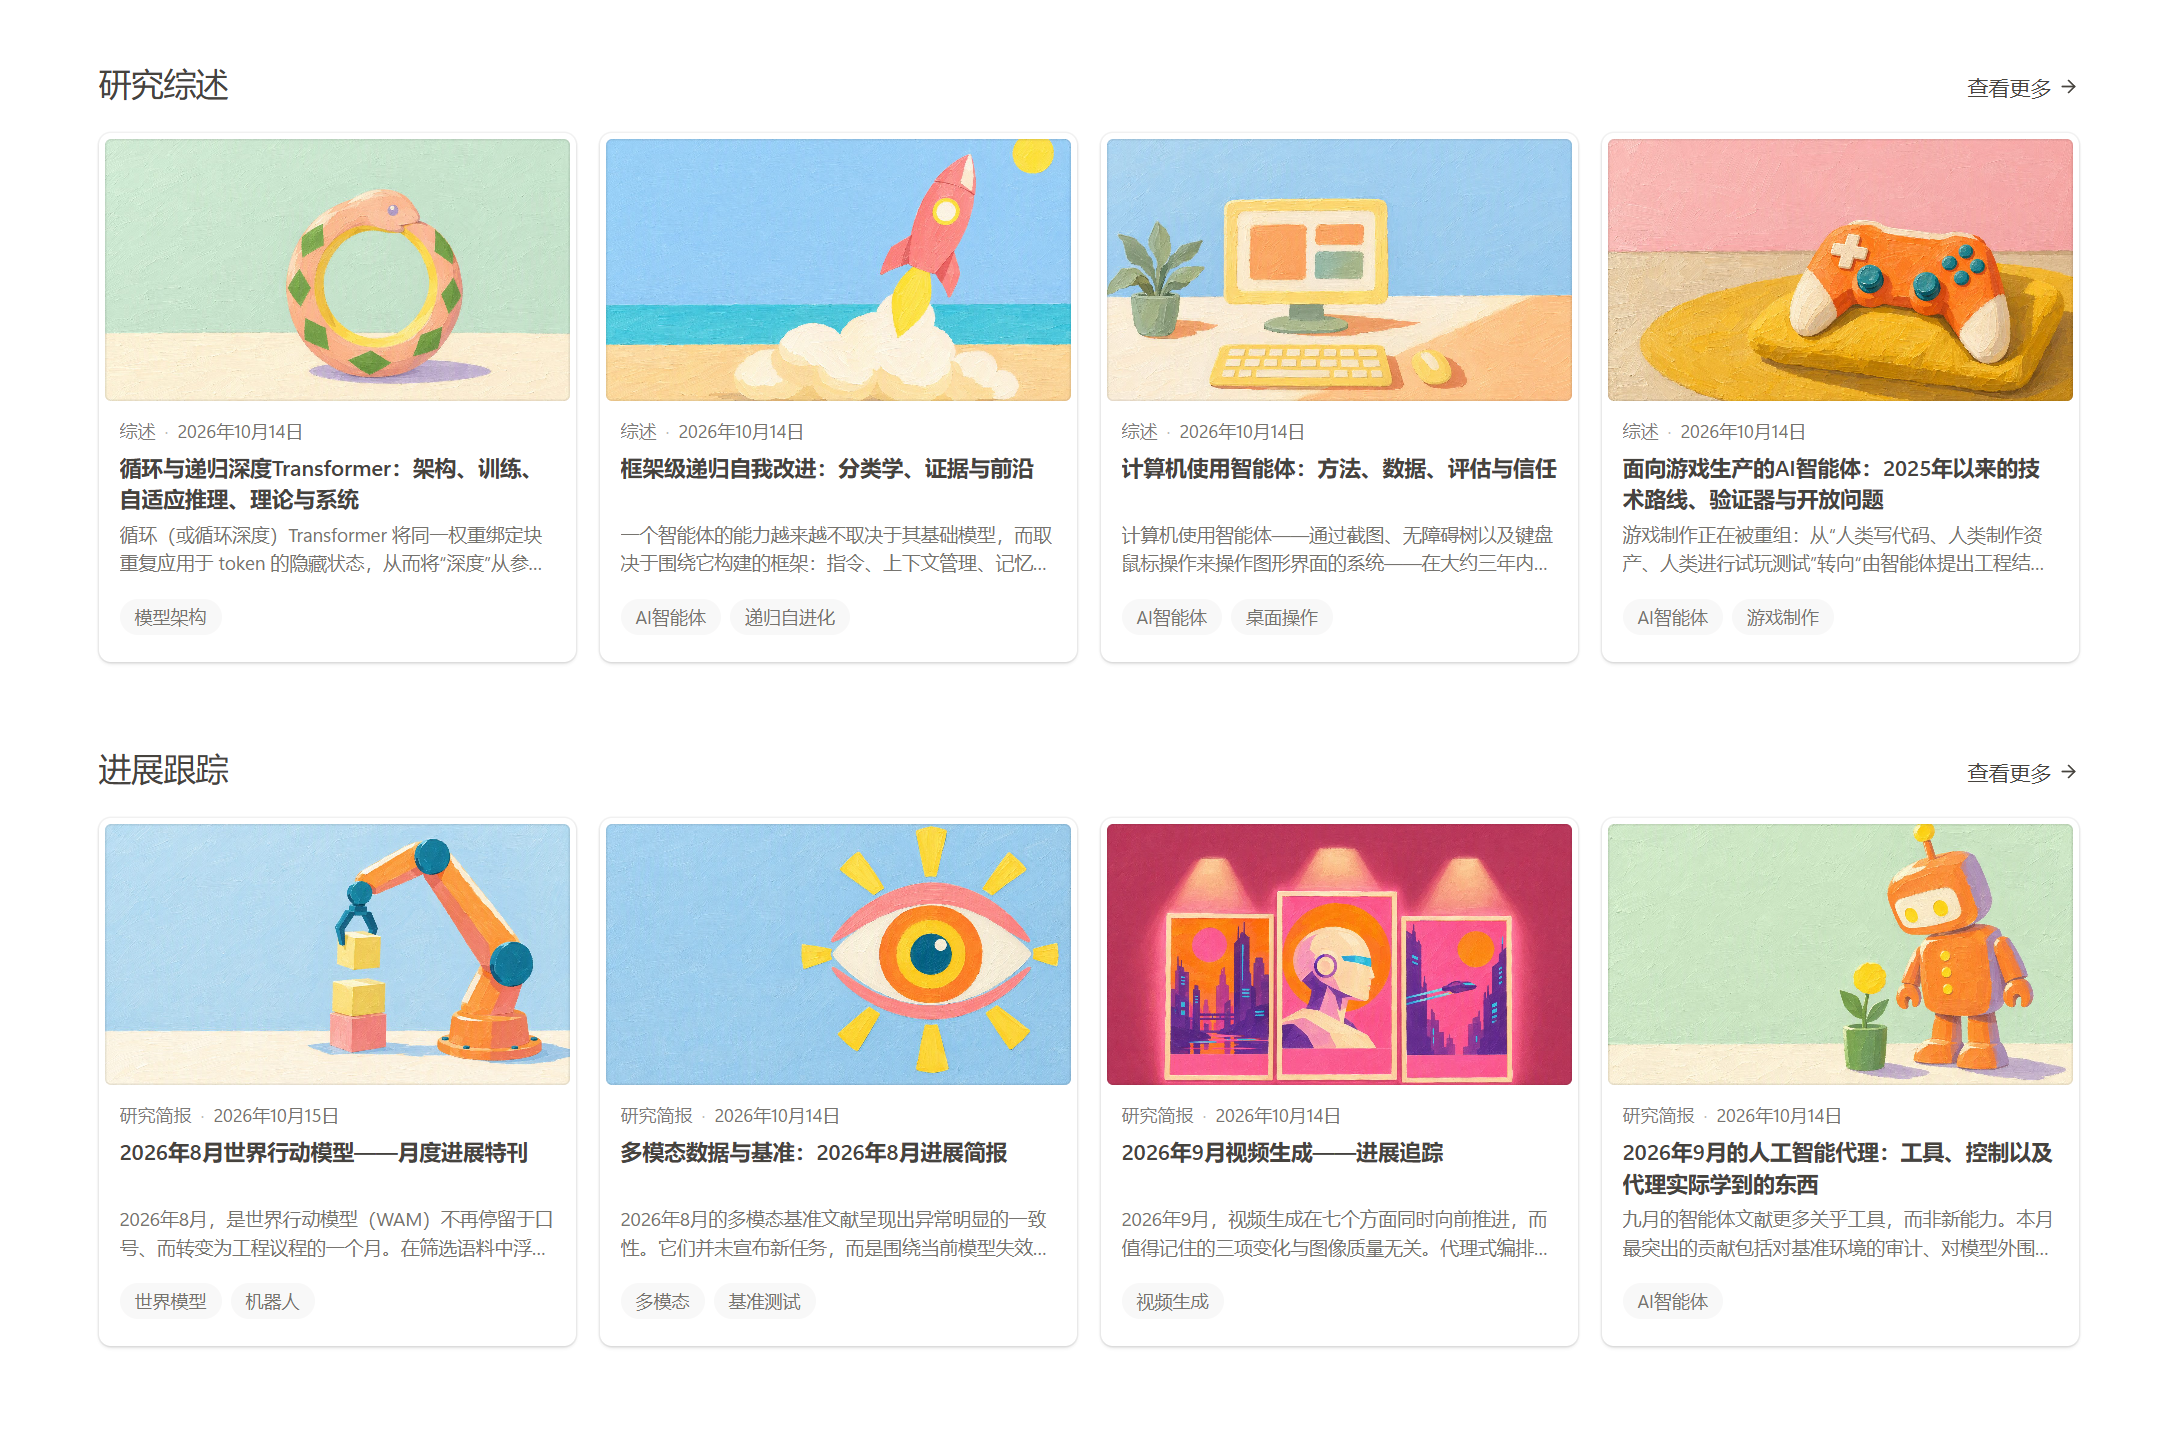
用Jev做了一个arXiv文献调研工具(parallax.ink),起源于自己的日常需求。在使用通用Coding Agent产品或者alphaxiv的时候,检索通常基于搜索引擎或者自建搜索策略,并且一般只召回几十篇论文,在进行更大规模检索的时候消耗的时间和token都大大增加。
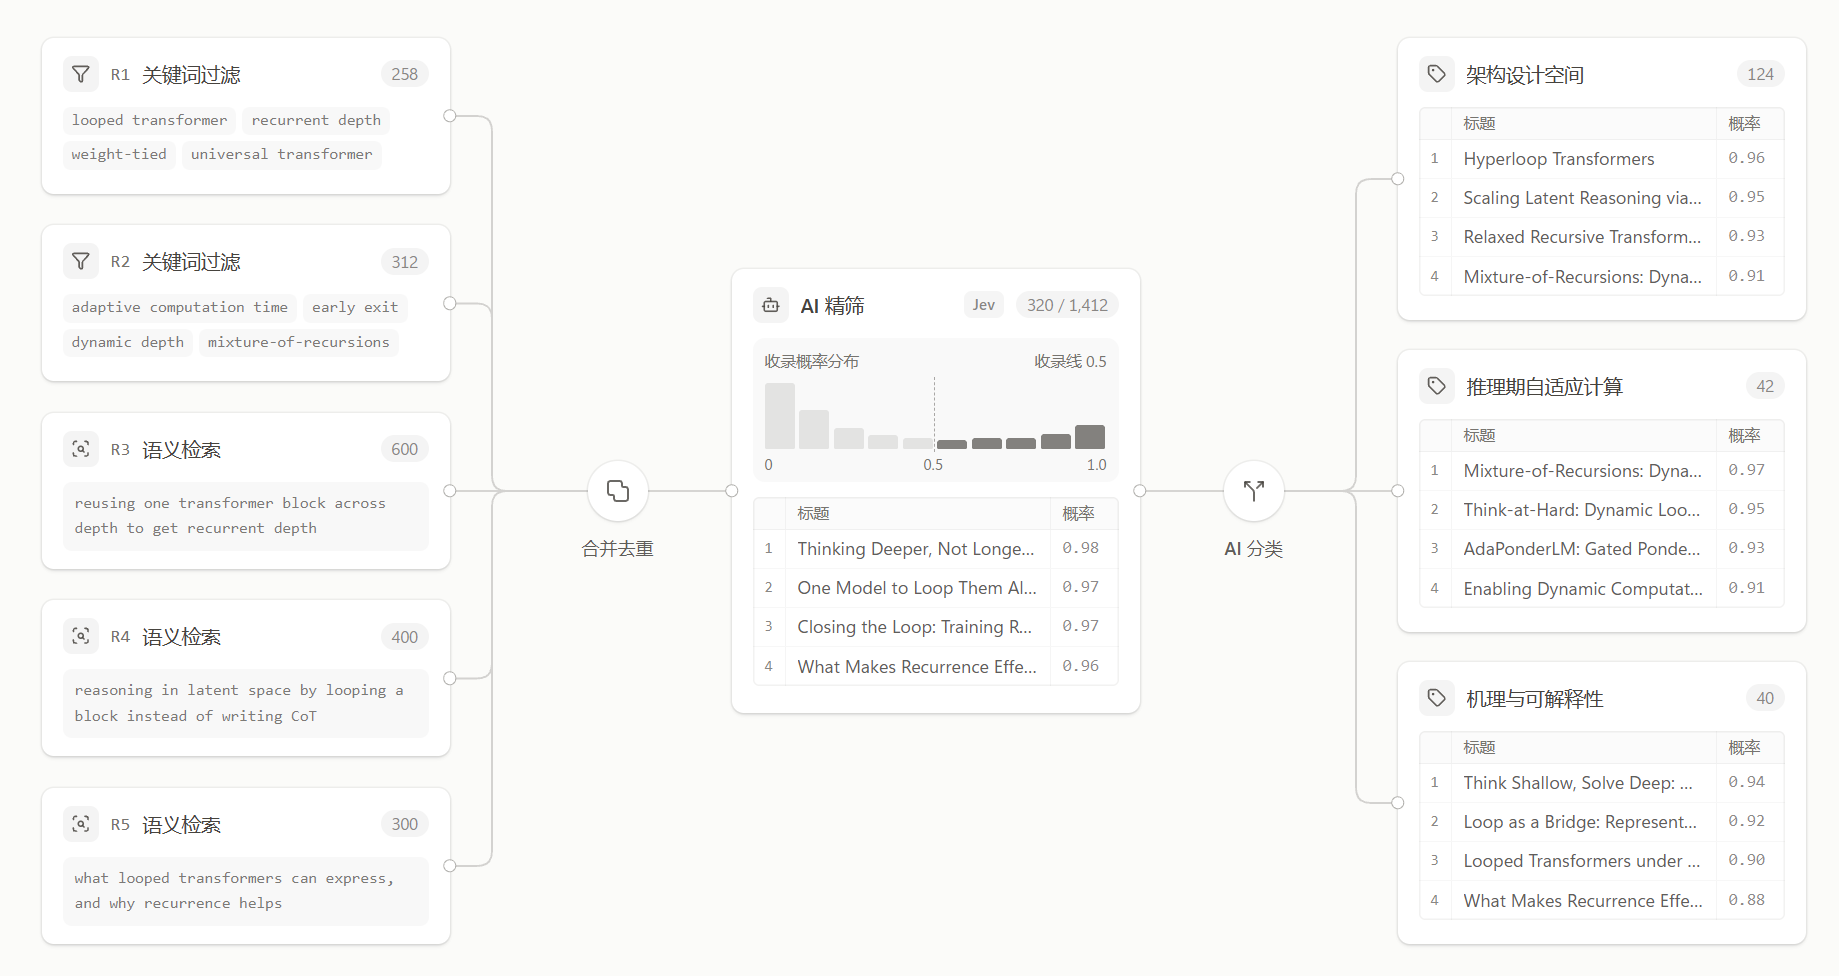
所以我设计了parallax检索管线,通过关键词和embedding进行大规模的多路召回,合并后通过并发调用决策模型Jev进行精筛判定以及主题分类,实测精筛3.6万篇文献只需5分钟,是deepseek-flash速度的10倍以上,成本仅为1/5不到。检索结果还会被设计为结构化的集合,以抑制后续智能体索引的幻觉。
在检索管线的基础上搭建了自动完成调研报告的工作流,目前支持完成学术综述和近期进展跟踪(每日/周/月论文总结)。并且正在尝试做Proactive Agent主动学术助理。
网址:parallax.ink
调研报告示例:parallax.ink/research/zh
#独立开发的日常
所以我设计了parallax检索管线,通过关键词和embedding进行大规模的多路召回,合并后通过并发调用决策模型Jev进行精筛判定以及主题分类,实测精筛3.6万篇文献只需5分钟,是deepseek-flash速度的10倍以上,成本仅为1/5不到。检索结果还会被设计为结构化的集合,以抑制后续智能体索引的幻觉。
在检索管线的基础上搭建了自动完成调研报告的工作流,目前支持完成学术综述和近期进展跟踪(每日/周/月论文总结)。并且正在尝试做Proactive Agent主动学术助理。
网址:parallax.ink
调研报告示例:parallax.ink/research/zh
#独立开发的日常
4 01
总算花三周业余时间读完了 A Survey of Large Language Models,获得了学术和工程层面对于 LLM 的系统性初步认识,修复了一些认识上的偏见,在此对这篇洋洋洒洒 83 页的综述阅读写点零碎的总结。
# 1. Scaling Law
首先是 Scaling Law,它不只是字面上关于“大力出奇迹”的笼统描述,更具体来说是 Deepmind 和 OpenAI 两个团队在对语言模型探索过程中各自总结出的经验公式:KM Scaling Law 和 Chinchilla Scaling Law。它们都描述了模型训练损失 L、模型规模 N、数据规模 D、算力规模 C 在一定数据范围内的近似定量关系;其大体结果都是 L 随着 N/D/C 的增长而下降。
但从深度学习角度而言,Loss 并不是下游任务最为关注的目标,推荐领域可能关注 Recall 或者 NDCG、文本生成可能关注 Perplexity 或者其他指标。Scaling Law 并不能指出这些对下游应用更有意义的指标是怎么随着规模变好的,反而更糟的是要引入物理学相变的术语来说明这些下游指标可能会发生突变,也就是现在流行的说法“涌现”。
另外 Scaling Law 的实际意义还在于指导模型的训练和微调。算法定下来之后可以在小规模参数、数据集和算力上看 Loss 下降情况,通过 Scaling Law 就能预测出相同算法下更大的参数、数据集和算力的大致结果。
# 2. Overview
学术和工程上对于 LLM 的关注点主要有这四个方面:Pre-Training, Adaptation, Utilization and Evaluation。
预训练(Pre-Training)是大模型从随机初始化的参数状态开始,在大规模语料库上进行拟合的过程,此阶段的训练目标通常是 Language Modeling 任务,最常见的就是 next word prediction 任务,此阶段得到的模型通常称为 base model。
适配(Adaptation)是经过预训练后的模型针对特定场景进行适配的过程,也就是通常所说的微调(finetune)。主要包括指令微调阶段(instruction tuning)和对齐阶段(alignment tuning),前者通常通过有监督学习进行微调(SFT),后者通常通过人类反馈的强化学习进行对齐(RLHF)。但实际上由于强化学习对超参数敏感、难以收敛,也有很多工作使用监督学习对大模型进行对齐微调。
利用(Utilization)是开发者、用户对于大模型的直接或间接的应用。综述主要讨论了提示工程、上下文学习(in-context learning)、思维链(CoT)、行动规划(Planning)。提示是对大模型的基本操作,通过提供任务描述、任务示例、任务提问来引导大模型进行回答;思维链则进一步地通过交互式的引导提升大模型的能力;行动规划则与当前最热门的自动化代理(autonomous agent)联系起来,具备任务分解、工具使用、记忆反思等综合性能力。
评测(Evaluation)则是对大模型的能力进行评估。对于预训练得到的 base model,通常使用 MMLU 等 benchmark(基准测试集)的方式对其各方面能力进行通用评估。对于微调后的模型,则更多地使用人类评估,或者其他 LLM 构建的智能体进行自动化评估。
现在做大模型的企业也针对这些技术方向分化出了不同的工程技术岗位,比如针对预训练和 SFT/Alignment 的数据类岗位、针对 Alignment 的安全类岗位、评测方向的算法研究员、面向分布式训练的基础架构岗位、面向推理加速的性能优化岗位,当然还有算法设计和应用实现的岗位。两年前大模型还是学术论文的热门话题,现在已经在工业界分化出了这么多细分岗位,并且没法完全继承以往机器学习的技术栈,也许有相关工程经验的人才也是相当稀缺。
# 3. 数据质量
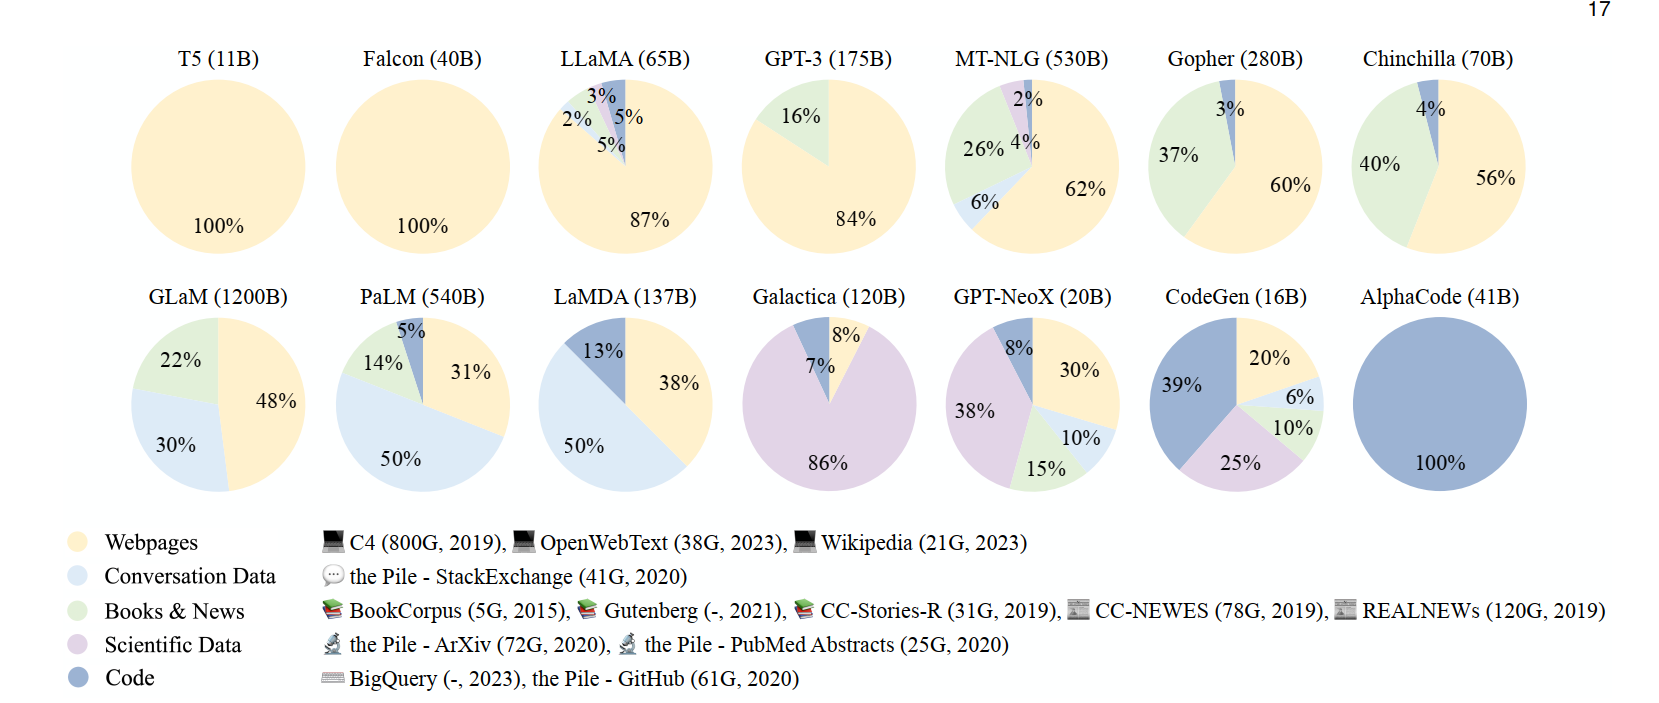
关于大模型与代码,一个很有意思的观点是,大模型的复杂推理能力受益于它在代码库上的预训练。研究者们发现,大模型预训练预料中代码数据占比越多,模型的复杂推理能力(包括 CoT 引导)会上升。人们推测是因为代码本身就是一种一步步进行推理的形式化语言,更别说很多数学物理上的数值计算和公式也能通过代码表达。所以古往今来的程序员们留下的智慧成果也为大模型的爆发贡献了一份力量 :-P
人们还发现了预训练语料库中的重复文本会降低模型生成文本的多样性,也会使得训练过程不稳定,所以数据处理时还会想办法去除重复文本。总之,作为人类本质的复读机行为使大模型智力下降。
大模型的预训练和微调过程和人类的认知发展过程很像,首先要在大规模通用语料库上学习基本语言常识(对应人类的基础教育/通识教育),然后再在任务特定的数据或者领域特定的数据上进行学习(对于人类的分专业的高等教育)。具体在训练过程中,不同类型数据的配比和学习的先后顺序也有各自的讲究,因为后面的数据微调可能会使得前面学到的内容发生灾难性遗忘(从优化角度来说就是去拟合另一种数据分布了,前一种分布自然会丢失一部分),所以发展出了 data scheduling 这门学问,也正因此需要专门的工程师来负责数据吧。不得不感叹一声大模型的学习真像人类。
# 4. 咕咕咕
6 04
The Game Developers Conference (GDC) 2024 将于三月中下旬在加州举行,一年一度的游戏开发者盛会聚集了来自工业界最新的游戏开发经验分享。
整理了一下部分 track 的英文摘要,并找 gpt-3.5-turbo 小助手翻译成中文,中英文对照方便查阅和搜索。这次整理的 track 包括游戏音频、游戏设计、游戏叙事、游戏制作与团队领导力、游戏程序、游戏视觉艺术、虚拟现实与增强现实。另外还有商业营销、游戏教育、独立游戏等 track 暂未整理在内。
制作列表的时候浏览目录和关键词,发现有许多团队在大型语言模型(LLM)与游戏结合的方向上做了许多探索工作。比如利用LLM设计游戏关卡,基于LLM的NPC,利用LLM理解玩家意图进行UGC,以及LLM与传统游戏决策模型行为树的结合。不出意外地,LLM在未来几年将会越来越深入地融入游戏生产流程当中,甚至成为游戏引擎的标配功能。
机器学习峰会(Machine Learning Summit)也将带来大量的机器学习与游戏生产结合的经验分享。例如最为广泛应用的强化学习(Reinforcement Learning)训练智能体作为游戏代理(怪物/NPC等)或者自动化测试代理(代理玩家),利用机器学习算法进行角色动作生成,人工智能协助分析开发过程中的Bug并支持更高效的持续集成(Continuous Integration, CI)。
我个人最感兴趣的是两项将神经网络应用于实时渲染的技术报告。一项工作将神经网络用于视锥剔除,另一项则将神经网络用于纹理压缩,并在着色器中通过一个小型神经网络将压缩后的信息进行复原。如果这两项技术能在消费级显卡上达到实用标准,是不是意味着在未来几年内,实时渲染中具有“预测”、“压缩”、“降噪”等属性的问题会涌现出越来越多的深度学习解法呢?毕竟解决这几类问题是深度学习的强项,而受限于实时渲染超高的性能需求,深度学习迟迟难以在该领域铺开。
总之,期待今年的GDC。希望这个列表能帮助你搜索你感兴趣的话题。
GitHub - Zilize/GDC-Index: The Game Developers Conference (GDC) 中英文摘要索引
4 01
组里的大模型综述更新了许多内容,从51页扩展到了85页,新增了如下内容:
对LLaMA模型及其衍生模型组成的LLaMA家族介绍;具体实验分析,包括指令微调数据集组合方式实验以及部分模型综合能力评测;大语言模型提示设计提示指南以及相关实验,总结了提示设计的原则、经验;参数高效适配和空间高效适配章节,总结了大语言模型相关的轻量化技术;对于规划(planning)的相关工作介绍;许多脉络梳理内容,以及大量最新工作介绍。
对LLaMA模型及其衍生模型组成的LLaMA家族介绍;具体实验分析,包括指令微调数据集组合方式实验以及部分模型综合能力评测;大语言模型提示设计提示指南以及相关实验,总结了提示设计的原则、经验;参数高效适配和空间高效适配章节,总结了大语言模型相关的轻量化技术;对于规划(planning)的相关工作介绍;许多脉络梳理内容,以及大量最新工作介绍。
大模型综述升级啦
7 01
最早知道Taichi是通过三四年前机器之心那篇“99行代码实现冰雪奇缘”的推文,而这学期幸运地进入Taichi Graphics实习,昨天顺利离职。我在象牙塔的四段实习中,收获最大印象最深是在Taichi的四个月。
初创公司能带来不一样的实习体验,成员能发挥更大的作用,工作氛围也会更自由灵动。在这边遇到了超强的前辈们,有对C++标准如数家珍的语言律师,有对Graphics API历史沿革娓娓道来的图形佬,还有游戏/HPC/AI兼修的弄潮极客……
本以为来这边能做一些渲染相关的工作,进来发现接的锅跟构建和编译走得更近。中途还跑去读了大半个月TVM想整个栈式虚拟机,后来发现只需要写线性的编译代码。最后给Taichi Lang写了个没有发布的插件(还有个坑找个周末继续填):
github.com
开源是计算机技术最浪漫的形态,把自己的头像塞进Taichi Lang的Contributor墙上是我在Taichi最开心的收获。
11 00
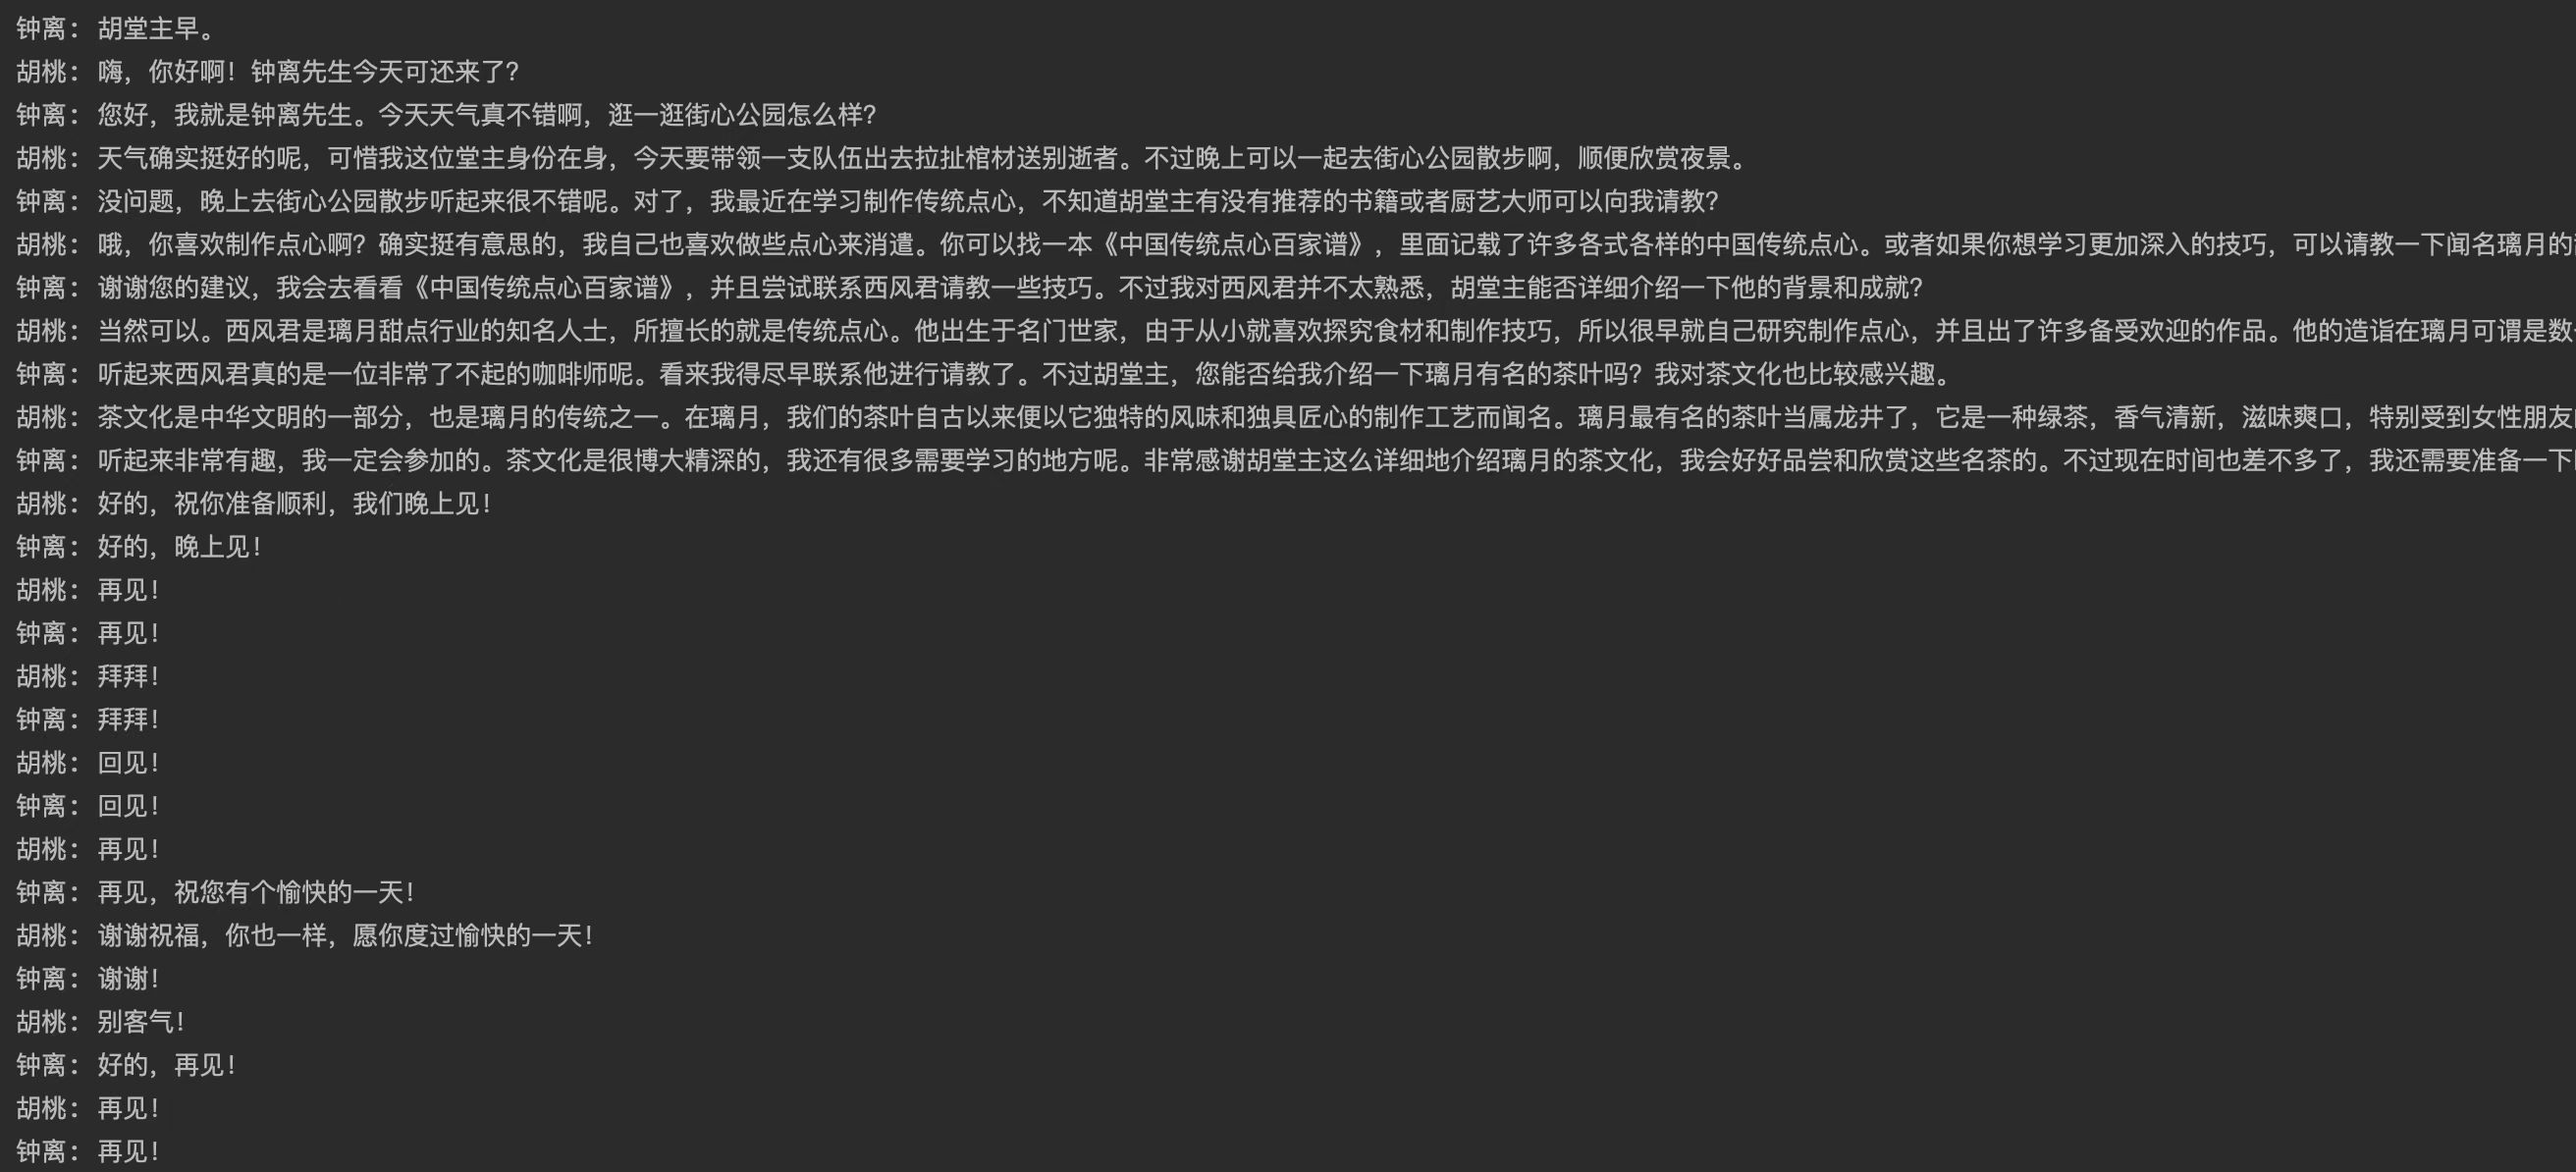
最近尝试着让两个GPT-3.5扮演各自的角色相互对话,整体的效果还不错,但是遇到了些许困难:
1. 难以让LLM主动打招呼:在调用OpenAI API时,官方文档的指引是同时提供系统提示(system)和用户提示(user),如果仅指定了系统提示就让assistant(也就是GPT)进行对话补全,它就会把系统提示当做上一句话进行回复。比如如果是官方提供的例子“You are a helpful assistant”,那么GPT就会回复“感谢你的赞美”之类的话。总之,这是一个根据对话上文补全回复的接口。
2. 难以停止对话:我在系统提示中指出,如果GPT觉得对话可以结束了请输出“QUIT”,但是尝试了好多次,除了少数几次系统能输出QUIT之外,其他都陷入了“再见”的死循环。GPT-3.5有时候并没有那么聪明。
3. 对话非常拘谨:总之就是GPT相当有礼貌,可能是RLHF阶段进行对齐的时候教训得好。但可能有一些神奇的prompt能让它扮演更有特点的角色,只是可能需要耗费不小的token数,占据了一些剧情铺垫的空间。
上面这些当然也不是什么致命的困难,都有不少的方案可以缓解。对于打招呼的问题,也许有这样一些解决办法:
1.1 可以在系统提示中直接指示GPT下一句就是对某一角色的打招呼文本,不过这部分提示需要根据该角色是否是打招呼的角色进行动态加载。当角色是被动开始聊天的一方,就直接根据原始的系统提示和对方的打招呼进行回复就好。
1.2 对于某一角色,可以准备一些预定义的打招呼文案,在当前角色需要打招呼的时候,用这些打招呼文案替代GPT的补全,进而让对方根据系统提示和打招呼文案进行补全。在这些预定义的文案中还能够设置一些slot,将打招呼对象的名字动态加载进去。
关于停止对话的问题,同样也有不错的办法:
2.1 设置一个告别词库,如果检测到双方完成了告别,就停止对话。
2.2 如果不幸没有触发告别词库,直接按最大对话轮次强行停止对话。
对于对话拘谨的问题,Generative Agents论文也在注脚中提出现在的LLM生成的回复都相当formal,可能得等以后的专用LLM来解决了吧。
顺便提供一份单智能体对话的代码片段,可以设置token数警戒值,一旦上下文超过了这个警戒值就会删除前面的对话内容(但是保留系统提示和第一轮对话),也可以将对话记录保存到文本文件:gist.github.com
10 73
关于下一代NPC:一些总结和翻译。
阅读论文Generative Agents的过程中看到了相关工作的介绍,其中有一个方向是“人类行为的可信代理”,才发现原来游戏NPC也是一个被系统性研究的对象。不过NPC构建的目标是配合游戏的剧情和玩法,但是学者们研究更广泛的模拟人类行为的智能体。
在这些相关工作中,通常将构建“可信智能体”(Believable Agents)作为核心目标,它们跟我们一样居住在一个开放型的世界中,感知周围环境,并在与其他智能体或者人类的交互过程中展现出“涌现行为”(Emergent Behaviors)。这些工作中最具代表性的就是游戏中的智能NPC。
目前构建这些可信智能体主要的方法有:
1. 基于规则的方法:比如“有限状态机”(Finite-State Machine)和”行为树”(Behavior Tree)。这类方法的优点在于技术成熟、表达可控。缺点是需要开发者进行大量的手工劳动,预设智能体在不同状态下的的行为表现,因此无法应对开放型世界中更加广泛的行为方式。
2. 基于学习的方法:比如“强化学习”(Reinforcement Learning)。这种方法的优点是不需要开发者手工预设大量的行为,同时能够在一些游戏中有超越人类的表现。缺点是它们通常需要明确定义的奖励来让学习算法进行优化,所以只在竞技性游戏中表现较好。
而LLM能够解决上述两种方法的缺点,它不需要手工预设大量的行为,也不需要场景定义明确的奖励来进行训练,因为LLM在预训练的过程中就学习到了大量人类的行为特点。因此,游戏设计师们可以通过类似于“涌现叙事”(Emergent Narratives)的方式来构建智能NPC和人类的交互。
一些名词解释:
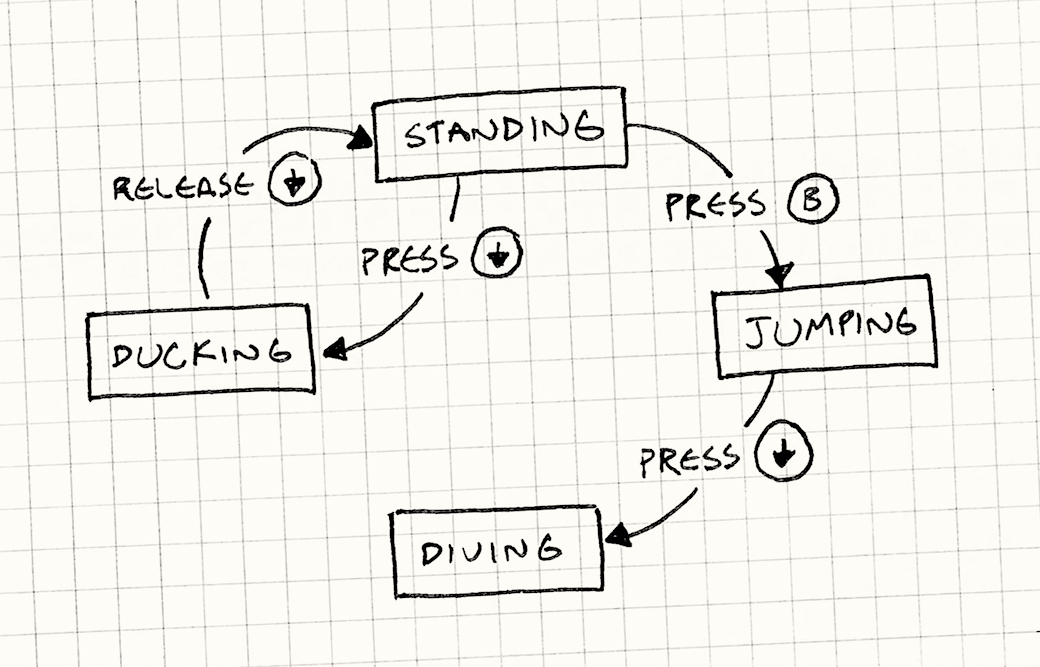
有限状态机:描述有限状态和他们之间转移关系的数学模型。比如图一是描述一个角色的有限状态机,它有站立、跳跃等动作,当角色处于站立状态时,按下游戏手柄的“B”就能够让角色转换到跳跃状态。
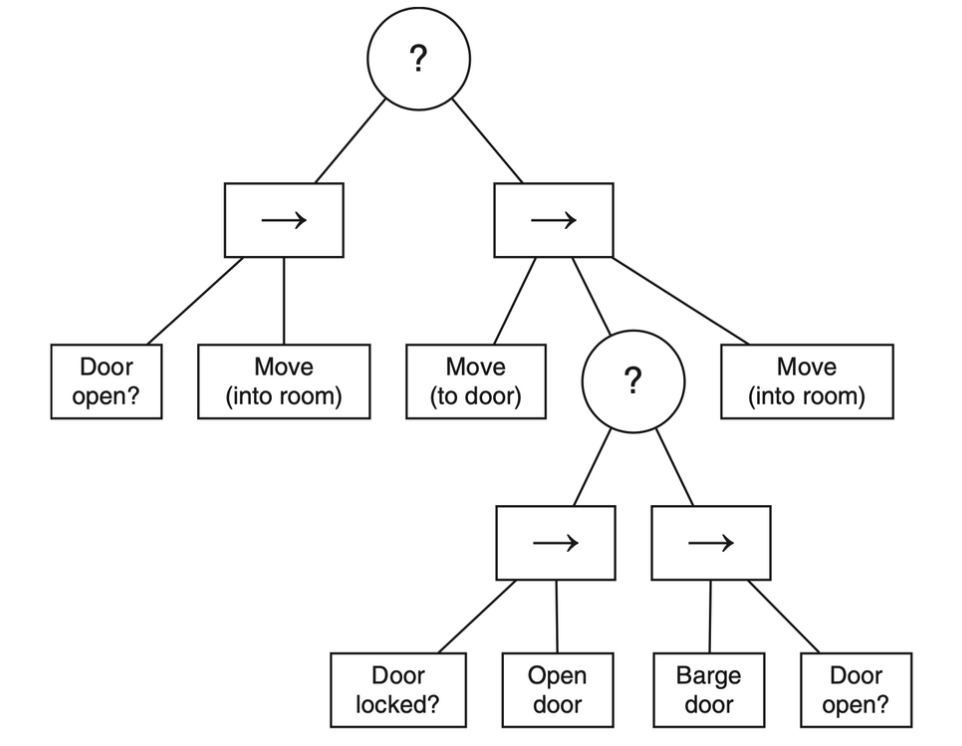
行为树:以一颗树状结构来描述角色的行为状态,比如图二中最左边,如果门是开的就进行进门操作,否则跳回根节点执行右边的复杂开门逻辑。
5 04
关于LLM tokens长度限制问题的一些想法。
与过小的空间和过长的时间对抗永远是计算机科学的重要命题。当年为了应对CPU和RAM速度的剪刀差,计算机发展出了Cache-内存-外存多级访存结构,在局部性原理的加持下我们可以同时享受近似Cache的速度和硬盘的大小。现在的LLM可能也是如此,同样存在着速度上的剪刀差和局部性原理。
解释一下多级存储结构,它的一个直观理解就像是我们在大餐桌上吃饭的时候,去夹远处的菜需要的时间久,但是夹自己碗里的菜需要的时间短,然而碗的大小又远比盘子的小,从碗作为一种缓冲就是多级存储结构的基本思想,这样我们在平均意义上能以用碗的速度享受整个餐桌的菜品(因为我们大多数时间里都是和碗打交道)。
我们与机器对话的局部性原理在于,我们在短时间内通常是围绕单个话题的,话题跳转一般也不会有太大的幅度。那么系统维护与用户对应的记忆的时候,只需要focus on话题相关的那部分记忆。如果出现了话题的跳转,类似于现在的Cache Miss,从而产生更大时间消耗,从而也算是访存不友好的行为。
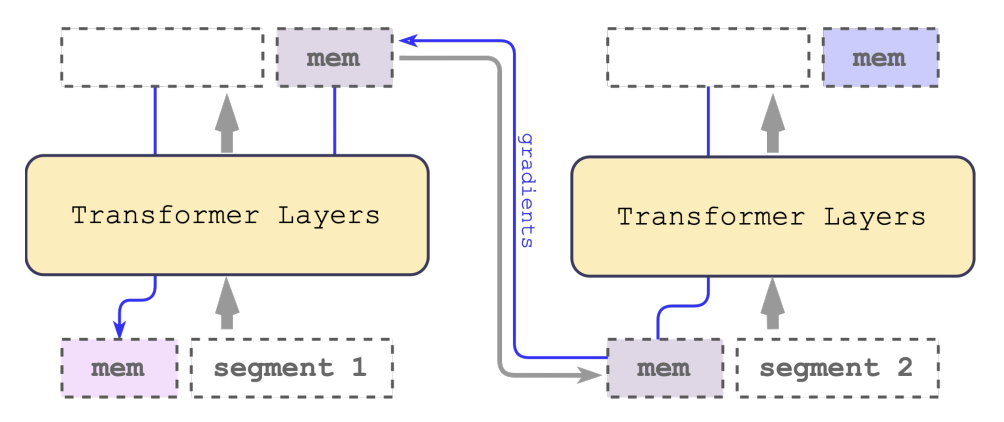
不过解决tokens限制问题的最好办法可能还是从LLM的底层架构出发进行改造,突破Transformer本身的限制。比如Recurrent Memory Transformer就是类似的工作。但是在现有的架构下,参考体系结构的思路缓解窗口限制问题也许是个不错的想法。
7 01
Embedding是机器学习带来的最有创造力的想法之一,在这个框架下,所有的信息都能够转化为一个由浮点数构成的向量,从而我们能够将其应用于自己的需求。介绍一些关于Embedding的想法,包括一些术语的解释,和它目前的一些应用(或者潜在的应用)。
机器学习领域的表示学习(Representation Learning)指的是从大量的数据中自动学习对于某一件事物的表示。这个“表示”在很多上下文中指的就是Embedding,在学术文献中又经常用representation、latent representation、latent feature来表示,不过可能会出现术语乱用的情况。
为什么是latent呢?这就涉及到了两个概念,一个是数据的初始表达方式,比如文本会被表示为字符串,图片表示为每个像素的RGB三通道颜色值。这些都是human readable的表示,但并不适合用来做更加灵活的计算。通常来说,这种人类可读的“初始化”表达还会被转化成更加方便计算的形式。
比如说,我们构建一个词典,每个单词在其中有一个序号,那么文本就可以表示为这些单词序号的集合,这种思路就演变成NLP中的One-Hot编码方法,也就是一个单词用一个长度超大的数组来描述,这个数组中除了单词序号那一位为1,其他位都是0。
这些人类能够读懂的表示都可以叫做explicit的表示方法,而通过神经网络(或者其他手段)将它们降维压缩得到的则叫做隐式表达方式,通常喜欢用latent来修饰。人们可读的数据表达的体积是巨大的,比如一张图片就是若干MB,但是转化为latent的表示可能只需要1024个浮点数。
体积从大到小,除了有些冗余的信息被抛弃,还有一些并不冗余但是对于我们来说没用的信息也被抛弃了。(PS:抛弃冗余信息,是无损压缩的基本思想;抛弃大部分信息,是我们这里叙述话题的基本思想)一张图片或者一段文本仅用1024或者2048个浮点数表示,大大提升了计算的灵活性。
这种“表示学习”,或者说学习复杂数据的低维表示的过程,在人工智能领域有很多应用。首先是自然语言处理,2013年的Word2Vec作为同时代最具代表性的词汇表示方法对NLP研究造成了巨大的影响。它的基本想法是词的分布式假设,也就是说在文本当中,一个词的语义由它的上下文“决定”。
在这个想法的基础上,Word2Vec提出了skip-gram和cbow两种模型,cbow是像完形填空一样用上下的词汇预测中间的词汇,skip-gram则刚好相反。再加上负采样的训练优化方式,得到静态的embedding。这里的静态意思是说一个单词的embedding是固定不变的,我们可以直接用一个文件存储这些对应关系用来计算。
Word2Vec得到的embedding或者说词向量有非常良好的特性:“语义相近的词的表示也相近”,也就是说,语义相近的词汇对应向量的欧式距离比较小。于是我们在数学上定义的向量计算的性质能够很好地和词向量的表示结合起来。一个经典的例子就是“国王-女王=男人-女人”,这里的斜杠是向量减法,等号是约等。
但是静态的表示有很多问题,比如说“Apple”这个单词,可能是指苹果公司,也可能是一种水果。如果有动态的embedding,能够根据上下文的情况对自身的值进行调整,就更加能应对多义词的问题。比如说上下文出现很多科技名词,那么这个Apple就是苹果公司;如果是种植、饮食之类的上文,它就是一种水果。
于是就有了动态embedding,其代表性工作就是BERT。好像扯远了,总之自然语言处理中词汇能够很好地表示成低维向量,也就是embedding。ELMo、BERT、GPT-2之后,预训练语言模型(PLM)成为热门研究方向;GPT-3那年,大型(预训练)语言模型(LLM)变得火热。
与此同时,人们发现大型语言模型是所谓的few-shot learner,它可以不需要fine-tune而直接从上下文中进行模仿和学习。这些提供了学习样例(few-shot)或者不提供样例只提供问题描述(zero-shot)的上下文被称为prompt。prompt learning,所谓的提示学习就是在这时候开始火起来的。这是2022年。
在推荐系统领域也有这种embedding的应用。在一个简化的例子中,推荐系统对于“用户”的原始数据表示就是该用户和哪些商品进行了交互(user-item pair),这些记录进行表示学习,就能够得到用户和商品的embedding,从而进行计算。正如之前Word2Vec的例子,推荐系统中可以找到用户的近邻商品进行推荐。
除了把文本、图片、用户行为表示成embedding,我们还可以把分子结构、社交关系等表示成embedding,这些是图神经网络所做的事情。总而言之,一切事物都能够从基本的数据表示转化成为embedding(前提是数据量足够大,神经网络能够学习到良好的拟合方式)。
为了应用AI,最好要理解AI技术的一些特点。表示学习得到的embedding很多情况下都能进行良好的运算(语义相似则距离相近),这种技术特点带来了一个计算密集型任务的巨大需求:快速向量检索。快速向量检索就是希望能够以实时的性能找到和目标向量最近或者最远的若干向量。
这里的最近可以有很多度量方式,比如欧几里得距离(L2范数)、点积距离、余弦距离。比如寻找与目标用户最匹配的商品(推荐系统)、匹配与目标文本最相似的其他文本(信息检索),都需要进行最近向量检索。而最远向量匹配可以用于一些异常检测或者离群值的剔除任务。
近期LLM火热,文本能够通过OpenAI的API转化成对应模型的embedding,进一步催生了相关的需求,这可能也是向量数据库发展迅速的原因。毕竟相对于Faiss等高性能向量检索框架提供更全方位的支撑。围绕AI应用的专用基础设施迅猛发展,也是LLM火热对技术行业带来的积极影响。
了解embedding的技术特性也能给开发人员们带来更丰富的灵感。它的核心在于“相似相近”,那么就非常适合一些非常规的信息检索场景。以往小型开发者只能通过字符串匹配或者模糊搜索的方式进行文本查询,而像智能搜索引擎那样的智能检索只有大公司才能负担得起。
但是LLM大规模落地,就能够很方便地得到一段文本、一张图片、一段视频的某些帧的低维向量表示,如果有更好的多模态LLM,那么语音、音乐旋律也能够被良好地编码。在这个基础上一些简单的想法,比如新闻的自动归类(向量聚类)、相似笔记的智能检索(最近向量检索),以及不同模态之间对齐的检索,比如根据文本搜图片,根据文本搜音乐都是未来能够落地的产品。当然这里面要考虑用户隐私的问题,有一些关乎隐私的任务天生不适合调用API来做,从而也就无法落实下去。
大概就写那么多吧。
23 78