即刻App年轻人的同好社区
下载
1/ Agent 挺像是一个卖电脑的生意,每用户(或每 agent)一台云电脑。Muse 的 Linux VM、dots 的专属云电脑、Grok Bot 的 microVM、Instinct 的持久云机器、Manus 8000 万台虚拟机、Today 的「云端执行空间」、Karpo 的 Browserbase
2/ 如果模型进步是不断上涨的潮水,要做 "be the boat, not the pillar",Altman 直言「没有新模型也做出一大堆有用的东西」,Nat Friedman 承认 Muse "heavily inspired by OpenClaw"。OpenClaw 是这一代产品的公共祖先,各家买的是 harness 经验
3/ Always-on 的工程实现是两种触发源(heartbeat 和门铃 webhook)加醒来之后的固定流程,「it's just a cron job in the end」
4/ 北极星从 DAU 转向「用户交出来多少?账号、权限、钱、决策权」。Karpo 看 Delegation Rate,问是不信任,委托是信任;Instinct 看绑卡率和授权后留存;Today 明说用户主动发 query 的次数「优先级非常低」,用户越不需要开口,说明它越懂用户;Manus 看「高价值用户的高价值任务」
5/ 算力是公认硬约束,所以定价按算力分层而非按功能。Muse 三档只差 token 量,dots 自认 premium,Manus 用 credits,Grok Bot 独立计量周重置,Instinct 创始人把四成时间花在算力规划上
6/ 主轴 1:需求从哪一层接住。这是最本质的分歧,Leah 自己也说「意图不是行业共识」。接得最早的是 Karpo,想在感受还没变成需求时就插进来:用户说「我女朋友不理我」,它推荐酒吧;VibePad 让用户用滑杆摇出一个 vibe,再由端侧模型实时变成 prompt。
往后一层是 Today AI 的「主动化 + 个性化」,齐俊元认为「主动化是最重要的特质,其它都是铺路」,前提是先懂用户再开口,所以产品跟踪的是「这个人处于什么状态」而不是任务到哪了。
再往后是 Instinct 和 Muse 的长期目标层:Shinn 明说 Instinct「not a task accomplisher」,用户给它的是三四个月的 standing objectives;Muse 把目标做成了 Goals tab,再用 Ideas tab 围绕目标提建议。
接得最晚的是 dots、Grok Bot 和 Manus Cue,三家的起点都是用户已经成形的指令:dots 的默认流程是「给目标→定权限→等汇报」,Cue 的 slogan 是 "Give it a cue",Grok Bot 是 "message a Bot to take on a task"。
dots 口头上也说 "without you having to ask",但它拦截的是通知流和工作上下文,Karpo 拦截的是消费需求,两者的「前插」对象并不相同
7/ 主轴 2:一个 agent 还是一群 agent。
Muse、Instinct、Today、Karpo 都是「一个长期了解用户的主助理 + 一条长对话」,Today 团队还专门讨论过「为什么面对一个助理而不是多个 agent」;
另一边,Manus Cue 给每个 agent 独立的邮箱、电话、钱包和电脑,多个 agent 可以在群里互相交接,Grok Bot 是「chief of staff + 各职能专员」的团队结构,dots 先有一个主 dot,再分化出带额外护栏的专家 dot。
Cue 的多身份设计是它和 Muse 之间唯一的真差异,代价是每个 agent 都成了一个可被封号、可被钓鱼的「数字人」。
这两条主轴往下延伸出六个维度的差异,大致可以按「切人群还是服务所有人」排成一个光谱。
人群上,Karpo 明确切 25–35 岁的都会生活型人群,Today 拒绝切人群而把异质性交给个性化,Instinct 和 Muse 的口径一律是 everyone 和 billions,Manus 按任务价值不按人,dots 先服务付费专业用户,Grok Bot 的人群由 SuperGrok 和 Cursor 的订阅盘决定。
人格策略几乎是人群策略的镜像:切人群的 Karpo 立固定人设、不开放换皮,怕稀释品牌;服务所有人的 Muse、dots、Today 都走「最大公约数 + 换皮」,Jolly 可完全定制,dot 可换皮加宠物,Today 让用户命名、换性格、看亲密度;
Instinct 走到另一个极端,明确拒绝人格,连名字都刻意不拟人,把空白当优势;Cue 没有统一人格,让用户自己造一群;Grok Bot 零人格,信任靠 Musk 本人背书。入口上,Instinct 坚持「没有新界面」,只用短信和电话;
Karpo 从 iMessage 试验后转成 App,Today 是五端 App、微信可当入口,Cue 是独立 App,Muse 同时占 WhatsApp 和 App;dots 和 Grok Bot 寄生在 ChatGPT、Slack、Grok、Cursor 这些既有产品里。
模型主权也分成两派:Muse 自研闭源的 Spark 和 Wonder,Today 从第一天起自训,Instinct 自称自研推理达到「Opus 5 级」,Karpo 在开源模型上做 post-train,dots 自然用自家 GPT-6 Astra;而 Manus 外采多模型路由,Grok Bot 由 Cursor 选模型。
变现路径上,Karpo 是交易抽佣加绑卡金融再加未来的 agent 竞价广告,Instinct 是用户免费、商家抽成、明确拒绝广告,Muse 是免费档加算力拍卖加交易抽成,Today 反对按 token 收费、倾向服务费,Manus 卖 credits,dots 和 Grok Bot 都是高价订阅的捆绑或留存钩子。
最后是工作还是生活:Karpo、Today、Instinct 押生活,Muse 是生活加小企业,Cue 两者皆有,dots 和 Grok Bot 明确押工作入口
8/ 「垂直 vs 通用」的分歧其实是对飞轮起点的分歧,有三个路线:收窄场景(Karpo)、扩大分发(Meta)、提高频次(Manus)。
Leah 认为收窄命题才能更早到达 recursive;季逸超认为「垂直是加约束」,Manus 的定义是「一个通用的模型加上一台计算机」。
模型本身什么都会,电脑上什么都能做,所以通用是这套东西的自然状态。做旅行 agent 或法律 agent,不是在往上加能力,而是在往下划边界,规定它只能做这类事、只能用这类工具。
在 Peak 看来,垂直不是做深,是做窄,等于主动放弃模型已经具备的大部分能力;Zuckerberg 认为任何品类都有飞轮,关键是用分发换反馈密度,不需要靠场景聚焦来获得密度,绝对数量足以让飞轮转起来
9/ 大厂和创业公司的 bet 结构性不同。大厂的共同打法是分发先行加算力先行(Meta 在产品就位前就买了推理算力,Musk 把 VM 当自家资产而非瓶颈)。
创业公司各自找一根「针」:Karpo 是垂类,Instinct 是零界面加信任飞轮,Today 是跨大厂中立,Manus 是执行层的壳。
Leah 的「代替人归模型厂、代理人归创业公司」在 OpenAI 身上被踩穿了:模型厂也在做代理人,而且认为代理人的生产要素同样是智力加算力
10/ 白领生活方式可能是人类的一段弯路。
拉长人类历史万年来看,坐在一个地方高强度脑力工作、不太运动是很少见的,可能就是 100 年。如果 AI 搞定这件事,大家应该更像过去那样生活
11/ 「贸工技」:先圈定生态红利,再淬炼产品矩阵,最后反哺底层技术
12/ 云上的 computer use 终于无论怎样都不会和人类争抢电脑光标了。
不久的将来,一个个体就能控制巨大的算力集群去满足自己的好奇心
13/ 「垂直 → 体验完整 → 更早交出意图 → 数据 → 飞轮」是 Karpo 的完整逻辑链,和 Manus「通用 → 高频 → 像人 → 飞轮」是同一个终点、相反的起点
22 15
学习完了@LeahW_2077 的访谈,太有收获了!
1/ 上一代互联网,满足的是几乎所有用户的一类需求,比如 Uber、DoorDash,对应国内的滴滴和美团。今天的 Personal AI 有机会反过来,满足一类人群几乎所有的需求。因为它天然擅长从一个意图出发,在不同需求之间做串联,再到最终完成执行。
2/ Agent 分成两个方向。「代替人」vs「代理人」。
代替人,替代以智力劳动为主的白领工作。核心生产要素是智力,而模型公司掌握了生产智力的方式,所以它大概率是模型厂商的机会。
代理人是另一回事。它代理你的需求,帮你生活得更好。生活里其实有很多需要用到智力、处理琐事的场景。但它涉及的生产要素不只是智力了,还包括能不能贴近用户的场景、交互是否足够好,以及品牌能不能代表特定人群的气质。它还会牵涉到用户的线下生活,要跟线下供给打交道。
3/ 每个人在当下的生命状态里,都有一个占主导的需求类型,或者说占主导的生命动机。
4/ 垂直更有利于我们把体验做完整。体验完整,用户才会得到其他产品里没有、或者好得多的体验,也才会愿意更早地把意图交出来。
5/ 上一代产品解决的是很明确的需求,你要吃饭,你要找个酒吧。除了这些,我们想往前再走一步,在用户只是有一个感受、还没形成需求的时候就接住它。叫作意图前插的竞争。对 Personal AI 来说,最重要的就是两件事。意图,以及基于意图进行供给的个性化生成。意图是一切的起点,但这件事不一定是行业共识。
6/ Muse 现在很强调任务执行,它会帮用户经营 Meta 的广告后台、在 Shopify 上经营店铺。它好像想用一种更全知全能、always-on 的方式,从个人生活再进入工作和创造,抢走 Codex 和 Claude Code 一部分市场份额。它是不是觉得意图最重要,真不一定。
它的产品设计,第二个 tab 是 feed 流,会围绕你关心的事情持续呈现内容,比如我说今天去哪个店吃了什么,feed 里就会开始出现那家店的简介。它更关注后链路的事情,关注执行以及执行带来的结果,想着怎么更好地承接用户已经提出来的需求。而不是在需求出现之前就抓住用户,或者在需求出现之后去做个性化的供给生成。
Muse 的 slogan 也很典型,叫「AI hustles for you」,强调 AI 帮你努力干活,干各种活。
7/ Personal AI 会重塑供给的关系。
过去买商品,不管是有形商品还是线上服务,面对的都是一个 marketplace,自己做选择,再去下单。用户需要先把需求拆成一个个商品。比如我最近睡得不好,改善睡眠是我的需求。但在今天的平台上,我要先做一道翻译,买一个更好睡的枕头、褪黑素、开安眠药,或者去上瑜伽课调节皮质醇。
AI 最大的创造,是用户不需要再翻译自己的需求。我的需求就是一句话,接下来 AI 应该直接交付「让我睡得好」这个结果。至于中间是换枕头、买褪黑素,还是采取其他方式,都只是路径。
8/ Personal AI 最关键的技术变量,是探索从意图到供给之间的供给生成,它应该是生成式的。因为这是最个性化的,也最能满足需求。所以它有一种势能,会吃掉其他交付形式。这条路怎么走,大家都还在尝试,没有标准答案。
9/ 上一代互联网服务的是普遍人群的单一需求,今天 AI 有机会服务一个人从头到尾的需求,但人的异质性很强。要服务好一群人,对交互、品牌、任务完成度上的个性化要求已经很高了。比如一个 Personal AI 要贴身服务好我,和我那位有三个孩子的朋友,有可能是完全相反的。
这个可以类比高端服务业,从整体看很分散,但每个人群内部又是聚集的。要普遍,就一定是规模化、标准化的。但如果要把一个人从头服务到尾,就需要是个性化的,两者天然有冲突。
10/ Personal AI 这场仗不会那么快结束。它受制于硬件,你服务一个用户可能就要开一个虚拟机。今天全世界可能只有 20% 的人用过 AI,给 AI 付费的不到 5%。市场很广阔。
11/ 现阶段优先做 events。餐饮虽然高频,但可传播性不如 events,去参加活动的人天然更 social、更外向,去了之后会在社交媒体上分享。人群更先锋、更 trendy。
12/人设能带来正向结果、增强用户粘性,这是我在豆包的时候拿到的 learning,所以做 Karpo 时很明确它应该有人格。
13/ Muse 的思路跟豆包很像,是一个无害的形象。大部分人都不会讨厌毛绒玩具,它站在光谱中大众化的一端,取人群中的最大公约数。
同时它也想兼顾个性化,允许大家给形象换皮,可以是狗、猫或一朵花,想扮成什么样都可以。这是 Meta 这种大体量平台能做的事,因为它可以从 Day One 起就用铺天盖地的传播,让那个「大白娃娃」的形象深入人心。之后每个人再个性化,也不太会稀释品牌资产。
mp.weixin.qq.com
33 513
1/ 伟大的战略家偏爱战略可选性(strategic optionality),一方面不想过早剪枝,另一方面也要优化资源。AI 正在做这件事,"保留可选性—展开—反思—剪枝"的探索本身就极耗算力
2/ 去年最大的解锁是大模型的外骨骼,记忆与工具使用,从工作记忆(working memory)到短期、再到长期记忆,进而形成知识图谱(knowledge graph),就像人类思考"我学到了什么、它如何嵌入我已有的全部知识"。"人类睡觉时会做压缩(compaction):不重要的慢慢忘掉,重要的被重新连接起来。"于是有了工作记忆 + 离线的知识抽取与知识图谱构建
3/ 许多学科正处在临界点,只要把 AI 的穷尽式探索(exhaustive exploration)叠加到既有成果上,就会一个接一个地快速突破。但这需要大量算力,因为很多突破真正缺的,是对巨大搜索空间(search space)的海量探索。比如纳维-斯托克斯方程(Navier-Stokes equations)描述流体(水、空气、血液……)如何流动,是流体力学的基石
4/ 每个触及物理世界的行业,都会重新变成科技公司 / AI 公司,比如Elon 如何把汽车业变成了本质上的计算产业
5/ 电力越稀缺,世界越会转向每瓦产出最高的 NVIDIA。当全球可用电力 / 功率变少时,客户会把选择转向"最具生产力"的版本——最可出租(rentable)、最可互换(fungible)、最耐久(durable)
6/ 上游也在收紧:
1) 基板(substrate):封装越做越大、单颗芯片用料更重,这些有机材料在所需精度下极难制造——封装变大后,热系数、堆叠方式让翘曲(warpage)等制造缺陷更难控制,必须极其精密、需要顶级伙伴;
2) 硅光子(silicon photonics):同样供给受限
7/ 在 NVIDIA 的报表里,Elon 已从"企业(Enterprise)"归类挪到"CSP"。
Elon 相当独特:同时做三件事: 用 NVIDIA 技术训练并部署自己的 AI 模型(Grok bot 很酷、消耗量正在飙升)、并把算力对外出租(这点与 Google 类似)。Elon 还有一个优势,热爱"计算与物理基建的交叉点",没有人比 Elon 更懂能源
8/ 只有 NVIDIA 的算力适合上太空:NVIDIA 单位能量的性能(performance per watt)世界第一,但更重要的是算力的生产力 / 投资回报极高,高到即便算上火箭发射成本,ROI 依然极好。发射成本并非微不足道,所以不会把低价值算力送上去,而要送高价值算力
9/ 太空算力还需满足可互换(fungible):若一颗卫星没有租户就会闲置。NVIDIA 算力在工作负载、模型、客户之间完全可互换,且耐久(durable)——"八年前付的钱,我们今天还在给你更新软件、更新算法。只要卫星还在天上,我们就一直更新 CUDA 软件。"可互换 + 可出租 + 耐久,叠加技术本身,使其成为 SpaceX 的"完美载荷"
10/ NVIDIA 的计算大致分三块:
1) 基础计算(约 1/3):数据处理、分子动力学、物理 / 聚变 / 裂变仿真、量子化学 / 物理、计算机图形,以及经典机器学习(Visa / Mastercard 的 XGBoost 反欺诈、推荐系统等)。假设完全没有 AI,NVIDIA 仍是一家很大的公司。这块仍以 30–40%/年增长。
2) 前沿实验室(约 1/4–1/3):人们只看到两家,但 NVIDIA 与每一家都合作——他能数出五六家(Meta 的 Metamuse 做得很好、Grok 三年前还不存在、如今也在跑 Gemini、今年开始与 Anthropic 合作)。
3) 新一代创业公司 / Neocloud / 企业(约 1/3):正值新计算平台切换的开端,大量初创涌现(消费、物理 AI、生物 AI、材料科学 AI,还有 Jeff Bezos 的新公司 Prometheus 等)——"它们做什么?租 NVIDIA 算力。"这约等于下一代的云计算 / 面向未来的 AWS
11/ "每 GW 产出约 400 亿美元"推演:若明年上线 40 GW、每 GW 产出 400 亿,就是 1.6 万亿美元收入——但现实不这么线性,要看需求曲线与扩散(diffusion)速度。
市场的担忧是:供给上得比需求快,可能在某个时点迎来"泡沫破裂",因为 AI 的进展更像"阶梯函数"而非一路陡升的抛物线。黄仁勋的回答是"回到第一性原理拆解":人们试图外推的"约 1,000–1,250 亿美元 ARR"只是整个基建的一部分。
他给出几条支柱: 基础计算那一块(约 1/3)稳稳的——"人们还会继续网上购物吧?这块拿去存银行都没问题,根本不用争。" 摩尔定律已经结束:过去想要晶体管翻倍,等一年、同样价格就有了;现在不管等多久,想要翻倍就得付两倍的钱。
所以无论世界想要多少算力,每年要翻倍,就得多花一倍——这等于给原本就自然增长的那半万亿美元支出乘上一个放大系数(X factor)。"就算没有 AI,半导体业本来也在通往'全球最大产业'的路上。"
12/ 老黄认为很少见到共识错得像此时此刻这么离谱,把英伟达的收入和自由现金流预测几乎翻了一倍,股价却只涨了约 20%,现在只按 13–14 倍市盈率交易。英伟达的护城河是在变宽:
- 一是 份额在涨,六年前 NVIDIA 占全球 CapEx 还是个位数百分比;如今在全球 CSP 里约占 40%,在 CSP 之外(本地部署、Neocloud)约占 80%——两块业务都在每年翻倍,所以占全球 CapEx 的美元份额仍在增长
- 二是每 GW 能卖的东西也在涨:从GPU 公司到"最大、增长最快的网络公司",再到"最大的 CPU 公司之一(且增长最快)",还扩展到存储计算、知识基础设施计算、以及安全(Open Shell、Sentry)。每 GW 的产品价值从约 180 亿→200 多亿→如今 400 亿美元以上,且仍在上行。所以英伟达的份额上涨有两重原因:一是客户转向NV的平台,二是NV对每一 GW 提供的东西越来越多
13/ NVIDIA 坚持通用(general purpose)的核心理由是为了可互换性(fungibility):可互换性的好处是低风险。当你在下大单、建 500 亿到1,000 亿美元基础设施时,你必须确信它无论如何都能长期好用。所以专用化是可互换性的敌人,专用化是耐久性的敌人。他给出那条著名的链条:通用性 = 低风险 = 可出租 = 可融资 = 最低 TCO
14/ 关于泡沫何时破(老黄此前在另一档节目回答过"约两到三年"的能见度),老黄的框架是:这本质上是对全球所有算力的一次永久性重构(re-architecture)。除非出现全球性大萧条,否则每年都要消耗巨量 NVIDIA 算力。过去 CSP 每年建设约半万亿、全行业约一万亿美元;每年都在新建,约每五年有一部分折旧 / 下线。旧世界是调取式(retrieval)'的计算,新世界是另一种计算方式,是永久性重构,问 AI 一个它没见过的问题 → 它不是去哪儿'翻出'标准答案,而是用神经网络现算一个全新的回答,让模型做展开—反思—剪枝。
17 04
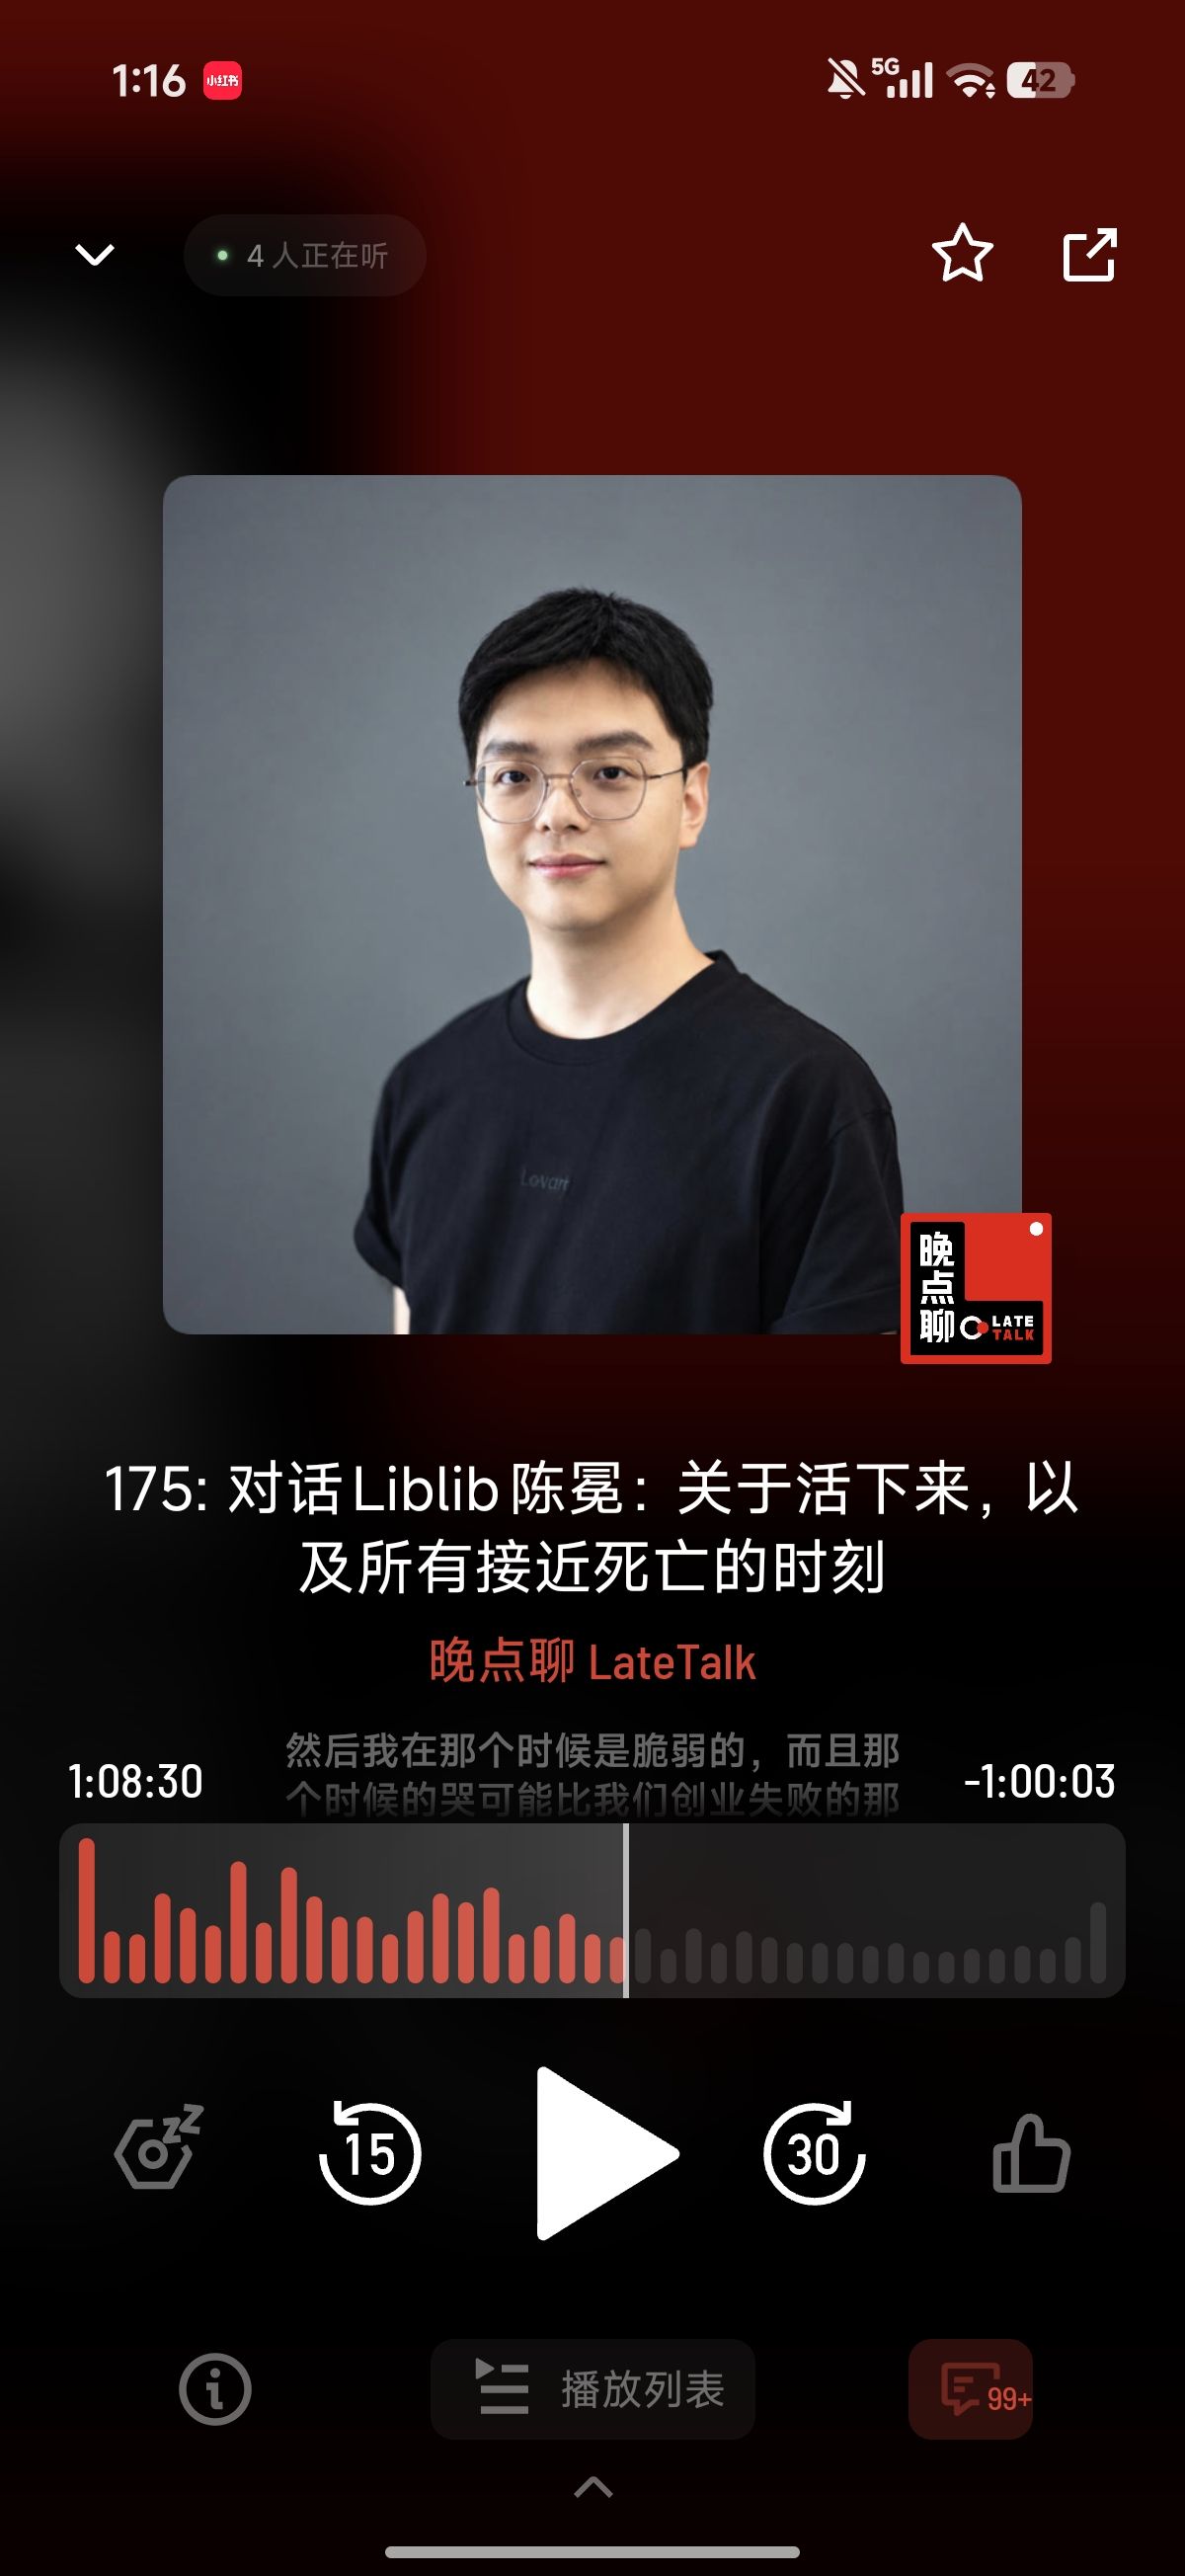
晚上睡前打算听点深度内容辅助入睡,想起@董慧hui 说,这一期聊了七个小时,非常深度,也想学习下小晚的访谈,点开了Liblib这一期。
结果我听了一个小时越听越清醒,还笑喷了: “有两个人给我们说你的口头禅是做不了就滚”,“半夜打电话给顺为的投资人哭”,“产研团队后院起火”。
结果我听了一个小时越听越清醒,还笑喷了: “有两个人给我们说你的口头禅是做不了就滚”,“半夜打电话给顺为的投资人哭”,“产研团队后院起火”。
12 21