即刻App年轻人的同好社区
下载
Barret李靖
171关注12k被关注12夸夸
编程领域优秀贡献者
AI Engineer | Lifelong learner | Cloud Native | Dad of 2
小胡子哥,一个有趣的灵魂
小胡子哥,一个有趣的灵魂
研究了一下过去几年芯片和算力的供给情况。目前,市场上大约有 2000 万张 H100 等效卡的算力。按 Token 计算,年消耗量已经达到几十万亿亿 Token,相比去年增长了接近一个数量级。
过去三年,AI 芯片的算力供给每年大约增长 3 倍。但考虑到卡的数量增加、单卡性能提升,以及推理效率不断优化,实际能够对外提供的 Token 算力,年增长幅度可能接近 10 倍。
从 Chat 到 Coding,再到 Agent,每次产品形态升级,都会带来一轮新的需求增长。早期的 Chat,一次推理可能只需要几千 Token;到了 Coding,用户通过 Agent 完成一项任务,一次可能消耗几十万到几百万 Token;而 Agent 需要处理更长的上下文、调用工具,并进行多轮推理和验证,复杂任务的消耗可能达到千万甚至上亿 Token。
按照这个趋势,未来 Token 的需求大概率仍会保持指数级增长。那市场上会不会出现 Token 供不应求的情况?答案是会,而且现在其实已经长期处于紧平衡状态。需求突然上升时,市场通常会通过价格和延迟来调节:高价模型先涨价,低价模型则出现排队,同时也会有更多算力从训练逐步转向推理。
Token 的供给可以从四个层面来看:
1)电力和数据中心。这是最慢的一层。一个大型数据中心从电力指标、选址建设到最终投产,通常需要两三年。
2)芯片供给。Nvidia、Google、AMD 等厂商都在持续扩大产能,同时新一代芯片的性能也在不断提升。
3)模型和推理效率。同样一张卡,通过量化、缓存、推测解码等技术,可以生成更多 Token,单位算力的产出还会继续提高。
4)算力分配。目前仍有大量算力用于训练、RL 和各种实验。随着推理需求继续增长,部分存量算力会逐步从训练转向对外提供 Token。
从这个角度看,未来的 Token 可能会越来越像今天的电力和带宽。算力供给每增加一轮,很快就会有新的应用把这部分增量消耗掉。Chat 吃掉了第一波,Coding 吃掉了第二波,接下来 Agent 还会继续消耗新增的算力。
过去三年,AI 芯片的算力供给每年大约增长 3 倍。但考虑到卡的数量增加、单卡性能提升,以及推理效率不断优化,实际能够对外提供的 Token 算力,年增长幅度可能接近 10 倍。
从 Chat 到 Coding,再到 Agent,每次产品形态升级,都会带来一轮新的需求增长。早期的 Chat,一次推理可能只需要几千 Token;到了 Coding,用户通过 Agent 完成一项任务,一次可能消耗几十万到几百万 Token;而 Agent 需要处理更长的上下文、调用工具,并进行多轮推理和验证,复杂任务的消耗可能达到千万甚至上亿 Token。
按照这个趋势,未来 Token 的需求大概率仍会保持指数级增长。那市场上会不会出现 Token 供不应求的情况?答案是会,而且现在其实已经长期处于紧平衡状态。需求突然上升时,市场通常会通过价格和延迟来调节:高价模型先涨价,低价模型则出现排队,同时也会有更多算力从训练逐步转向推理。
Token 的供给可以从四个层面来看:
1)电力和数据中心。这是最慢的一层。一个大型数据中心从电力指标、选址建设到最终投产,通常需要两三年。
2)芯片供给。Nvidia、Google、AMD 等厂商都在持续扩大产能,同时新一代芯片的性能也在不断提升。
3)模型和推理效率。同样一张卡,通过量化、缓存、推测解码等技术,可以生成更多 Token,单位算力的产出还会继续提高。
4)算力分配。目前仍有大量算力用于训练、RL 和各种实验。随着推理需求继续增长,部分存量算力会逐步从训练转向对外提供 Token。
从这个角度看,未来的 Token 可能会越来越像今天的电力和带宽。算力供给每增加一轮,很快就会有新的应用把这部分增量消耗掉。Chat 吃掉了第一波,Coding 吃掉了第二波,接下来 Agent 还会继续消耗新增的算力。
14 22
从公司 IT 学到一个冷知识,Mac 长期不关机,MagSafe 插口容易出现疑似接触不良甚至充不进电的问题。
另外一个冷知识,关机 30s 以后重试,可以解决这个问题。
查了下原理,关机等待 30s,会让 Mac 的电源管理相关电路充分掉电、硬件残余状态被清除,从而让充电控制器在下次上电时重新初始化。😃
另外一个冷知识,关机 30s 以后重试,可以解决这个问题。
查了下原理,关机等待 30s,会让 Mac 的电源管理相关电路充分掉电、硬件残余状态被清除,从而让充电控制器在下次上电时重新初始化。😃
32 42
Team 的运转离不开三类人。第一,能够持续去定义问题,做什么,不做什么。第二,对结果负责的 owner,他能够牵引团队,以正确的方式拿到结果。第三,领域专家,他的技能是确保团队在复杂任务之下,依然可以良好运转。AI 很容易让这三类特性同时落在一个人头上,因此出现了大量的超级个体、OPC。
30 21
OpenClaw 凉了么?从 Star 趋势来看,差不多了,社区讨论热度也几乎没有了。
但从 PR、Issue 等贡献来看,还是相当活跃的。它已经从一个全民围观的现象级项目,退回成了一个大型 Agent 开源基础设施项目。
玩 🦞 的人,基本都是各种 Skills、Memory、Tools 折腾一遍,然后就会面临一个灵魂拷问:“所以我到底每天让它干嘛?”
如果没有稳定、高频、可衡量的任务,Agent 就会从生产力工具退化成一个昂贵的电子宠物。
OpenClaw 当前的命运,已经是从个人生产力场景走向企业严肃办公场景,重新挖掘它在企业里的价值。
但从 PR、Issue 等贡献来看,还是相当活跃的。它已经从一个全民围观的现象级项目,退回成了一个大型 Agent 开源基础设施项目。
玩 🦞 的人,基本都是各种 Skills、Memory、Tools 折腾一遍,然后就会面临一个灵魂拷问:“所以我到底每天让它干嘛?”
如果没有稳定、高频、可衡量的任务,Agent 就会从生产力工具退化成一个昂贵的电子宠物。
OpenClaw 当前的命运,已经是从个人生产力场景走向企业严肃办公场景,重新挖掘它在企业里的价值。
23 53
当看到一条充满不确定性的路时,脑子里总会先预演一遍,走下去可能会遇到什么问题,最后又会是什么结果。
觉得简单,容易失去兴趣。觉得太难,又不愿承担风险。结果就是,还没真正经历,就已经放弃,最后原地踏步。
后来想想,有些路,不亲自走一遭,又怎么知道会遇见什么。真正去活一次,去看看生活究竟会发生什么,😄
觉得简单,容易失去兴趣。觉得太难,又不愿承担风险。结果就是,还没真正经历,就已经放弃,最后原地踏步。
后来想想,有些路,不亲自走一遭,又怎么知道会遇见什么。真正去活一次,去看看生活究竟会发生什么,😄
21 00
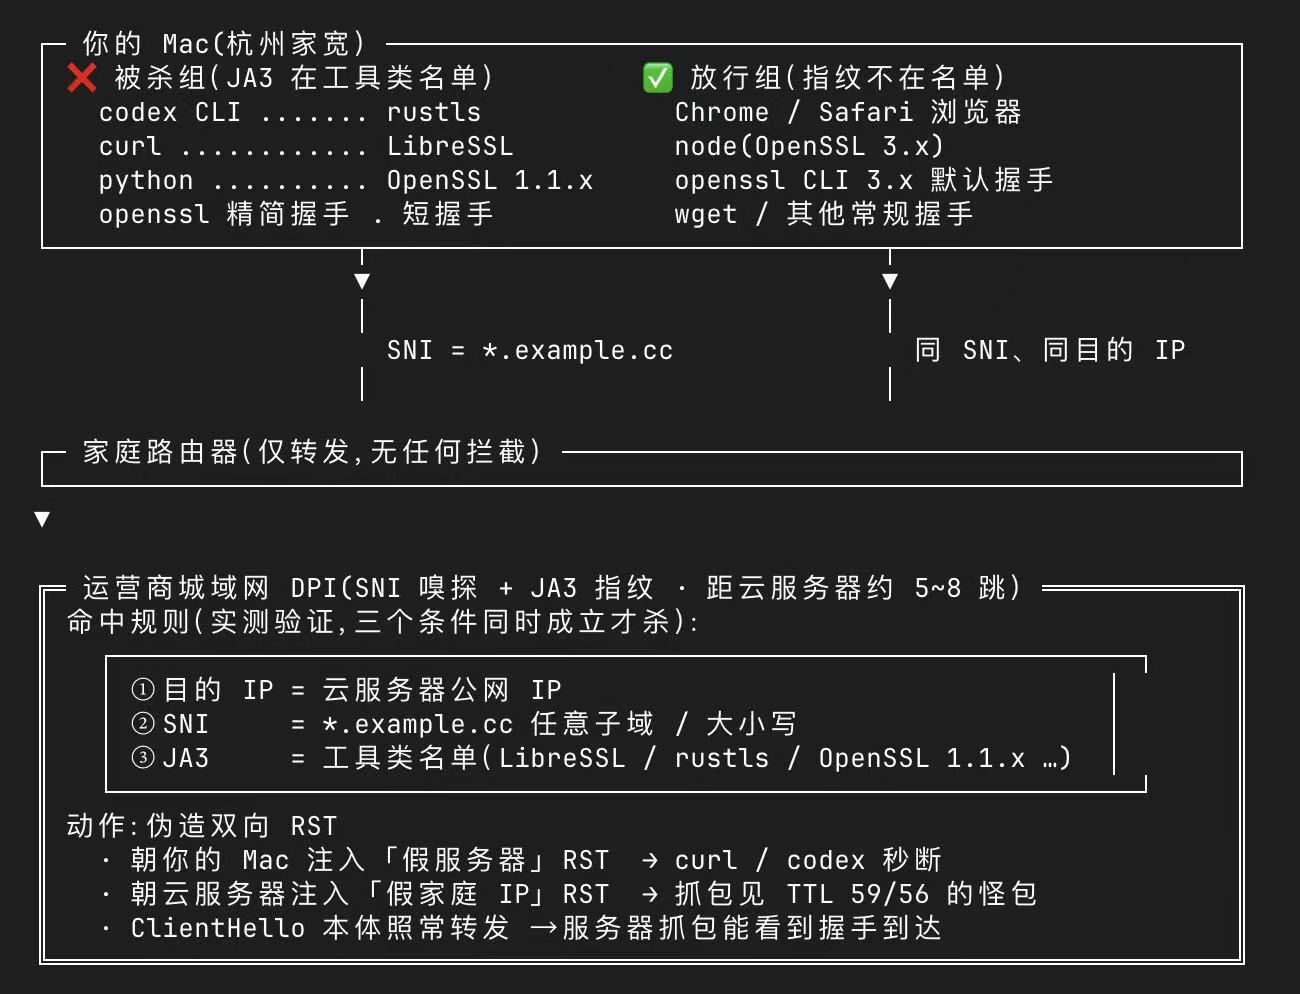
发现一个有意思的现象,运营商会在城域网部署策略,精准拦截中转站的流量。难怪最近在家 codex 总是连不上。
具体表现是,从中转站服务器看日志,发现是客户端主动断连( client prematurely closed connection),客户端看报错是服务端主动断连(server reset)。实际上是中间网络环节伪造了报文,分别给服务器和客户端注入了 RST。
命中策略:codex/cc 发出的请求指纹 + 部署在云服务器的 IP + SNI 嗅探识别是中转站域名。
具体表现是,从中转站服务器看日志,发现是客户端主动断连( client prematurely closed connection),客户端看报错是服务端主动断连(server reset)。实际上是中间网络环节伪造了报文,分别给服务器和客户端注入了 RST。
命中策略:codex/cc 发出的请求指纹 + 部署在云服务器的 IP + SNI 嗅探识别是中转站域名。
12 04
AI 擅长处理结构化的内容,未来一切能够被结构化的知识工作,都将被 AI 取代。
自然语言就是一种对表达的高度抽象和结构化,编程语言更是如此,这也是为啥程序员首当其冲🐶
把注意力转移到如何做信息的数字化、结构化和智能化上,同时围绕 AI 构建合适的流程、工具和服务,那结果就不是取代,而是转型。
自然语言就是一种对表达的高度抽象和结构化,编程语言更是如此,这也是为啥程序员首当其冲🐶
把注意力转移到如何做信息的数字化、结构化和智能化上,同时围绕 AI 构建合适的流程、工具和服务,那结果就不是取代,而是转型。
19 22
在 AI 转型面前,所有人都是从零开始,这是最大的公平。但一定有人跑得更快,也有人开始掉队,甚至迷路,后者缺少的往往是一个好的环境和良善的指引。
我的建议是,持续去找比当下环境更 AI Native 的工作模式、工作伙伴和工作氛围,融入进去,学会主动为自己营造环境。
我的建议是,持续去找比当下环境更 AI Native 的工作模式、工作伙伴和工作氛围,融入进去,学会主动为自己营造环境。
51 33