即刻App年轻人的同好社区
下载
 置顶
agent时代我们都在狂飙突进生产力跃升,那长辈们呢?
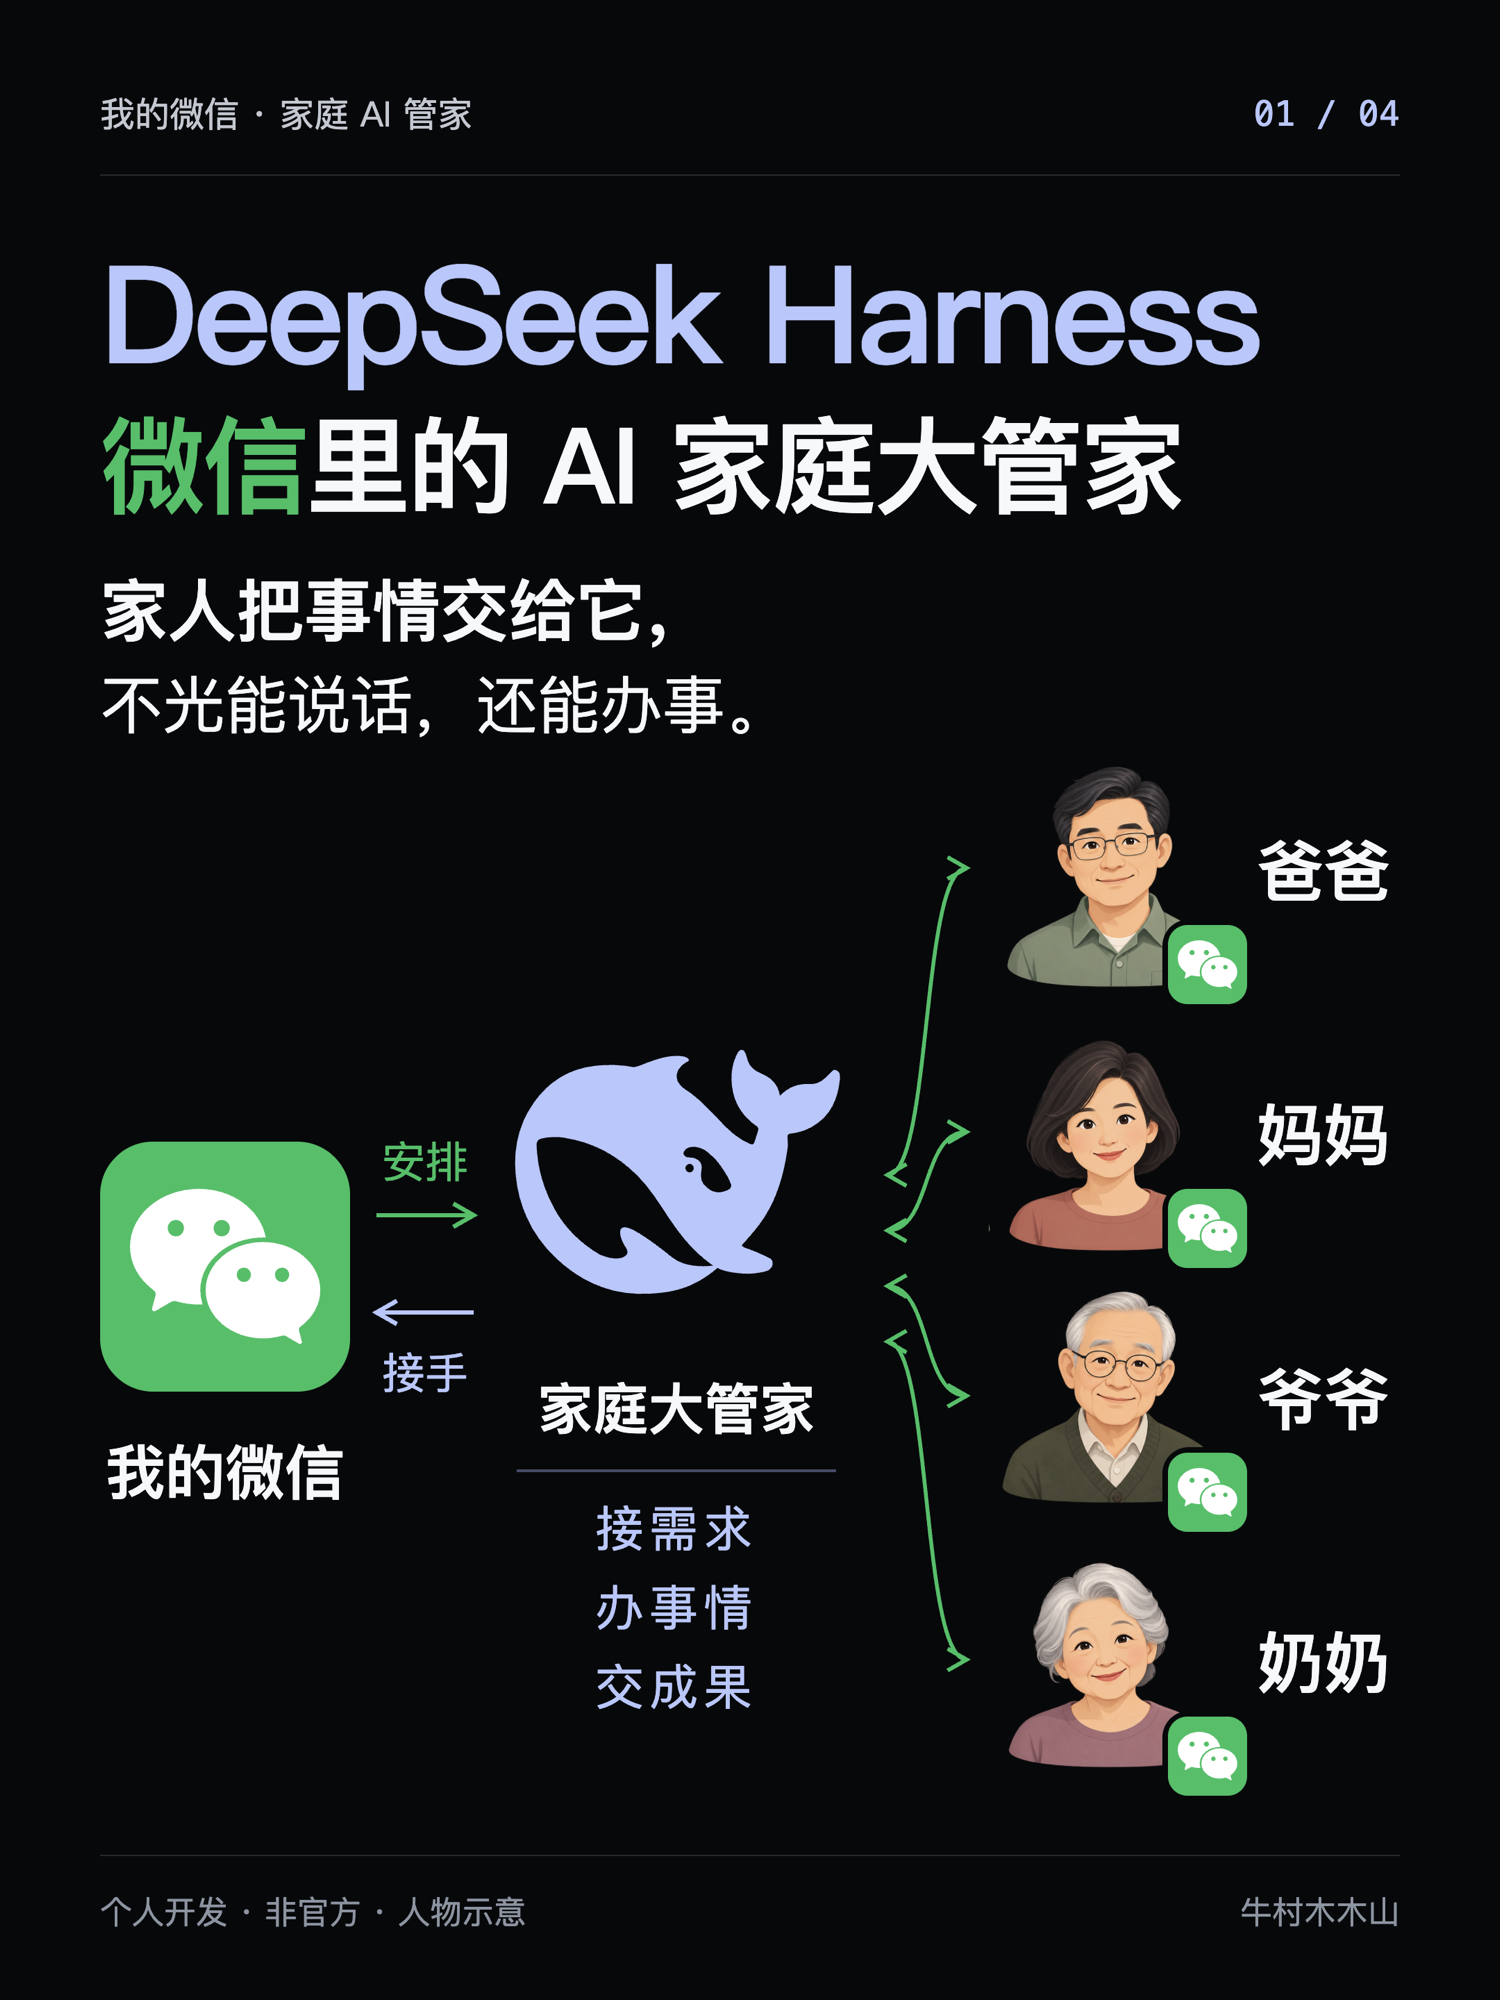
他们也不止需要和豆包聊天,他们其实也需要各种有能力的agent去服务,但让长辈们去自己搭建迭代agent还是太难为他们了,那为啥不做一个云端共享版呢,把自己搭好的agent直接通过微信接入给长辈家人们,做他们的微信大管家,不仅仅是陪聊,日报、提醒、健康观测、文件各种生产力场景他们也都可以用,还可以居中帮我去照看并且及时提醒我,我只需要持续去升级这个“agent微信管家”就好,同时它也可以实时长辈们的需求自我迭代。
---
大管家叫“乐乐”,后台跑在 DeepSeek Harness 上。我在电脑上安装,准备资料和工具,再按每个人的需要分配。家人各自扫码连接微信后,就能直接提需求,也能提出我没提前安排过的新事情。
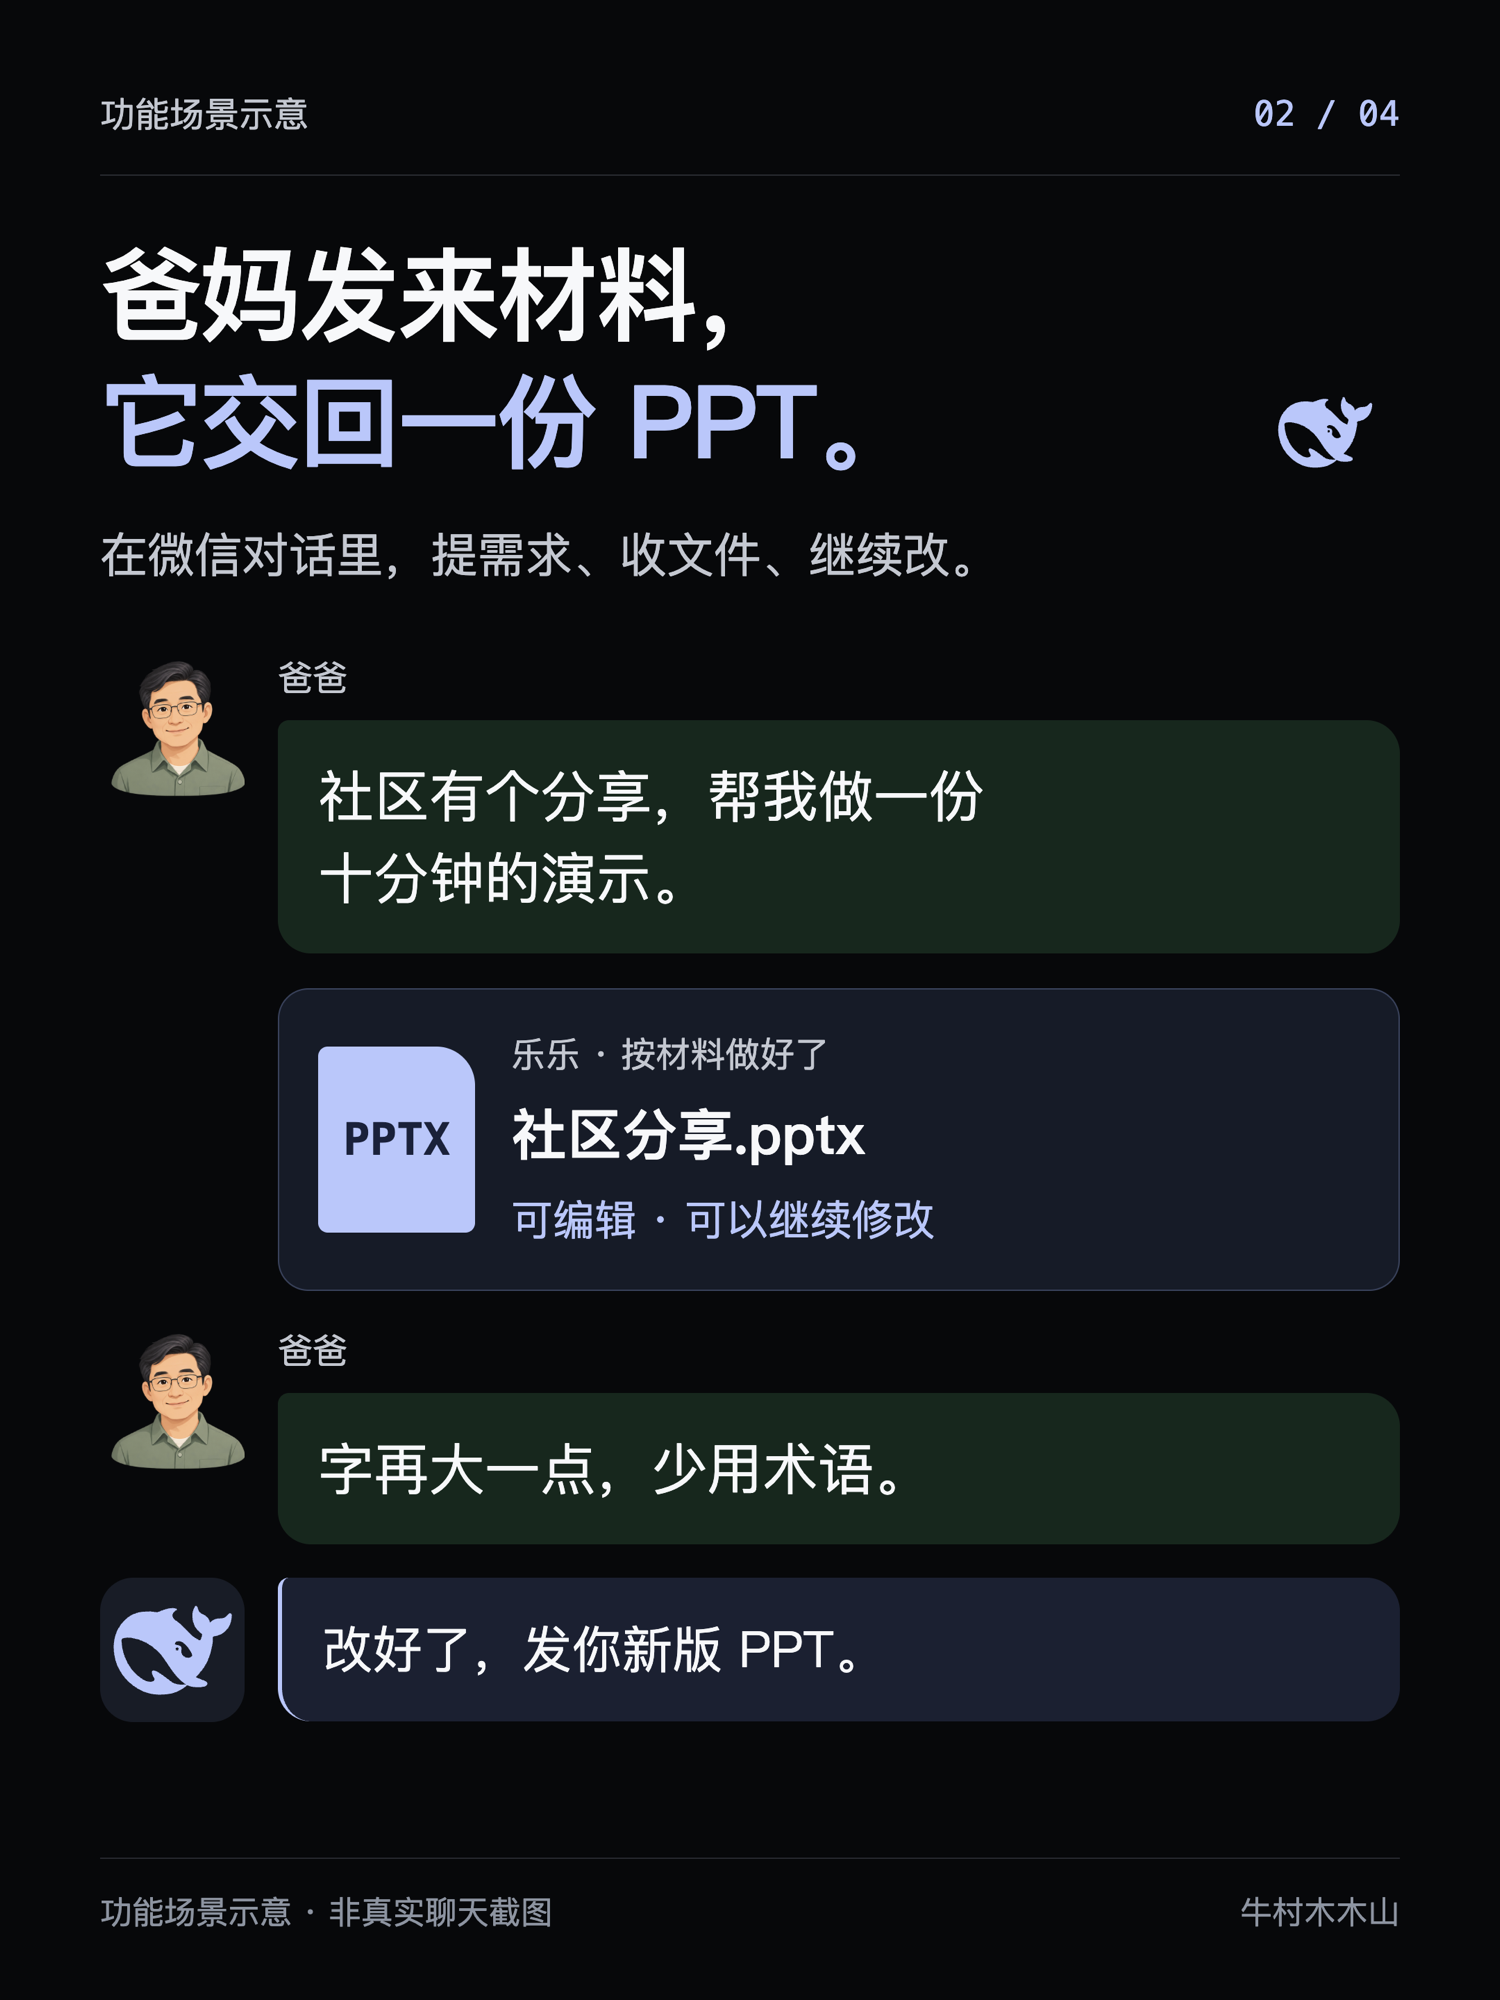
比如这样一个场景:爸爸准备去社区做分享,把材料发给乐乐:“帮我做一份十分钟的演示,给街坊们讲。”
乐乐整理材料,做出可编辑的 PPTX 发回来。爸爸觉得字太小、术语太多,就在微信里说:“字再大一点,讲得通俗些。”它再修改,交回新版。
家人可以把事情交出去,拿到成果,不合适还能接着改。
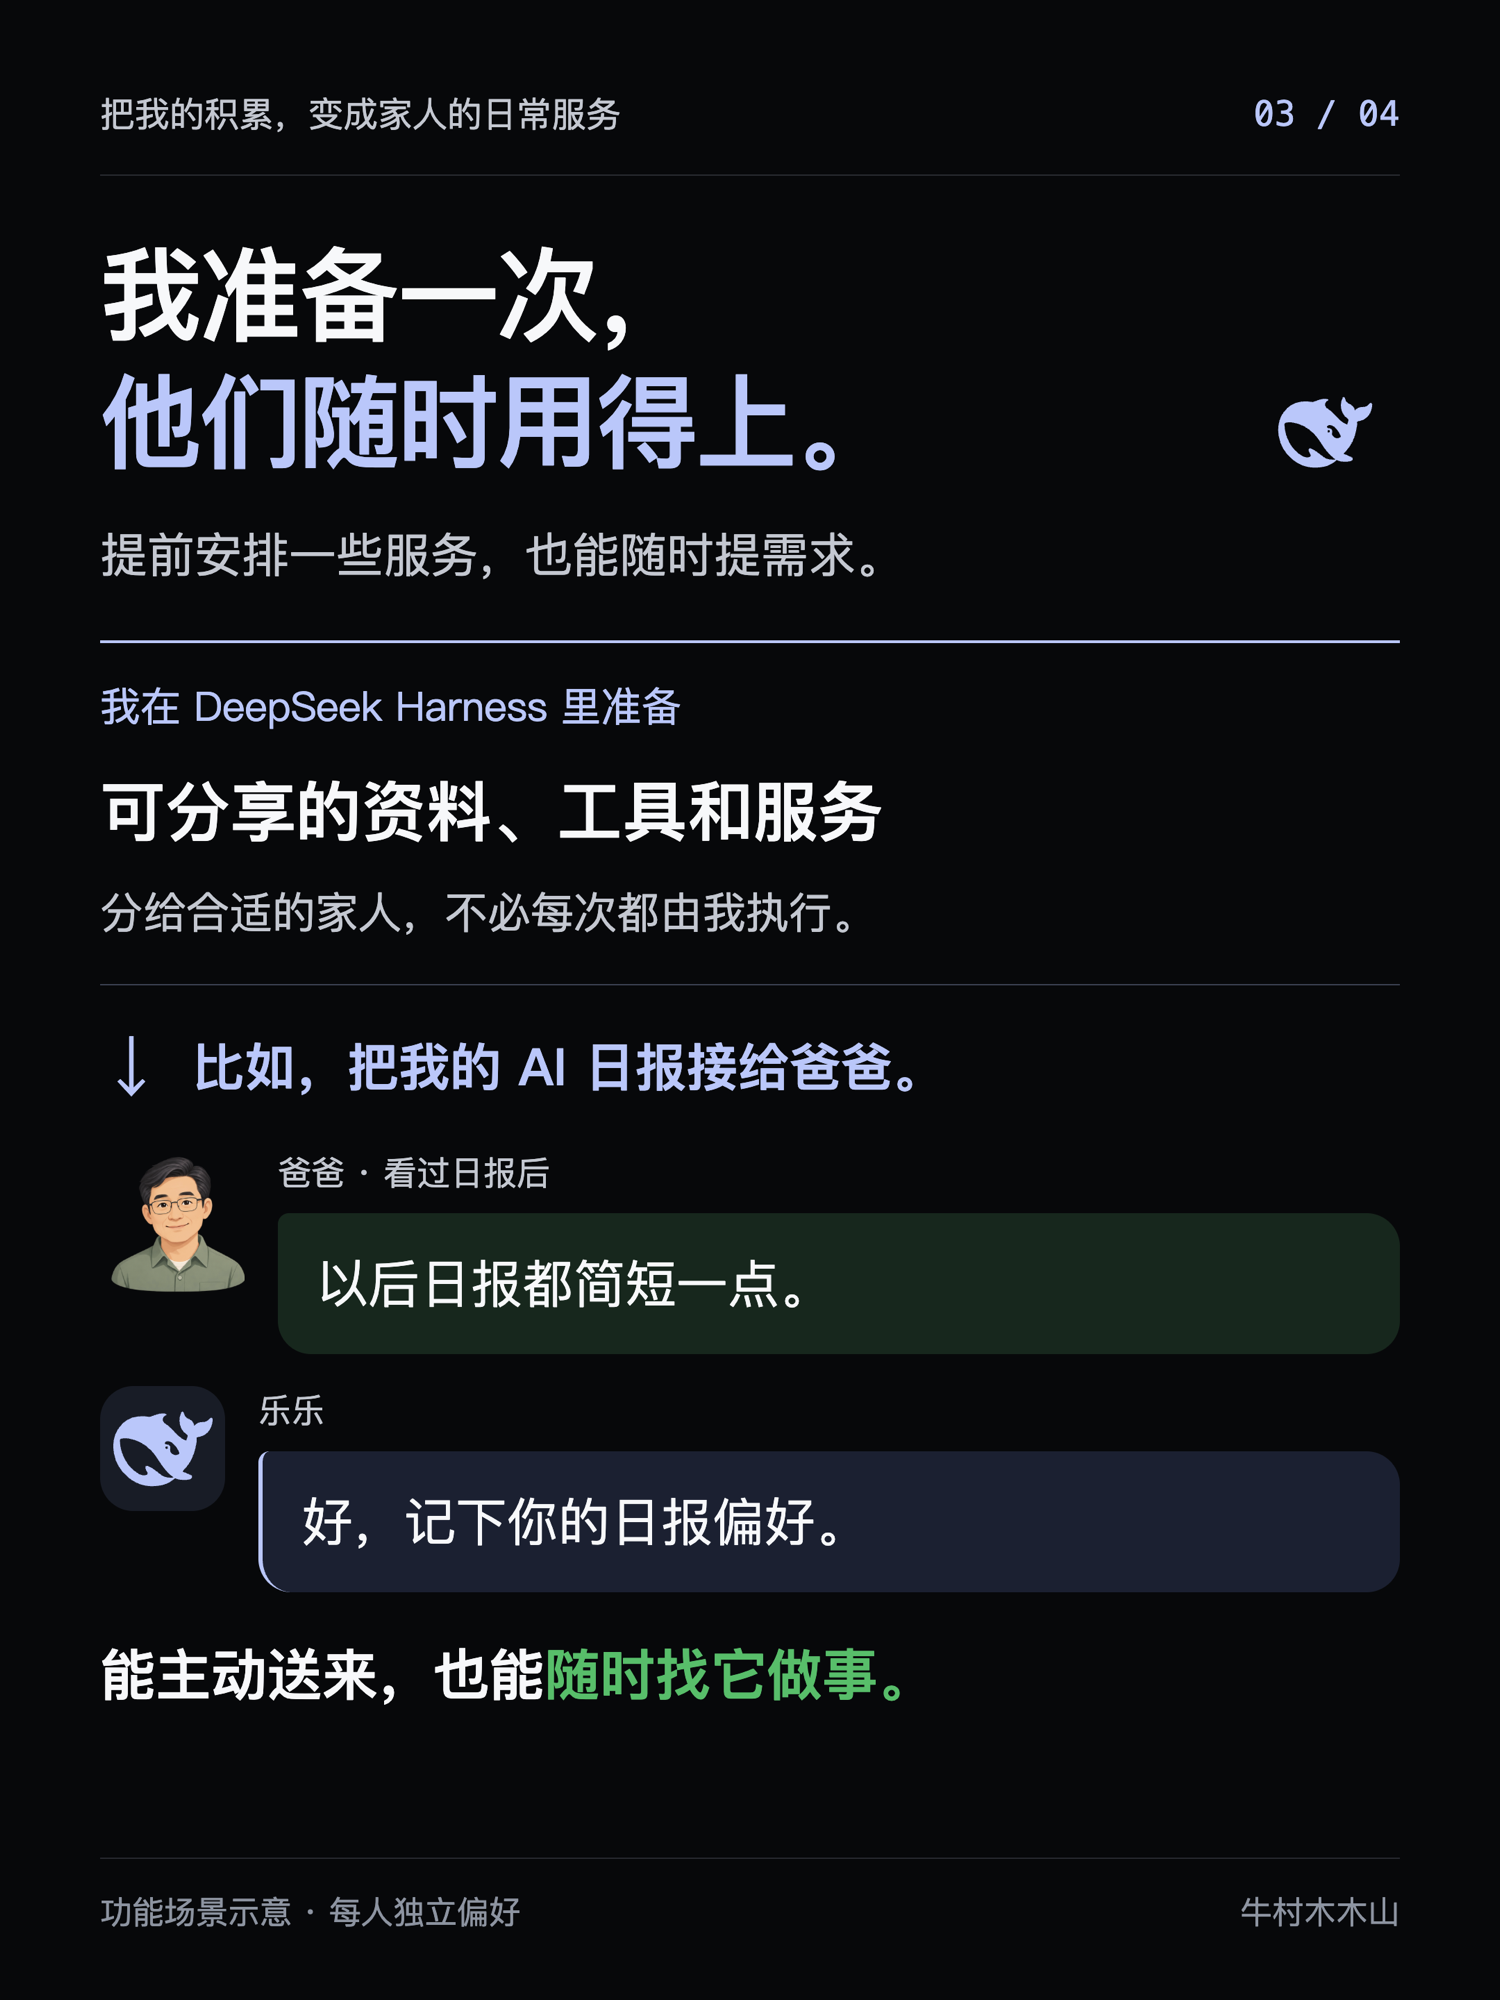
我也可以提前安排日报、提醒。家人觉得日报太长,可以直接说“以后日报都简短一点”,让它记下偏好,也能随时找它做别的事。
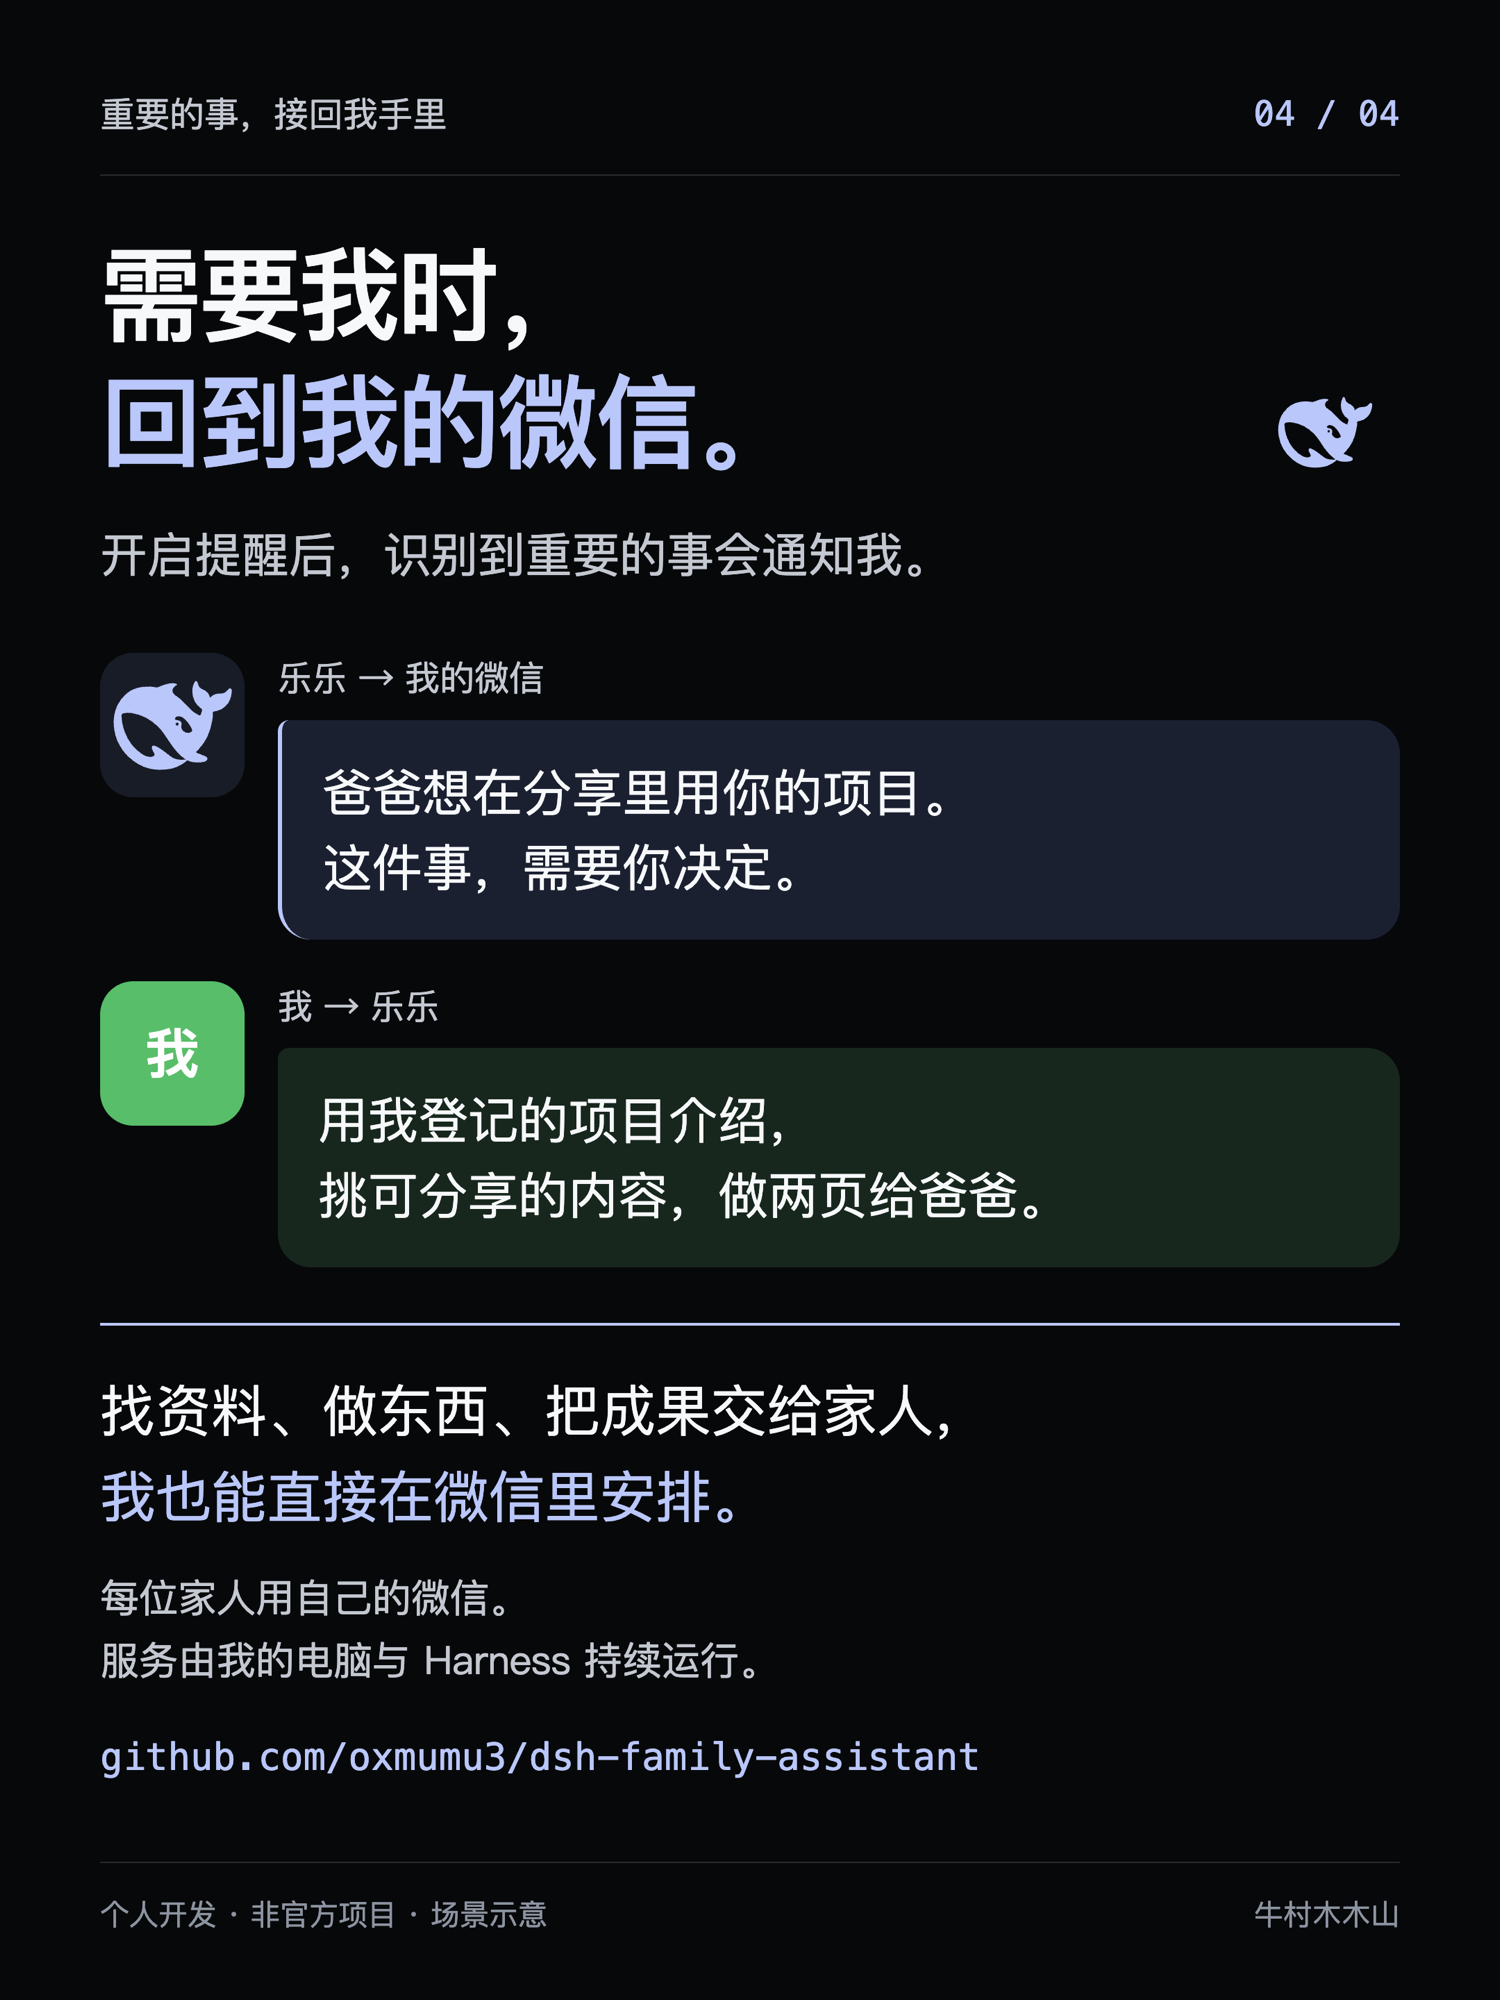
打开重要事项提醒后,乐乐识别到需要我关注的事,会在微信提醒我。它不一定识别到每件事,家人也可以主动请它转告。我回复“我来处理”,或交代它把答复带回去,就能接着处理。我也可以让它查电脑里授权的项目资料、整理内容,再交给指定的家人。
每个人用自己的微信,聊天和偏好分开处理;我的资料只在授权范围内使用。作为管理者,我能查看本机保存的家庭对话记录,这一点也应该提前和家人说清楚。
我想要的,是家人遇到事情时,有个熟悉的入口能先帮上一把;需要我的时候,我们仍然能在微信里把事情接起来。
想试的朋友,两步安装最新版:
1. 在 DeepSeek Harness 新建会话,点顶部「标准模式」下拉,选「创造模式」。
2. 粘贴下面这句话,弹出授权时点「允许」:
请通过插件管理器,从 npm 官方源安装并启用 @oxmumu3/dsh-family-assistant@latest;保留已有的家人资料和微信绑定。完成后请核对版本和启用状态,再带我打开左侧「家庭助手」完成设置。
---
个人开发,非官方项目。
牛村木木山 / oxmumu3
github.com
他们也不止需要和豆包聊天,他们其实也需要各种有能力的agent去服务,但让长辈们去自己搭建迭代agent还是太难为他们了,那为啥不做一个云端共享版呢,把自己搭好的agent直接通过微信接入给长辈家人们,做他们的微信大管家,不仅仅是陪聊,日报、提醒、健康观测、文件各种生产力场景他们也都可以用,还可以居中帮我去照看并且及时提醒我,我只需要持续去升级这个“agent微信管家”就好,同时它也可以实时长辈们的需求自我迭代。
---
大管家叫“乐乐”,后台跑在 DeepSeek Harness 上。我在电脑上安装,准备资料和工具,再按每个人的需要分配。家人各自扫码连接微信后,就能直接提需求,也能提出我没提前安排过的新事情。
比如这样一个场景:爸爸准备去社区做分享,把材料发给乐乐:“帮我做一份十分钟的演示,给街坊们讲。”
乐乐整理材料,做出可编辑的 PPTX 发回来。爸爸觉得字太小、术语太多,就在微信里说:“字再大一点,讲得通俗些。”它再修改,交回新版。
家人可以把事情交出去,拿到成果,不合适还能接着改。
我也可以提前安排日报、提醒。家人觉得日报太长,可以直接说“以后日报都简短一点”,让它记下偏好,也能随时找它做别的事。
打开重要事项提醒后,乐乐识别到需要我关注的事,会在微信提醒我。它不一定识别到每件事,家人也可以主动请它转告。我回复“我来处理”,或交代它把答复带回去,就能接着处理。我也可以让它查电脑里授权的项目资料、整理内容,再交给指定的家人。
每个人用自己的微信,聊天和偏好分开处理;我的资料只在授权范围内使用。作为管理者,我能查看本机保存的家庭对话记录,这一点也应该提前和家人说清楚。
我想要的,是家人遇到事情时,有个熟悉的入口能先帮上一把;需要我的时候,我们仍然能在微信里把事情接起来。
想试的朋友,两步安装最新版:
1. 在 DeepSeek Harness 新建会话,点顶部「标准模式」下拉,选「创造模式」。
2. 粘贴下面这句话,弹出授权时点「允许」:
请通过插件管理器,从 npm 官方源安装并启用 @oxmumu3/dsh-family-assistant@latest;保留已有的家人资料和微信绑定。完成后请核对版本和启用状态,再带我打开左侧「家庭助手」完成设置。
---
个人开发,非官方项目。
牛村木木山 / oxmumu3
github.com
70 2038
我理解的产品经理基本功🤔
换位
一秒钟变成自己产品的小白用户,打破既知魔咒
抽象
复杂系统/现实的本质抽象,比如“电子支付本质是两个id之间的数字转移”
取舍
有限资源时间下的优先级取舍,以及即使无限资源下的品味/判断取舍,比如怎么设计产品的mvp,比如为啥微信不做置底功能,无限堆叠只会出臃肿平庸的产品
换位
一秒钟变成自己产品的小白用户,打破既知魔咒
抽象
复杂系统/现实的本质抽象,比如“电子支付本质是两个id之间的数字转移”
取舍
有限资源时间下的优先级取舍,以及即使无限资源下的品味/判断取舍,比如怎么设计产品的mvp,比如为啥微信不做置底功能,无限堆叠只会出臃肿平庸的产品
17 21
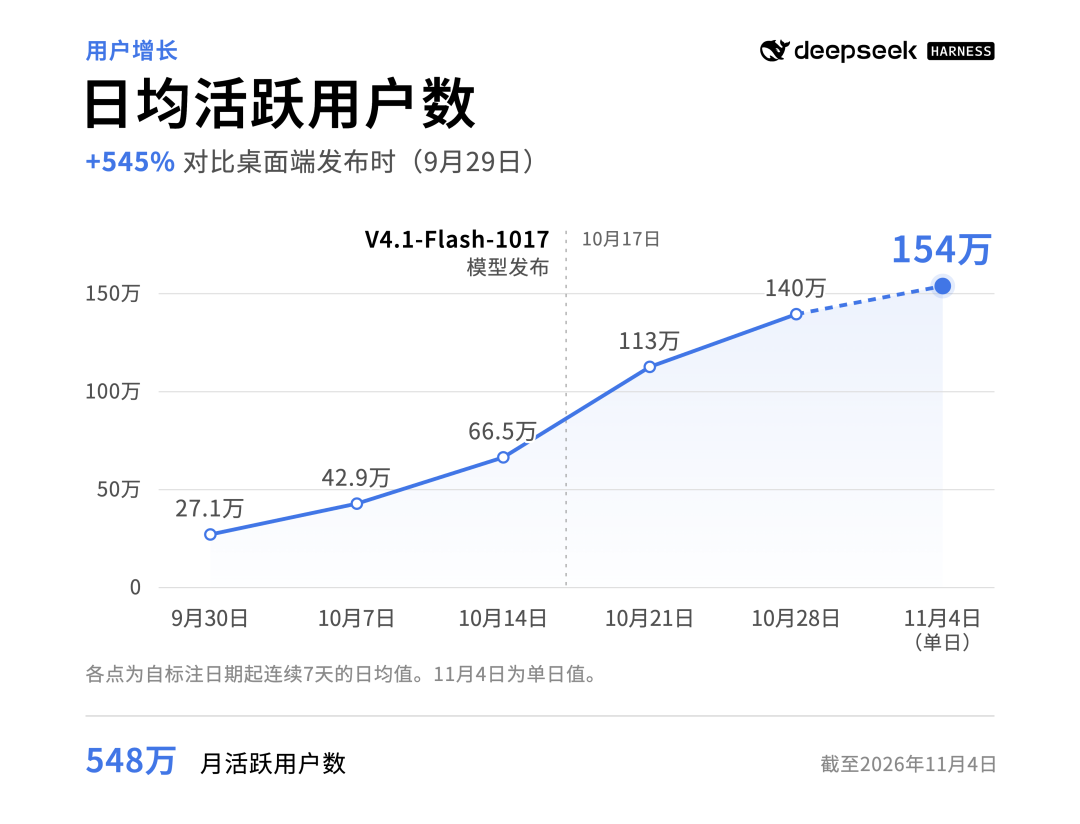
DeepSeek Harness官方正在下场做最累的“物业”和“招商”?隐藏在数据背后的细节,关注两个核心指标
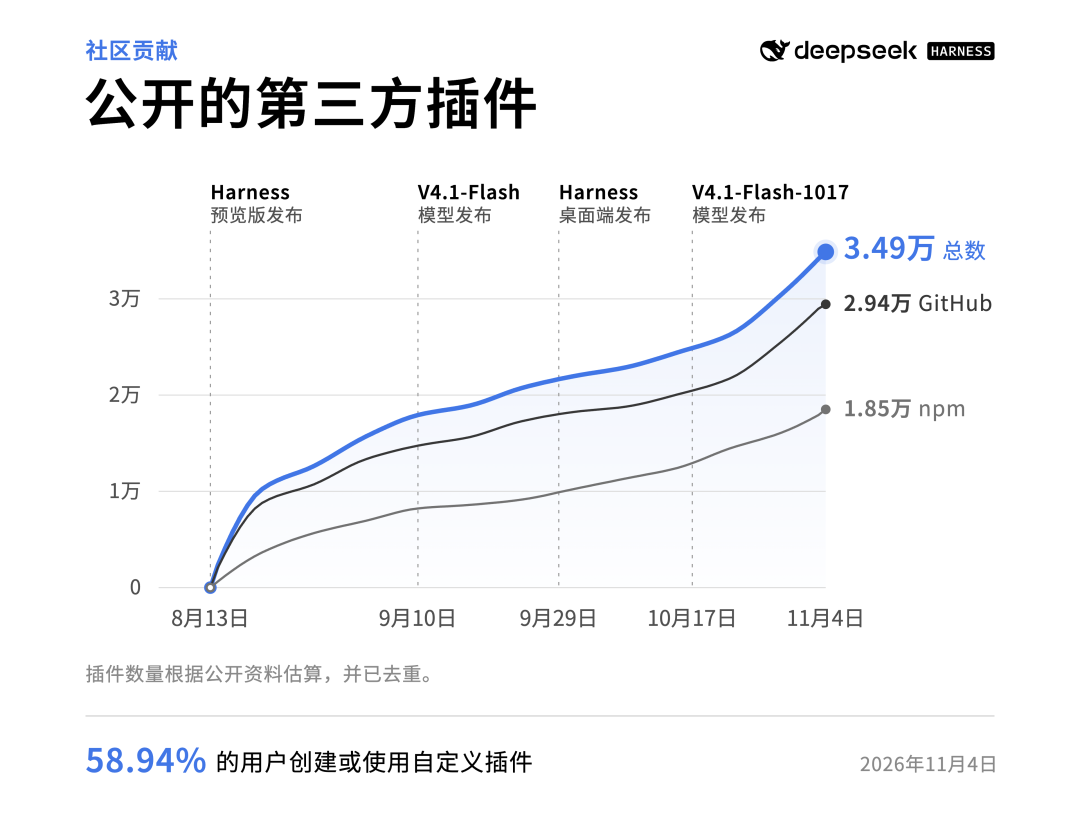
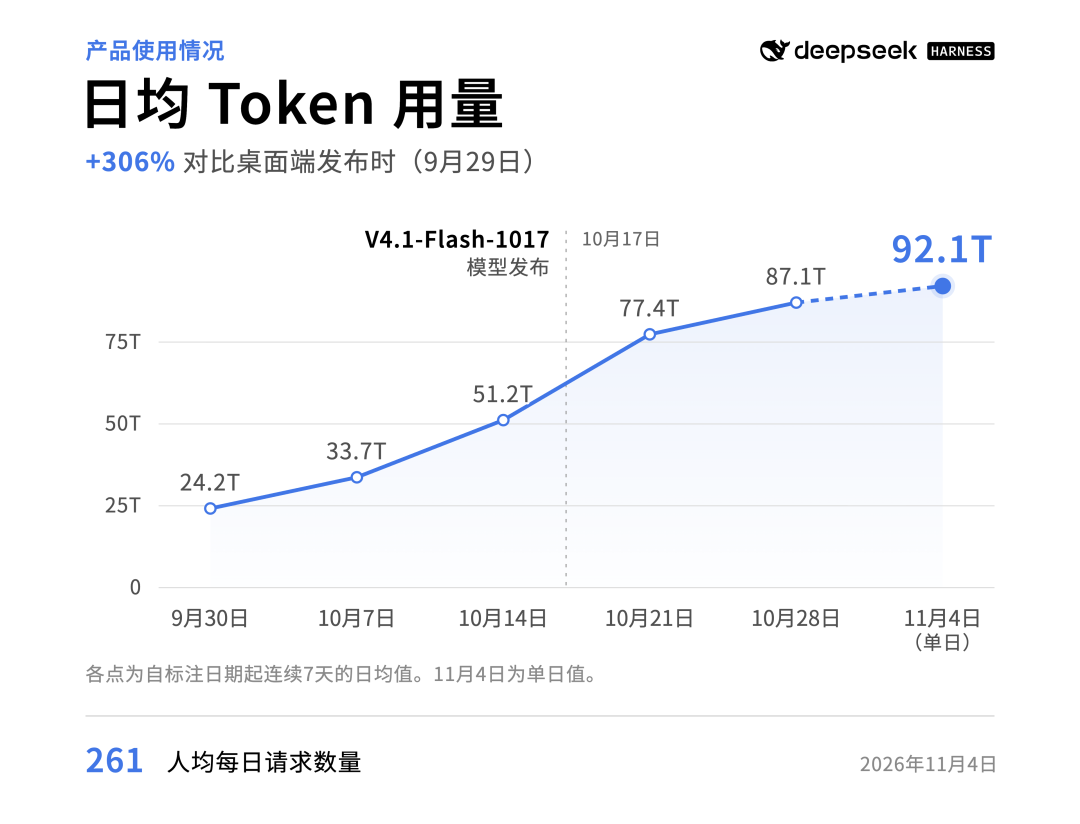
dsh刚公布了最新官方数据:日活 154 万、月活 548 万、日耗 Token 92.1 万亿、公开第三方插件 3.49 万个,约 60% 的活跃用户制作或装过插件。
两周前我扒社区目录里的 7000 个插件时,还拿推特关注数对比 Codex,盲猜它周活大概才 40 万——今天被打脸(而且 154 万日活还只统计了调官方 API 的用户)。
作为一个在 3.5 万个插件里亲手搓过 7 个、踩过一轮升版坑的人,我从官方这三张图和表态里看到的:只交毛坯房的野蛮生长结束了,官方正在下场干最累的“物业和招商”。
先拆三个数据里藏着的细节:
1. 为什么日活一个月暴涨 545%(27.1万→154万),Token 消耗却只涨了 306%(24.2T→92.1T)?
算笔账:
9 月底人均每天烧近 9000 万 Token,基本全是全天候挂机跑代码的重度极客;现在人均降到约 6000 万 Token(日均 261 次请求),说明新涌进来的百万用户开始拿它写稿、做设计、读论文(也可能是有 API 批量任务与交互口径混算,但趋势很明显)——单人任务变轻,恰恰是走出纯程序员圈的信号。
2. 为什么社区市场里只看得到 8700 多个插件,官方去重却有 3.49 万个(GitHub 2.94万 + npm 1.85万)?
因为官方算的是“公开发布过的”,社区导航算的是“被收录的”。
中间差出来的 2.6 万个插件,造出来了却连目录都没进。我在里面做过 7 个插件太有体会了:现在根本不缺人造轮子,而是两万多个插件散在外面没人找得到、也没人知道今天还能不能跑。
3. 官方这次做对了哪三件事?
最亮眼的是排序:把“提升 API 稳定性与兼容性”排在第一顺位,说明官方认下了这笔公共成本(否则平台每发一次破坏性更新,成本全转嫁给用爱发电的作者);紧接着建官方市场、补安全机制、推作者 Token 激励,精选的 4 个案例里 3 个是非编程工作台(自媒体、设计、读论文),还首次喊话“欢迎创业团队和企业通过插件接入产品与服务”。
这跟我们前两篇文章预判的破局方向几乎逐条对上了。
如果顺着官方这套策略再往下深推一层,下半场真正决定成败的其实在于两个转向:
第一,核心指标要从“发了几个、装了几个”,下沉到“活体率”和“用成率”。
3.49 万个插件和 60% 渗透率都在漏斗最顶层,一个是“发过”,一个是“装过”。
但生态健不健康,得往下一层看:
- 供给侧看“量”更要看“活”:
30 天内还在维护的占比多少?作者做完第一个还会不会做第二个?官方提兼容是防未来的病,但存量那 3.5 万个老插件在宿主升版后怎么自动巡检、标注兼容范围或静默迁移?
- 需求侧看“装”更要看“用”:装上后首次任务跑通率多少?30 天后还在复用的留存多少?
- 匹配侧看效率:3.5 万个插件平铺在商店里根本挑不过来。官方市场最该守住的是“已验证兼容 + 安全分级”的信任底线;而前端发现还得靠“在对话里提需求 → 先搜现成好插件 → 能拼就拼 → 缺的再让创造模式造”(这也是我做「发现好插件 2.0」跑的逻辑)。
第二,商业与激励要分清“补成本”还是“奖价值”,别让 Token 激励变成奖励“谁更费 Token”。
生态不同阶段该用不同手段:冷启动降开发门槛,成长期靠兼容契约和验证降交付成本,成熟期靠分成和企业服务让维护有回报。
官方这次提的 Token 激励本质是研发成本补贴,但如果按消耗量发,很容易奖励长上下文、高消耗的插件,而不是帮用户省钱办成事的插件。
更稳的是:
- 对高复用公共底座和版本兼容适配,平台按“公共品维护”单独兜底;
- 对应用层插件,把激励挂在“成功交付的任务数”上;
- 同时顺着官方这次“欢迎创业团队和企业接入服务”的口子,帮懂业务的行家把波动的 Token 消耗打包成确定性的服务去变现(就像我们用「AI 分身工作台」做的尝试)。
从极客玩具走向大众与商业生态,官方这一步迈得非常准;接下来就看指标和治理能不能从“看数量”真正落到“看用成、看存续”上了。
dsh刚公布了最新官方数据:日活 154 万、月活 548 万、日耗 Token 92.1 万亿、公开第三方插件 3.49 万个,约 60% 的活跃用户制作或装过插件。
两周前我扒社区目录里的 7000 个插件时,还拿推特关注数对比 Codex,盲猜它周活大概才 40 万——今天被打脸(而且 154 万日活还只统计了调官方 API 的用户)。
作为一个在 3.5 万个插件里亲手搓过 7 个、踩过一轮升版坑的人,我从官方这三张图和表态里看到的:只交毛坯房的野蛮生长结束了,官方正在下场干最累的“物业和招商”。
先拆三个数据里藏着的细节:
1. 为什么日活一个月暴涨 545%(27.1万→154万),Token 消耗却只涨了 306%(24.2T→92.1T)?
算笔账:
9 月底人均每天烧近 9000 万 Token,基本全是全天候挂机跑代码的重度极客;现在人均降到约 6000 万 Token(日均 261 次请求),说明新涌进来的百万用户开始拿它写稿、做设计、读论文(也可能是有 API 批量任务与交互口径混算,但趋势很明显)——单人任务变轻,恰恰是走出纯程序员圈的信号。
2. 为什么社区市场里只看得到 8700 多个插件,官方去重却有 3.49 万个(GitHub 2.94万 + npm 1.85万)?
因为官方算的是“公开发布过的”,社区导航算的是“被收录的”。
中间差出来的 2.6 万个插件,造出来了却连目录都没进。我在里面做过 7 个插件太有体会了:现在根本不缺人造轮子,而是两万多个插件散在外面没人找得到、也没人知道今天还能不能跑。
3. 官方这次做对了哪三件事?
最亮眼的是排序:把“提升 API 稳定性与兼容性”排在第一顺位,说明官方认下了这笔公共成本(否则平台每发一次破坏性更新,成本全转嫁给用爱发电的作者);紧接着建官方市场、补安全机制、推作者 Token 激励,精选的 4 个案例里 3 个是非编程工作台(自媒体、设计、读论文),还首次喊话“欢迎创业团队和企业通过插件接入产品与服务”。
这跟我们前两篇文章预判的破局方向几乎逐条对上了。
如果顺着官方这套策略再往下深推一层,下半场真正决定成败的其实在于两个转向:
第一,核心指标要从“发了几个、装了几个”,下沉到“活体率”和“用成率”。
3.49 万个插件和 60% 渗透率都在漏斗最顶层,一个是“发过”,一个是“装过”。
但生态健不健康,得往下一层看:
- 供给侧看“量”更要看“活”:
30 天内还在维护的占比多少?作者做完第一个还会不会做第二个?官方提兼容是防未来的病,但存量那 3.5 万个老插件在宿主升版后怎么自动巡检、标注兼容范围或静默迁移?
- 需求侧看“装”更要看“用”:装上后首次任务跑通率多少?30 天后还在复用的留存多少?
- 匹配侧看效率:3.5 万个插件平铺在商店里根本挑不过来。官方市场最该守住的是“已验证兼容 + 安全分级”的信任底线;而前端发现还得靠“在对话里提需求 → 先搜现成好插件 → 能拼就拼 → 缺的再让创造模式造”(这也是我做「发现好插件 2.0」跑的逻辑)。
第二,商业与激励要分清“补成本”还是“奖价值”,别让 Token 激励变成奖励“谁更费 Token”。
生态不同阶段该用不同手段:冷启动降开发门槛,成长期靠兼容契约和验证降交付成本,成熟期靠分成和企业服务让维护有回报。
官方这次提的 Token 激励本质是研发成本补贴,但如果按消耗量发,很容易奖励长上下文、高消耗的插件,而不是帮用户省钱办成事的插件。
更稳的是:
- 对高复用公共底座和版本兼容适配,平台按“公共品维护”单独兜底;
- 对应用层插件,把激励挂在“成功交付的任务数”上;
- 同时顺着官方这次“欢迎创业团队和企业接入服务”的口子,帮懂业务的行家把波动的 Token 消耗打包成确定性的服务去变现(就像我们用「AI 分身工作台」做的尝试)。
从极客玩具走向大众与商业生态,官方这一步迈得非常准;接下来就看指标和治理能不能从“看数量”真正落到“看用成、看存续”上了。
3 00
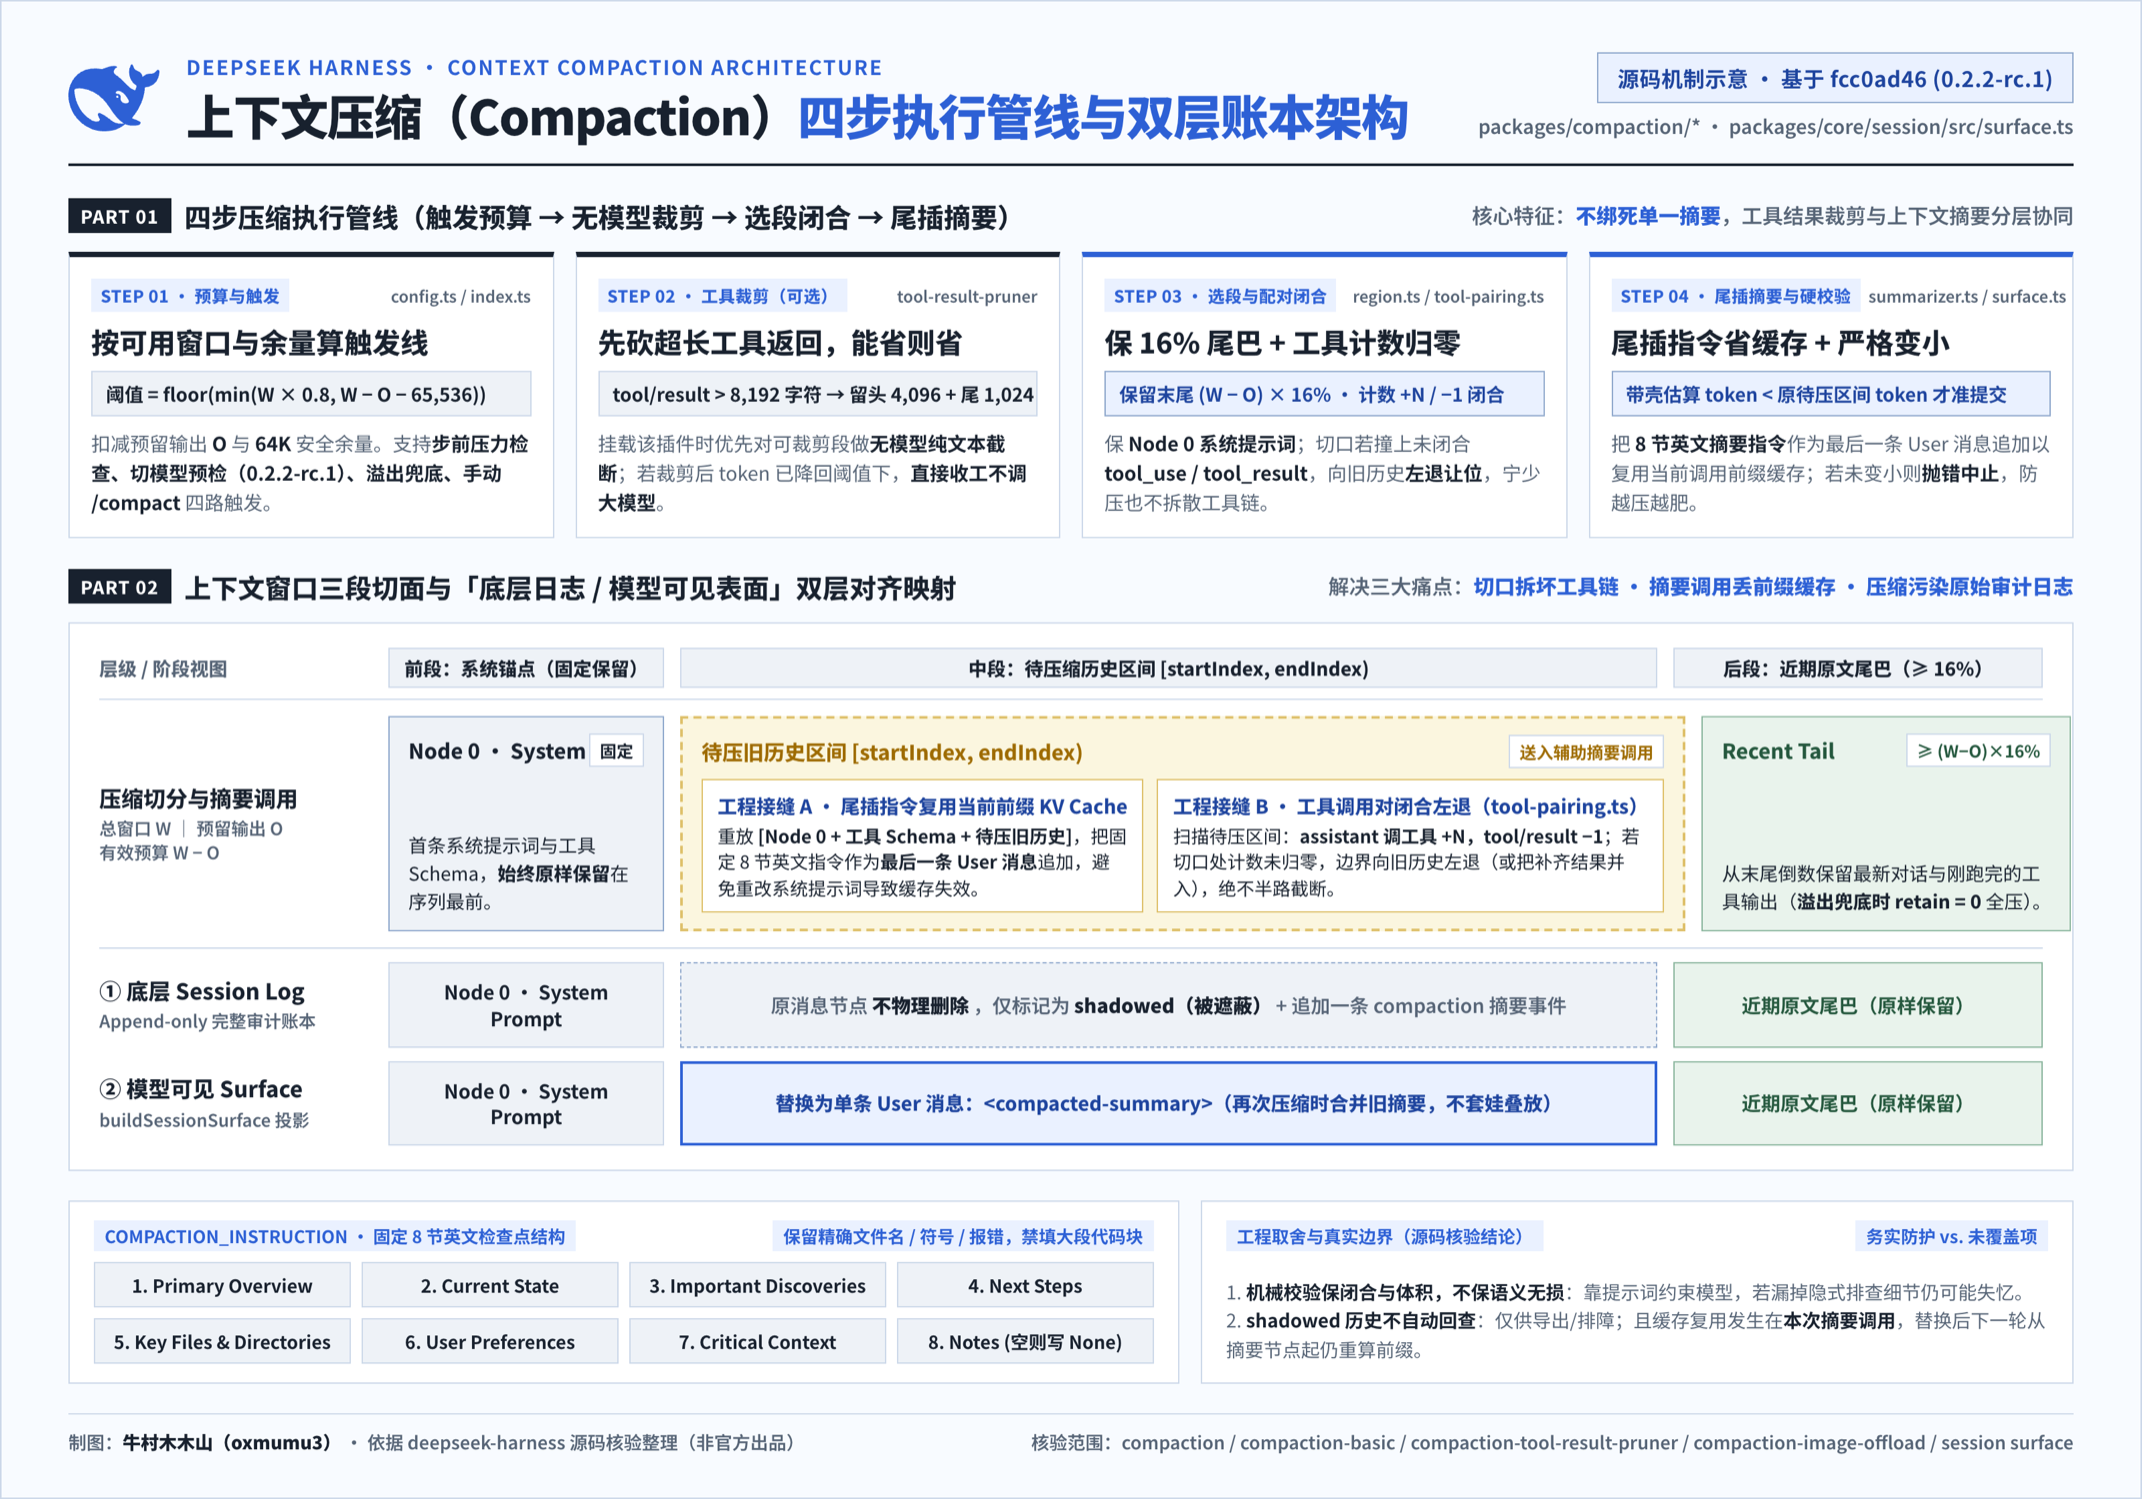
扒了下 DeepSeek Harness 的上下文压缩(compaction)源码,大框架其实特别朴素,跟标准做法没啥两样,但有 4 个防崩、省缓存的工程细节写得蛮讲究。
看主干:
没搞复杂的语义重要性打分,也没做自动翻旧账的记忆魔法,和 LangChain、Anthropic 讲的常规方案一样——按模型窗口扣掉预留输出和 65536 token 安全余量算触发线;先用无模型修剪器把超过 8192 字符的工具返回结果砍掉中间(只留头 4096、尾 1024 字符),够用就不调模型;不够再留 16% 的近期消息原样不动,把前面的旧历史交给模型压成固定 8 节的英文检查点(意图、概念、文件、报错、待办、当前进展、下一步、关键上下文),包进 <compacted-summary> 替换旧历史。
教科书式简单实现之外, 4 个工程接缝值得留意:
1. 切口按工具计数对齐,绝不劈开工具调用。
倒数凑够 16% 近期尾巴后,它会检查切口处的工具调用计数是否归零(assistant 发起调用加 N,收到 tool/result 减 1,只算数量不核对 ID)。没归零就继续往更早的消息退,宁可多留尾巴,也绝不把一组工具调用切成两半导致下一轮 API 报错。
2. 摘要请求把指令塞在最末尾,专门复用前缀 KV Cache。
很多实现写摘要时会换一套“你是摘要助手”的 System Prompt,结果长对话攒下的前缀缓存从第 0 个 token 起全废了。DSH 则是原样重放当前会话第 0 节点的系统提示词、工具 Schema 和待压缩旧消息,把摘要指令作为最后一条 User 消息追加在末尾,让摘要请求本身直接吃上热缓存(当然,等摘要真正替换旧历史后,后续对话从替换点起的缓存前缀还是会变)。
3. 底层日志只追加不删改,且摘要必须“真变小”。
底层 Session 日志只追加,压缩只是在给模型看的 surface 视图上做位置替换,被盖住的旧事件标为 shadowed,人查记录都在。而且提交前有硬门槛:带包装标签的摘要估算 token 必须严格小于被替换区间,否则直接报错拒绝入账,不做“越压越长”的负优化。
4. 失败分路兜底与切模型门禁。
碰上上下文溢出报错,哪怕写摘要挂了,只要前一步的无模型工具修剪实际缩减了表面,依然算有效进展允许重试;最新 0.2.2-rc.1 源码还加了一道切模型预检,中途切小窗口模型压不下来就直接拦住切换(我本机 0.2.1-rc.5 还没这道门禁)。
怎么评价🤔
我觉得谈不上“出人意料”,最准确的词是“主干很朴素,工程接缝很实在,边界也很诚实”。很有ds的风格
代码只兜底机械状态和体积缩减,并没有任何程序去校验模型是不是真写齐了 8 节,也没法证明摘要没漏掉某句关键纠正;旧记录虽在,对话模型也不会主动回查(recallable-compaction 目前还只是仓库里的 proposed 提案)。
源码位置(0.2.2-rc.1 固定提交):
github.com
看主干:
没搞复杂的语义重要性打分,也没做自动翻旧账的记忆魔法,和 LangChain、Anthropic 讲的常规方案一样——按模型窗口扣掉预留输出和 65536 token 安全余量算触发线;先用无模型修剪器把超过 8192 字符的工具返回结果砍掉中间(只留头 4096、尾 1024 字符),够用就不调模型;不够再留 16% 的近期消息原样不动,把前面的旧历史交给模型压成固定 8 节的英文检查点(意图、概念、文件、报错、待办、当前进展、下一步、关键上下文),包进 <compacted-summary> 替换旧历史。
教科书式简单实现之外, 4 个工程接缝值得留意:
1. 切口按工具计数对齐,绝不劈开工具调用。
倒数凑够 16% 近期尾巴后,它会检查切口处的工具调用计数是否归零(assistant 发起调用加 N,收到 tool/result 减 1,只算数量不核对 ID)。没归零就继续往更早的消息退,宁可多留尾巴,也绝不把一组工具调用切成两半导致下一轮 API 报错。
2. 摘要请求把指令塞在最末尾,专门复用前缀 KV Cache。
很多实现写摘要时会换一套“你是摘要助手”的 System Prompt,结果长对话攒下的前缀缓存从第 0 个 token 起全废了。DSH 则是原样重放当前会话第 0 节点的系统提示词、工具 Schema 和待压缩旧消息,把摘要指令作为最后一条 User 消息追加在末尾,让摘要请求本身直接吃上热缓存(当然,等摘要真正替换旧历史后,后续对话从替换点起的缓存前缀还是会变)。
3. 底层日志只追加不删改,且摘要必须“真变小”。
底层 Session 日志只追加,压缩只是在给模型看的 surface 视图上做位置替换,被盖住的旧事件标为 shadowed,人查记录都在。而且提交前有硬门槛:带包装标签的摘要估算 token 必须严格小于被替换区间,否则直接报错拒绝入账,不做“越压越长”的负优化。
4. 失败分路兜底与切模型门禁。
碰上上下文溢出报错,哪怕写摘要挂了,只要前一步的无模型工具修剪实际缩减了表面,依然算有效进展允许重试;最新 0.2.2-rc.1 源码还加了一道切模型预检,中途切小窗口模型压不下来就直接拦住切换(我本机 0.2.1-rc.5 还没这道门禁)。
怎么评价🤔
我觉得谈不上“出人意料”,最准确的词是“主干很朴素,工程接缝很实在,边界也很诚实”。很有ds的风格
代码只兜底机械状态和体积缩减,并没有任何程序去校验模型是不是真写齐了 8 节,也没法证明摘要没漏掉某句关键纠正;旧记录虽在,对话模型也不会主动回查(recallable-compaction 目前还只是仓库里的 proposed 提案)。
源码位置(0.2.2-rc.1 固定提交):
github.com
3 00
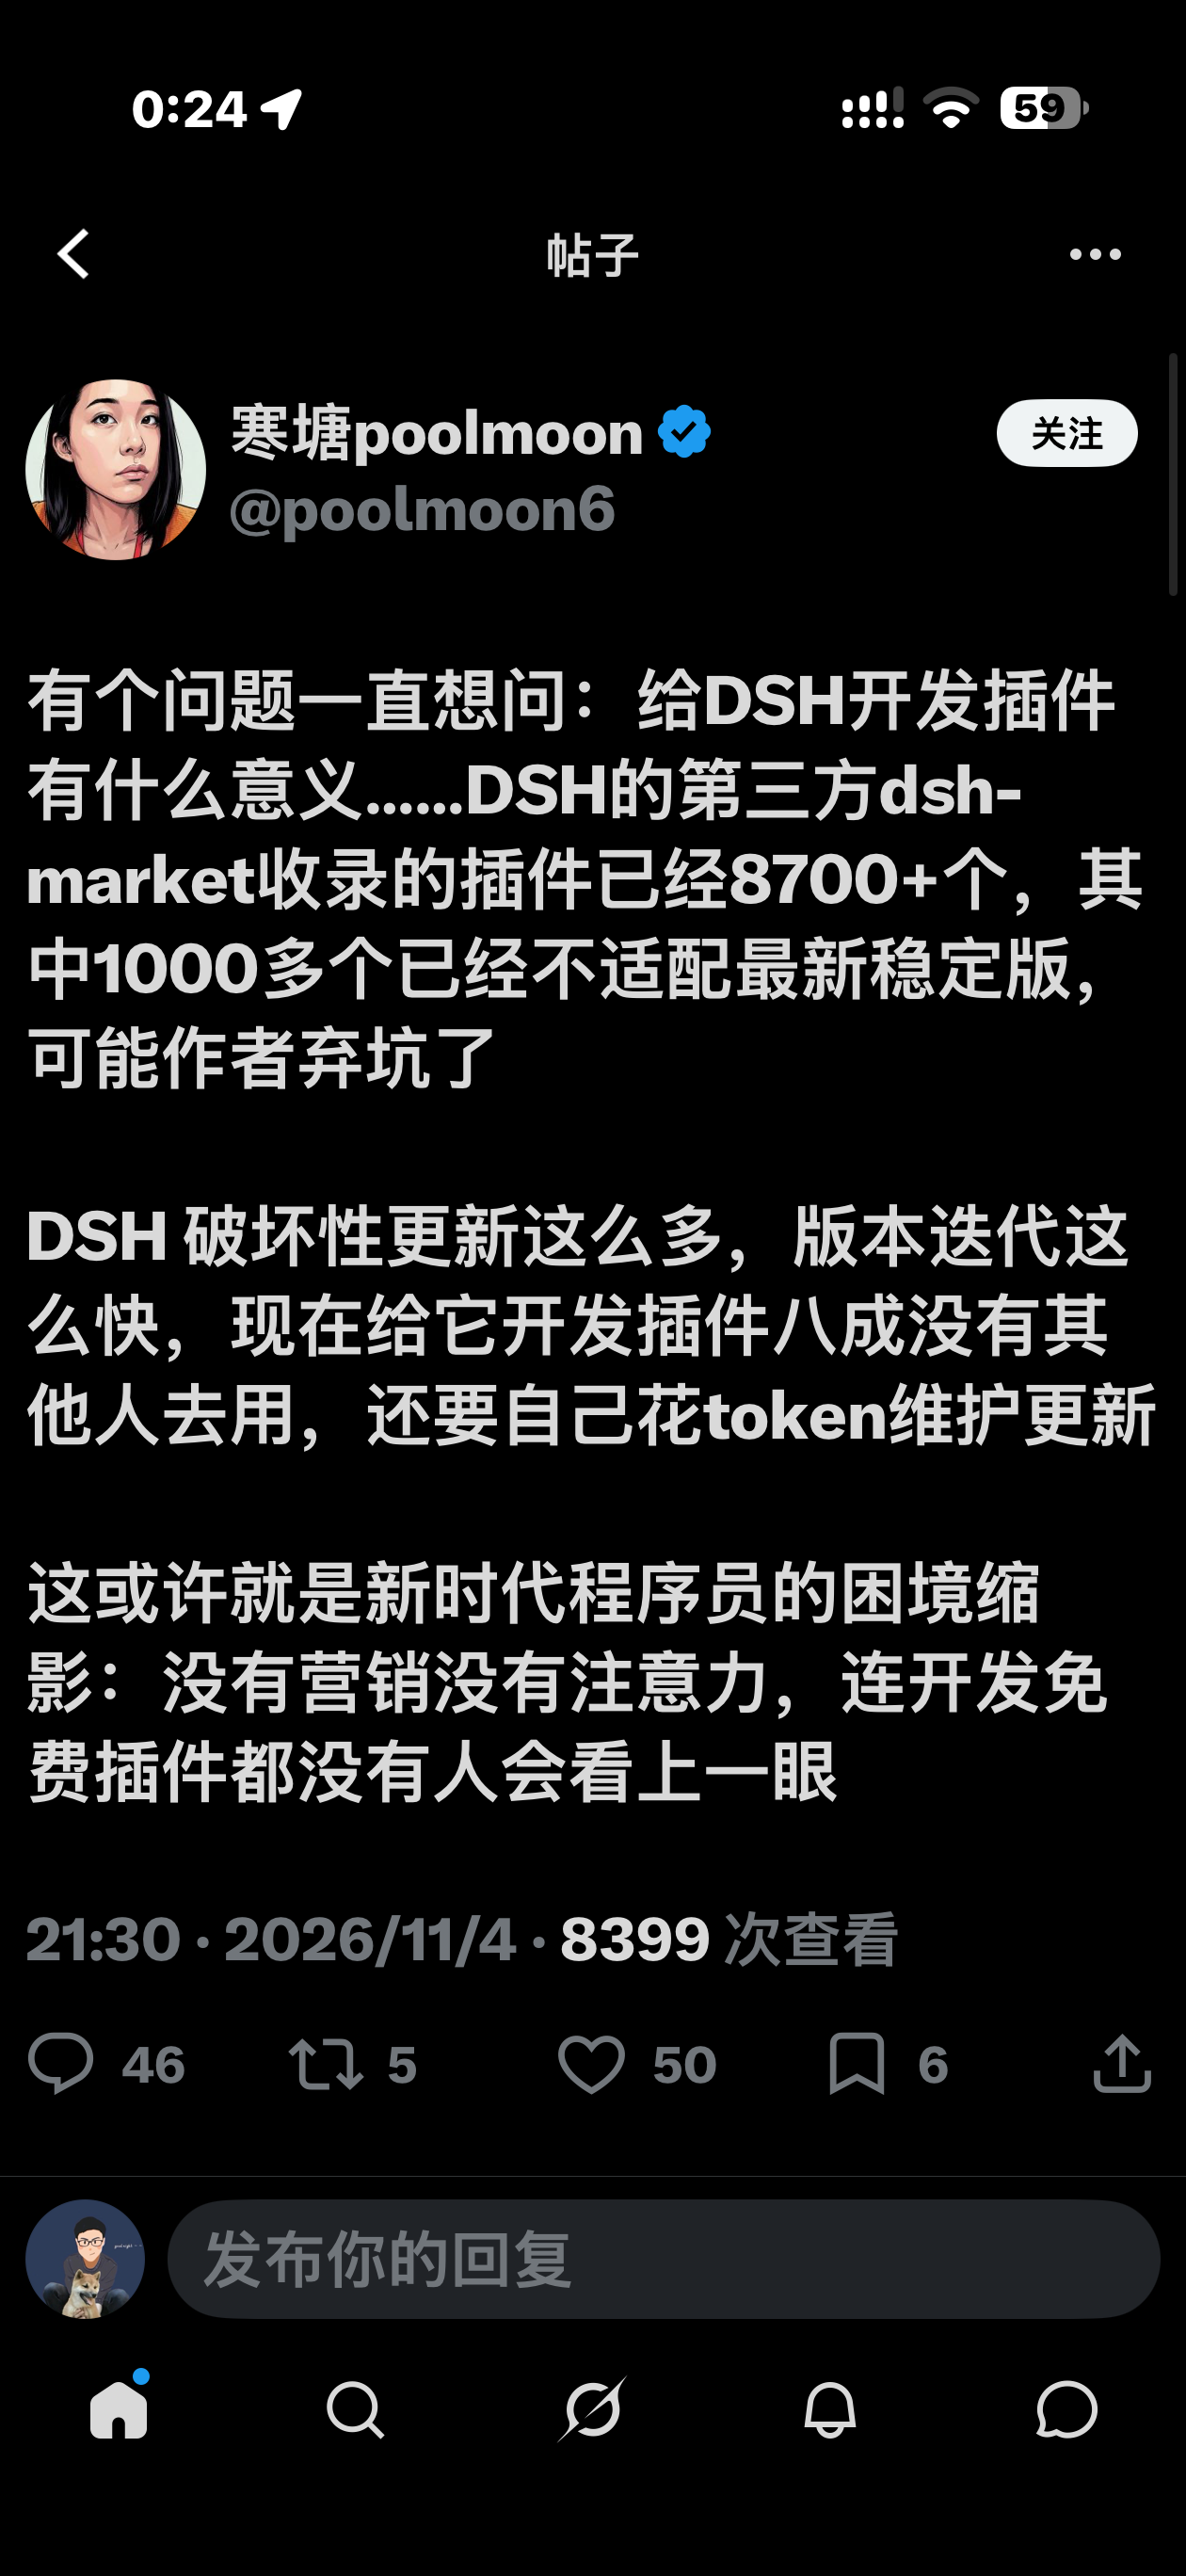
体感太真实了。我自己这一个月连搓了 7 个 DSH 插件,前几天读者说有一个装不上,我顺手把 7 个全查了一遍,结果发现随着宿主快速迭代,另外 6 个全出了不同程度的兼容问题。
我觉得这说明 DSH 走到生态换挡的关口:
靠底层极致开放和创造模式,第一阶段“把供给搞起来”已经非常成功。
但当写代码的成本被压到接近零之后,真正的瓶颈一定会转到下半场的消费侧发现和持续交付上:
1. 分发不能再靠逛目录:
8000 多个插件里光查用量的就有两百多个,用户找不到、作者也没反馈。必须变成用户在对话里提需求,AI 先按任务匹配现成好插件,缺哪块再造(这也是我做「发现好插件 2.0」的原因)。
2. 维护不能全靠作者手搓:
宿主跑得快,就得靠向后兼容层 + 让 AI 在后台自动完成插件升级迁移,同时给高复用的公共底座做定向激励。
从“造得出来”到“找得到、养得活”,这是生态从极客尝鲜走向大众普惠必过一关
我觉得这说明 DSH 走到生态换挡的关口:
靠底层极致开放和创造模式,第一阶段“把供给搞起来”已经非常成功。
但当写代码的成本被压到接近零之后,真正的瓶颈一定会转到下半场的消费侧发现和持续交付上:
1. 分发不能再靠逛目录:
8000 多个插件里光查用量的就有两百多个,用户找不到、作者也没反馈。必须变成用户在对话里提需求,AI 先按任务匹配现成好插件,缺哪块再造(这也是我做「发现好插件 2.0」的原因)。
2. 维护不能全靠作者手搓:
宿主跑得快,就得靠向后兼容层 + 让 AI 在后台自动完成插件升级迁移,同时给高复用的公共底座做定向激励。
从“造得出来”到“找得到、养得活”,这是生态从极客尝鲜走向大众普惠必过一关
3 00
真的 合理等待agent回应的时间很多时候就是刷手机…但是dsh ✖️ds基模很快似乎就没啥时间刷了,倒是用codex/claudecode的时候间歇时间很多
评论尸: 我特么笑死,红果插件现已登录 Deepseek Harness。 不敢想这多巴胺分泌得多充裕,一边是 Vibe Coding 抽卡,另一边是短剧奶头乐。
0 00