即刻App年轻人的同好社区
下载
Attention——注意力,印象里从短视频开始讨论热度越来越高。
最近关于 AI 讨论/帖子里,注意力又开始出现在视野中。
它跟时间一样,无法回溯,却会对未来产生极大影响。
有了 AI 想做、可以做的更多,你选择为什么下注?未来某一刻回想,曾经那么多选择在眼前,哪一件有结果?
最近关于 AI 讨论/帖子里,注意力又开始出现在视野中。
它跟时间一样,无法回溯,却会对未来产生极大影响。
有了 AI 想做、可以做的更多,你选择为什么下注?未来某一刻回想,曾经那么多选择在眼前,哪一件有结果?
1 00
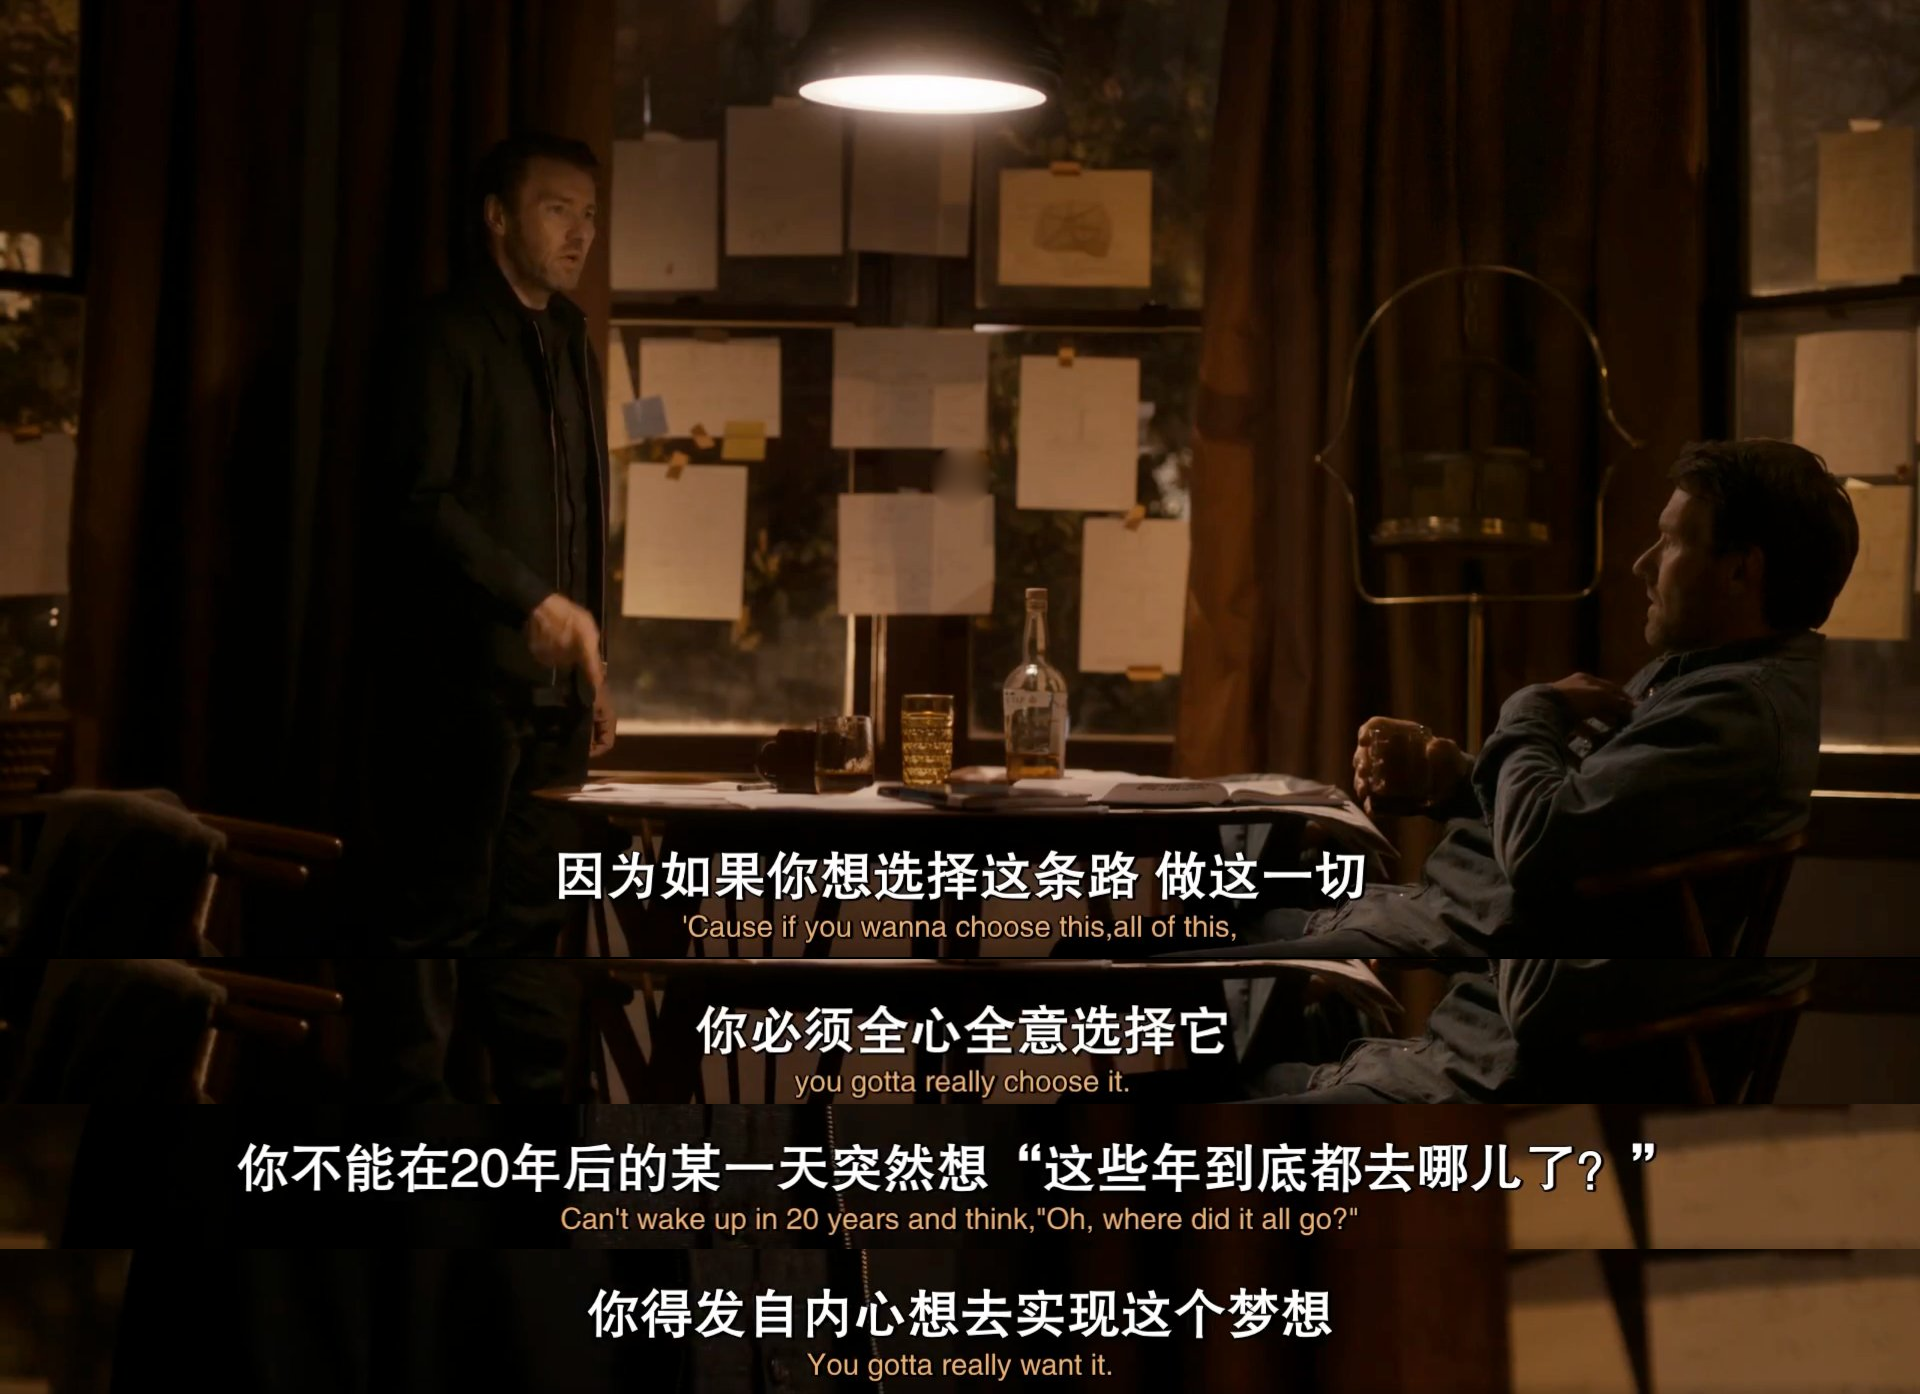
花一周时间,帮同事“兜底”
仅做吐槽记录,无其它引导,事情原委如下。
两个多月前,接到个功能需求:“审核用户上传的文件内容,判是否有足够证据支撑满足条件”
1. 文件类型:任意办公文件(Word、PPT、Excel、PDF)、图片
2. 文件数量:可能成百上千 —— 对 AI 来说上下文未知
3. 不规范:无法规范目录结构、文件名 —— 无法用结构化,对数据做初筛
4. 可溯源:能找到 AI 结论的支撑来自哪份文件、哪个位置
领导将它派发给同事负责,关于技术实现可以询问我:采用知识库 Weknora 实现 —— 基于当时认识,需要看源码确认知识库实现是否溯源,
他认为(或许尝试过)知识库无法「溯源」,同时审核不够准确 —— 参考我们另外一套使用 OCR 技术实现溯源,但反复提过评测审核无法借鉴。
他还是采用 OCR 对文件扫描,这带来一个问题,如何实现上面 4 个功能需求?当时还不是这么整理的,他可能没考虑到。
于是按照:结构化目录分类,单次请求 LLM(大模型)接口审核程序筛选出的文本。
领导也认为,他开发的完成了,便去负责另一个项目。
我接手后,并不想管如何实现的,但发现完全不可用,根本没有考虑以上 4 种情况,比如:用户上传的文件,不遵循目录结构、文件名。就成了死代码
一气之下,全部重构掉(毕竟我是这个项目的负责人,从0-1开始做的)。
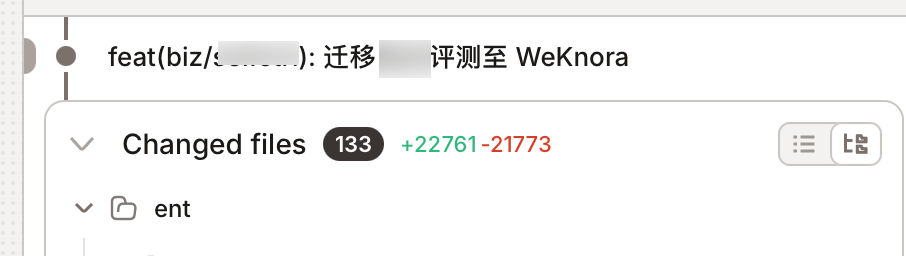
涉及 5 个代码仓库,最终修改近 5w 行代码
——
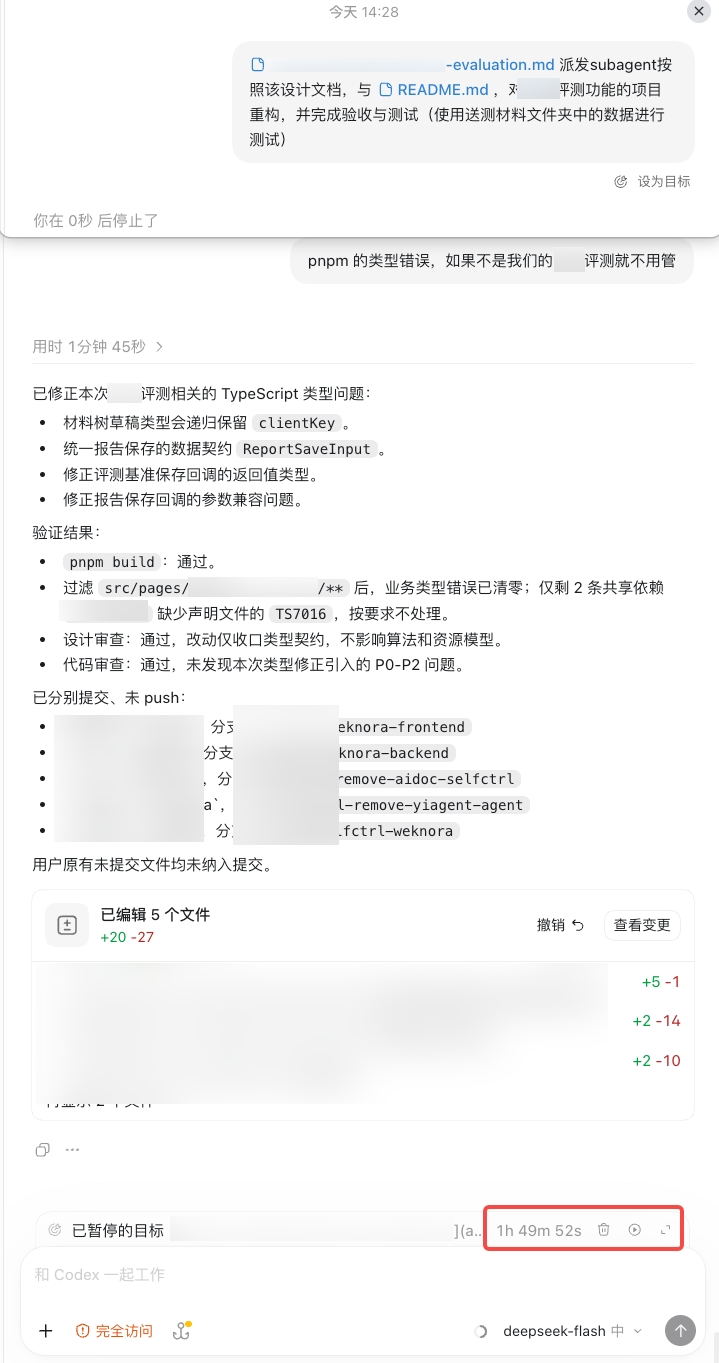
“AI时代的分水岭:如何让 AI 执行 1小时以上”。
> 这是METR在2025年发表的一篇论文中,提出了衡量AI“任务完成时间跨度”的指标。该研究发现,当时的前沿模型(如Claude 3.7 Sonnet)能够以约50%的成功率,完成人类大约需要 1小时 才能完成的软件工程等任务。
再次记录 1小时 分水岭,竟是这件事哈哈哈
仅做吐槽记录,无其它引导,事情原委如下。
两个多月前,接到个功能需求:“审核用户上传的文件内容,判是否有足够证据支撑满足条件”
1. 文件类型:任意办公文件(Word、PPT、Excel、PDF)、图片
2. 文件数量:可能成百上千 —— 对 AI 来说上下文未知
3. 不规范:无法规范目录结构、文件名 —— 无法用结构化,对数据做初筛
4. 可溯源:能找到 AI 结论的支撑来自哪份文件、哪个位置
领导将它派发给同事负责,关于技术实现可以询问我:采用知识库 Weknora 实现 —— 基于当时认识,需要看源码确认知识库实现是否溯源,
他认为(或许尝试过)知识库无法「溯源」,同时审核不够准确 —— 参考我们另外一套使用 OCR 技术实现溯源,但反复提过评测审核无法借鉴。
他还是采用 OCR 对文件扫描,这带来一个问题,如何实现上面 4 个功能需求?当时还不是这么整理的,他可能没考虑到。
于是按照:结构化目录分类,单次请求 LLM(大模型)接口审核程序筛选出的文本。
领导也认为,他开发的完成了,便去负责另一个项目。
我接手后,并不想管如何实现的,但发现完全不可用,根本没有考虑以上 4 种情况,比如:用户上传的文件,不遵循目录结构、文件名。就成了死代码
一气之下,全部重构掉(毕竟我是这个项目的负责人,从0-1开始做的)。
涉及 5 个代码仓库,最终修改近 5w 行代码
——
“AI时代的分水岭:如何让 AI 执行 1小时以上”。
> 这是METR在2025年发表的一篇论文中,提出了衡量AI“任务完成时间跨度”的指标。该研究发现,当时的前沿模型(如Claude 3.7 Sonnet)能够以约50%的成功率,完成人类大约需要 1小时 才能完成的软件工程等任务。
再次记录 1小时 分水岭,竟是这件事哈哈哈
1 10
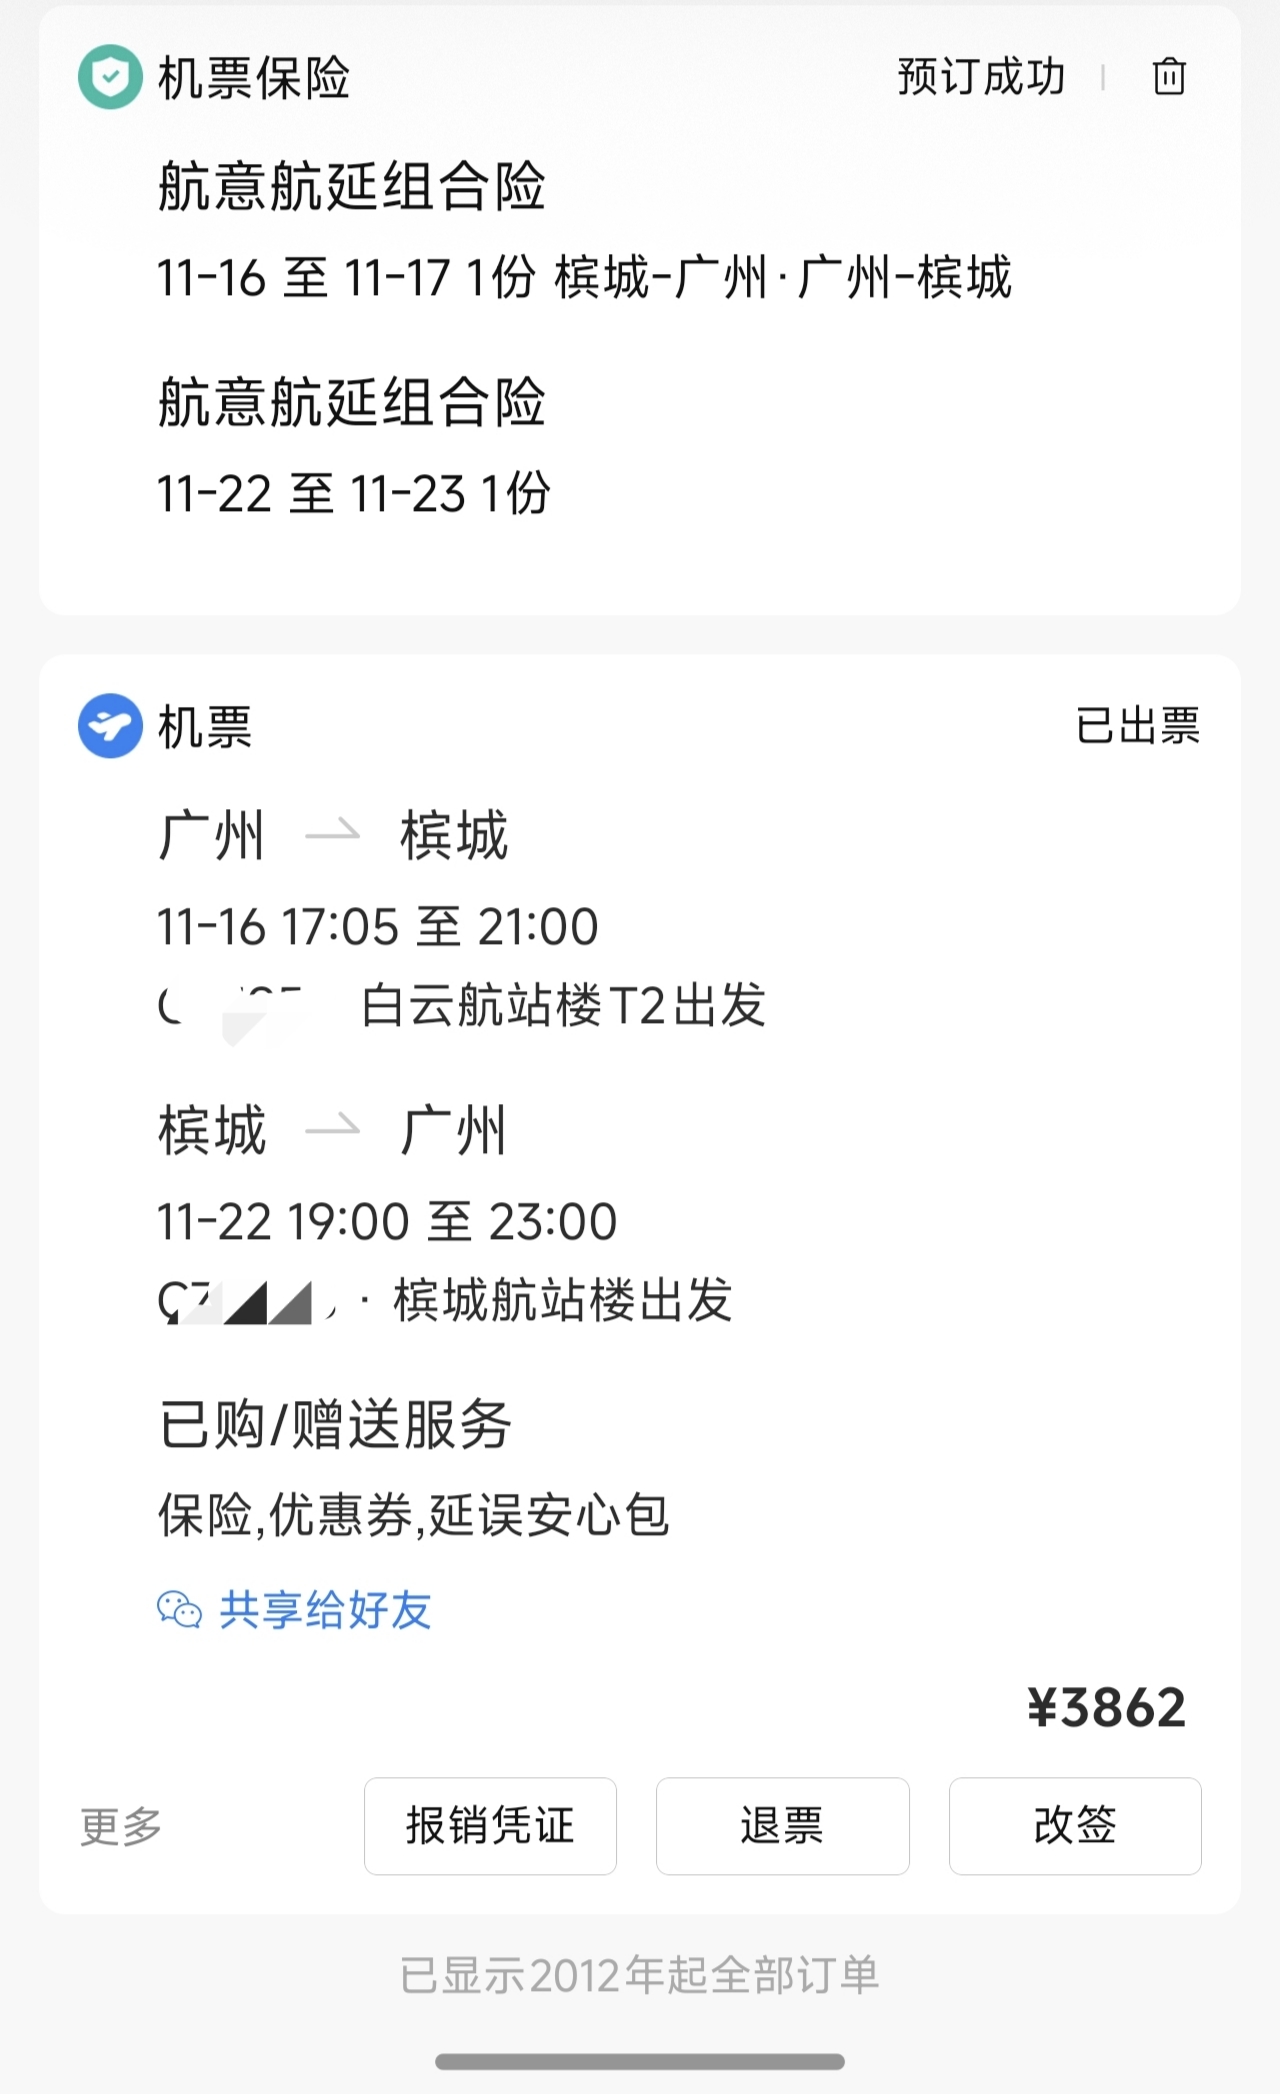
第一次出国,没想到是因公出差。
如果让我自己出去玩,连国内都不知道去哪里,更别说“昂贵”的机票去国外了。
也是有了护照、港澳通行证,Visa / 万事达银行卡,这些都是因工作办理下来。
得知要去马来西亚出差到两周内,我在没有收集相应信息情况下,听朋友、家人劝,安全考虑决定不去马来西亚。
跟领导说过后,他将另一位实习生“拉下水”(出过国)。
在这位实习生收集信息后,发现要去的那家公司非常正规、安全,也是当地工会成员,我这忐忑不安的心放下了。
今年八月左右,重新跟一位很久没联系的中专同学恢复了往来。
他说自己 最大的教训,就是在没有收集相关信息下做了决策/行动。
后来我在书里也读到了类似描述——《黑天鹅》《理解规则》《重新理解批判性思维》
此后,“信息”一词深深印在了脑海。
我没有将责任归咎于没有主动获取信息。
根本问题是,我没有给自己留下空白时间。
空白时间(正念,处在当下)能够让我看眼前重要的事情,而不挤满给未来。
——
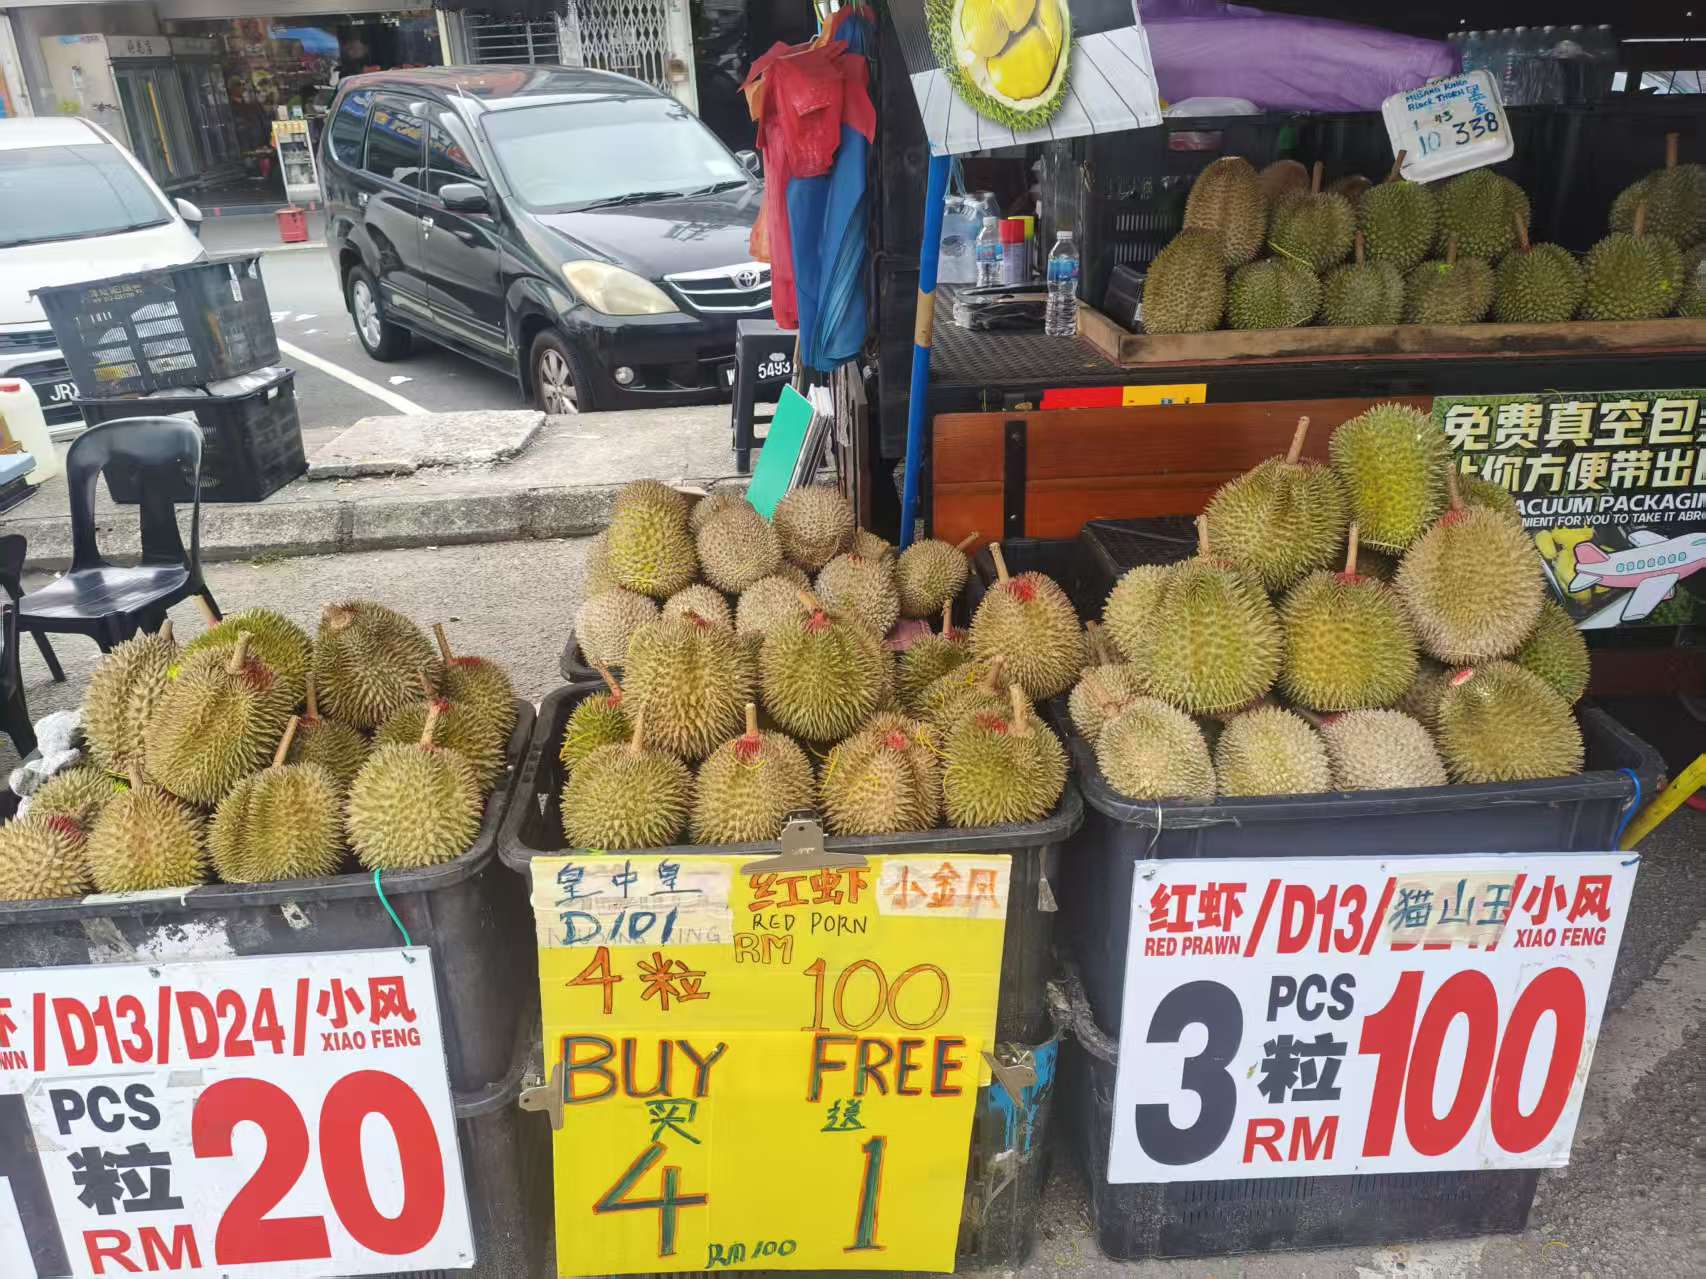
听朋友们说,马拉西亚的水果非常便宜。有3颗榴莲100块,到时一定常常鲜。
如果让我自己出去玩,连国内都不知道去哪里,更别说“昂贵”的机票去国外了。
也是有了护照、港澳通行证,Visa / 万事达银行卡,这些都是因工作办理下来。
得知要去马来西亚出差到两周内,我在没有收集相应信息情况下,听朋友、家人劝,安全考虑决定不去马来西亚。
跟领导说过后,他将另一位实习生“拉下水”(出过国)。
在这位实习生收集信息后,发现要去的那家公司非常正规、安全,也是当地工会成员,我这忐忑不安的心放下了。
今年八月左右,重新跟一位很久没联系的中专同学恢复了往来。
他说自己 最大的教训,就是在没有收集相关信息下做了决策/行动。
后来我在书里也读到了类似描述——《黑天鹅》《理解规则》《重新理解批判性思维》
此后,“信息”一词深深印在了脑海。
我没有将责任归咎于没有主动获取信息。
根本问题是,我没有给自己留下空白时间。
空白时间(正念,处在当下)能够让我看眼前重要的事情,而不挤满给未来。
——
听朋友们说,马拉西亚的水果非常便宜。有3颗榴莲100块,到时一定常常鲜。
0 00
难以找寻的特别一帧,让AI来实现
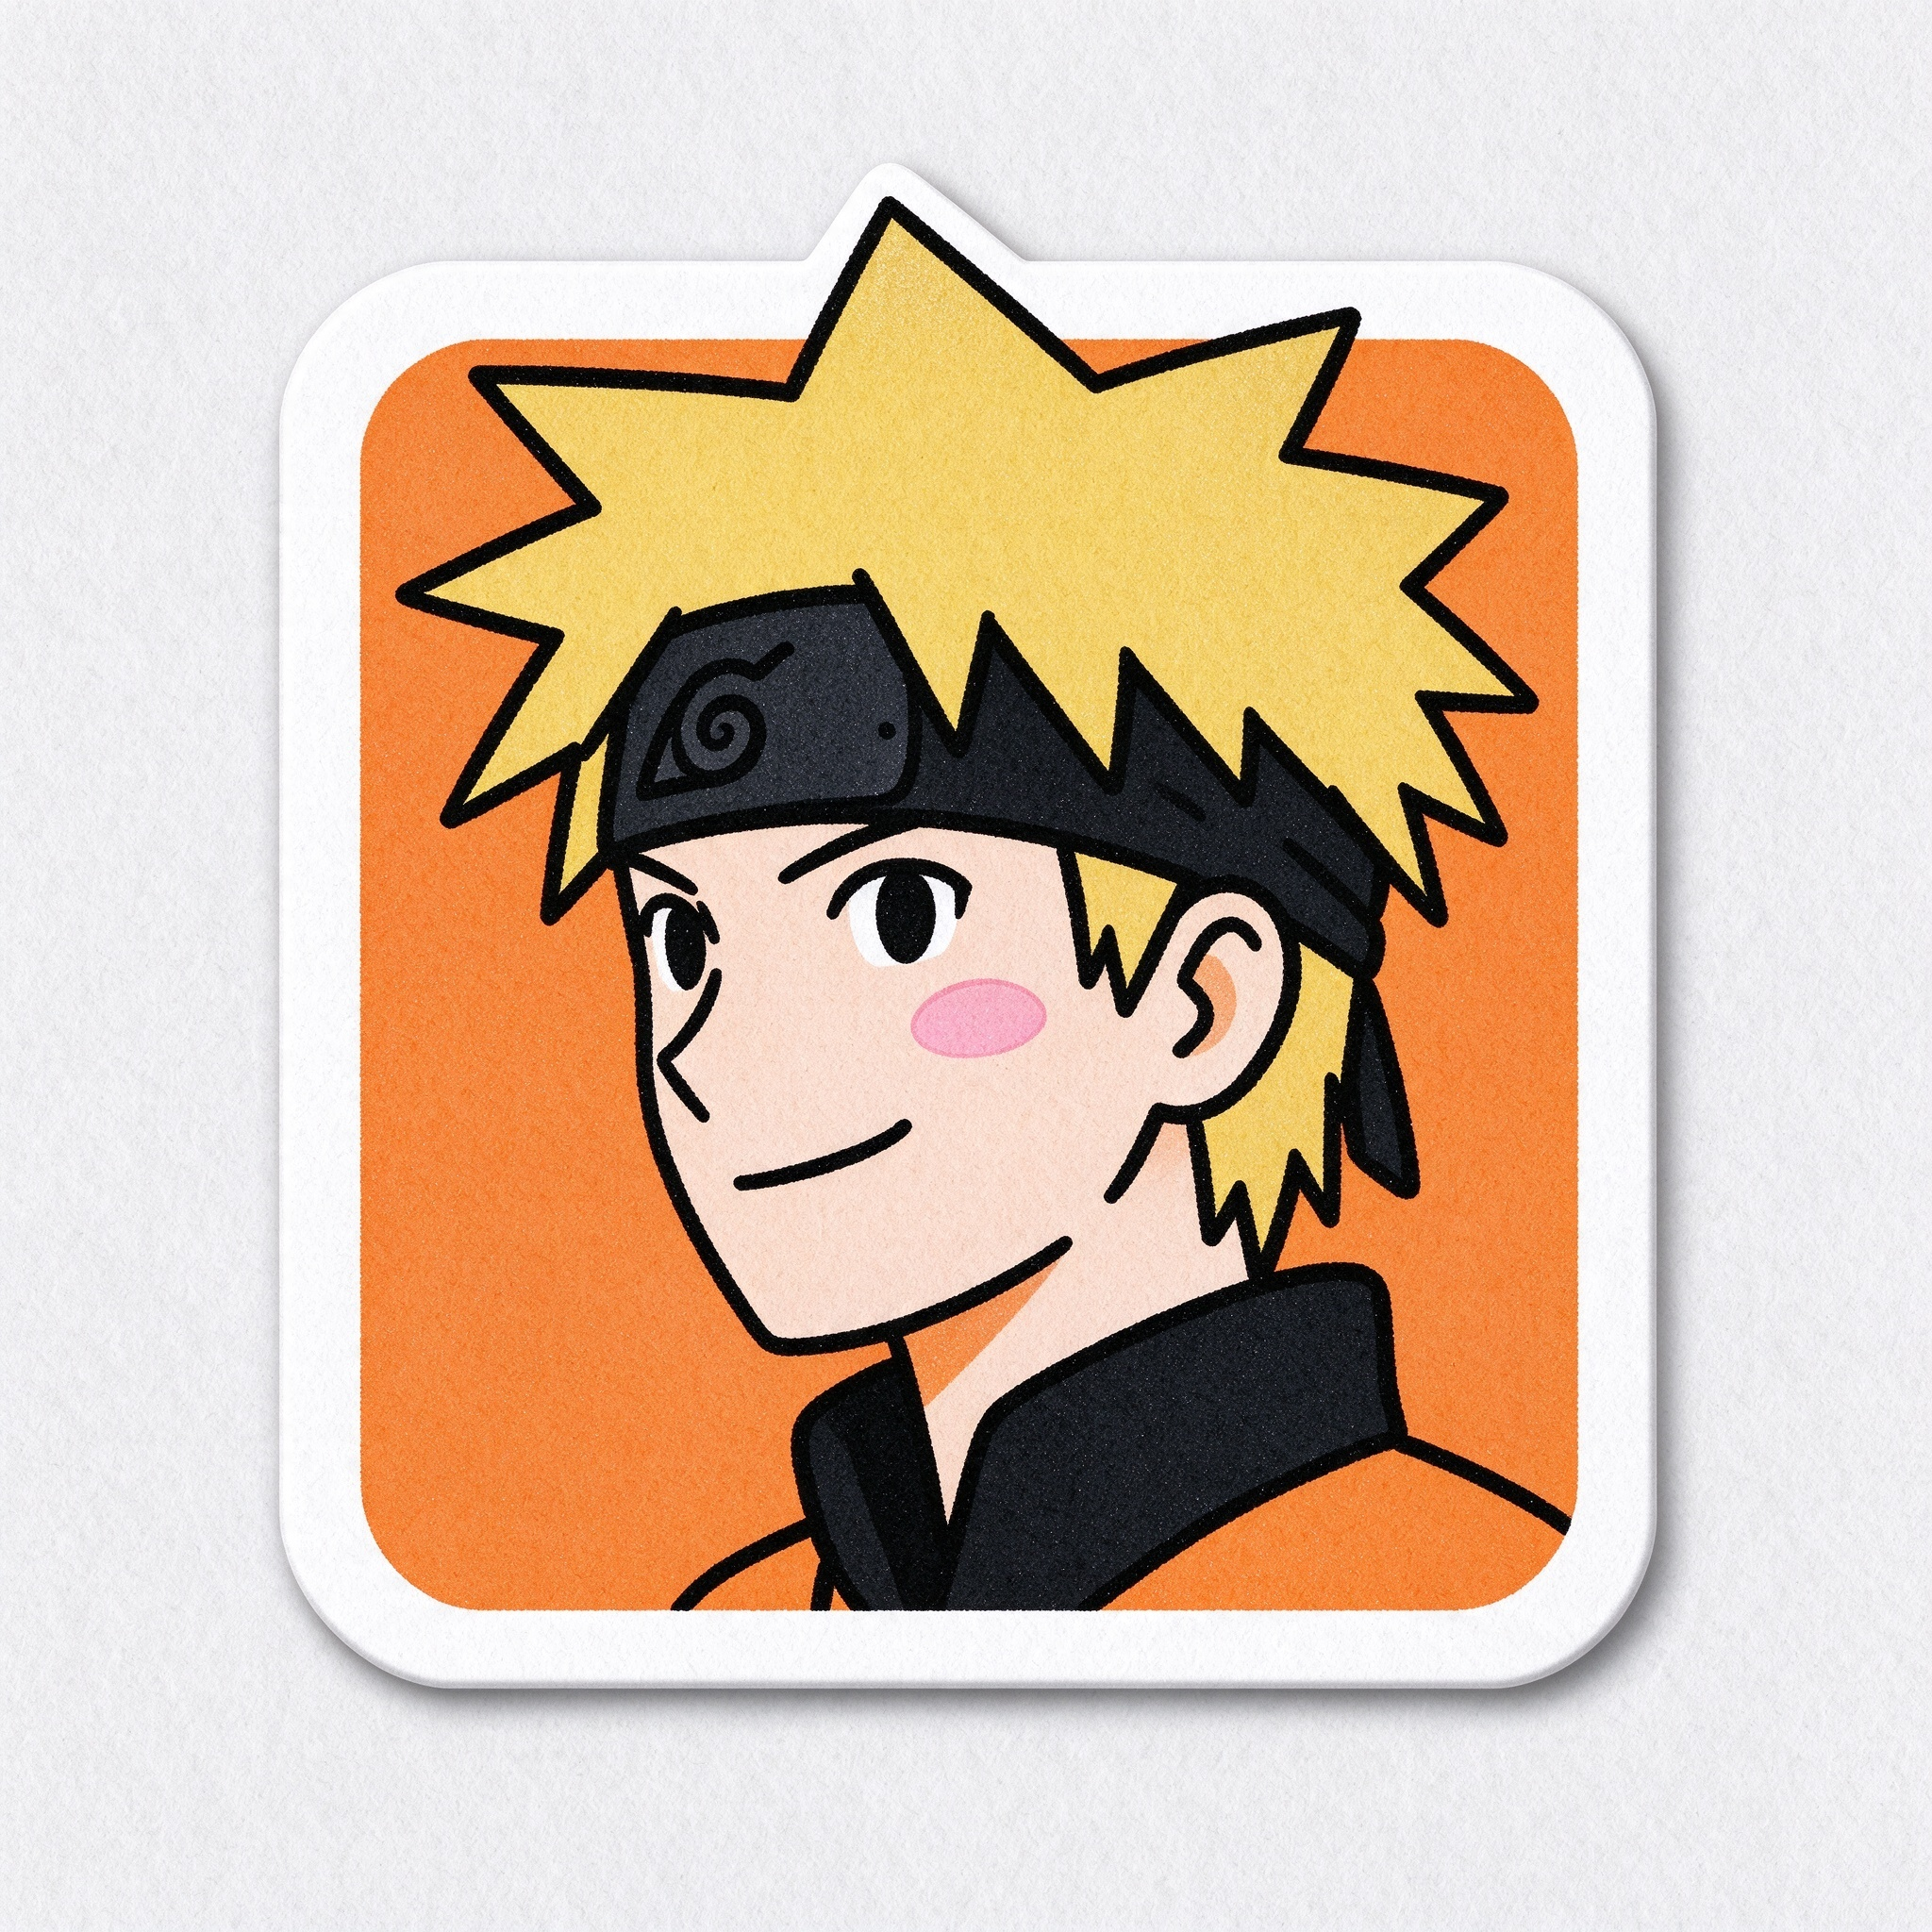
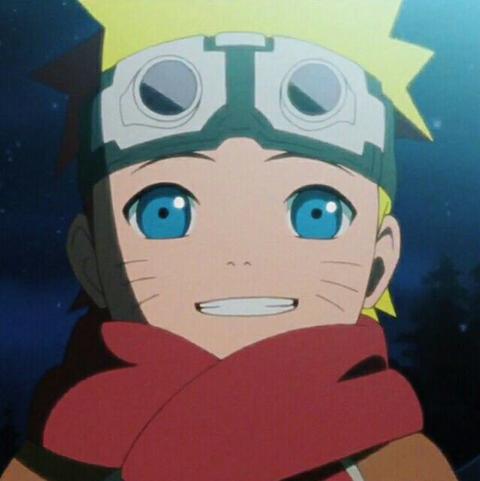
我用最久也是最喜欢的一张头像,是《火影忍者》剧场版中,小鸣人和小雏田在雪中灯下的场景,鸣人那童真的笑容和雏田萌萌的神态。
动漫、电影中某个被触动的画面,想经历、体验的人生故事,或与人物共鸣。 我们就会把那一帧,当作壁纸、背景或头像。
在 Pinterest 可以看到非常多二创内容,很好看、清晰,它们就像 POP MART 陈列起来,自己喜欢的人物、场景仿佛活了起来。
但我有个毛病:总是删数据,特别是图片、视频。不光占用内存空间,还有那一个个的图片、视频数量。
以前,我是讲它发到自媒体平台,发完就把手机里的删了——现在改了,用电脑Obsidian组织,就清晰很多(以后的帖子与大家分享)。
分享类的还好,但像头像这种需要不同地方使用,重新下载又会损失画质,导致越来越模糊。 同时,一个场景很难找到,找到了可能也不是最想要的那一帧,这是最让人沮丧的。
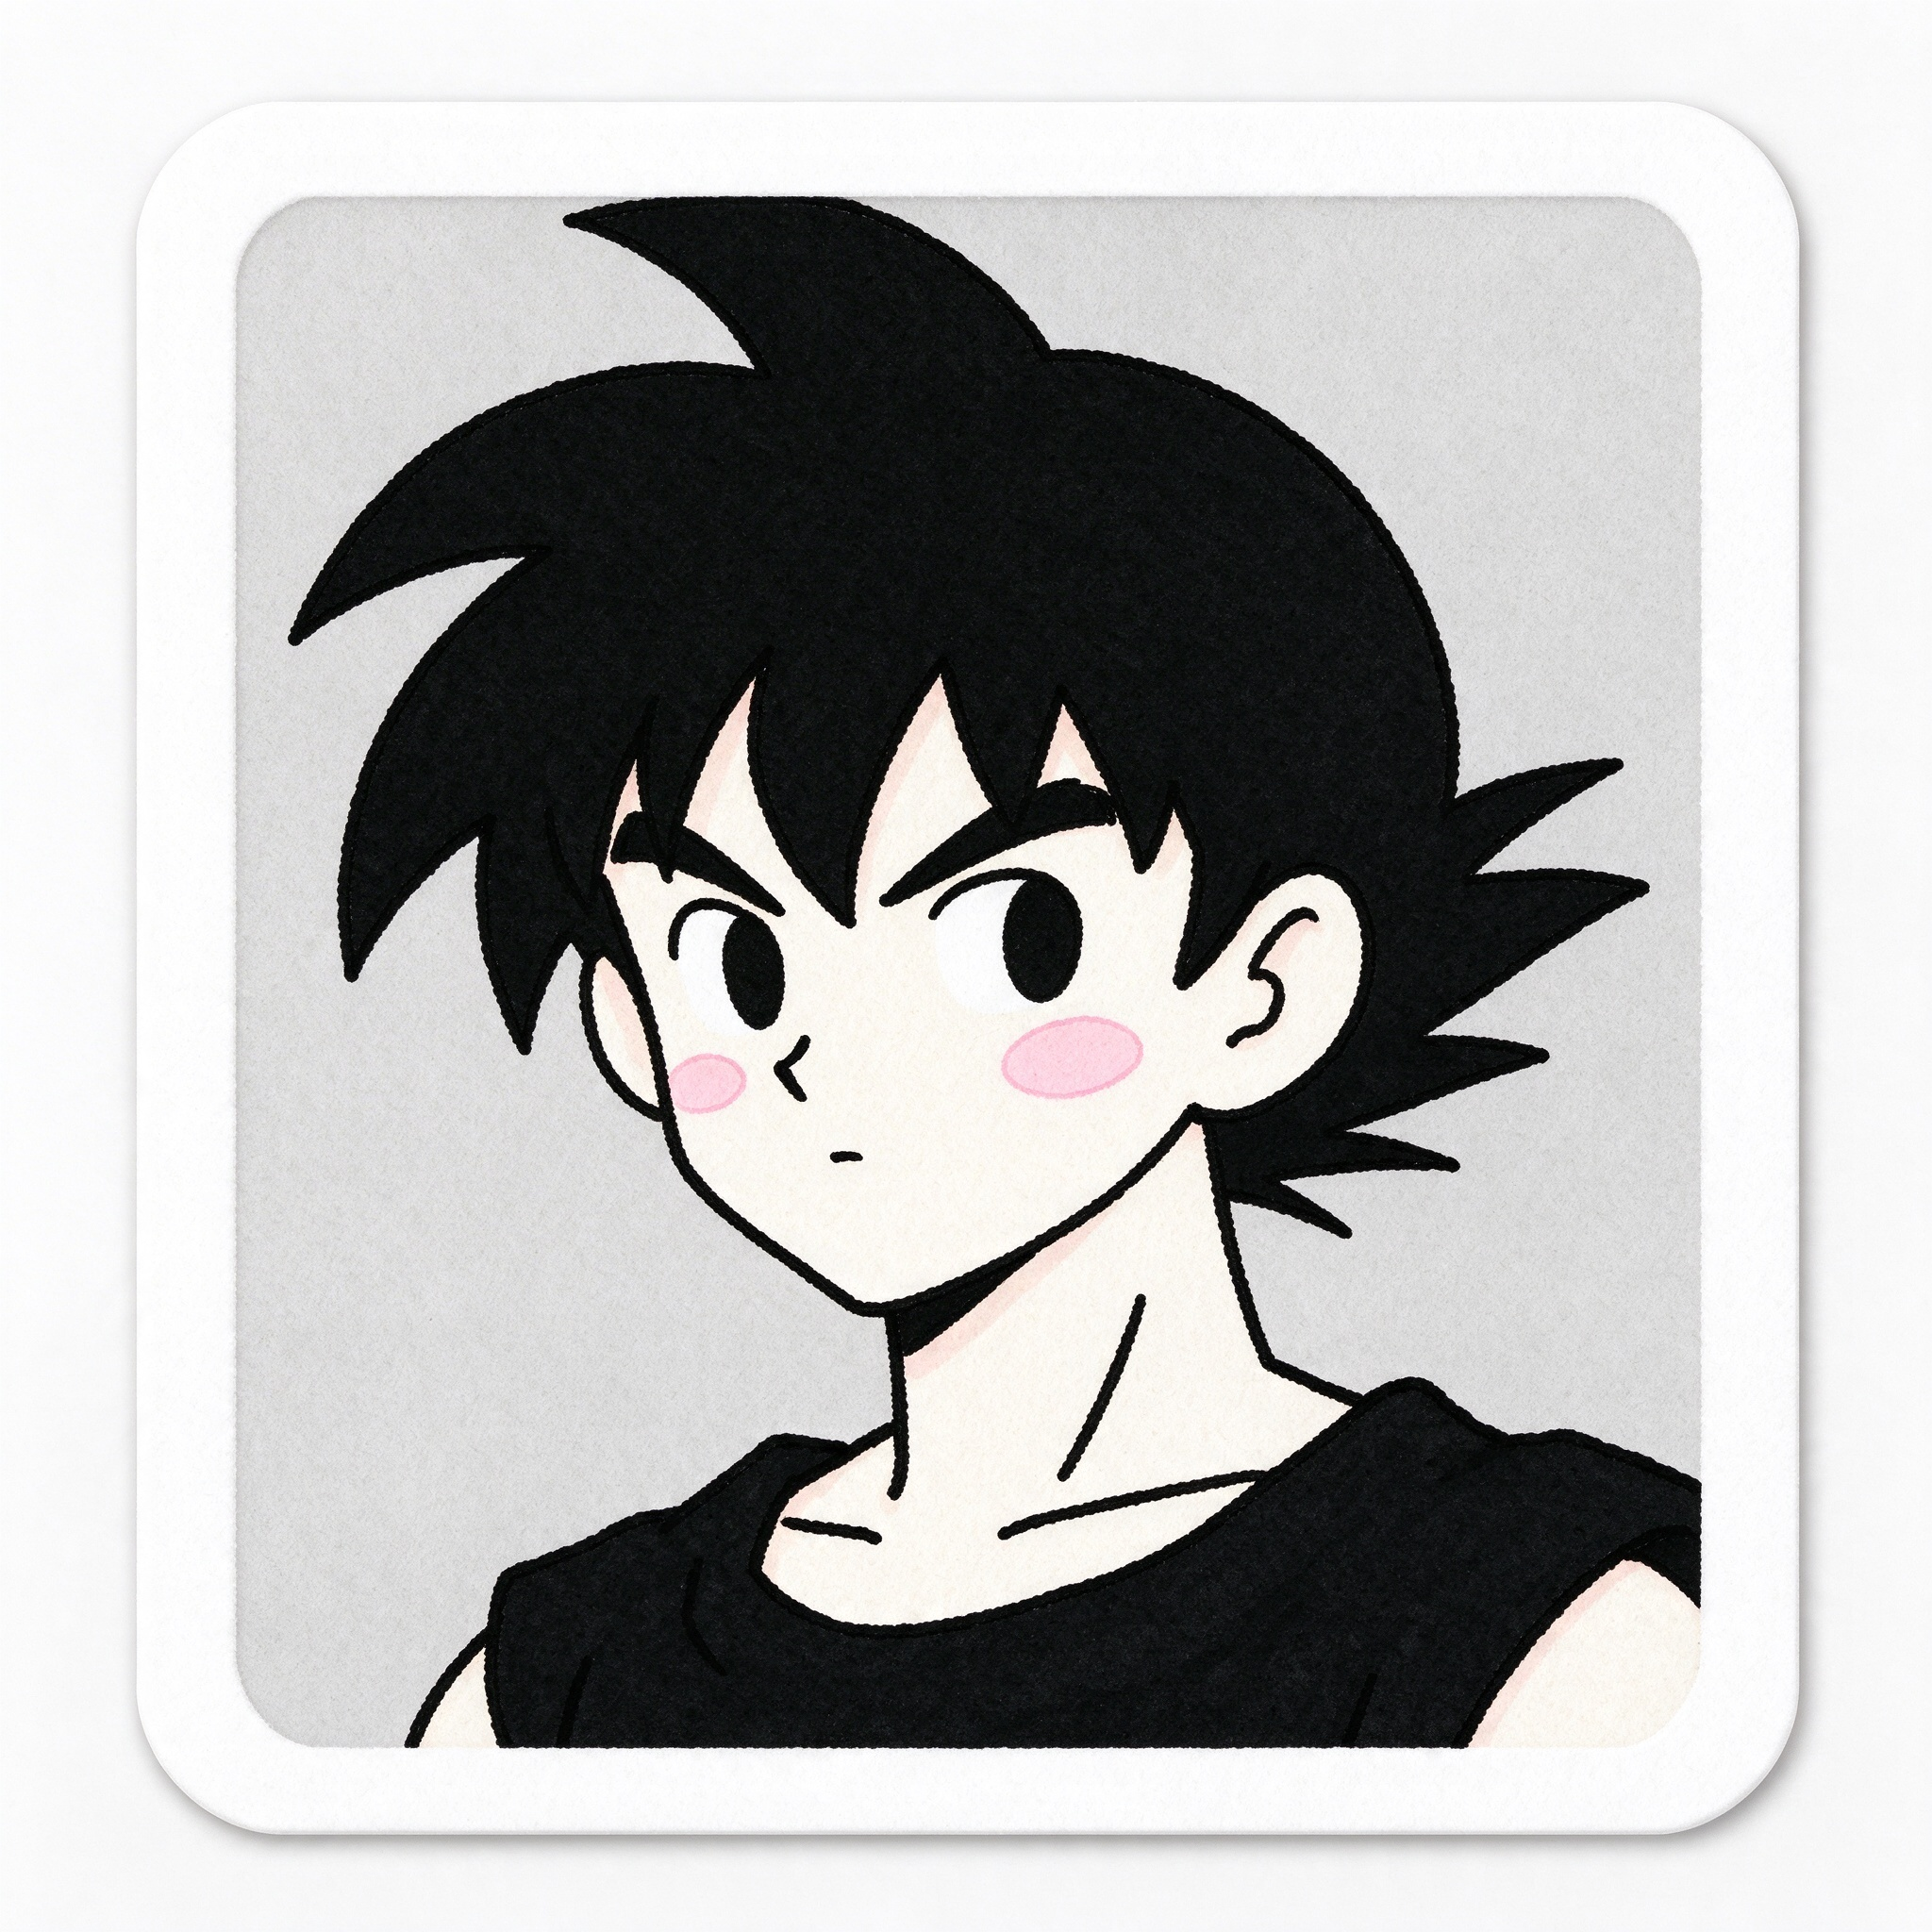
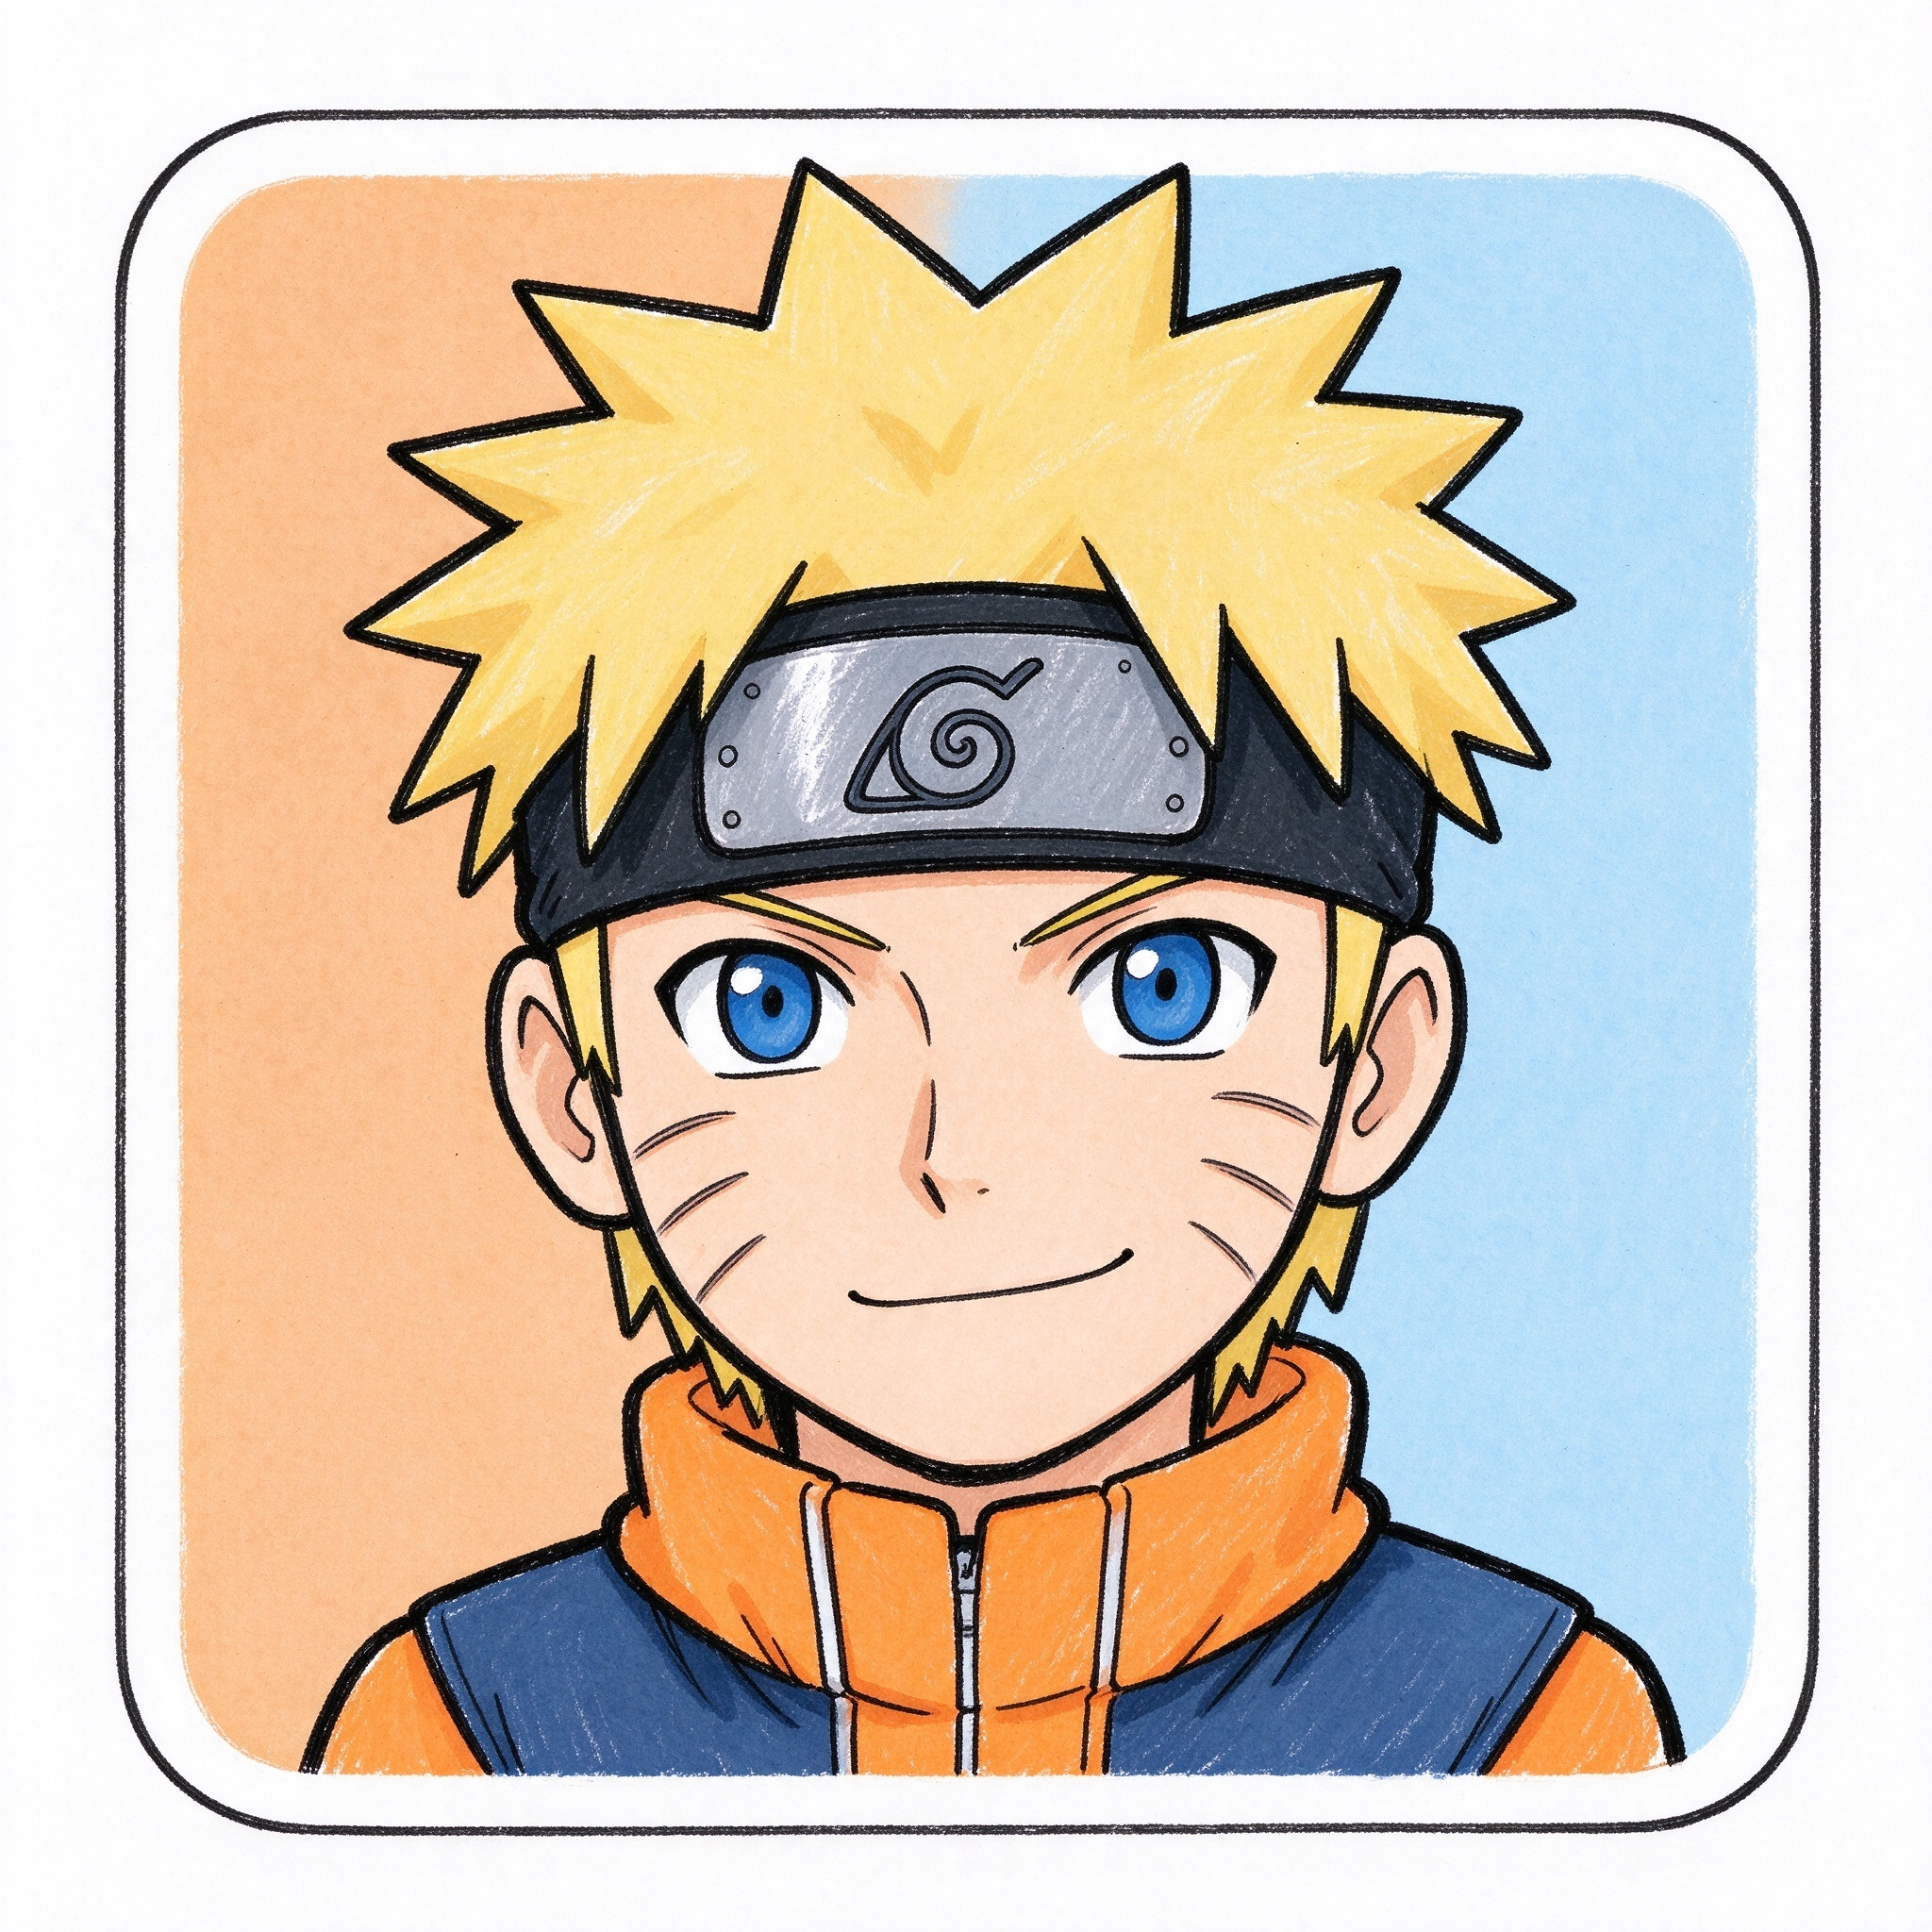
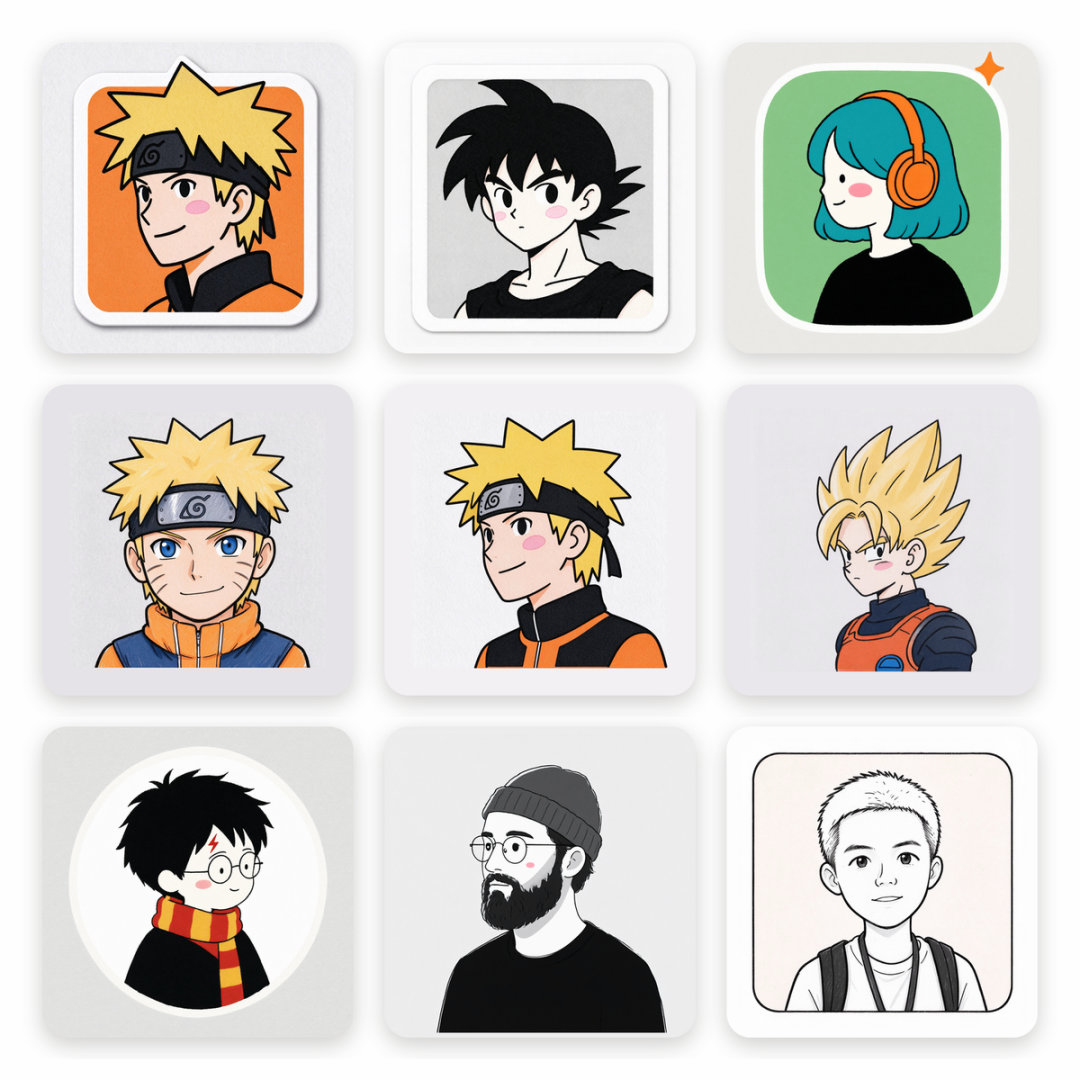
嘿,AI 来了可太好了。 周末我看到有人分享了图中风格的头像,尝试把它复刻出来,便得到了这张九宫格大图。
我用 AI 分析、拆解成了 Skill,现在可以想用上自己喜欢的人物/心爱的照片当头像,非常轻松和方便了。
它有两种风格:颜色、黑白,可以任意选择一种让 AI 生成,再挑我们喜欢的就行。
后续还想尝试下制作静态壁纸、动态壁纸
我用最久也是最喜欢的一张头像,是《火影忍者》剧场版中,小鸣人和小雏田在雪中灯下的场景,鸣人那童真的笑容和雏田萌萌的神态。
动漫、电影中某个被触动的画面,想经历、体验的人生故事,或与人物共鸣。 我们就会把那一帧,当作壁纸、背景或头像。
在 Pinterest 可以看到非常多二创内容,很好看、清晰,它们就像 POP MART 陈列起来,自己喜欢的人物、场景仿佛活了起来。
但我有个毛病:总是删数据,特别是图片、视频。不光占用内存空间,还有那一个个的图片、视频数量。
以前,我是讲它发到自媒体平台,发完就把手机里的删了——现在改了,用电脑Obsidian组织,就清晰很多(以后的帖子与大家分享)。
分享类的还好,但像头像这种需要不同地方使用,重新下载又会损失画质,导致越来越模糊。 同时,一个场景很难找到,找到了可能也不是最想要的那一帧,这是最让人沮丧的。
嘿,AI 来了可太好了。 周末我看到有人分享了图中风格的头像,尝试把它复刻出来,便得到了这张九宫格大图。
我用 AI 分析、拆解成了 Skill,现在可以想用上自己喜欢的人物/心爱的照片当头像,非常轻松和方便了。
它有两种风格:颜色、黑白,可以任意选择一种让 AI 生成,再挑我们喜欢的就行。
后续还想尝试下制作静态壁纸、动态壁纸
0 00
把想法说出来,就开始完成了
很多时候,对一件感兴趣、想做的事情,使用“外力”推进更为轻松。
例如,宅家很久想出门、准备录制一档播客节目。
但想到要换衣服,思考节目名称、节目定位、封面和介绍,各种还没做、没头绪的事情就难以进行。
我在 不会设计,却通过 AI 做出了一套插画 Skill 中也分享到,可以用 AI 很方便做东西,但想着最终目标结果就有很大的无力感;我便通过「5分钟法则」,先把一眼看到的 软件Logo、软件名称做出来。
像跟朋友分享想法一样,把它说给 AI 听听,我们看结果,「5分钟法则」应验后,事便开始了。
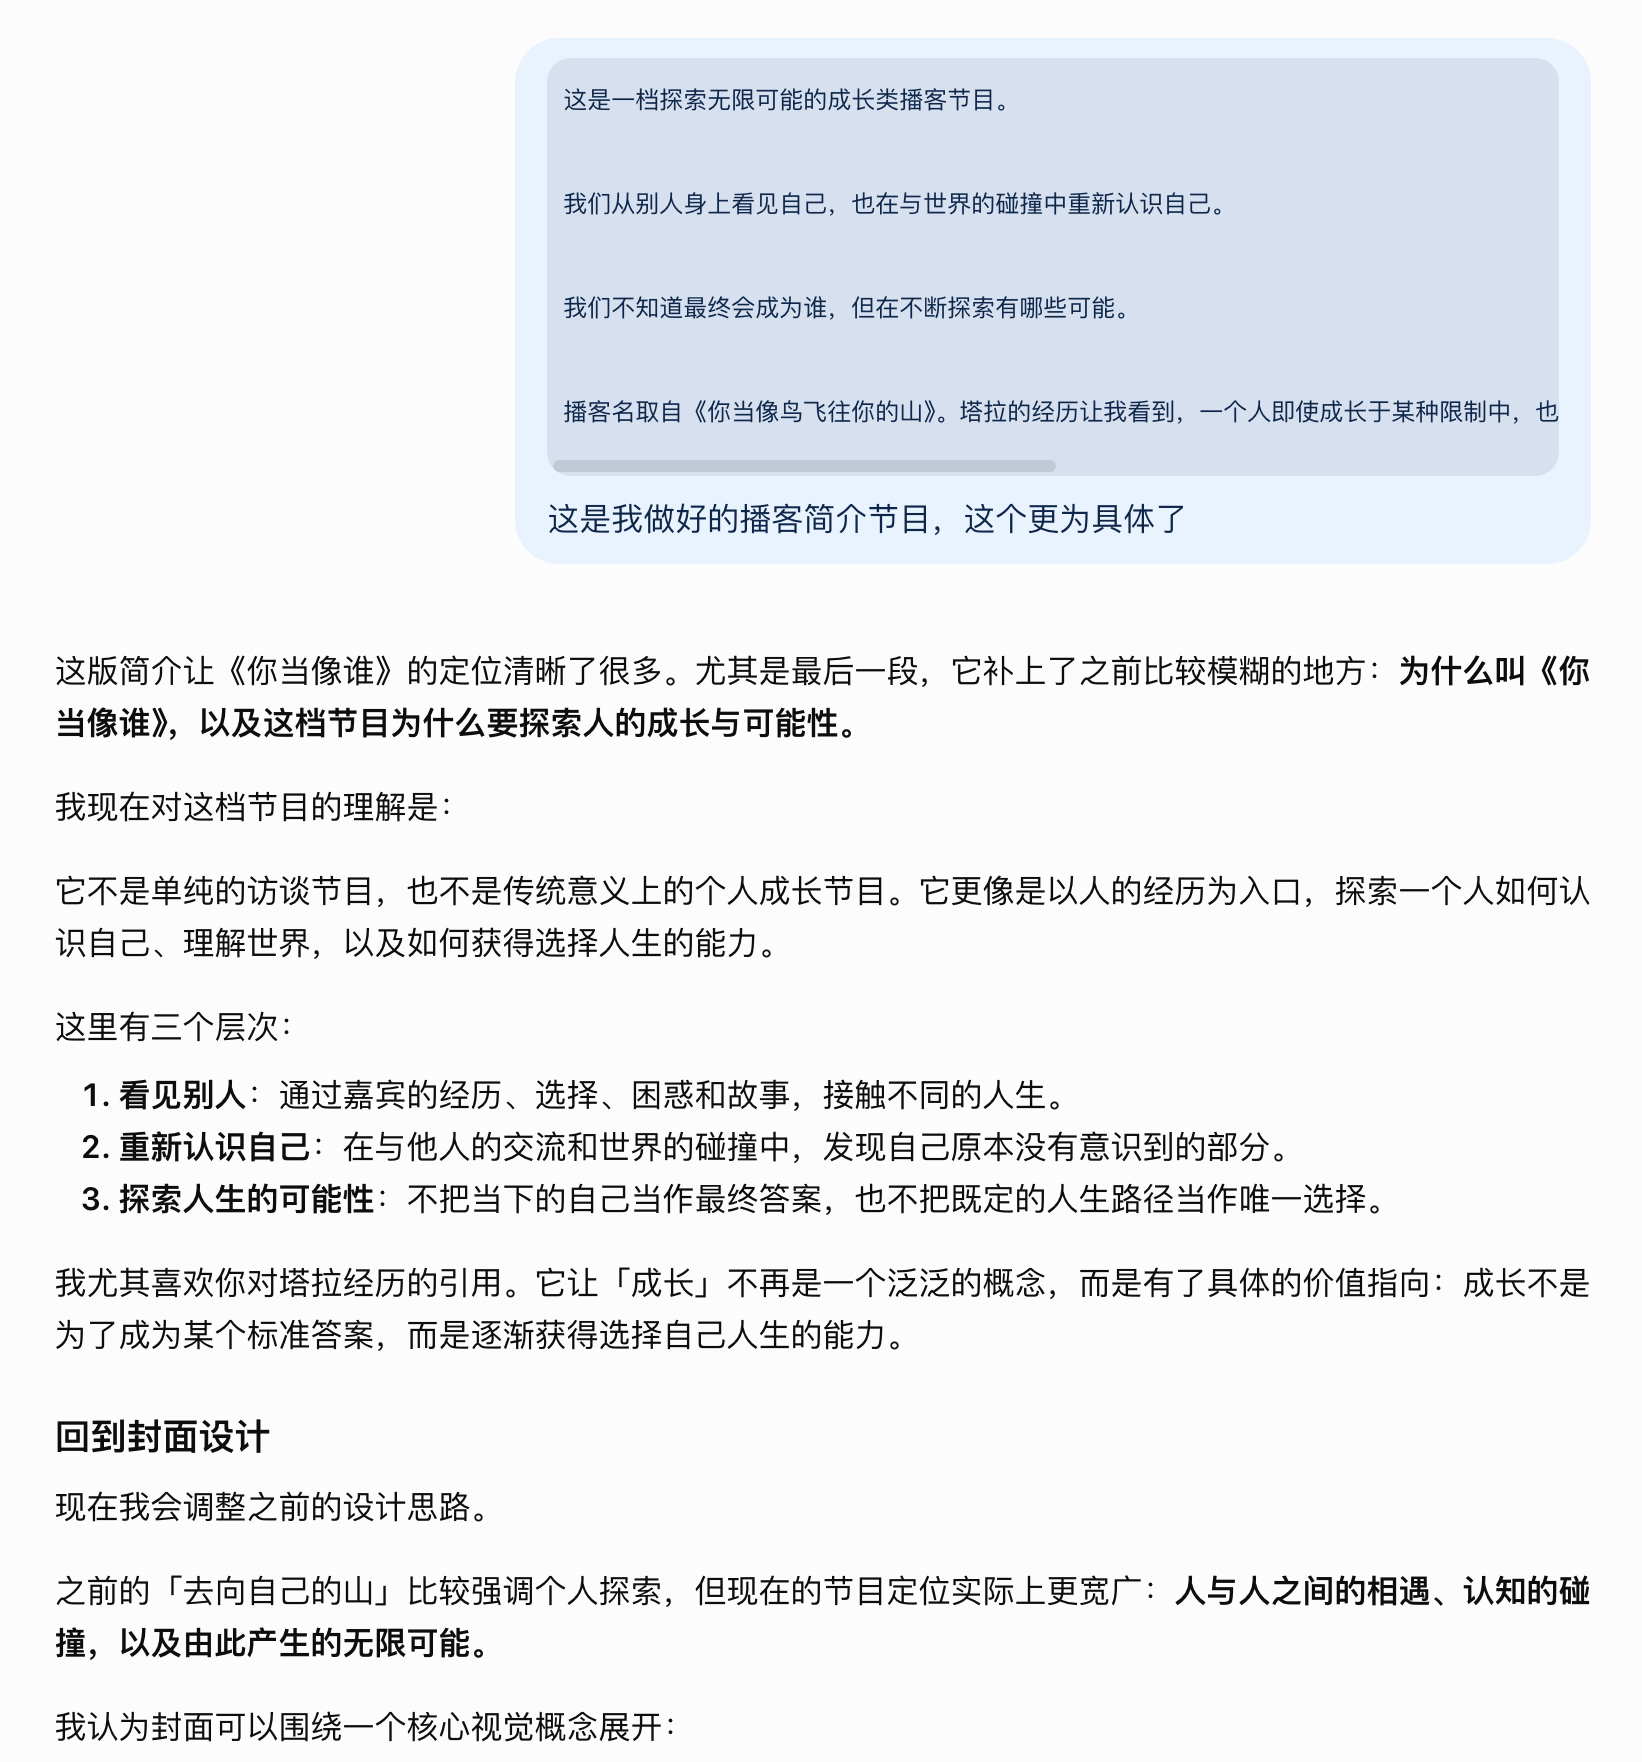
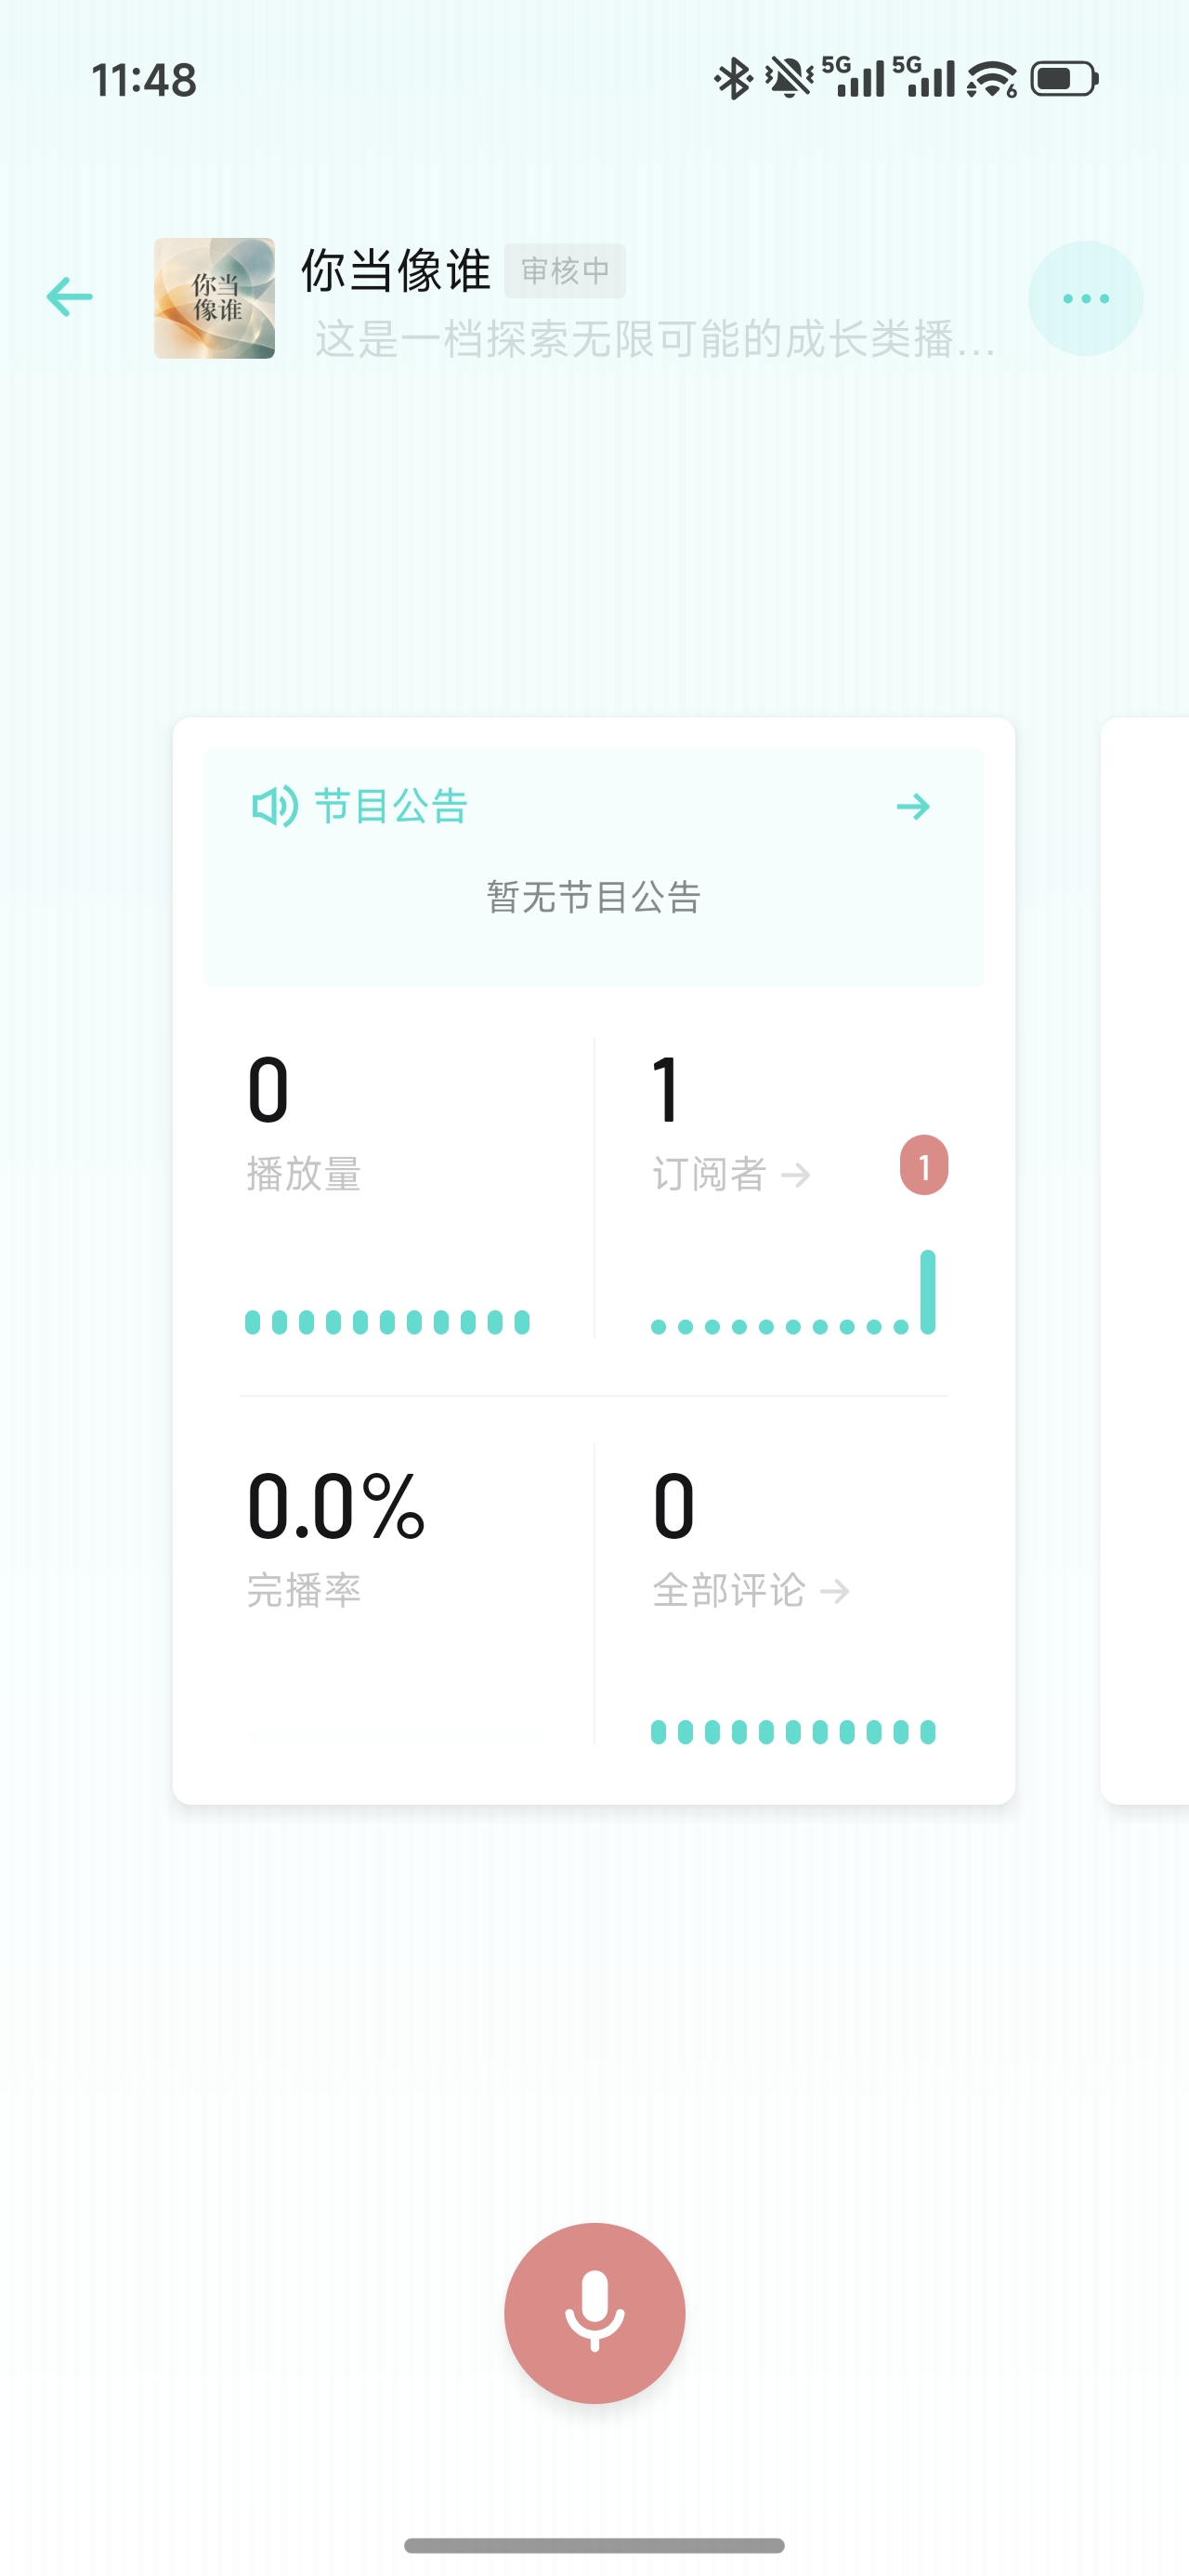
这篇分享了我如何将它运用到,新开的一档新播客《你当像谁》中。
10月31号参加完小宇宙播客创作者线下活动时,触发的灵感,寓意取自《你当像鸟飞往你的山》。
塔拉的经历让我看到,一个人即使成长于某种限制中,也可以通过教育、接触外部世界、重新认识自己,为之付出行动,逐渐获得选择人生的能力。
原来一直不知道如何向别人介绍自己、表达自己,面对自我介绍的问题就懵了。
我想,在这档新播客节目里,去向我的山。
想法都有了,我就跟 GPT 一起讨论定位、面向群体,一切妥当后设计播客 Logo
从 创作者视角 切到 受众视角,需要理解和转换的时间——这篇已修改后的分享也是一次尝试。
我向 GPT 学习,如何从受众视角来思考,如:如何起标题、如何写好内容叙事?
这项能力,我不想外包给 AI,所以便让它引导我如何具体地思考。
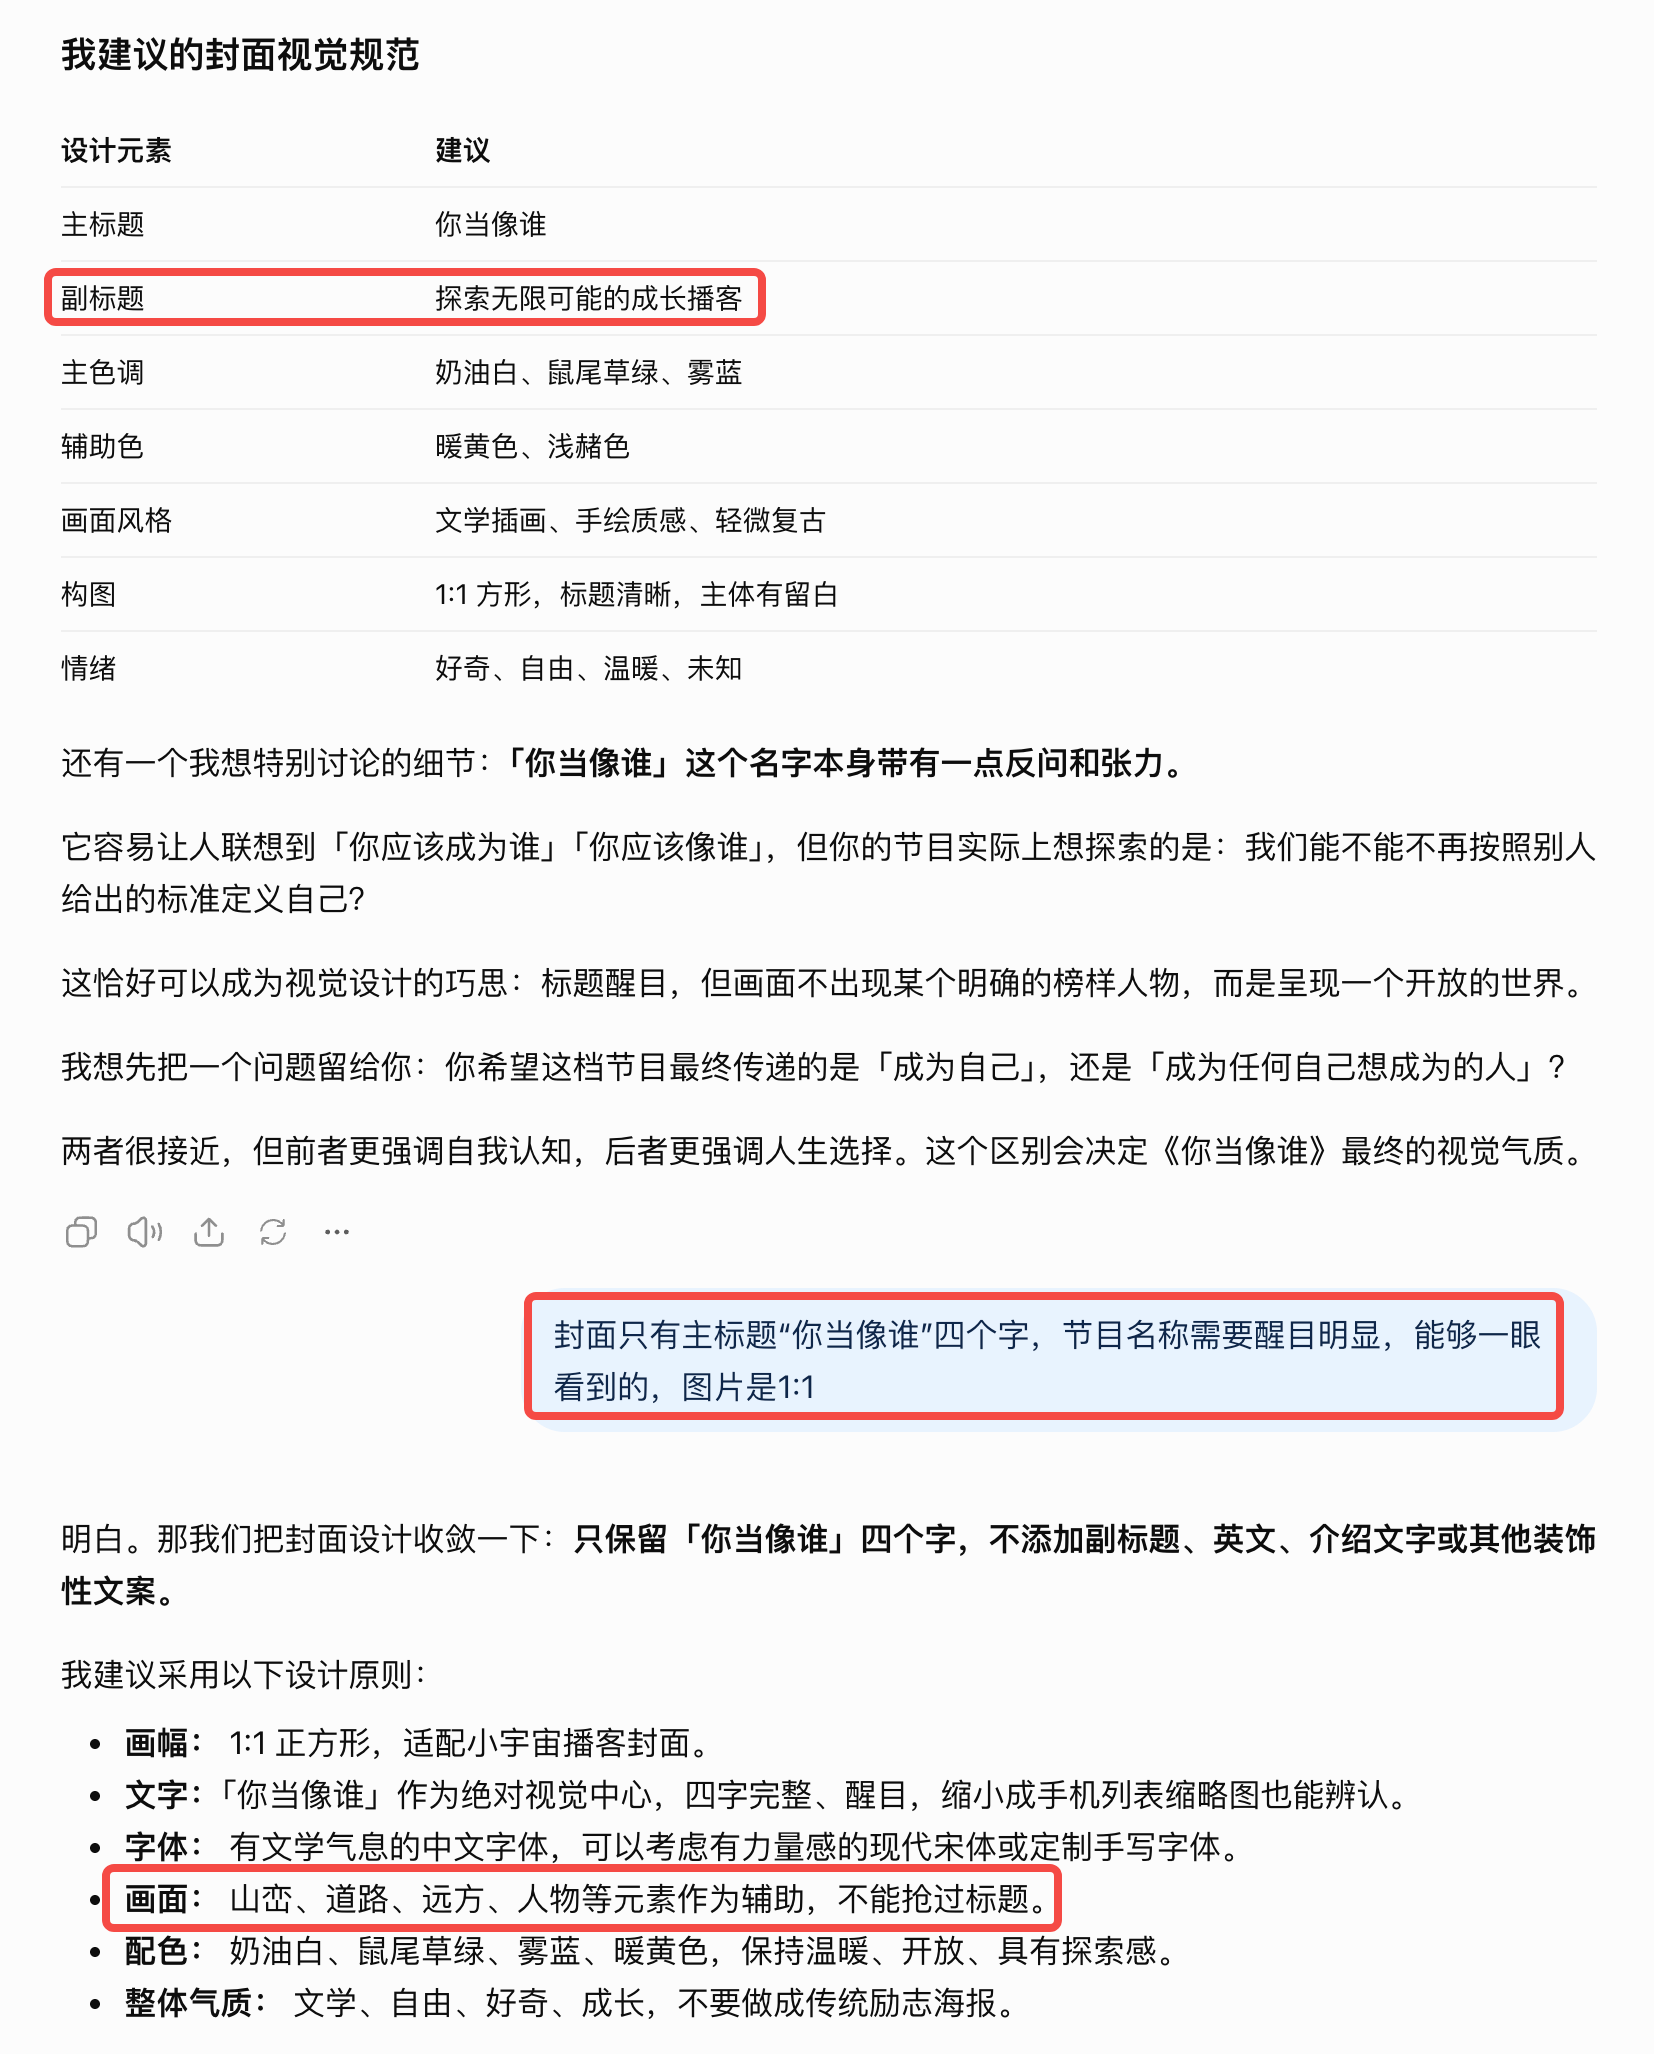
第一轮,打眼一看还挺好。细看,它想做成海报设计,对播客 Logo 就是“杂乱无章”。
于是指出,只需节目名作标题。
但AI 有个毛病:在已知信息中找相关。:山、蜿蜒道路、远方。
啊!!不行,绝对不行!太刻板印象、老气。
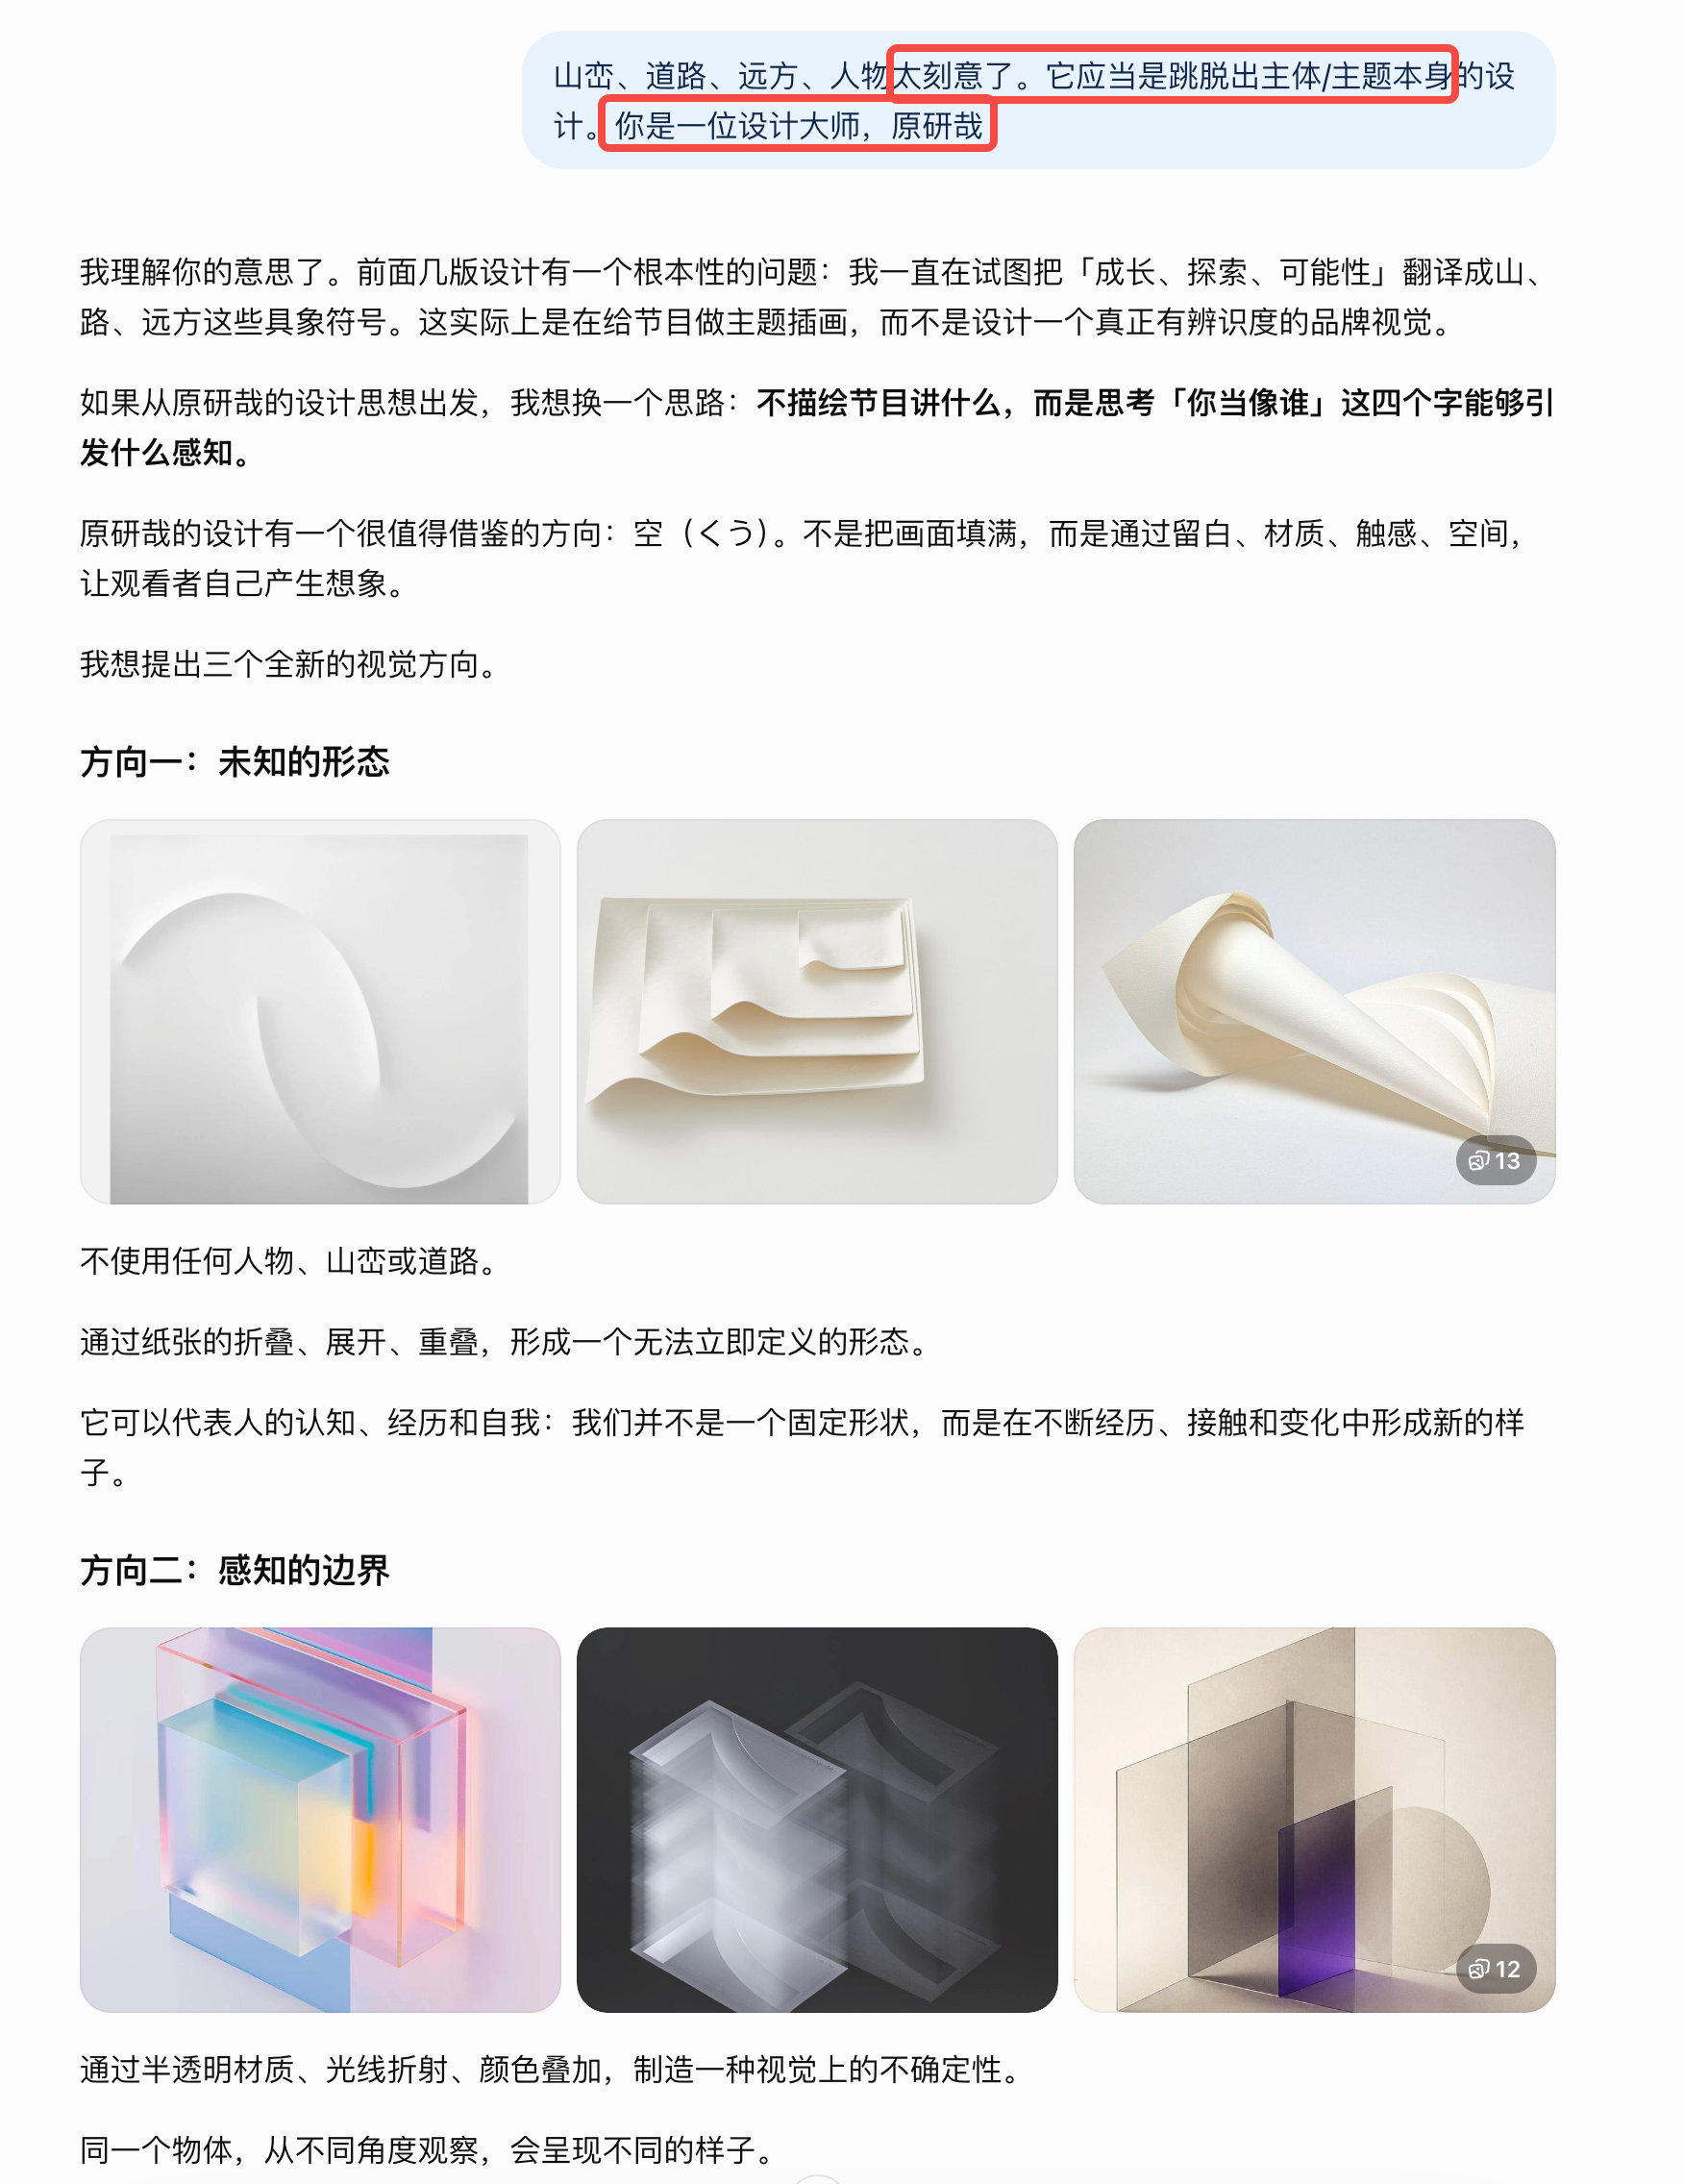
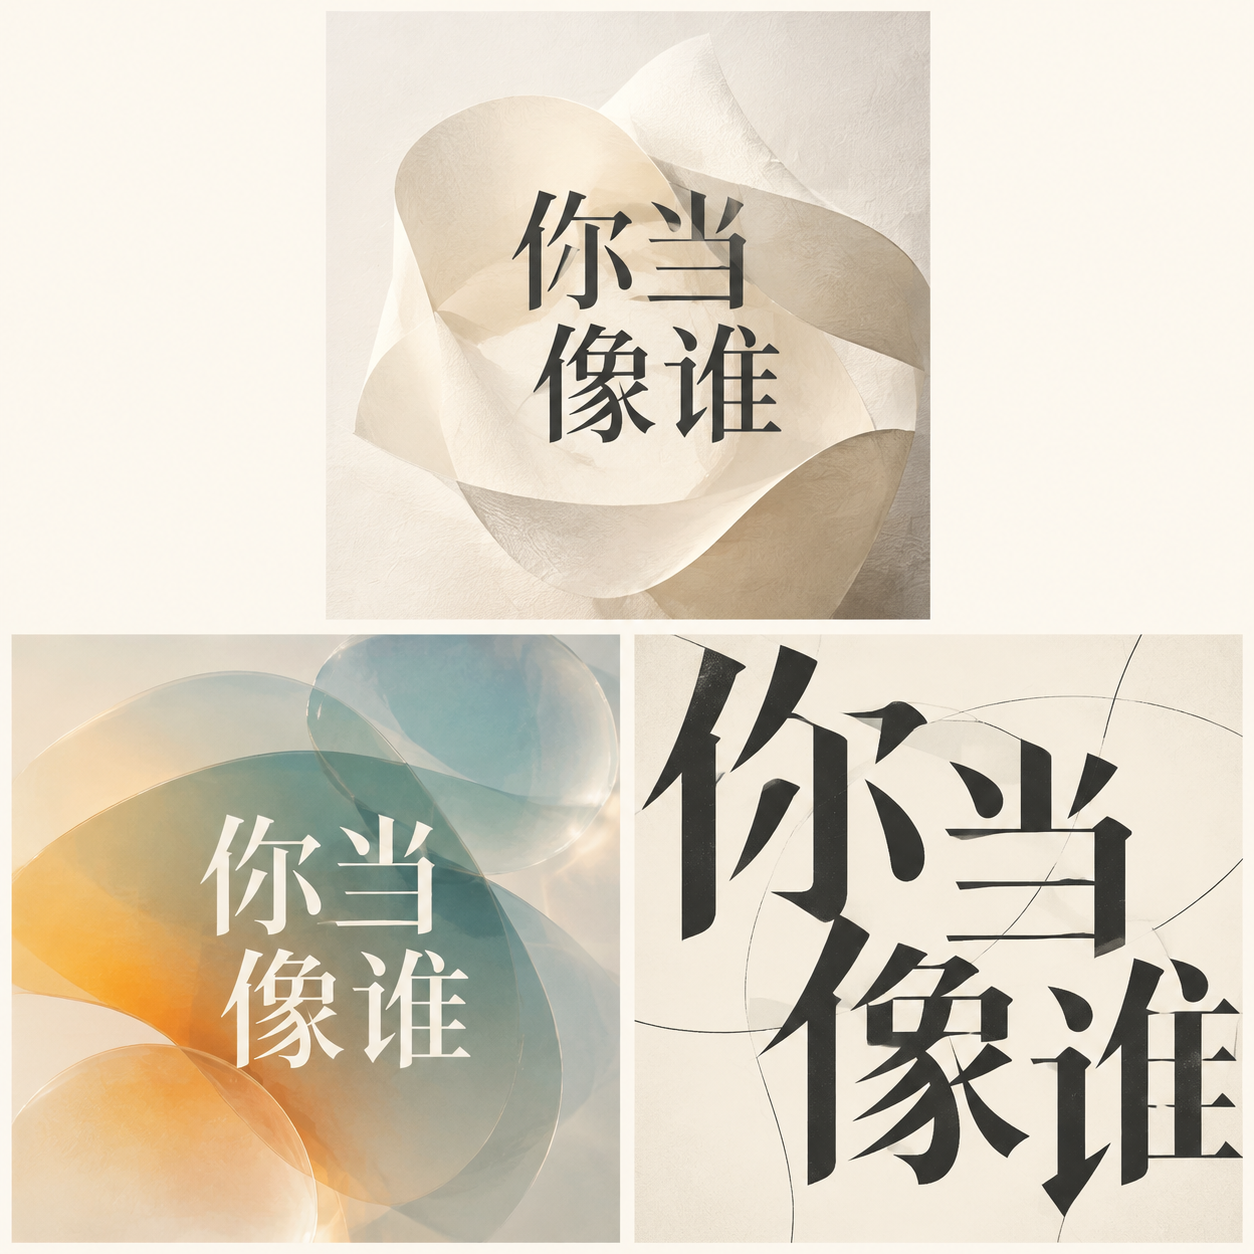
于是在提示词中加上:原研哉(图三)。设计、视觉、审美直接拉高了好几个档次(图四)。
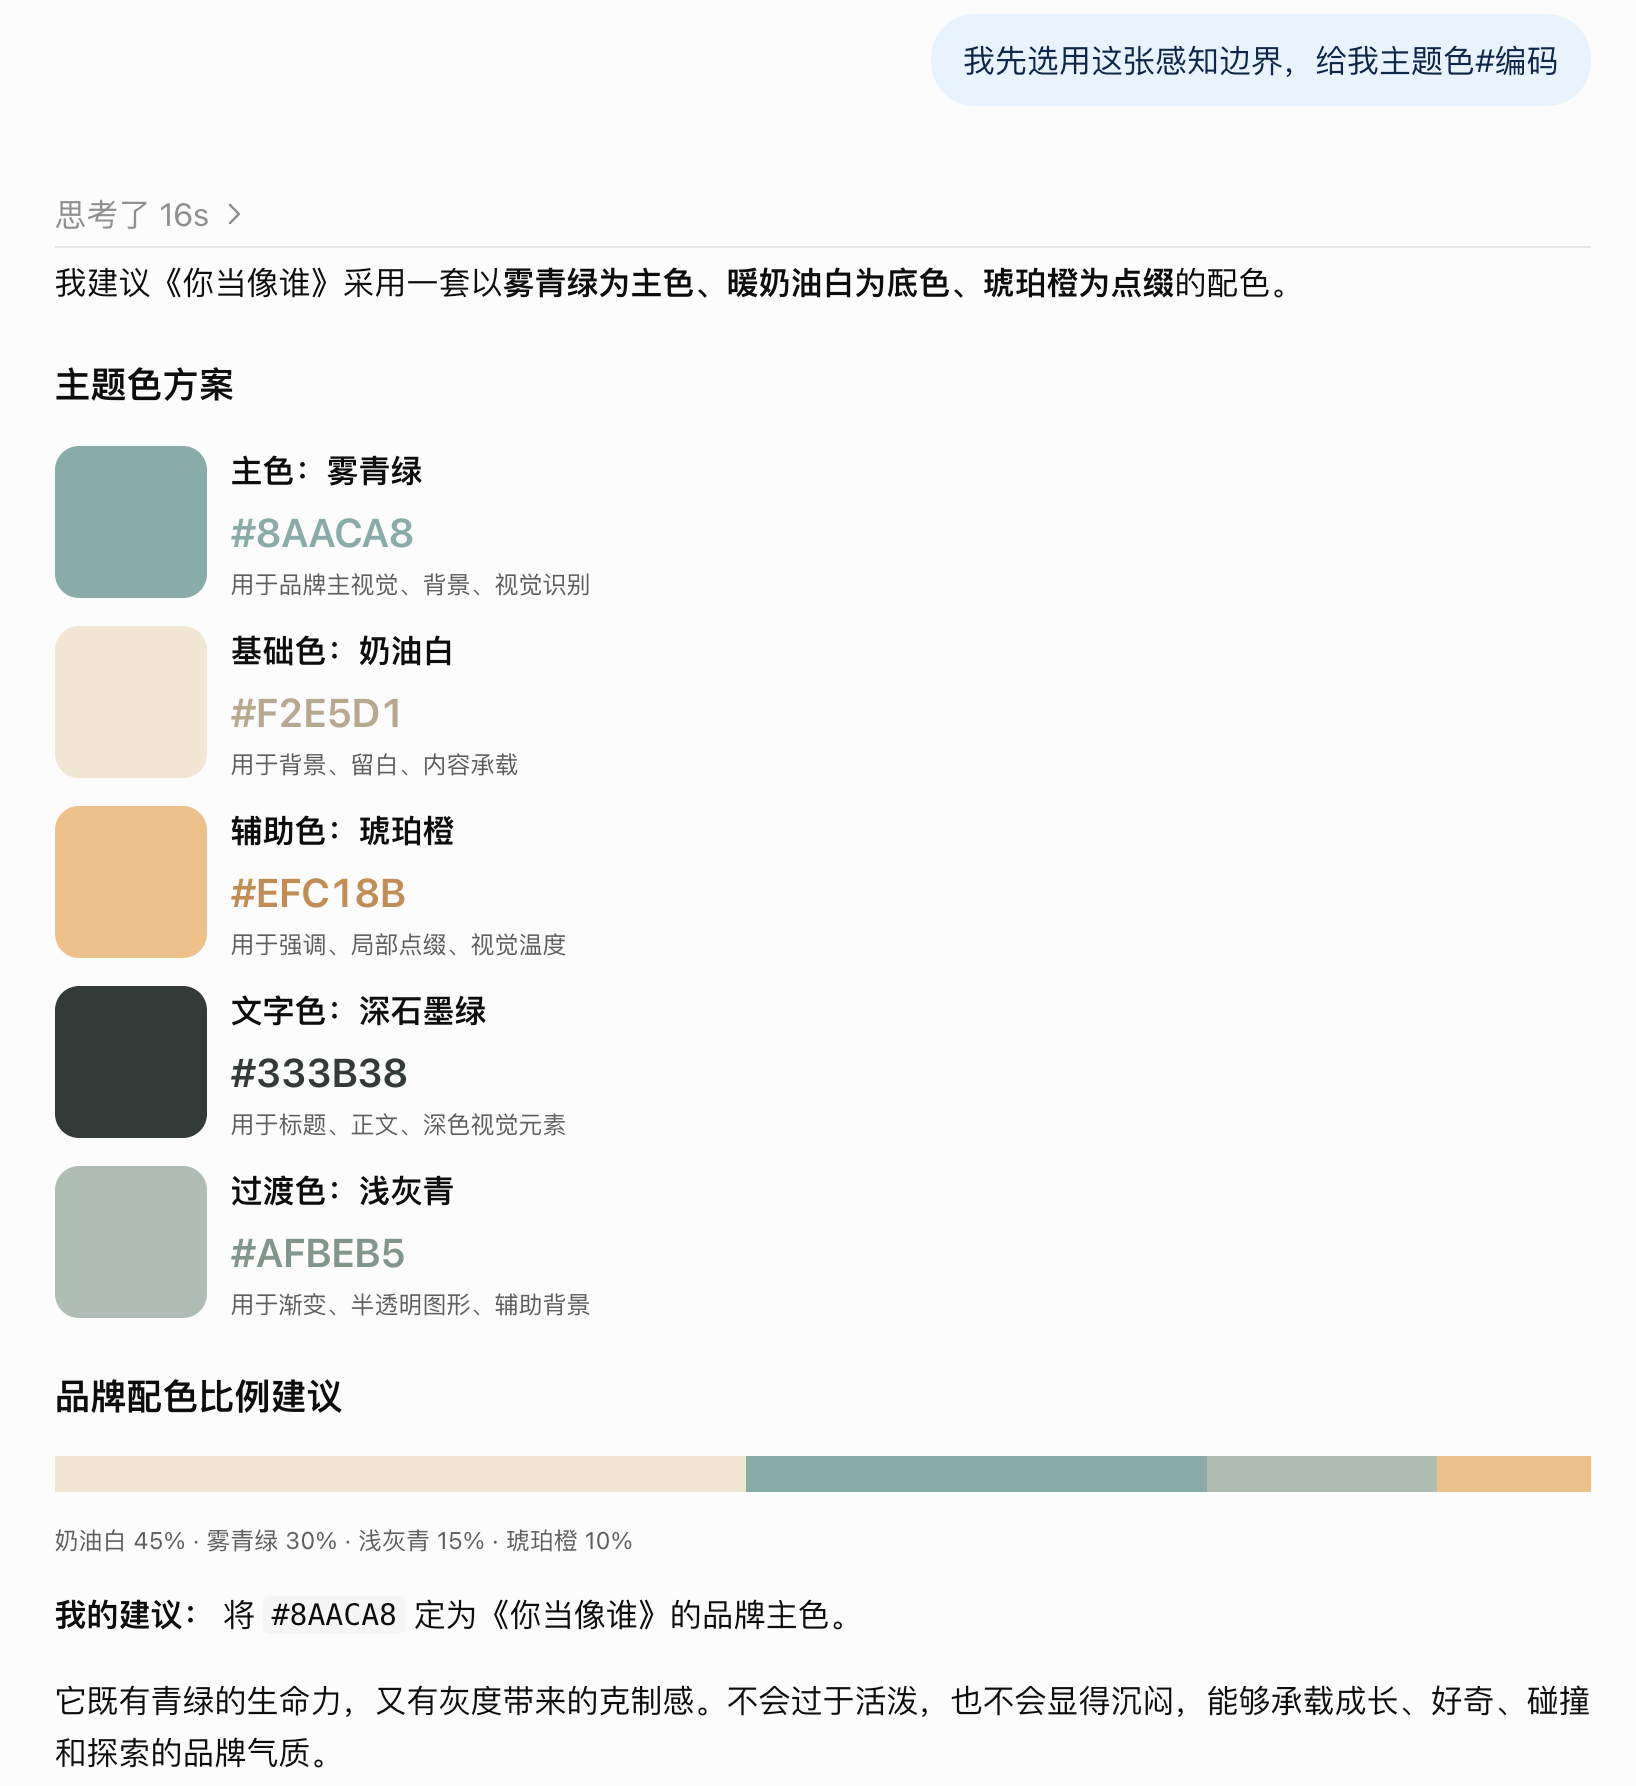
颜色很多,主色选哪个呢?
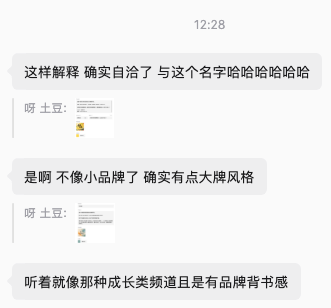
也让 AI 出主意,给出精确的 # 颜色编码,于是整个节目定好调(图6),朋友说:“这档节目封面有范”。
到这里感觉大功告成,都做到这份上了,总不能没有后续吧?
选题、内容、录制、剪辑,这些都可以开始了。
很多时候,对一件感兴趣、想做的事情,使用“外力”推进更为轻松。
例如,宅家很久想出门、准备录制一档播客节目。
但想到要换衣服,思考节目名称、节目定位、封面和介绍,各种还没做、没头绪的事情就难以进行。
我在 不会设计,却通过 AI 做出了一套插画 Skill 中也分享到,可以用 AI 很方便做东西,但想着最终目标结果就有很大的无力感;我便通过「5分钟法则」,先把一眼看到的 软件Logo、软件名称做出来。
像跟朋友分享想法一样,把它说给 AI 听听,我们看结果,「5分钟法则」应验后,事便开始了。
这篇分享了我如何将它运用到,新开的一档新播客《你当像谁》中。
10月31号参加完小宇宙播客创作者线下活动时,触发的灵感,寓意取自《你当像鸟飞往你的山》。
塔拉的经历让我看到,一个人即使成长于某种限制中,也可以通过教育、接触外部世界、重新认识自己,为之付出行动,逐渐获得选择人生的能力。
原来一直不知道如何向别人介绍自己、表达自己,面对自我介绍的问题就懵了。
我想,在这档新播客节目里,去向我的山。
想法都有了,我就跟 GPT 一起讨论定位、面向群体,一切妥当后设计播客 Logo
从 创作者视角 切到 受众视角,需要理解和转换的时间——这篇已修改后的分享也是一次尝试。
我向 GPT 学习,如何从受众视角来思考,如:如何起标题、如何写好内容叙事?
这项能力,我不想外包给 AI,所以便让它引导我如何具体地思考。
第一轮,打眼一看还挺好。细看,它想做成海报设计,对播客 Logo 就是“杂乱无章”。
于是指出,只需节目名作标题。
但AI 有个毛病:在已知信息中找相关。:山、蜿蜒道路、远方。
啊!!不行,绝对不行!太刻板印象、老气。
于是在提示词中加上:原研哉(图三)。设计、视觉、审美直接拉高了好几个档次(图四)。
颜色很多,主色选哪个呢?
也让 AI 出主意,给出精确的 # 颜色编码,于是整个节目定好调(图6),朋友说:“这档节目封面有范”。
到这里感觉大功告成,都做到这份上了,总不能没有后续吧?
选题、内容、录制、剪辑,这些都可以开始了。
0 00
下班出地铁口后,看到从我7月线下实习到现在,每天必过的那条路,连关三家大门面的餐饮店。
平时、周末走过看都有很多人在吃,没想到晚上回来竟开始拆门店了……
公司附近这一年多,也有不少餐饮店不停更替,最快的没到两个月就关门。
平时、周末走过看都有很多人在吃,没想到晚上回来竟开始拆门店了……
公司附近这一年多,也有不少餐饮店不停更替,最快的没到两个月就关门。
0 00
利用 AI 制作有品位的播客作品封面
昨天参加完小宇宙创作者线下活动时,打算新开一档播客节目《你当像谁》
寓意是取自《你当像鸟飞往你的山》。
塔拉的经历让我看到,一个人即使成长于某种限制中,也可以通过教育、接触外部世界、重新认识自己,为之付出行动,逐渐获得选择人生的能力。
这让我知道,原来一直不知道如何向别人介绍自己、表达自己。即使我做着各种事情、得到各类成果,但面对这个问题就懵了。
我想,在这档新播客节目里,去向我的山。
也是探索无限可能的成长类播客节目。
我们从别人身上看见自己,也在与世界的碰撞中重新认识自己。我们不知道最终会成为谁,但在不断探索有哪些可能。
目标定位好后,跟 GPT 一起设计封面。
第一轮,打眼一看还挺好。细一看,它想做成海报设计那种。
我就指出只需要节目名作为标题。
但AI 有个毛病,就是在已知信息中找相关性。
它就给出已知信息:山、蜿蜒道路、远方。
啊!!不行,绝对不行!也太刻板印象、老气了。
于是我在提示词中加上:原研哉(图三)。
设计、视觉、审美直接拉高了好几个档次(图四)。
颜色很多,主色选哪个呢?
也让 AI 出出主意,让他给出精确的 # 颜色编码,于是整个节目定调(图6)
朋友说:“这档节目封面有范”。接下来就看选题和内容本身了
昨天参加完小宇宙创作者线下活动时,打算新开一档播客节目《你当像谁》
寓意是取自《你当像鸟飞往你的山》。
塔拉的经历让我看到,一个人即使成长于某种限制中,也可以通过教育、接触外部世界、重新认识自己,为之付出行动,逐渐获得选择人生的能力。
这让我知道,原来一直不知道如何向别人介绍自己、表达自己。即使我做着各种事情、得到各类成果,但面对这个问题就懵了。
我想,在这档新播客节目里,去向我的山。
也是探索无限可能的成长类播客节目。
我们从别人身上看见自己,也在与世界的碰撞中重新认识自己。我们不知道最终会成为谁,但在不断探索有哪些可能。
目标定位好后,跟 GPT 一起设计封面。
第一轮,打眼一看还挺好。细一看,它想做成海报设计那种。
我就指出只需要节目名作为标题。
但AI 有个毛病,就是在已知信息中找相关性。
它就给出已知信息:山、蜿蜒道路、远方。
啊!!不行,绝对不行!也太刻板印象、老气了。
于是我在提示词中加上:原研哉(图三)。
设计、视觉、审美直接拉高了好几个档次(图四)。
颜色很多,主色选哪个呢?
也让 AI 出出主意,让他给出精确的 # 颜色编码,于是整个节目定调(图6)
朋友说:“这档节目封面有范”。接下来就看选题和内容本身了
0 00