即刻App年轻人的同好社区
下载
 置顶
现在,通过 vibe coding 为 1000 个人手工打造软件变得可行了,前提是产品真正为这 1000 个人着想,而不是粗制滥造,让用户愿意为软件付费,如果订阅费在除去所需成本后能够养活自己,那就更好了。
这是个人创作的好时代,想法不值钱,只有做出真正的产品,为用户服务,解决问题的软件才真正值钱。
这是个人创作的好时代,想法不值钱,只有做出真正的产品,为用户服务,解决问题的软件才真正值钱。
像匠人一样做软件,把产品当手工艺品
0 00
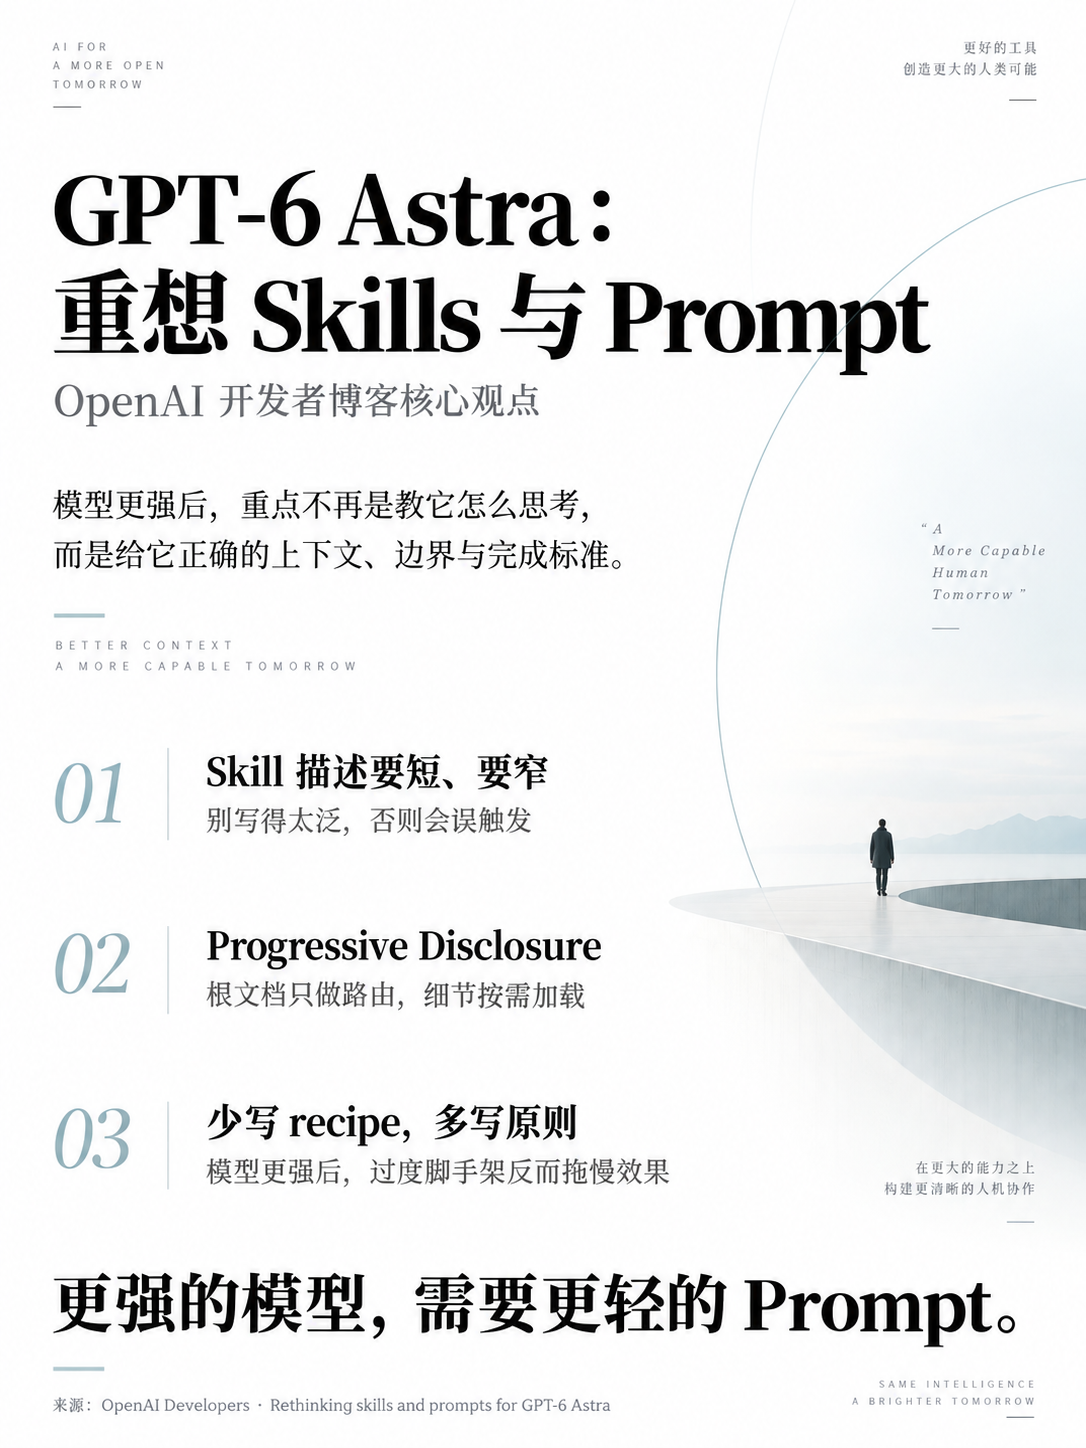
随着模型能力变强,过去很多为了“扶着模型完成任务”而加入的规则,开始变得没有那么必要了。
以前做 Agent,经常会在 Prompt 里写很多流程:
先读哪些文件、先规划还是先搜索、修改之后必须测试、失败之后继续重试、什么时候需要确认、什么时候才能结束。
这些规则在模型能力还不够稳定的时候很有用,但随着模型本身越来越擅长理解任务、判断上下文和检查结果,过多的规则反而可能带来额外负担。
首先是 Skill。
Skill 的描述应该尽量短,而且边界清楚。它主要是帮助模型判断“什么时候需要使用这个 Skill”,而不是在描述里塞进大量背景和操作流程。
其次是 Progressive Disclosure。
不要一次把所有文档和规则都放进上下文。更合理的方式,是先让模型知道有哪些信息可以用,真正需要的时候再去读取对应内容。
也就是说,顶层 Skill 更像一个路由入口,而不是一本完整说明书。
另外一个变化是,少写过于具体的 recipe,多写原则和边界。
过去可能会规定 step 1、step 2、step 3,但模型越来越强之后,很多中间步骤其实可以交给模型自己判断。流程规定得太细,有时反而会限制它。
AGENTS.md 也是类似。
与其要求模型每次修改代码之前都读取完整的架构、数据库和部署文档,不如告诉它:在什么任务下,需要参考什么资料。
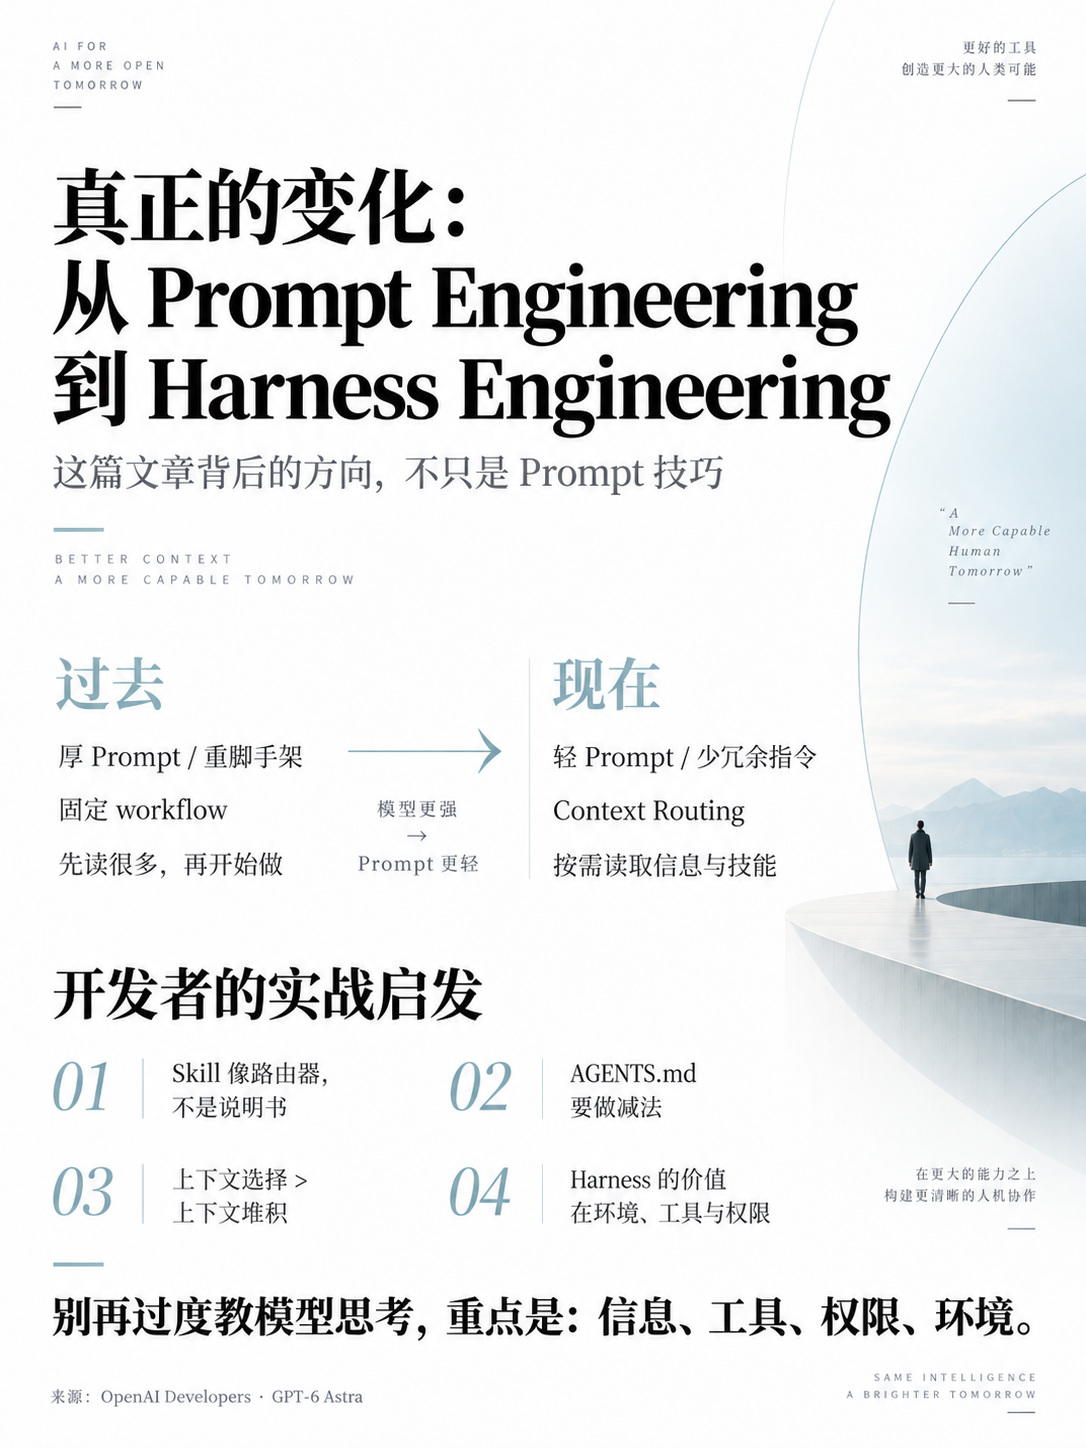
这几个变化放在一起,其实指向同一个方向:
Prompt Engineering
→ Context Engineering
→ Harness Engineering
重点逐渐从“怎么把 Prompt 写得更详细”,转向“怎么让模型拿到正确的信息和工具”。
长期来看,更稳定的部分可能不是某一版 Prompt,而是这些东西:
工具、上下文路由、权限、状态、记忆、执行环境,以及清晰的任务完成标准。
模型负责越来越多的推理和判断,系统则负责提供合适的环境。
所以未来的 Agent 未必需要越来越复杂的 Prompt。
可能恰恰相反:
模型越强,Prompt 越轻。
真正需要设计的,是模型能看到什么、能调用什么、允许做什么,以及做到什么程度才算完成。
以前做 Agent,经常会在 Prompt 里写很多流程:
先读哪些文件、先规划还是先搜索、修改之后必须测试、失败之后继续重试、什么时候需要确认、什么时候才能结束。
这些规则在模型能力还不够稳定的时候很有用,但随着模型本身越来越擅长理解任务、判断上下文和检查结果,过多的规则反而可能带来额外负担。
首先是 Skill。
Skill 的描述应该尽量短,而且边界清楚。它主要是帮助模型判断“什么时候需要使用这个 Skill”,而不是在描述里塞进大量背景和操作流程。
其次是 Progressive Disclosure。
不要一次把所有文档和规则都放进上下文。更合理的方式,是先让模型知道有哪些信息可以用,真正需要的时候再去读取对应内容。
也就是说,顶层 Skill 更像一个路由入口,而不是一本完整说明书。
另外一个变化是,少写过于具体的 recipe,多写原则和边界。
过去可能会规定 step 1、step 2、step 3,但模型越来越强之后,很多中间步骤其实可以交给模型自己判断。流程规定得太细,有时反而会限制它。
AGENTS.md 也是类似。
与其要求模型每次修改代码之前都读取完整的架构、数据库和部署文档,不如告诉它:在什么任务下,需要参考什么资料。
这几个变化放在一起,其实指向同一个方向:
Prompt Engineering
→ Context Engineering
→ Harness Engineering
重点逐渐从“怎么把 Prompt 写得更详细”,转向“怎么让模型拿到正确的信息和工具”。
长期来看,更稳定的部分可能不是某一版 Prompt,而是这些东西:
工具、上下文路由、权限、状态、记忆、执行环境,以及清晰的任务完成标准。
模型负责越来越多的推理和判断,系统则负责提供合适的环境。
所以未来的 Agent 未必需要越来越复杂的 Prompt。
可能恰恰相反:
模型越强,Prompt 越轻。
真正需要设计的,是模型能看到什么、能调用什么、允许做什么,以及做到什么程度才算完成。
0 00
快捷指令 + 操作按钮,记账无需打开 App
微信支付宝付完钱,切到记账 App,选类别、填金额、选账户……一套下来十几秒,然后下次就懒得记了。
盈余 App 将截屏与识图记账打包到一个简单的 iPhone 快捷指令了🎉
🔧 配置一次,两分钟
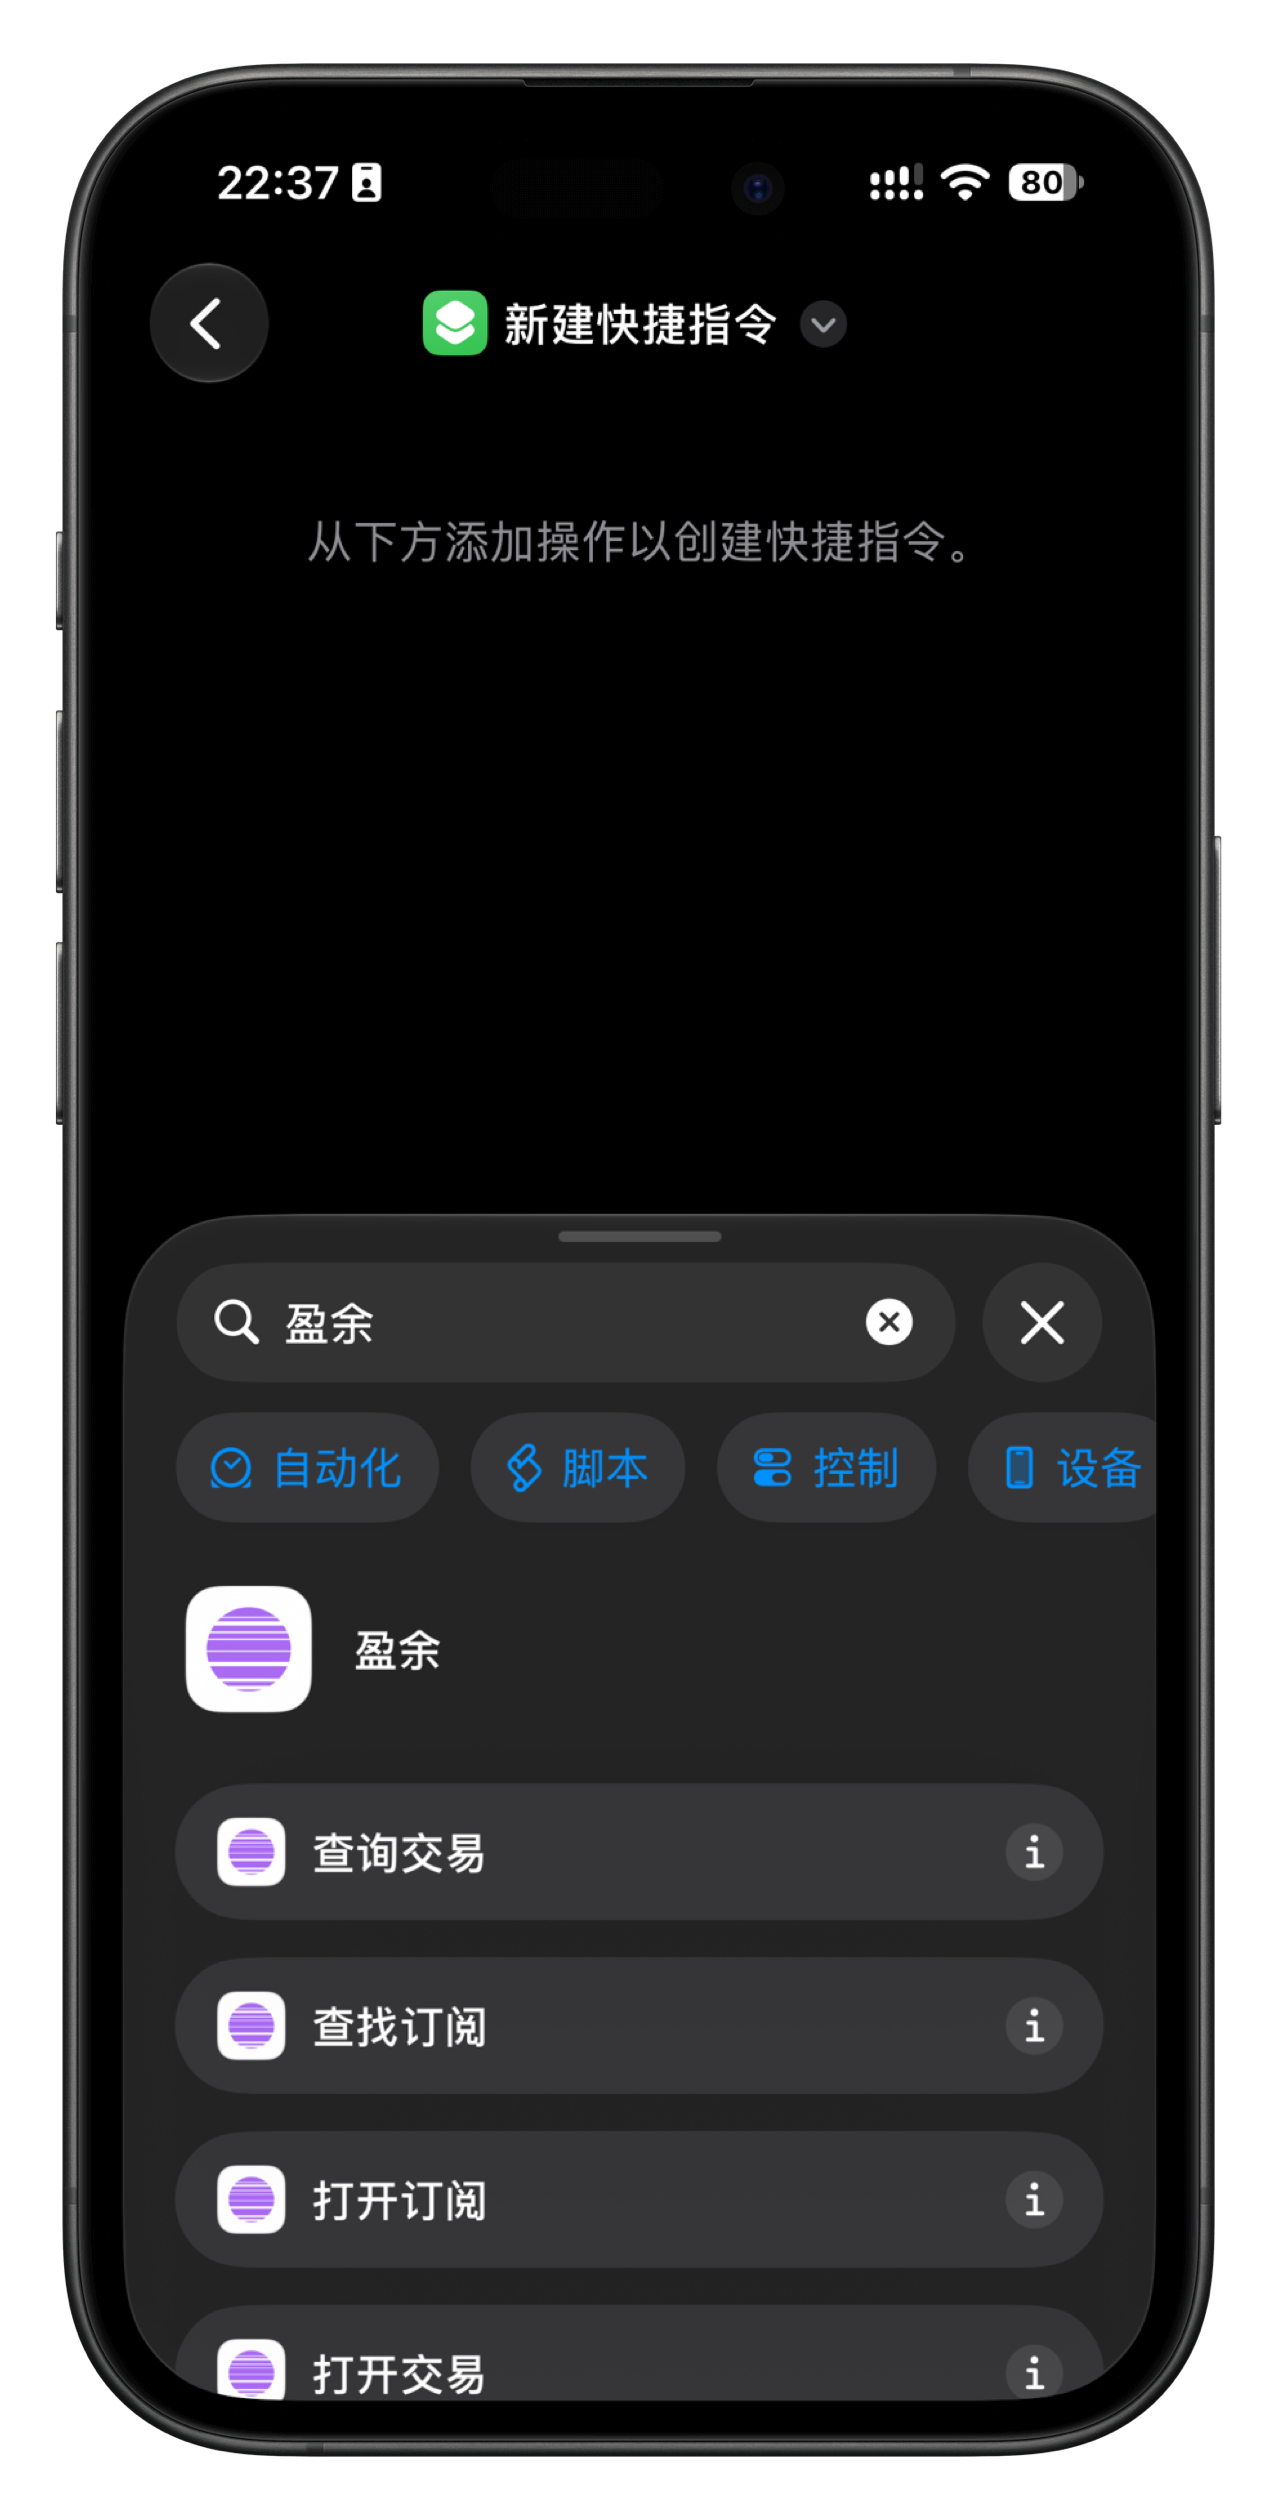
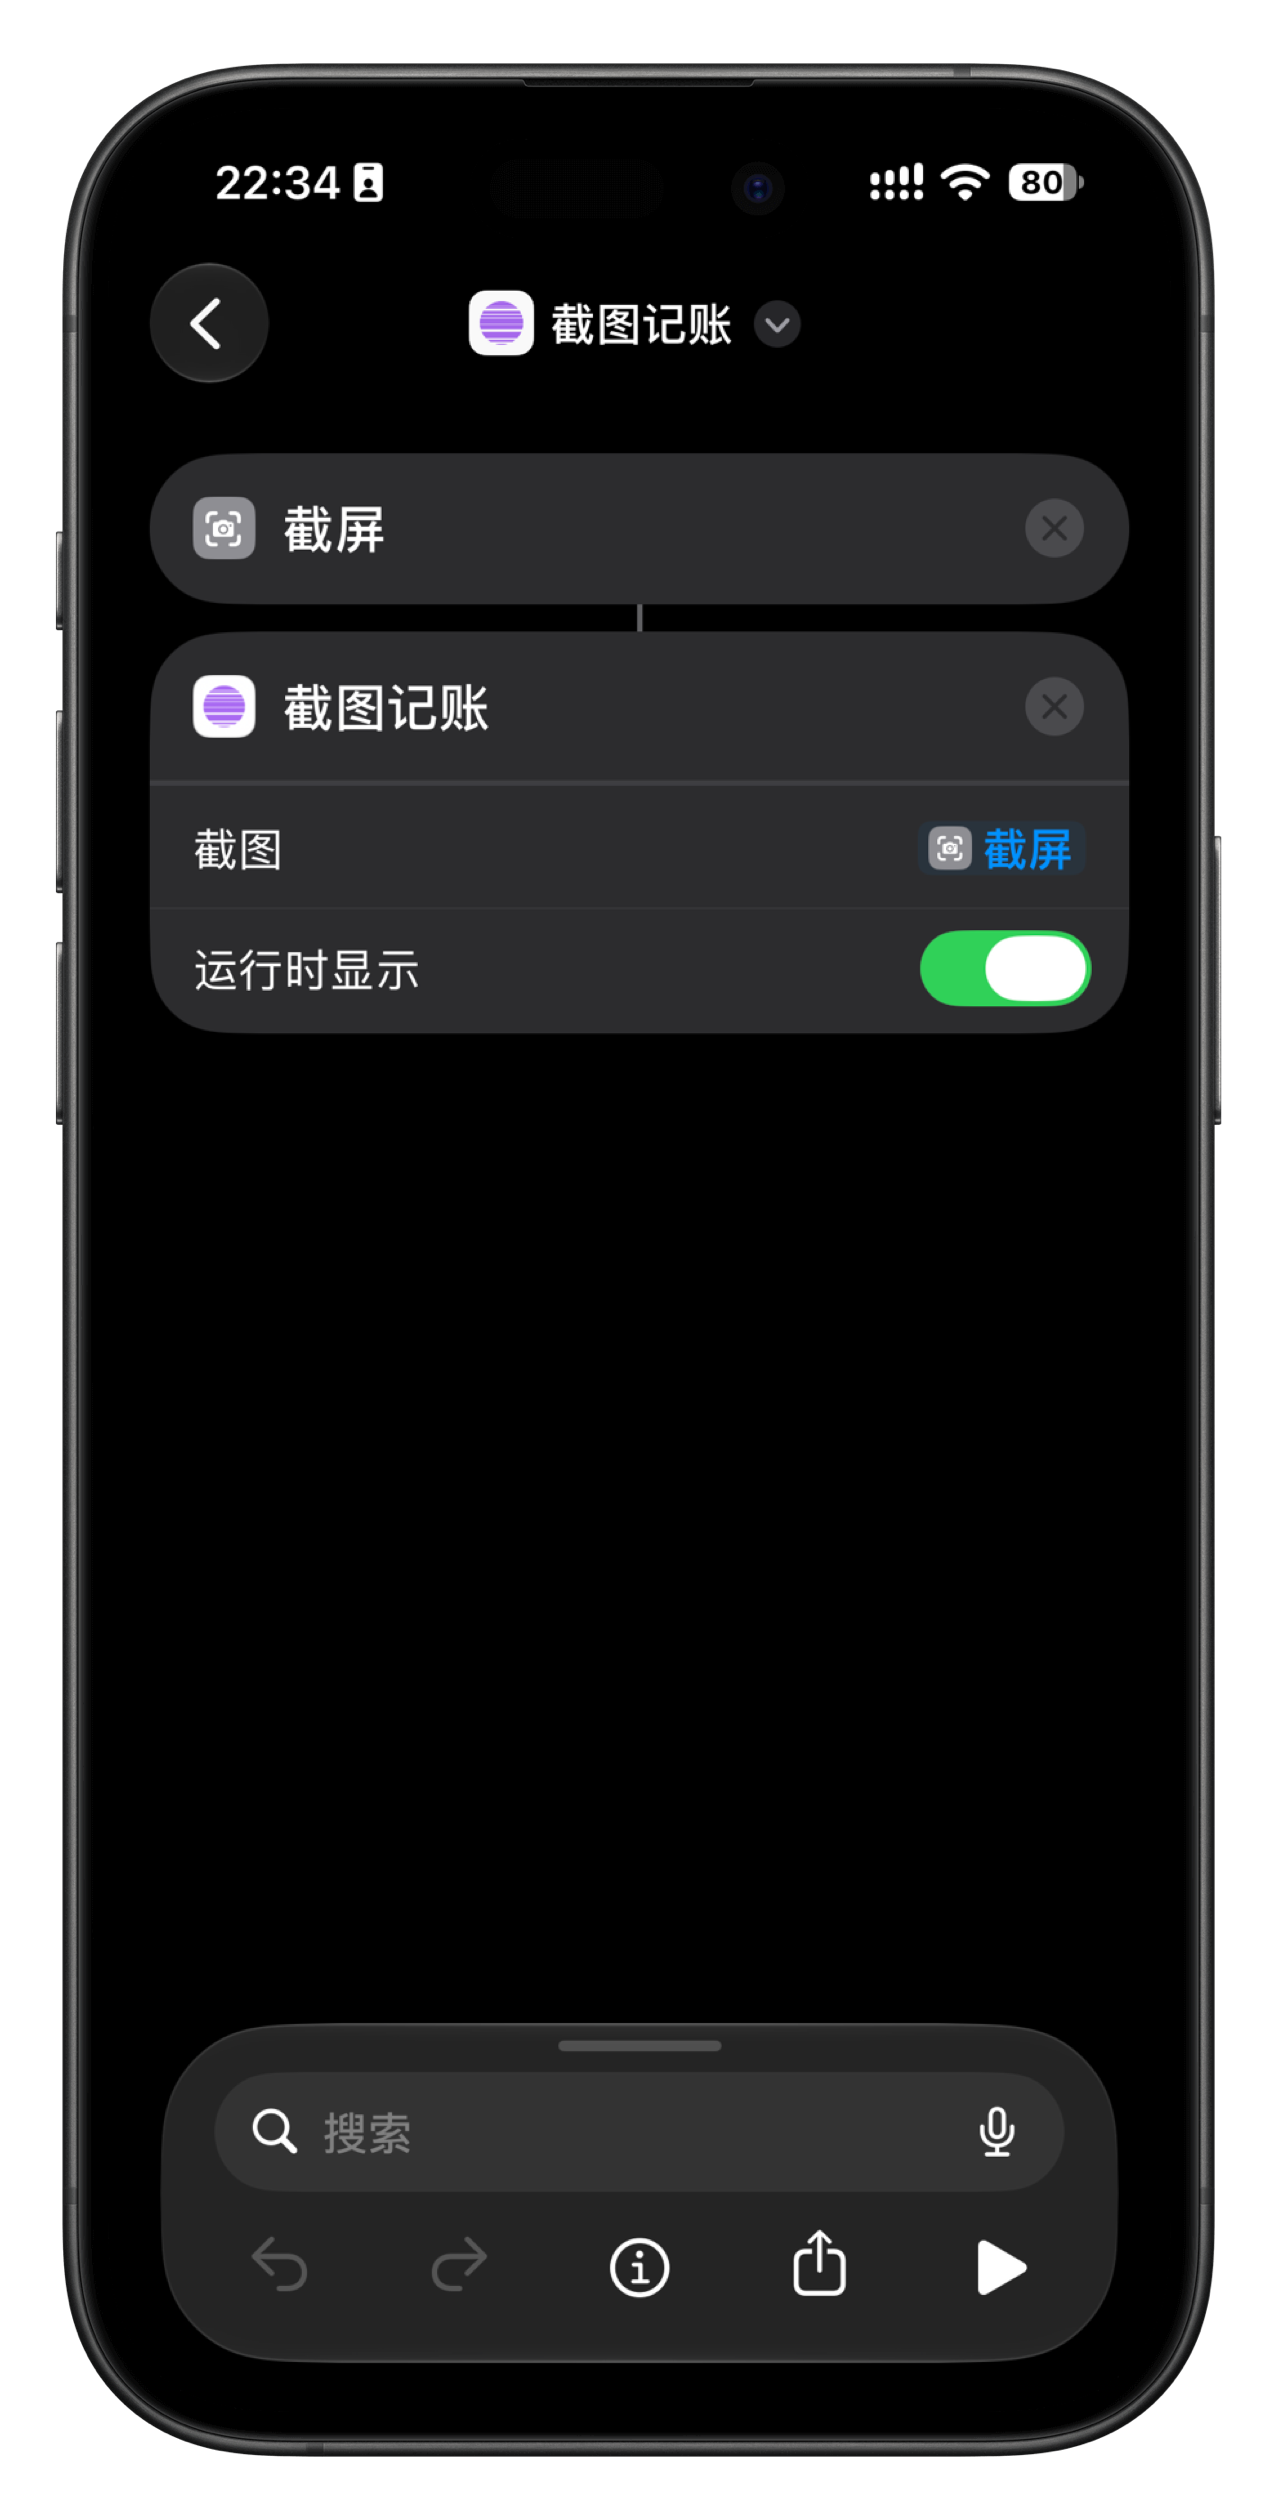
1. 打开「快捷指令」→ 新建,先添加系统自带的「截屏」操作
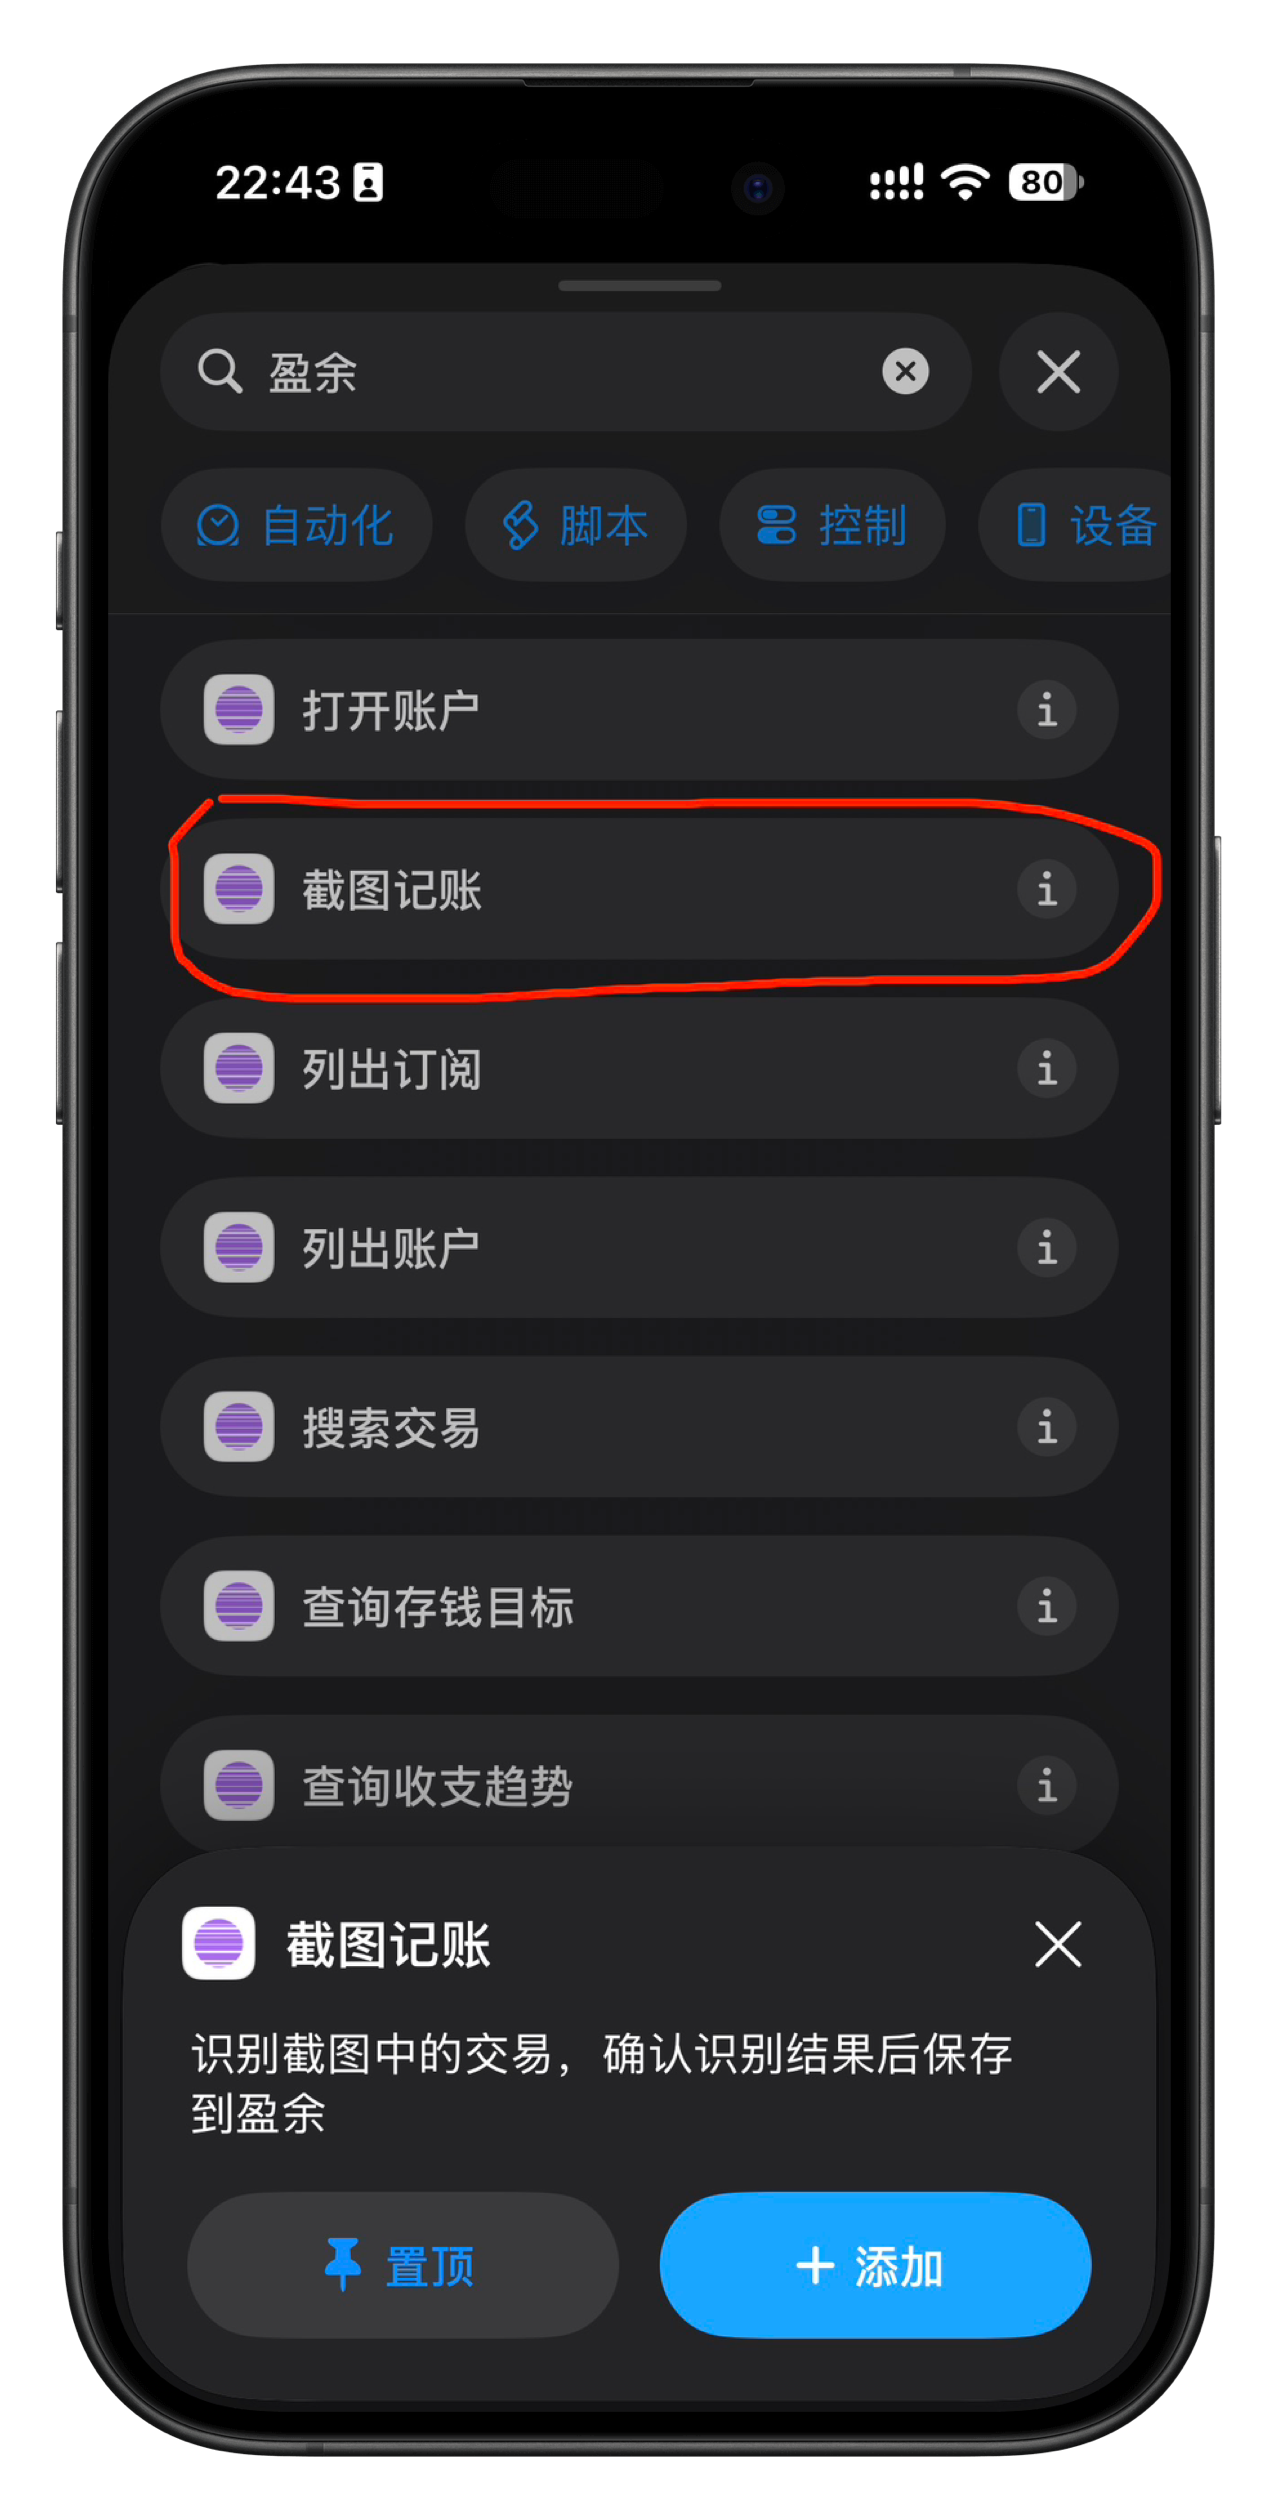
2. 接着在下面搜索「盈余」,找到「截图记账」并添加
3. 把「截图记账」的截图参数设为上一步的「截屏」结果,打开「运行时显示」
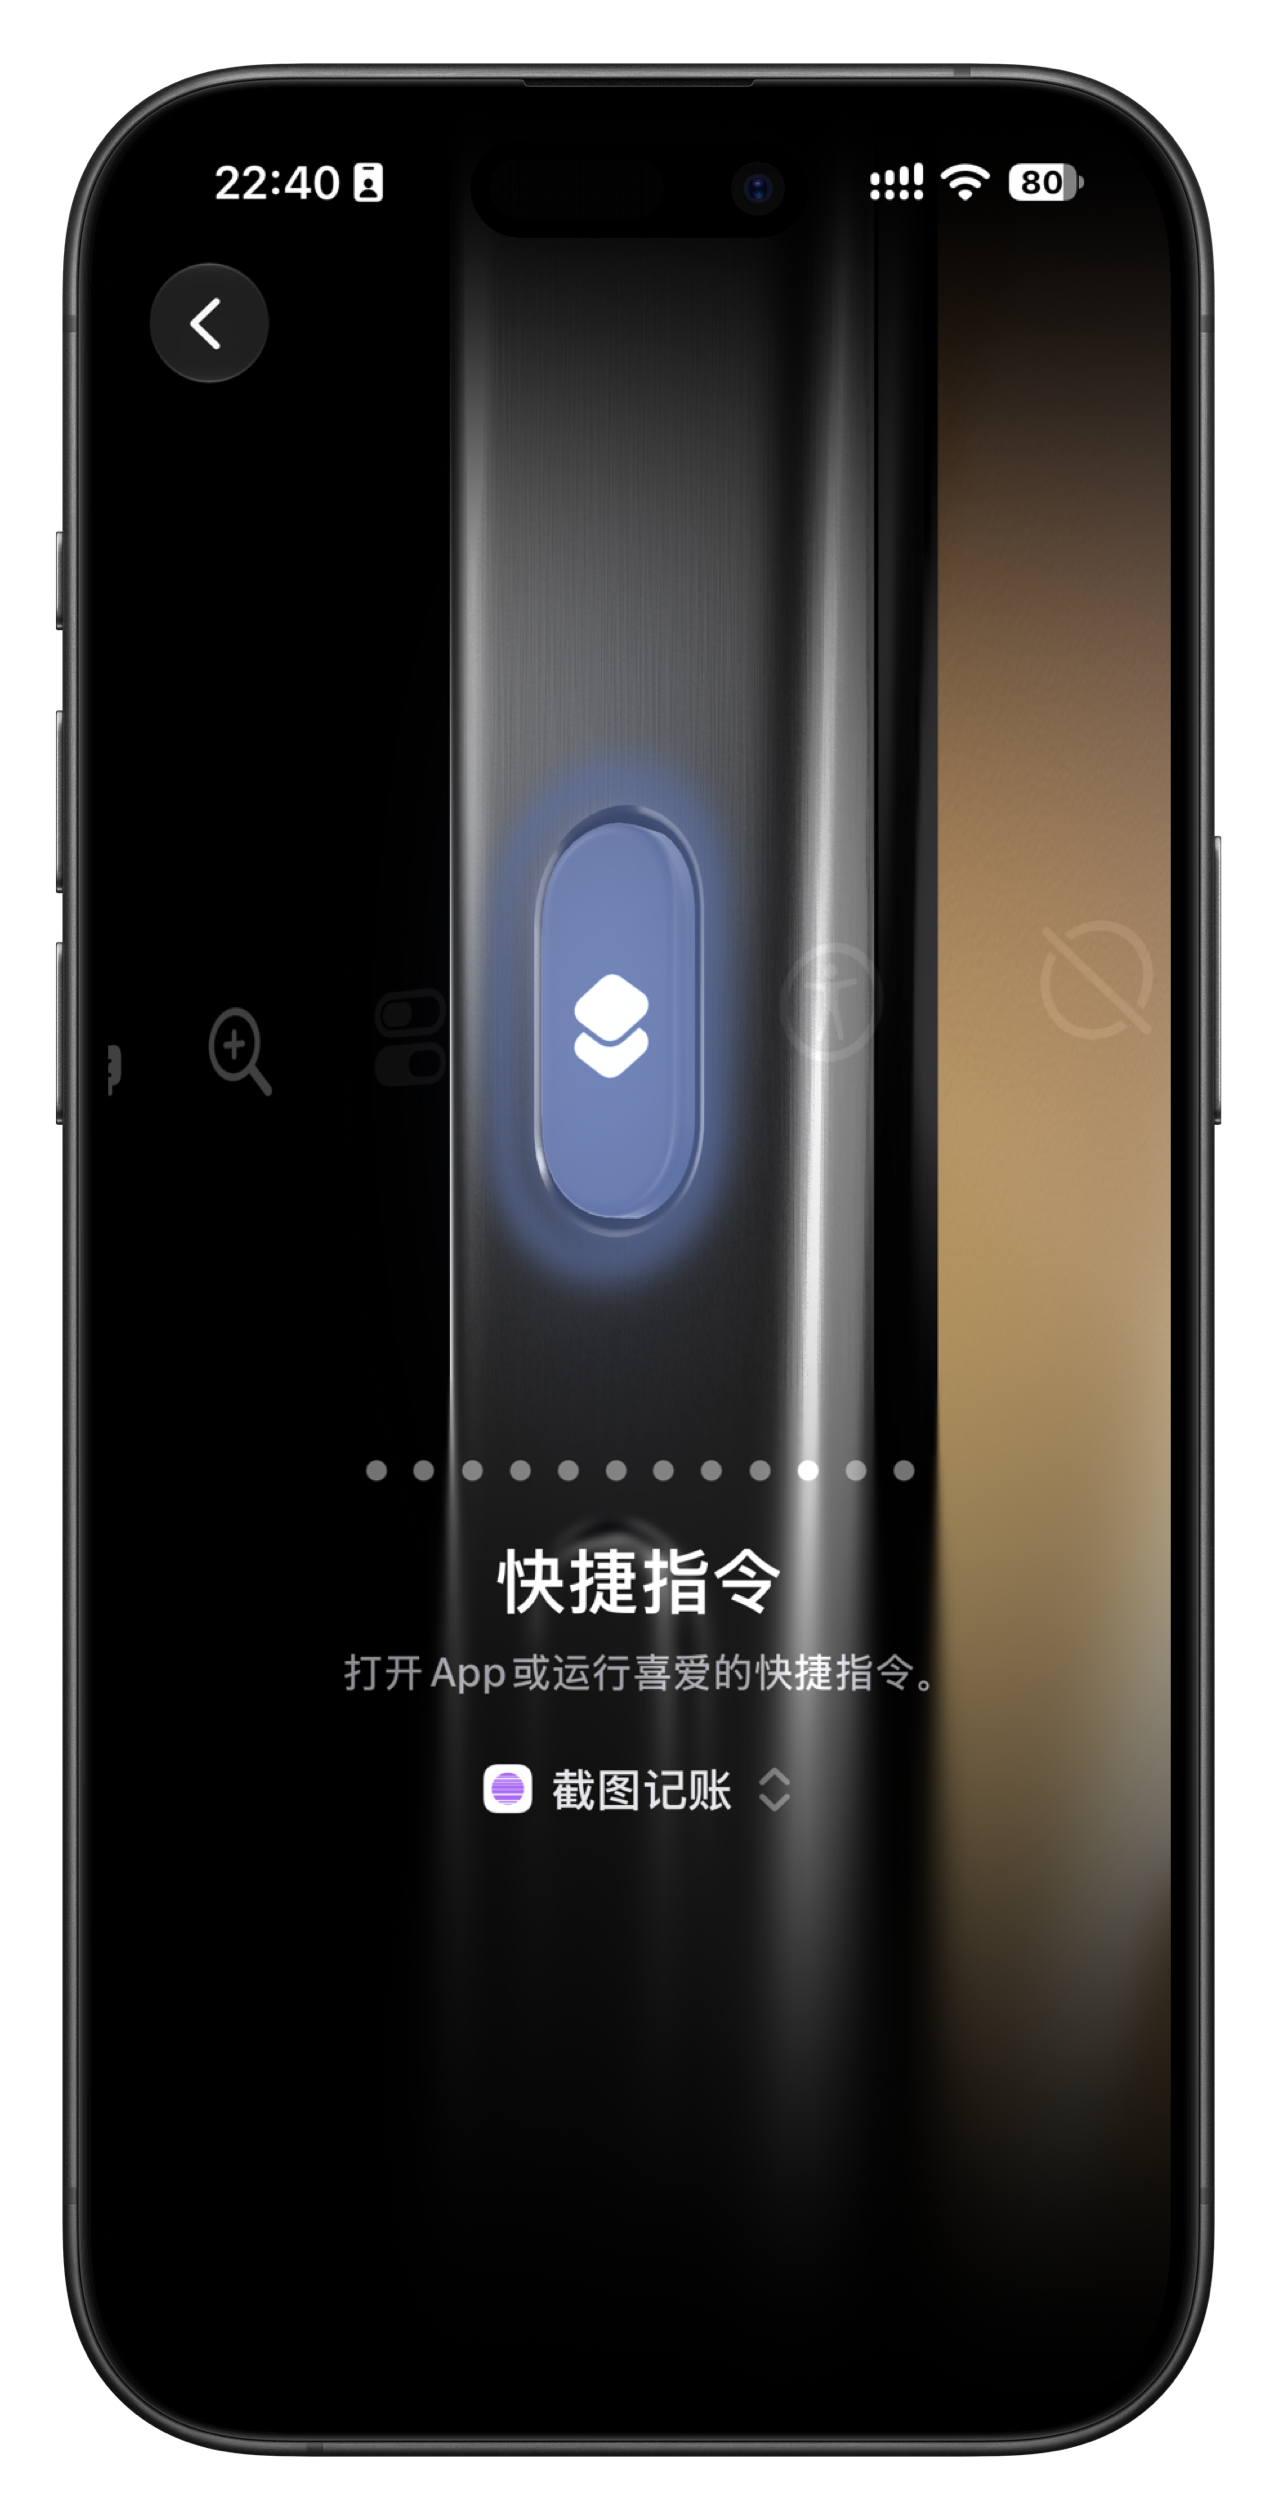
4. 存好之后去:设置 → 操作按钮 → 快捷指令 → 选这个快捷指令
懒得操作?可以复制下方快捷指令链接导入:
www.icloud.com
✨ 之后的体验
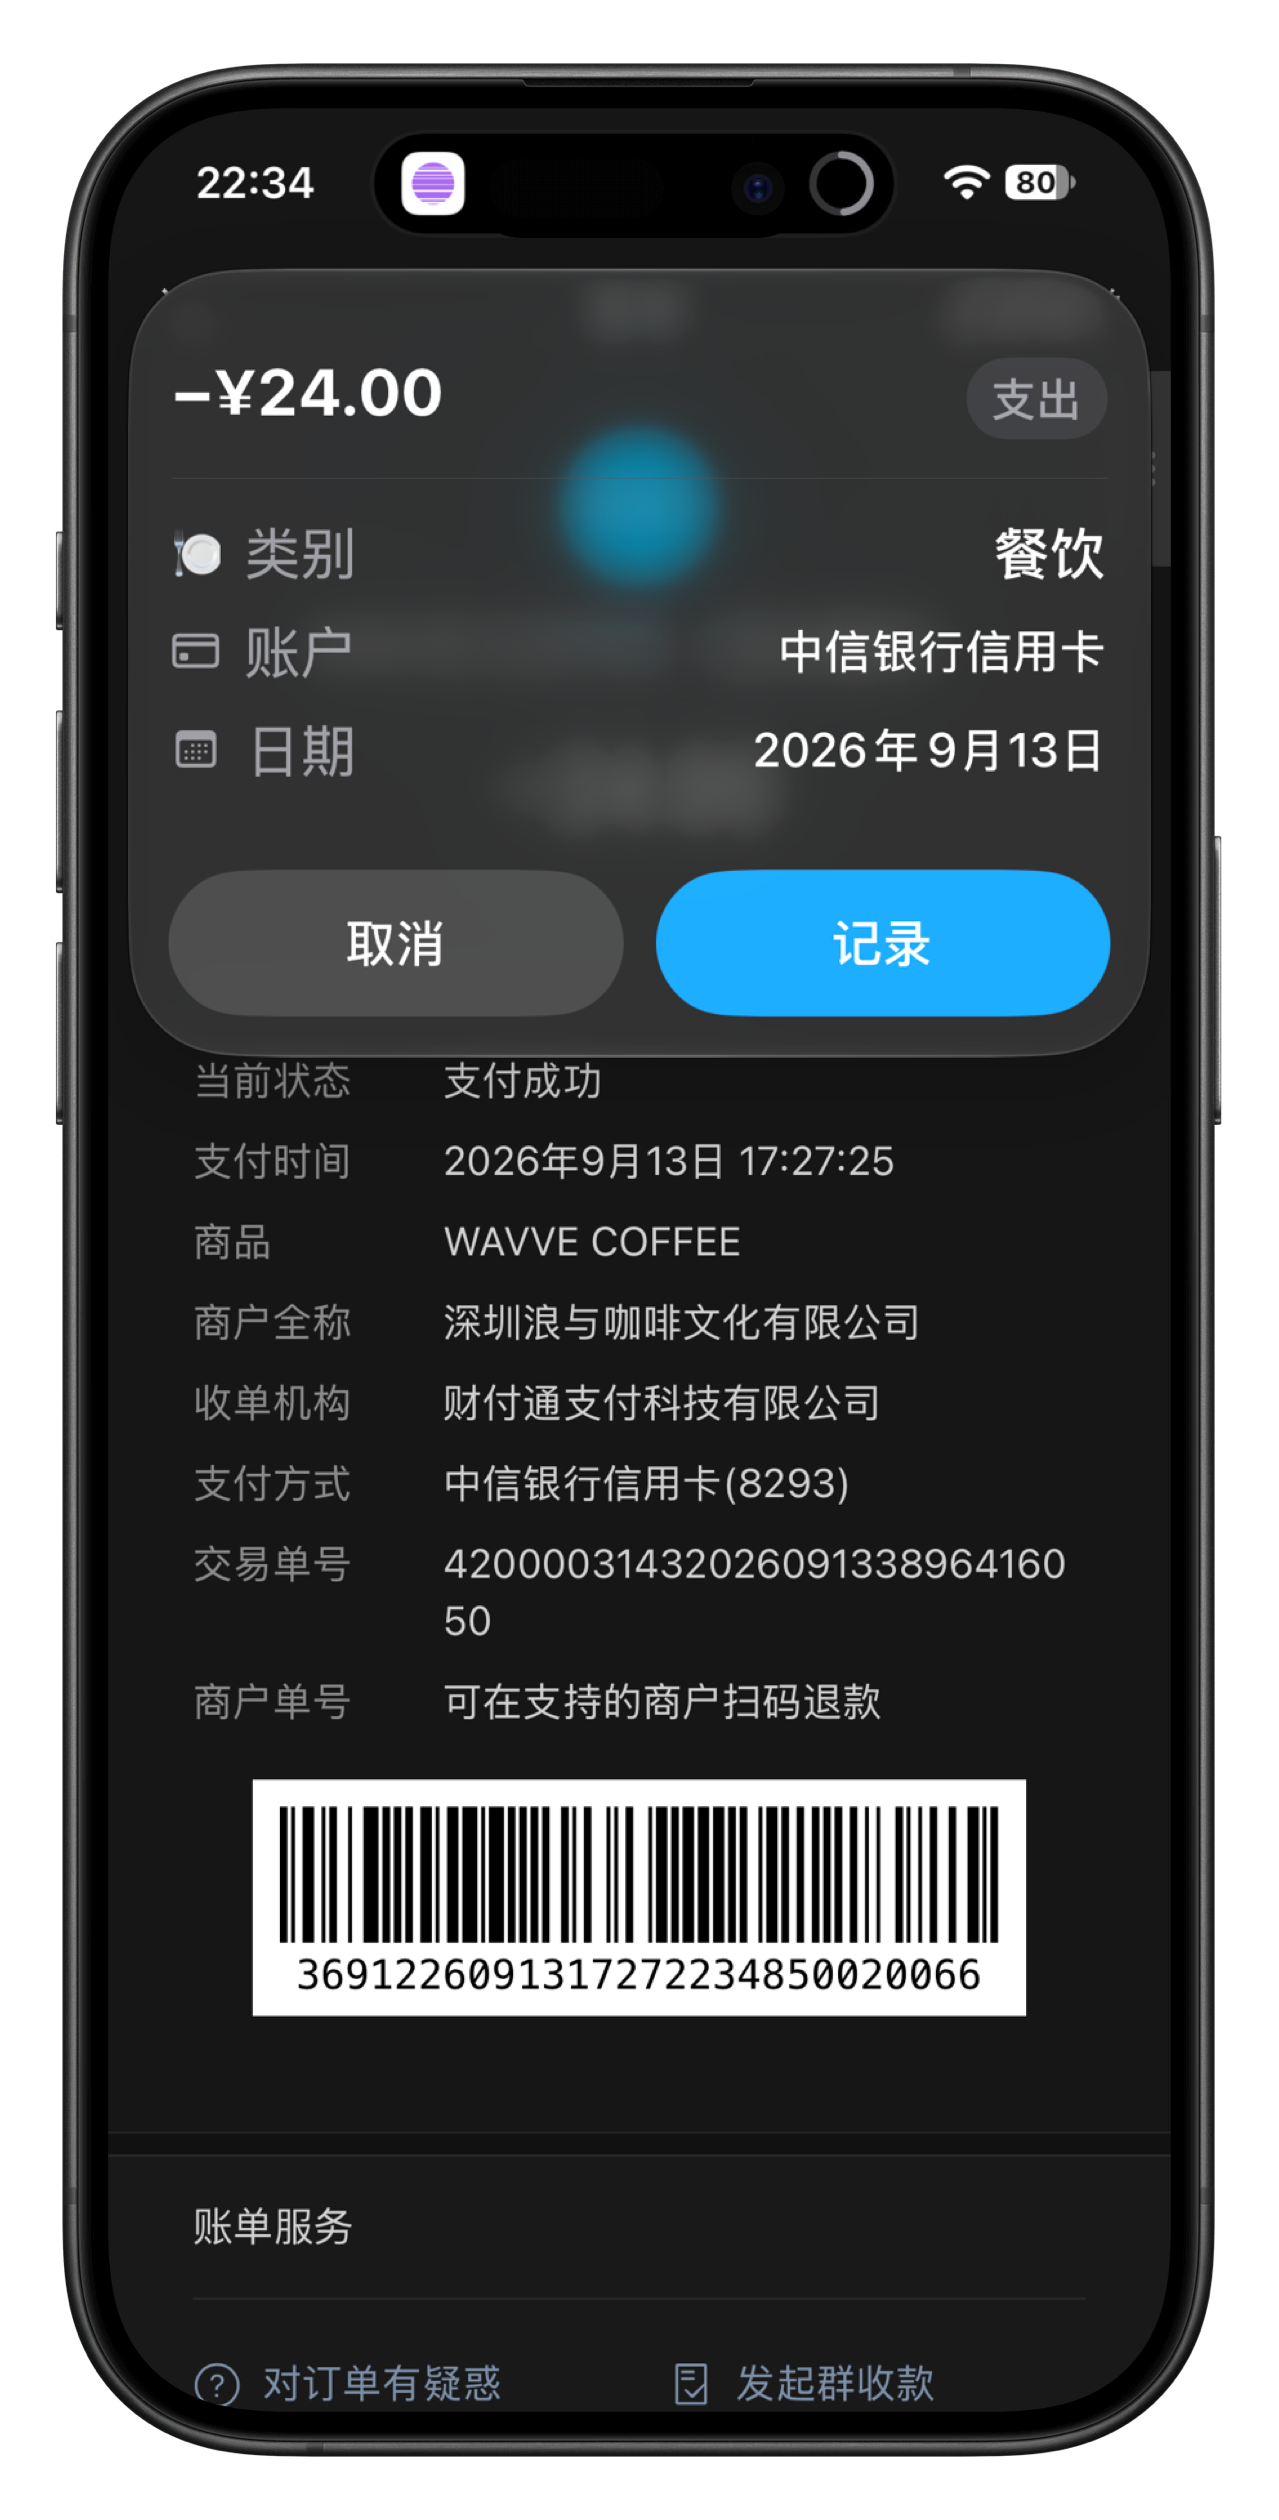
在任何一个付款详情页——微信账单、支付宝、银行 App、外卖订单——按一下侧边的操作按钮:
自动截屏 → 识别出金额、类别、账户、日期 → 弹出确认卡片 → 点「记录」。
全程不用离开当前页面,也不用打开盈余。刚才那杯 24 块的咖啡,从「想记账」到「记完了」大概两三秒。
此外。你可以在 App 内的设置中选择是否识别完直接落账无需确认。
🧠 它是怎么工作的
按下操作按钮,快捷指令先执行系统的「截屏」,把当前这张付款详情页原样抓下来;这张图直接交给盈余的「截图记账」,由它从画面里读出金额、类别、账户和日期,拼成一条待记录的交易,弹出确认卡片;你确认无误点「记录」,这笔账就落进盈余了。整条链路只有截屏和识别两步,不需要跳转、不需要打开 App。
真正省下的不只是那十几秒,而是「稍后再记」的那个念头没有机会出现。记账崩在哪里,大家都清楚——不是某天特别忙,是某笔账拖到了第二天,然后就再也补不回来了。
配置只要两分钟,做完之后你唯一要记住的动作,就是付完钱顺手按一下侧边键。门槛降到这个程度,坚持才不再需要靠自律。🌅
微信支付宝付完钱,切到记账 App,选类别、填金额、选账户……一套下来十几秒,然后下次就懒得记了。
盈余 App 将截屏与识图记账打包到一个简单的 iPhone 快捷指令了🎉
🔧 配置一次,两分钟
1. 打开「快捷指令」→ 新建,先添加系统自带的「截屏」操作
2. 接着在下面搜索「盈余」,找到「截图记账」并添加
3. 把「截图记账」的截图参数设为上一步的「截屏」结果,打开「运行时显示」
4. 存好之后去:设置 → 操作按钮 → 快捷指令 → 选这个快捷指令
懒得操作?可以复制下方快捷指令链接导入:
www.icloud.com
✨ 之后的体验
在任何一个付款详情页——微信账单、支付宝、银行 App、外卖订单——按一下侧边的操作按钮:
自动截屏 → 识别出金额、类别、账户、日期 → 弹出确认卡片 → 点「记录」。
全程不用离开当前页面,也不用打开盈余。刚才那杯 24 块的咖啡,从「想记账」到「记完了」大概两三秒。
此外。你可以在 App 内的设置中选择是否识别完直接落账无需确认。
🧠 它是怎么工作的
按下操作按钮,快捷指令先执行系统的「截屏」,把当前这张付款详情页原样抓下来;这张图直接交给盈余的「截图记账」,由它从画面里读出金额、类别、账户和日期,拼成一条待记录的交易,弹出确认卡片;你确认无误点「记录」,这笔账就落进盈余了。整条链路只有截屏和识别两步,不需要跳转、不需要打开 App。
真正省下的不只是那十几秒,而是「稍后再记」的那个念头没有机会出现。记账崩在哪里,大家都清楚——不是某天特别忙,是某笔账拖到了第二天,然后就再也补不回来了。
配置只要两分钟,做完之后你唯一要记住的动作,就是付完钱顺手按一下侧边键。门槛降到这个程度,坚持才不再需要靠自律。🌅
0 00
Raycast改变订阅模式与价格背后的启发
Raycast 是 Mac 上的效率启动器,相当于 Spotlight 的增强版。按一个快捷键呼出,就能启动应用、搜文件、翻剪贴板、管理窗口;扩展商店里有大量插件,能连接 GitHub、Notion 等工具。
现在还内置了 AI,可以直接对话,也能调用工具帮你干活。
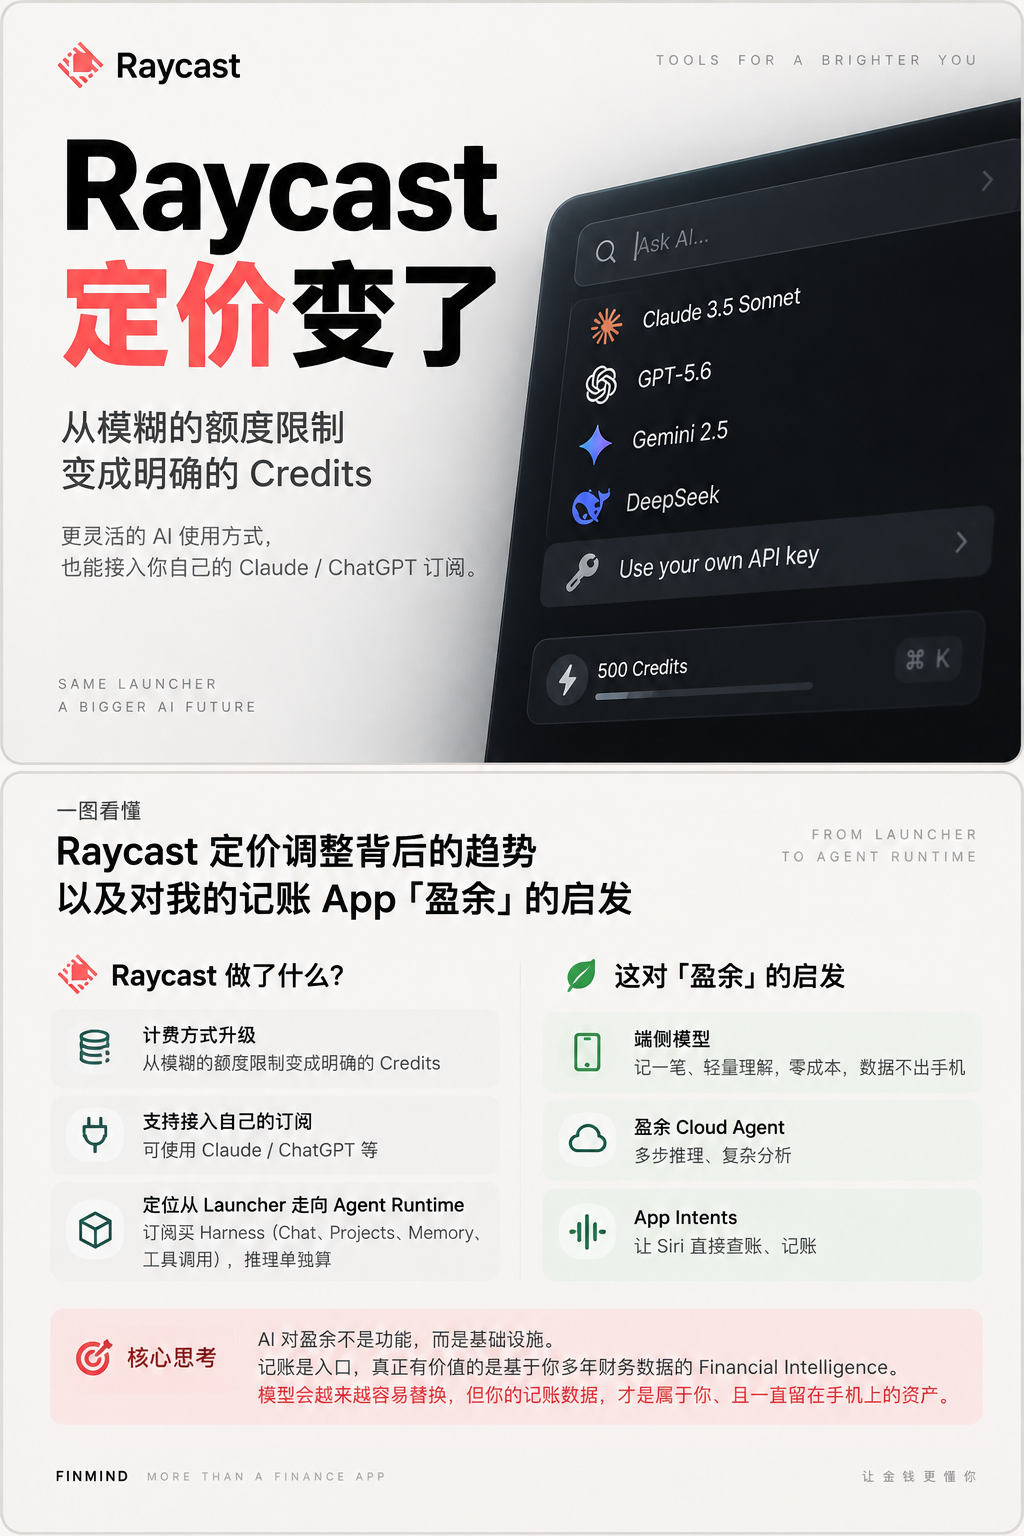
Raycast 这周改了 AI 定价:模糊的额度限制变成明确的 Credits,还能接入自己的 Claude / ChatGPT 订阅。
以前 AI 一问一答,成本好估;现在 Agent 会调工具、写代码、失败重试,消耗没有上限,固定订阅撑不住。于是 Raycast 拆成两件事:
订阅费买 Harness(Chat、Projects、Memory、工具调用),推理单独算:用它的额度,或接你自己的订阅。
它越来越不像带 AI 的 Launcher,更像 Agent Runtime:模型负责聪明,Raycast 负责上下文、执行和记忆。
这也是我做「盈余」一直在想的:不做"记账 App + 聊天框",而是真正懂个人财务的 Financial Agent。
比如问"这个月为什么比上个月花得多",它不会把几千条流水塞给模型,而是先在手机上完成查询、聚合、环比和预算判断,只把结构化结果交给 AI。
token 更少,隐私暴露也更少:账本和计算留在手机上,AI 只负责判断和解释。
Intelligence 按任务分层 👇
🍎 端侧模型:记一笔、轻量理解,零成本、数据不出手机
☁️ 盈余 Cloud Agent:多步推理、复杂分析
🗣️ 被别的 AI 调用:通过 App Intents,让 Siri 直接查账、记账
盈余不绑定任何一个模型:端侧模型、国产大模型,以后的 GPT / Claude,都可以接进来。模型正在商品化,换一家几乎没有成本;真正宝贵的是你的记账数据,这是属于你的资产,而它一直留在你的手机上。
记一笔只是入口,真正有价值的是:
💭 过去一年,我的消费习惯变了什么?
🧾 哪些订阅一年算下来,比我以为的贵得多?
🎯 想年底存到 10 万,现在该怎么调整?
模型会越来越容易替换,但几年的财务上下文不会。记账是入口,Financial Intelligence 才是长期价值 🌱
www.raycast.com
Raycast 是 Mac 上的效率启动器,相当于 Spotlight 的增强版。按一个快捷键呼出,就能启动应用、搜文件、翻剪贴板、管理窗口;扩展商店里有大量插件,能连接 GitHub、Notion 等工具。
现在还内置了 AI,可以直接对话,也能调用工具帮你干活。
Raycast 这周改了 AI 定价:模糊的额度限制变成明确的 Credits,还能接入自己的 Claude / ChatGPT 订阅。
以前 AI 一问一答,成本好估;现在 Agent 会调工具、写代码、失败重试,消耗没有上限,固定订阅撑不住。于是 Raycast 拆成两件事:
订阅费买 Harness(Chat、Projects、Memory、工具调用),推理单独算:用它的额度,或接你自己的订阅。
它越来越不像带 AI 的 Launcher,更像 Agent Runtime:模型负责聪明,Raycast 负责上下文、执行和记忆。
这也是我做「盈余」一直在想的:不做"记账 App + 聊天框",而是真正懂个人财务的 Financial Agent。
比如问"这个月为什么比上个月花得多",它不会把几千条流水塞给模型,而是先在手机上完成查询、聚合、环比和预算判断,只把结构化结果交给 AI。
token 更少,隐私暴露也更少:账本和计算留在手机上,AI 只负责判断和解释。
Intelligence 按任务分层 👇
🍎 端侧模型:记一笔、轻量理解,零成本、数据不出手机
☁️ 盈余 Cloud Agent:多步推理、复杂分析
🗣️ 被别的 AI 调用:通过 App Intents,让 Siri 直接查账、记账
盈余不绑定任何一个模型:端侧模型、国产大模型,以后的 GPT / Claude,都可以接进来。模型正在商品化,换一家几乎没有成本;真正宝贵的是你的记账数据,这是属于你的资产,而它一直留在你的手机上。
记一笔只是入口,真正有价值的是:
💭 过去一年,我的消费习惯变了什么?
🧾 哪些订阅一年算下来,比我以为的贵得多?
🎯 想年底存到 10 万,现在该怎么调整?
模型会越来越容易替换,但几年的财务上下文不会。记账是入口,Financial Intelligence 才是长期价值 🌱
www.raycast.com
1 00
今天 AI 的“真实商业渗透率”其实远低于大家在科技圈里的体感,尤其是 Agent 和 API 级别的深度使用,还处在极早期。
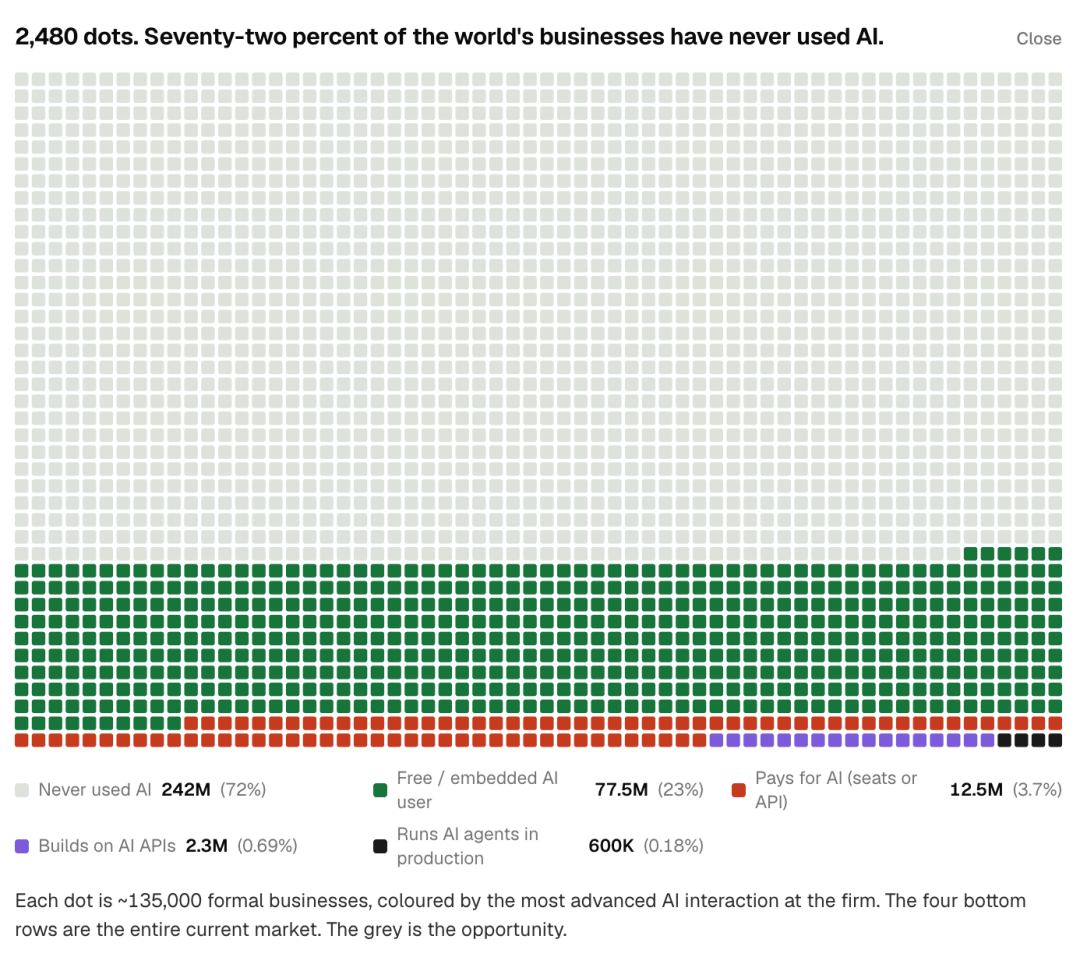
图里一共有 2,480 个点,每个点大约代表 13.5 万家正式注册企业。颜色表示一家企业“最先进”的 AI 使用方式。
灰色占绝对多数:
* 从未使用 AI:2.42 亿家,占 72%
* 使用免费/内嵌 AI:7,750 万家,占 23%
* 为 AI 付费,比如买 ChatGPT seats 或 API:1,250 万家,占 3.7%
* 基于 AI API 自己开发产品:230 万家,占 0.69%
* 真正在生产环境运行 AI Agent:60 万家,占 0.18%
所以最值得注意的其实不是“28% 的企业已经碰过 AI”,而是后面这条漏斗:
100 家企业里,大约 28 家用过 AI,4 家愿意付费,不到 1 家真正基于 API 开发,只有约 0.18 家把 Agent 跑进生产环境。
也就是大约每 556 家企业里,才有 1 家处于“生产级 Agent”阶段。
不过灰色不等于“未来都会变成 AI 客户”。
很多小企业、个体商户、本地服务业可能根本不需要自己买模型 API,更不会部署 Agent。更可能发生的路径是:
传统软件 → 软件内置 AI → AI 成为默认功能
而不是:
每家公司 → 自己开发 Agent。
所以真正巨大的机会,很可能不是“卖 Agent 开发工具给全球所有企业”,而是把 AI 隐藏进现有工作流,让原本“不使用 AI”的企业,在没有明显学习成本的情况下直接开始使用。
这也是为什么图里的绿色区域——Free / embedded AI user——其实非常重要。它很可能是未来最大规模的 AI adoption 入口。
图里一共有 2,480 个点,每个点大约代表 13.5 万家正式注册企业。颜色表示一家企业“最先进”的 AI 使用方式。
灰色占绝对多数:
* 从未使用 AI:2.42 亿家,占 72%
* 使用免费/内嵌 AI:7,750 万家,占 23%
* 为 AI 付费,比如买 ChatGPT seats 或 API:1,250 万家,占 3.7%
* 基于 AI API 自己开发产品:230 万家,占 0.69%
* 真正在生产环境运行 AI Agent:60 万家,占 0.18%
所以最值得注意的其实不是“28% 的企业已经碰过 AI”,而是后面这条漏斗:
100 家企业里,大约 28 家用过 AI,4 家愿意付费,不到 1 家真正基于 API 开发,只有约 0.18 家把 Agent 跑进生产环境。
也就是大约每 556 家企业里,才有 1 家处于“生产级 Agent”阶段。
不过灰色不等于“未来都会变成 AI 客户”。
很多小企业、个体商户、本地服务业可能根本不需要自己买模型 API,更不会部署 Agent。更可能发生的路径是:
传统软件 → 软件内置 AI → AI 成为默认功能
而不是:
每家公司 → 自己开发 Agent。
所以真正巨大的机会,很可能不是“卖 Agent 开发工具给全球所有企业”,而是把 AI 隐藏进现有工作流,让原本“不使用 AI”的企业,在没有明显学习成本的情况下直接开始使用。
这也是为什么图里的绿色区域——Free / embedded AI user——其实非常重要。它很可能是未来最大规模的 AI adoption 入口。
0 00
更快的模型意味着什么?
首先,对于大模型来说速度指两方面:
延迟(有时称为首 token 时间)是模型开始返回响应前的等待时间;
吞吐量则是模型启动后每秒生成多少 token。
GPT-5.6 sol Ultrafast 宣称每秒最高可输出 750 个 token。Artificial Analysis 在 OpenAI 自家 API 上以最高推理强度测试 GPT-5.6 Sol,结果为每秒 65 个 token,这意味着 Ultrafast 大约快 11 倍。
当这种速度来到用户面前,意味着所说即所得,用户不必为了一个功能等几分钟十几分钟,不必在等待与切换上下文中反复,需求表达完,几乎能立刻看到结果,与模型的交互就像是在跟真人对话,话音刚落,答案或 demo 或真实的产品就已经就绪,等着用户测试了。
Just in time
首先,对于大模型来说速度指两方面:
延迟(有时称为首 token 时间)是模型开始返回响应前的等待时间;
吞吐量则是模型启动后每秒生成多少 token。
GPT-5.6 sol Ultrafast 宣称每秒最高可输出 750 个 token。Artificial Analysis 在 OpenAI 自家 API 上以最高推理强度测试 GPT-5.6 Sol,结果为每秒 65 个 token,这意味着 Ultrafast 大约快 11 倍。
当这种速度来到用户面前,意味着所说即所得,用户不必为了一个功能等几分钟十几分钟,不必在等待与切换上下文中反复,需求表达完,几乎能立刻看到结果,与模型的交互就像是在跟真人对话,话音刚落,答案或 demo 或真实的产品就已经就绪,等着用户测试了。
Just in time
The Batch: 977 | AI 对速度的需求为何如此迫切
2 00
智谱和阿里在同一天各自推出了“便宜但够强”的模型:GLM-5.3-Flash[1] 和 Qwen3.8-Flash-Next[2]。两者技术路线不同,但两份技术博客里的主要对手都是 DeepSeek-V4-Flash,应用场景都直指 DeepSeek-V4-Flash——不求最顶尖的智能上限,而是主打极致性价比,足以从容应对日常高频调用的 Agent 任务。
GLM-5.3-Flash 与 Qwen3.8-Flash-Next 技术架构速读
0 00