即刻App年轻人的同好社区
下载
最近一直在跑包括Seedance 2.5在内的各种模型,但发现哪怕用上最新模型,直出的视频还是有一股明显的「AI 味」。
例如:
1. 画面漂浮(Floaty):物体瞬间启停,头发和布料缺少真实物理效果
2. 运镜失控:不写要求,镜头就自己缓慢推进(电影感漂移);写多了,画又会变形
3. 塑料油腻感:字节在 Seedance 2.5 官方博客里专门提过这个词——训练数据多是精修图,加上帧间去噪抹掉了天然噪点,导致皮肤没有毛孔、泛着假锐度
4. 切镜与声音脱节:就是切镜很突兀、人声语速平均得没有起伏
单靠换模型解决不了这些问题。
实测下来,真正能把视频质感拉回来的,是下面这 10 个去「AI 味」技巧:
1. 删掉感觉词,要瑕疵:去掉“电影感、情绪感”等笼统词,直接写毛孔、细纹、胡茬、未修图皮肤、实景光源,加上 “35 毫米胶片、手持摄影”
2. 运镜写具体速度与时间戳:用「0.5 米/秒推进」代替模糊指令。长镜头按 0–5 秒起步,人物表演和对话节奏则放手交给模型
3. 一镜只做一件事:单镜头只留一个主运镜和一个主导动作,需要变轨就拆成两条生成,避免多个快速运动信号叠加造成画面涂抹
4. 按模型控提示词长度:Seedance 2.5 指令遵循度随位置衰减快,压在 60–100 词;Veo 3.1 适合 80–120 词并以视觉动词开头
5. 用英文补丁句单点修毛病:每轮只修一个问题。镜头乱推就加 Locked-off tripod shot; no zoom;画面太死板就加 Subtle handheld realism: tiny natural micro-movements
6. 运动与美学拆开控制:参考视频只管运镜和动作节奏,文字提示词管光影色调。引用时写明用途,参考权重设在 70%–80%,避免拉满导致角色僵硬
7. 生图模型垫底锁肤质:先用擅长皮肤真实感的图像模型生成人像做角色参考;多镜头项目先生成一条锁定色板的锚点视频,再喂给后续镜头防漂移
8. 用真实音频控卡点与环境音:按节奏切镜时直接喂参考音频波形;在 Seedance 或 Omni 1.2 里显式写清环境音要求,防止模型乱加配乐
9. 高废片率粗剪 + 动作顺接:15 秒的生成片段平均只截取最稳的 5 秒进时间线,切点卡在动作发生瞬间(Match on Action,动作顺接),剪掉首尾静止帧
10. 后期加脏与手机审片:成片叠一层轻颗粒并柔化过锐边缘,文字一律后期加;超过 1.5 倍速先分离原生音轨并开光流补帧;最后用手机开满亮度审片,把关肤质和漂浮感。
说到底,大模型学的是一个被过度美化的平均世界,真正的人味审美无比珍贵。
例如:
1. 画面漂浮(Floaty):物体瞬间启停,头发和布料缺少真实物理效果
2. 运镜失控:不写要求,镜头就自己缓慢推进(电影感漂移);写多了,画又会变形
3. 塑料油腻感:字节在 Seedance 2.5 官方博客里专门提过这个词——训练数据多是精修图,加上帧间去噪抹掉了天然噪点,导致皮肤没有毛孔、泛着假锐度
4. 切镜与声音脱节:就是切镜很突兀、人声语速平均得没有起伏
单靠换模型解决不了这些问题。
实测下来,真正能把视频质感拉回来的,是下面这 10 个去「AI 味」技巧:
1. 删掉感觉词,要瑕疵:去掉“电影感、情绪感”等笼统词,直接写毛孔、细纹、胡茬、未修图皮肤、实景光源,加上 “35 毫米胶片、手持摄影”
2. 运镜写具体速度与时间戳:用「0.5 米/秒推进」代替模糊指令。长镜头按 0–5 秒起步,人物表演和对话节奏则放手交给模型
3. 一镜只做一件事:单镜头只留一个主运镜和一个主导动作,需要变轨就拆成两条生成,避免多个快速运动信号叠加造成画面涂抹
4. 按模型控提示词长度:Seedance 2.5 指令遵循度随位置衰减快,压在 60–100 词;Veo 3.1 适合 80–120 词并以视觉动词开头
5. 用英文补丁句单点修毛病:每轮只修一个问题。镜头乱推就加 Locked-off tripod shot; no zoom;画面太死板就加 Subtle handheld realism: tiny natural micro-movements
6. 运动与美学拆开控制:参考视频只管运镜和动作节奏,文字提示词管光影色调。引用时写明用途,参考权重设在 70%–80%,避免拉满导致角色僵硬
7. 生图模型垫底锁肤质:先用擅长皮肤真实感的图像模型生成人像做角色参考;多镜头项目先生成一条锁定色板的锚点视频,再喂给后续镜头防漂移
8. 用真实音频控卡点与环境音:按节奏切镜时直接喂参考音频波形;在 Seedance 或 Omni 1.2 里显式写清环境音要求,防止模型乱加配乐
9. 高废片率粗剪 + 动作顺接:15 秒的生成片段平均只截取最稳的 5 秒进时间线,切点卡在动作发生瞬间(Match on Action,动作顺接),剪掉首尾静止帧
10. 后期加脏与手机审片:成片叠一层轻颗粒并柔化过锐边缘,文字一律后期加;超过 1.5 倍速先分离原生音轨并开光流补帧;最后用手机开满亮度审片,把关肤质和漂浮感。
说到底,大模型学的是一个被过度美化的平均世界,真正的人味审美无比珍贵。
1 00
不得不感慨,Claude 的模型能力依然碾压 GPT,虽然写作能力没有 Gemini 强了,但问题不大。
现在不仅开发主力都是 Claude,我们做 AI 混剪视频、短剧,用 GPT 可能要 1、2 个小时,用 Claude 半小时就解决了,效果还很好。
最多人问的反而是:怎么订阅才稳?
统一回答一下:在新加坡放一个 mac mini,然后用新加坡账号订阅,新号的话养两天,先订阅 pro,再订阅 max 或者 ultra,非常稳,我们有 3 台,火力全开用了半年
如果没有的话,也可以网上找租机器的,我看了一下大概 100 美金一个月,渠道的话这里没法发网站,可以到我 X 看,待会补发一条
所以好好珍惜朋友圈里的新加坡朋友哈哈哈
早上看了卡兹克和刘小排老师的内容,抓紧跑了一下,再结合网上的信息,整理了一波速通清单:
1. 跑分登顶,Artificial Analysis 实测拿 65 分登顶(GPT-6.1 Sol 55 分),但 `$8/$40` 单价仍是 Opus 5.5 的 2 倍。只有在做跨项目重构,才敢用 Fable。
2. 实测最舒(sheng)服(qian)的多模型分工:把 Fable 5.2 当成「宰相」,只做最顶层的诊断规划和总指挥,前端和审美相关的活交给 Opus 5.5 执行,算法和后端交给性价比极高的 GPT Sol
另外有个坑:内置 `Explore` 子代理现默认跟随主模型,记得在 `.claude/agents/` 里锁死 `model: opus`
3. 视频动效和 3D 审美达到了绝对统治级别。以前用 Opus 5.5 做讲解视频或 Three.js 场景还得聊好几轮,现在给 Fable 5.2 一句话提示词,它自己联网扒上百张实景照片放大看细节、自己写配乐卡点剪辑,跑一两个小时直接一次直出完整成片
4. 关于思考程度,不需要开 Max, 优先用medium(已超过 opus 5.5 high)
甚至可以跑 low 或 medium 档做多步任务,但记得在提示词里明确加上「全部做完并验证通过再停」,能把半路撂挑子的概率直接砍半;如果长任务几十分钟不说话,加一句「每调几次工具汇报一行进展」
5. 动手写代码前,强烈建议先问它一句:「你看我这个想法哪里有问题?」这是 Anthropic 官方给的技巧,它极擅长挑刺;聊清楚之后,再规定好哪些危险操作(比如删文件)需要你批准,剩下的直接把整个项目丢给它自己跑几个小时
6. 为什么这次叫 5.2 而不是顺着 Opus 5.5 叫 Fable 5.5?最早 9 月爆料的内部代号其实就叫 5.2,说明这次只是常规迭代,Anthropic 手里大概率还藏着一张真正王炸的 Fable 5.5 没打出来
7. 送了一次充值,且 pro 用户(这周)也能随心蹬了!
现在不仅开发主力都是 Claude,我们做 AI 混剪视频、短剧,用 GPT 可能要 1、2 个小时,用 Claude 半小时就解决了,效果还很好。
最多人问的反而是:怎么订阅才稳?
统一回答一下:在新加坡放一个 mac mini,然后用新加坡账号订阅,新号的话养两天,先订阅 pro,再订阅 max 或者 ultra,非常稳,我们有 3 台,火力全开用了半年
如果没有的话,也可以网上找租机器的,我看了一下大概 100 美金一个月,渠道的话这里没法发网站,可以到我 X 看,待会补发一条
所以好好珍惜朋友圈里的新加坡朋友哈哈哈
早上看了卡兹克和刘小排老师的内容,抓紧跑了一下,再结合网上的信息,整理了一波速通清单:
1. 跑分登顶,Artificial Analysis 实测拿 65 分登顶(GPT-6.1 Sol 55 分),但 `$8/$40` 单价仍是 Opus 5.5 的 2 倍。只有在做跨项目重构,才敢用 Fable。
2. 实测最舒(sheng)服(qian)的多模型分工:把 Fable 5.2 当成「宰相」,只做最顶层的诊断规划和总指挥,前端和审美相关的活交给 Opus 5.5 执行,算法和后端交给性价比极高的 GPT Sol
另外有个坑:内置 `Explore` 子代理现默认跟随主模型,记得在 `.claude/agents/` 里锁死 `model: opus`
3. 视频动效和 3D 审美达到了绝对统治级别。以前用 Opus 5.5 做讲解视频或 Three.js 场景还得聊好几轮,现在给 Fable 5.2 一句话提示词,它自己联网扒上百张实景照片放大看细节、自己写配乐卡点剪辑,跑一两个小时直接一次直出完整成片
4. 关于思考程度,不需要开 Max, 优先用medium(已超过 opus 5.5 high)
甚至可以跑 low 或 medium 档做多步任务,但记得在提示词里明确加上「全部做完并验证通过再停」,能把半路撂挑子的概率直接砍半;如果长任务几十分钟不说话,加一句「每调几次工具汇报一行进展」
5. 动手写代码前,强烈建议先问它一句:「你看我这个想法哪里有问题?」这是 Anthropic 官方给的技巧,它极擅长挑刺;聊清楚之后,再规定好哪些危险操作(比如删文件)需要你批准,剩下的直接把整个项目丢给它自己跑几个小时
6. 为什么这次叫 5.2 而不是顺着 Opus 5.5 叫 Fable 5.5?最早 9 月爆料的内部代号其实就叫 5.2,说明这次只是常规迭代,Anthropic 手里大概率还藏着一张真正王炸的 Fable 5.5 没打出来
7. 送了一次充值,且 pro 用户(这周)也能随心蹬了!
1 00
和十几位顶流AI博主交流现状,总结出 10 条经验,起码少走几年弯路。
1. 从发第一篇内容起,就必须设计好“公域引流公众号、再沉淀到私域”的漏斗,纯靠单篇商单广告抗风险能力极差,把私域做成多级火箭(低客单社群+高客单训练营或高阶服务),收益能直接放大5到10倍。
2. 现阶段国内最大的流量和变现红利依然在微信生态(尤其是视频号直播和私域),海外则是X(推特)处于极佳红利期,不仅流量好,还能靠蓝V互动稳拿美金流量分成,非常值得同步分发。
3. 刚起步千万别轻易招大团队搞ToB重交付服务,一年收几万块却要贴身服务一整年,毛利连10%都不到,哪怕是月入几十万的大博主,盲目扩张几十人团队去卷重交付项目,半年就能亏光几百万积蓄。
4. 在AI时代,“一人公司(OPC)”依然是活得最滋润、利润率最高的形态,靠自己把内容、商单和轻咨询跑通,远比租大办公室、背负高昂人力社保成本要安全得多。
5. 如果你想做付费社群或卖课,早期冷启动最猛的打法不是自己闷头攒流量,而是拿出70%甚至80%的超高分佣比例,把朋友圈文案和海报做成傻瓜式物料包,让其他有流量的博主直接复制粘贴帮你分销。
6. 不要为了贪图完美去烧最贵的顶配大模型,有人一天跑几百条视频烧掉几万块Token却零产出;内容和带货的本质是“用低成本数量去博爆款概率”,选够用的高性价比模型配合自动化工作流才是正道。
7. 永远紧盯离钱最近、能立刻算清ROI的垂直需求,无论是做工具评测、跨境带货混剪还是教企业用AI提效,只要你的内容或工具能让客户在几天内看到真金白银的回报,他们就愿意付高价。
8. 别在家里闭门造车,一定要挤进高浓度的同行圈子,很多改变命运的10万+选题和变现新玩法,都是在群友互相“内卷”和线下吹水碰撞时被激发出来的,跟对一波新工具的红利,足够让你彻底站稳脚跟。
9. 纯讲硬核技术干货是个伪命题,用户看完白嫖就走,很难产生商业转化;真正能赚到大钱的,是把普通人玩不明白的新工具变成“信息差”,做深度的工具评测、落地场景拆解,这才是目前广告商单最多的方向。
10. 千万别用AI批量洗稿起号,平台算法现在极度排斥纯AI生成的垃圾内容,真正能打穿流量池的10万+爆款,全靠你亲自深度实测后的“人味”手写和独特认知,这部分核心表达连招员工代笔都替代不了。
1. 从发第一篇内容起,就必须设计好“公域引流公众号、再沉淀到私域”的漏斗,纯靠单篇商单广告抗风险能力极差,把私域做成多级火箭(低客单社群+高客单训练营或高阶服务),收益能直接放大5到10倍。
2. 现阶段国内最大的流量和变现红利依然在微信生态(尤其是视频号直播和私域),海外则是X(推特)处于极佳红利期,不仅流量好,还能靠蓝V互动稳拿美金流量分成,非常值得同步分发。
3. 刚起步千万别轻易招大团队搞ToB重交付服务,一年收几万块却要贴身服务一整年,毛利连10%都不到,哪怕是月入几十万的大博主,盲目扩张几十人团队去卷重交付项目,半年就能亏光几百万积蓄。
4. 在AI时代,“一人公司(OPC)”依然是活得最滋润、利润率最高的形态,靠自己把内容、商单和轻咨询跑通,远比租大办公室、背负高昂人力社保成本要安全得多。
5. 如果你想做付费社群或卖课,早期冷启动最猛的打法不是自己闷头攒流量,而是拿出70%甚至80%的超高分佣比例,把朋友圈文案和海报做成傻瓜式物料包,让其他有流量的博主直接复制粘贴帮你分销。
6. 不要为了贪图完美去烧最贵的顶配大模型,有人一天跑几百条视频烧掉几万块Token却零产出;内容和带货的本质是“用低成本数量去博爆款概率”,选够用的高性价比模型配合自动化工作流才是正道。
7. 永远紧盯离钱最近、能立刻算清ROI的垂直需求,无论是做工具评测、跨境带货混剪还是教企业用AI提效,只要你的内容或工具能让客户在几天内看到真金白银的回报,他们就愿意付高价。
8. 别在家里闭门造车,一定要挤进高浓度的同行圈子,很多改变命运的10万+选题和变现新玩法,都是在群友互相“内卷”和线下吹水碰撞时被激发出来的,跟对一波新工具的红利,足够让你彻底站稳脚跟。
9. 纯讲硬核技术干货是个伪命题,用户看完白嫖就走,很难产生商业转化;真正能赚到大钱的,是把普通人玩不明白的新工具变成“信息差”,做深度的工具评测、落地场景拆解,这才是目前广告商单最多的方向。
10. 千万别用AI批量洗稿起号,平台算法现在极度排斥纯AI生成的垃圾内容,真正能打穿流量池的10万+爆款,全靠你亲自深度实测后的“人味”手写和独特认知,这部分核心表达连招员工代笔都替代不了。
3 10
今天是我玩机器人的第三天,我已经上瘾了。
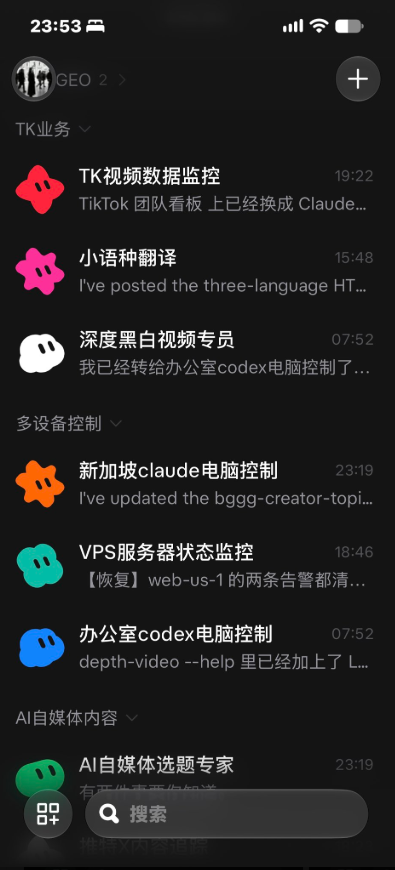
最有用的一个是作为我新加坡电脑 Claude 的移动客户端——无论我想让 Claude 运行什么,我都可以让机器人来处理。
我还把它连接到了办公室的 Codex 电脑上,那台电脑一直开着,所以 grok bot 充当了联络员;几乎所有的分析和开发工作都由 Claude Codex 完成。
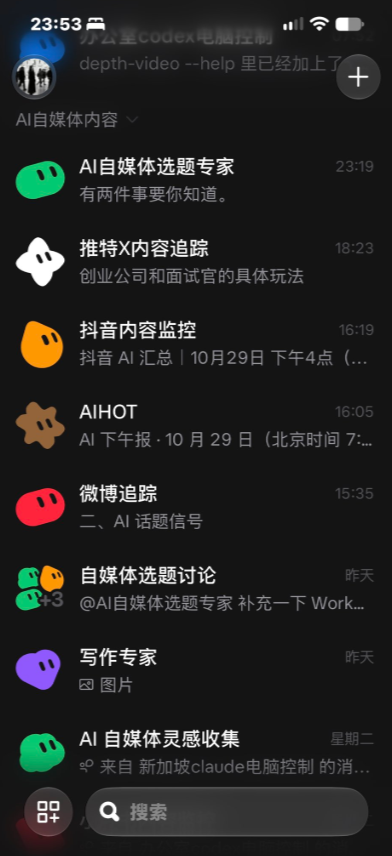
目前最常用的机器人有:
1. TikTok 数据监控和分析优化:它每天轮询一次我的矩阵账户的自然流量数据和广告数据,交给 Claude 分析,然后 grok 机器人输出每日仪表盘报告——链接可以直接分享给团队。
2. AI 自媒体:我搁置已久的自媒体项目重新启动了,我担心跟不上大家的进度,所以设置了机器人每天两次抓取 X、微博、小红书、抖音和爱好客的最新动态。当然,即使抓取之后,我也没有时间去看,所以我花了三天时间完善了一个选题机器人来审核,把我感兴趣的内容整理成潜在主题——目前效果还不错。同时,在日常生活中,我看到的任何好内容都会直接转发给灵感机器人,它会把内容存储在 Notion 中。换句话说,Notion充当我的传输数据库——好处是 Claude 还可以连接到 Notion 应用,共享一个数据库用于内容写作等。
3. VPS 服务器状态监控 今天刚设置好;逻辑是在每台服务器上运行一个脚本,将状态同步到 Cloudflare Worker,然后 Cloudflare Worker 再同步到机器人。反过来,当我需要检查情况时,我可以让机器人直接查询。
4. 小语种翻译 由于我们面向欧洲国家,小语种无法直接进行机器翻译,而且 AI 翻译也并非总是可靠。目前,只有我可以访问 Claude 来使用预置的翻译技能——非常繁琐。
没想到 grok bot 会变成一个所有人都能使用的应用,让我彻底解放了。
逻辑是:首先,在 Lark 中创建一个应用——不要在这里处理冗长的响应(容易断开连接);而是将事件传递给服务器。服务器是一个免费的 Cloudflare Worker。
因此,当有翻译需求时,每个人都可以……@slark 组中的机器人会将任务传递给 Worker,然后再传递给机器人;机器人调用 Claude 的技能进行处理,并将处理后的任务返回给 Worker,最后返回给 Lark。理论上,这种方法可以取代大量的内部应用程序。
最有用的一个是作为我新加坡电脑 Claude 的移动客户端——无论我想让 Claude 运行什么,我都可以让机器人来处理。
我还把它连接到了办公室的 Codex 电脑上,那台电脑一直开着,所以 grok bot 充当了联络员;几乎所有的分析和开发工作都由 Claude Codex 完成。
目前最常用的机器人有:
1. TikTok 数据监控和分析优化:它每天轮询一次我的矩阵账户的自然流量数据和广告数据,交给 Claude 分析,然后 grok 机器人输出每日仪表盘报告——链接可以直接分享给团队。
2. AI 自媒体:我搁置已久的自媒体项目重新启动了,我担心跟不上大家的进度,所以设置了机器人每天两次抓取 X、微博、小红书、抖音和爱好客的最新动态。当然,即使抓取之后,我也没有时间去看,所以我花了三天时间完善了一个选题机器人来审核,把我感兴趣的内容整理成潜在主题——目前效果还不错。同时,在日常生活中,我看到的任何好内容都会直接转发给灵感机器人,它会把内容存储在 Notion 中。换句话说,Notion充当我的传输数据库——好处是 Claude 还可以连接到 Notion 应用,共享一个数据库用于内容写作等。
3. VPS 服务器状态监控 今天刚设置好;逻辑是在每台服务器上运行一个脚本,将状态同步到 Cloudflare Worker,然后 Cloudflare Worker 再同步到机器人。反过来,当我需要检查情况时,我可以让机器人直接查询。
4. 小语种翻译 由于我们面向欧洲国家,小语种无法直接进行机器翻译,而且 AI 翻译也并非总是可靠。目前,只有我可以访问 Claude 来使用预置的翻译技能——非常繁琐。
没想到 grok bot 会变成一个所有人都能使用的应用,让我彻底解放了。
逻辑是:首先,在 Lark 中创建一个应用——不要在这里处理冗长的响应(容易断开连接);而是将事件传递给服务器。服务器是一个免费的 Cloudflare Worker。
因此,当有翻译需求时,每个人都可以……@slark 组中的机器人会将任务传递给 Worker,然后再传递给机器人;机器人调用 Claude 的技能进行处理,并将处理后的任务返回给 Worker,最后返回给 Lark。理论上,这种方法可以取代大量的内部应用程序。
3 01
DeepSeek Harness必装的15个插件
DeepSeek Harness开源了,先别让手头上的Codex、CC下岗,因为它跟半成品没区别。
DSH「一切皆插件」的概念还蛮酷。
实际意思是装完以后连传文件、识图的功能都没有。。。
需要啥功能、就装啥插件。
所以现阶段面向的就是开发者,使用门槛还是有的,建议普通用户先观望吧。
想玩玩用这个指令,直接给到本地 Agent:
“
帮我安装并启动 DeepSeek Harness。
项目地址:github.com/deepseek-ai/deepseek-harness
先检查环境,缺什么装什么。
然后运行 npx @deepseek-ai/dsh web 并打开网页端。
”
跑完浏览器会弹出Web UI,然后填上 DeepSeek API Key 就能用。
Key 去 platform.deepseek.com 充钱创建,也可以从设置那里自定义模型。
装完只是开始,界面纯纯空壳。
所以必装插件我列了个清单,下面可汗大点兵:
第一梯队
ModLens:识图
dsh-at-file:输入框打@引用文件
dsh-paste-input:Ctrl+V 粘贴、拖拽文件进对话框
dsh-office:读写 docx、pdf、pptx
dsh-browser-panel:内嵌浏览器,Agent操作网页
dsh-computer-use:Agent操作桌面,仅 macOS
第二梯队
safe-find-dsh-plugins:说需求自动找插件
dsh-web-ui:全家桶之任务看板、Git、手机远程、Token统计
dsh-genui:回复里渲染图表、表格、组件
dsh-turn-rewind:一键回退
dsh-message-edit:编辑已发消息、重新生成
第三梯队
dsh-agent-teams:多 Agent 干活
dsh-memory-evolve:跨会话长期记忆
dsh-llm-fallbacks:模型挂了自动切备用
dsh-feishu-bot:接飞书机器人
不止这些,这个页面(github.com/topics/dsh-plugin)目前收录了1000+插件了。
DSH 跟组装乐高一样,可玩性很高。
感觉是对标 pi,有没有人来讨论下哈哈哈哈。
DeepSeek Harness开源了,先别让手头上的Codex、CC下岗,因为它跟半成品没区别。
DSH「一切皆插件」的概念还蛮酷。
实际意思是装完以后连传文件、识图的功能都没有。。。
需要啥功能、就装啥插件。
所以现阶段面向的就是开发者,使用门槛还是有的,建议普通用户先观望吧。
想玩玩用这个指令,直接给到本地 Agent:
“
帮我安装并启动 DeepSeek Harness。
项目地址:github.com/deepseek-ai/deepseek-harness
先检查环境,缺什么装什么。
然后运行 npx @deepseek-ai/dsh web 并打开网页端。
”
跑完浏览器会弹出Web UI,然后填上 DeepSeek API Key 就能用。
Key 去 platform.deepseek.com 充钱创建,也可以从设置那里自定义模型。
装完只是开始,界面纯纯空壳。
所以必装插件我列了个清单,下面可汗大点兵:
第一梯队
ModLens:识图
dsh-at-file:输入框打@引用文件
dsh-paste-input:Ctrl+V 粘贴、拖拽文件进对话框
dsh-office:读写 docx、pdf、pptx
dsh-browser-panel:内嵌浏览器,Agent操作网页
dsh-computer-use:Agent操作桌面,仅 macOS
第二梯队
safe-find-dsh-plugins:说需求自动找插件
dsh-web-ui:全家桶之任务看板、Git、手机远程、Token统计
dsh-genui:回复里渲染图表、表格、组件
dsh-turn-rewind:一键回退
dsh-message-edit:编辑已发消息、重新生成
第三梯队
dsh-agent-teams:多 Agent 干活
dsh-memory-evolve:跨会话长期记忆
dsh-llm-fallbacks:模型挂了自动切备用
dsh-feishu-bot:接飞书机器人
不止这些,这个页面(github.com/topics/dsh-plugin)目前收录了1000+插件了。
DSH 跟组装乐高一样,可玩性很高。
感觉是对标 pi,有没有人来讨论下哈哈哈哈。
3 10
顶级 AI 模型价格被腰斩后,会发生什么?
Grok 4.6这波跟上了 DeepSeek梁子的节奏,与 GPT-5.6 Sol 同样的能力,但价格直接腰斩。
我理解,这不是一次促销,而是长期趋势。
Epoch AI 估算,达到同等能力水平的推理成本,大约每年下降 5—10 倍。
当顶级模型足够便宜,第一件事不是大家少花钱。
而是开始挥霍智能。
以前一次问答,未来可以是十个 Agent 并行。
以前人工抽查,未来可以让三个模型相互审核。
廉价的不是AI,而是可调用的判断力
——从“谁最聪明”,变成“一个任务到底多少钱、跑多久、失败几次”。
因为 token 单价低,不代表最终任务成本低。Agent 会循环、重试、读取长上下文,甚至持续工作几个小时。
最后很可能出现杰文斯悖论:
每个 token 越便宜,企业消耗的 token 反而越多。模型公司降价后,不一定少赚钱,反而会释放出过去根本不成立的新需求。
对 AI 产品来说,很多原本只能做一次性交付的功能,会升级成持续监控、自动复盘、主动执行的长期服务。产品竞争也会从“生成一个结果”,变成“持续把事情做到达标”。
AI 成为基建,不是因为它无所不能。
而是因为它便宜到,可以被浪费。
Grok 4.6这波跟上了 DeepSeek梁子的节奏,与 GPT-5.6 Sol 同样的能力,但价格直接腰斩。
我理解,这不是一次促销,而是长期趋势。
Epoch AI 估算,达到同等能力水平的推理成本,大约每年下降 5—10 倍。
当顶级模型足够便宜,第一件事不是大家少花钱。
而是开始挥霍智能。
以前一次问答,未来可以是十个 Agent 并行。
以前人工抽查,未来可以让三个模型相互审核。
廉价的不是AI,而是可调用的判断力
——从“谁最聪明”,变成“一个任务到底多少钱、跑多久、失败几次”。
因为 token 单价低,不代表最终任务成本低。Agent 会循环、重试、读取长上下文,甚至持续工作几个小时。
最后很可能出现杰文斯悖论:
每个 token 越便宜,企业消耗的 token 反而越多。模型公司降价后,不一定少赚钱,反而会释放出过去根本不成立的新需求。
对 AI 产品来说,很多原本只能做一次性交付的功能,会升级成持续监控、自动复盘、主动执行的长期服务。产品竞争也会从“生成一个结果”,变成“持续把事情做到达标”。
AI 成为基建,不是因为它无所不能。
而是因为它便宜到,可以被浪费。
5 00
Codex 必改的8 个基础配置
我是饼干哥哥,我给NGS每人配了200美金的Codex Pro。
结果上周团队有人跟我说:
Codex不如豆包好用,离了他一点活都干不了!!
我大为震撼,明明同一套餐,另一边已经蹬疯了。。
我把两边的设置拉出来一对比,不是Codex 的问题,是这8个配置没动,大家自查!
01 权限模式
点设置 → 常规 → 权限 → 打开完全访问权限。
默认权限每次改文件都要问一遍,平时我都无脑开最大权限,省得被弹窗打断。
02 个性化
点开左下角设置,找到个性化。
语气从默认"亲和"改成"务实",少说废话;
记忆功能打开,记住用户偏好;
自定义指令上GitHub搜"forrestchang/andrej-karpathy-skills",卡帕西吐槽Agent写的那份开源规则,整段复制粘贴进去就行。
03 跟进行为
点开左下角设置,找到常规。
编辑器下面把默认的"排队"切成"引导";
任务跑到一半能随时插话纠错,不用等跑完再返工。
04 会话管理
会话卡死、上下文太长没救了。
右键任务"复制会话ID",给到另一个对话框继续改;
如果是背景全但想另开路线,选"在新任务中继续"。
05 电脑操控
设置里找"电脑操控",打开"任意应用"和Google Chrome这两栏;
日常操作App、刷网页,让 Codex 爽玩你的电脑。
06 搜索任务
任务多了翻不到,点左侧边栏上方搜索图标🔍
弹出面板直接搜任务,比翻列表快。
07 语音听写
设置里点"语音",设好快捷键;
随时随地开始口喷,自动转中文,比打字都快。
08 重连接问题
如果总遇到"正在重新连接5/5"这问题,是Codex想走WebSocket,代理不支持就反复重连。
先把下面提示词丢给Codex修复:
“
请帮我修复"重连接"问题:
备份config.toml为config.toml.bak,新增provider(名openai_http,wire_api=responses,supports_websockets=false,requires_openai_auth=true,已有同名则跳过),顶部model_provider改成openai_http,完成后告诉我改了什么。
”
如果还卡,还有个方法:
“
帮我检测本地代理端口,先检查.codex/.env是否已存在并备份现有内容,查到端口就更新或追加代理这两行,不要整体覆盖;
查不到再问我;完成后告诉我具体改了什么、端口怎么确定的。
”
然后重启就 ok 了。
(* 改完如果发现会话变少了,是按 provider 分组的正常现象,改回去就行了。)
我是饼干哥哥,我给NGS每人配了200美金的Codex Pro。
结果上周团队有人跟我说:
Codex不如豆包好用,离了他一点活都干不了!!
我大为震撼,明明同一套餐,另一边已经蹬疯了。。
我把两边的设置拉出来一对比,不是Codex 的问题,是这8个配置没动,大家自查!
01 权限模式
点设置 → 常规 → 权限 → 打开完全访问权限。
默认权限每次改文件都要问一遍,平时我都无脑开最大权限,省得被弹窗打断。
02 个性化
点开左下角设置,找到个性化。
语气从默认"亲和"改成"务实",少说废话;
记忆功能打开,记住用户偏好;
自定义指令上GitHub搜"forrestchang/andrej-karpathy-skills",卡帕西吐槽Agent写的那份开源规则,整段复制粘贴进去就行。
03 跟进行为
点开左下角设置,找到常规。
编辑器下面把默认的"排队"切成"引导";
任务跑到一半能随时插话纠错,不用等跑完再返工。
04 会话管理
会话卡死、上下文太长没救了。
右键任务"复制会话ID",给到另一个对话框继续改;
如果是背景全但想另开路线,选"在新任务中继续"。
05 电脑操控
设置里找"电脑操控",打开"任意应用"和Google Chrome这两栏;
日常操作App、刷网页,让 Codex 爽玩你的电脑。
06 搜索任务
任务多了翻不到,点左侧边栏上方搜索图标🔍
弹出面板直接搜任务,比翻列表快。
07 语音听写
设置里点"语音",设好快捷键;
随时随地开始口喷,自动转中文,比打字都快。
08 重连接问题
如果总遇到"正在重新连接5/5"这问题,是Codex想走WebSocket,代理不支持就反复重连。
先把下面提示词丢给Codex修复:
“
请帮我修复"重连接"问题:
备份config.toml为config.toml.bak,新增provider(名openai_http,wire_api=responses,supports_websockets=false,requires_openai_auth=true,已有同名则跳过),顶部model_provider改成openai_http,完成后告诉我改了什么。
”
如果还卡,还有个方法:
“
帮我检测本地代理端口,先检查.codex/.env是否已存在并备份现有内容,查到端口就更新或追加代理这两行,不要整体覆盖;
查不到再问我;完成后告诉我具体改了什么、端口怎么确定的。
”
然后重启就 ok 了。
(* 改完如果发现会话变少了,是按 provider 分组的正常现象,改回去就行了。)
10 22
真的看不懂高铁的售票逻辑
我自己一个人出行
上车的时候,诺大的车厢空无一人
庆幸可以以 1 个人坐的时候
就上来一位乘客,非常精准的坐到了我的旁边
不是,这么多位置,为什么要匹配我啊?
整个车厢就我们俩,这合理吗?
我自己一个人出行
上车的时候,诺大的车厢空无一人
庆幸可以以 1 个人坐的时候
就上来一位乘客,非常精准的坐到了我的旁边
不是,这么多位置,为什么要匹配我啊?
整个车厢就我们俩,这合理吗?

5 21
如何给传统网站加上 Agent,让 AI 操作一切
上一篇提到我在做的 ngsFlow,要加一个 Canvas Agent 操作画布的踩坑经验。
现在跑出来了,关键在网站要把自己的业务能力整理成一套 Agent 可以理解和调用的产品协议。
如果你也在经营网站,想让 Codex 帮你加一个 Agent 让 AI 替用户操作功能,可以参考提示词:
```text
请分析当前网站代码库,并设计一套让 Agent 深度操作网站功能的改造方案。
要求:
1. 不替换现有业务流程、数据库、API 和任务系统,Agent 只作为旁路编排层。
2. 梳理网站现有核心能力,建立统一 Capability Catalog,避免在不同页面、CLI、MCP 中重复维护工具定义。
3. Agent 每次先读取当前页面和项目状态,再生成声明式执行计划。
4. 所有写操作必须支持 dry-run、变更预览、一次确认、原子提交、版本冲突检测和撤销。
5. 付费、删除、覆盖、发布、本地命令等操作增加独立审批和预算限制。
6. 长任务使用持久化 Run/Job 状态,不依赖一个长 HTTP 请求。
7. 执行完成后必须通过确定性条件验证,不能仅凭模型回复判断成功。
8. 建立统一 Trace,记录 run、turn、tool、审批、耗时、结果、失败原因和敏感信息脱敏。
9. 全局 Agent UI 可以常驻,但会话、权限和上下文必须按用户、项目和页面隔离。
10. 保持旧功能和旧客户端兼容,给出分阶段实施方案、公共接口、数据表、核心类型、测试计划和回滚策略。
请先进行只读代码审计,再输出:
- 当前架构与主要问题
- 目标架构图
- 分阶段改造计划
- 需要新增或修改的模块
- 风险与兼容策略
- 可验证的验收标准
不要直接大规模重写代码,优先复用现有业务能力和任务系统。
```
协议整理好之后,接入方随便换:网页侧栏 Agent、本地 Codex / Claude Code 走 CLI 和 MCP 都能用
上一篇提到我在做的 ngsFlow,要加一个 Canvas Agent 操作画布的踩坑经验。
现在跑出来了,关键在网站要把自己的业务能力整理成一套 Agent 可以理解和调用的产品协议。
如果你也在经营网站,想让 Codex 帮你加一个 Agent 让 AI 替用户操作功能,可以参考提示词:
```text
请分析当前网站代码库,并设计一套让 Agent 深度操作网站功能的改造方案。
要求:
1. 不替换现有业务流程、数据库、API 和任务系统,Agent 只作为旁路编排层。
2. 梳理网站现有核心能力,建立统一 Capability Catalog,避免在不同页面、CLI、MCP 中重复维护工具定义。
3. Agent 每次先读取当前页面和项目状态,再生成声明式执行计划。
4. 所有写操作必须支持 dry-run、变更预览、一次确认、原子提交、版本冲突检测和撤销。
5. 付费、删除、覆盖、发布、本地命令等操作增加独立审批和预算限制。
6. 长任务使用持久化 Run/Job 状态,不依赖一个长 HTTP 请求。
7. 执行完成后必须通过确定性条件验证,不能仅凭模型回复判断成功。
8. 建立统一 Trace,记录 run、turn、tool、审批、耗时、结果、失败原因和敏感信息脱敏。
9. 全局 Agent UI 可以常驻,但会话、权限和上下文必须按用户、项目和页面隔离。
10. 保持旧功能和旧客户端兼容,给出分阶段实施方案、公共接口、数据表、核心类型、测试计划和回滚策略。
请先进行只读代码审计,再输出:
- 当前架构与主要问题
- 目标架构图
- 分阶段改造计划
- 需要新增或修改的模块
- 风险与兼容策略
- 可验证的验收标准
不要直接大规模重写代码,优先复用现有业务能力和任务系统。
```
协议整理好之后,接入方随便换:网页侧栏 Agent、本地 Codex / Claude Code 走 CLI 和 MCP 都能用
2 00
复盘一个典型的 Agent Harness 问题
上篇讲到我在开发 ngsFlow AI画布,有个 Canvas Agent 可以帮用户直接搭工作流。但结果很尴尬:它只能稳定完成 3 个节点左右的简单连线,一旦涉及复杂需求,就开始漏节点、连错线、做到一半停下来说"完成了"。
后来专门去读了 Anthropic、OpenAI 的公开实践分享,才发现这是个典型的 Agent Harness 问题。(可以直接拉到文末看解决方案)
Harness 不是模型,而是模型外面的整套执行环境:
Agent 怎么理解产品状态,怎么选择工具,怎么规划步骤,怎么安全执行,怎么验证结果,失败之后怎么恢复。
MCP 解决的是“怎么接进来”,CLI 解决的是“怎么调用”。
但它们都不保证 Agent 能完成复杂任务。
具体到 ngsFlow,问题有三个。
第一,工具重叠严重:多个工具都能建节点,Agent 每一步都要先纠结用哪个,工具越多选择越差。
第二,Agent 要自己管理节点 UUID、自己算坐标、自己维持十几步调用之间的状态,这些恰恰是模型最不擅长的。
第三,没有验证环节,工具调用返回成功,Agent 就认为任务完成了,至于画布上是不是真的有 10 个节点,没人检查。
怎么破?大厂的解法可以总结成 5 个点:
1. 收敛成少量高层工具。
Anthropic 明确说过,把产品 API 原样包成几十个工具是常见错误。应该提供面向完整工作流的工具,比如"创建一条生成流程",内部的多次操作由产品自己完成。原子工具留在底层,不默认暴露给模型。
2. 让 Agent 提交声明式 Plan,而不是几十次离散调用。
Agent 只需要描述要创建哪些节点、怎么连接、布局目标和完成条件。真实 ID、坐标计算、批量循环和事务提交,都交给确定性的 Runtime。
3. 确认粒度提到计划级。
不要每建一个节点弹一次确认。先 dry-run 展示完整预览和预计费用,用户确认一次,然后原子执行。否则长任务天然被切碎。
4. 复杂批处理交给受限 Code Mode。
创建 10 个节点、批量连线这类任务,让 Agent 在沙箱里调用领域 SDK 写循环,通常比连续调用十几次 MCP 更稳定。
5. 强制验证。
Plan 里内置后置条件:节点数量对不对、有没有断线、有没有重叠。执行完由 Runtime 重新读取状态逐条检查,不通过就进入修复循环,通过才算完成。MCP-Atlas 基准显示,大量失败发生在工具全部调用成功之后——模型提前停了。
一句话概括这套 Harness 的思路:模型负责决定要什么,Runtime 负责保证做对。
上篇讲到我在开发 ngsFlow AI画布,有个 Canvas Agent 可以帮用户直接搭工作流。但结果很尴尬:它只能稳定完成 3 个节点左右的简单连线,一旦涉及复杂需求,就开始漏节点、连错线、做到一半停下来说"完成了"。
后来专门去读了 Anthropic、OpenAI 的公开实践分享,才发现这是个典型的 Agent Harness 问题。(可以直接拉到文末看解决方案)
Harness 不是模型,而是模型外面的整套执行环境:
Agent 怎么理解产品状态,怎么选择工具,怎么规划步骤,怎么安全执行,怎么验证结果,失败之后怎么恢复。
MCP 解决的是“怎么接进来”,CLI 解决的是“怎么调用”。
但它们都不保证 Agent 能完成复杂任务。
具体到 ngsFlow,问题有三个。
第一,工具重叠严重:多个工具都能建节点,Agent 每一步都要先纠结用哪个,工具越多选择越差。
第二,Agent 要自己管理节点 UUID、自己算坐标、自己维持十几步调用之间的状态,这些恰恰是模型最不擅长的。
第三,没有验证环节,工具调用返回成功,Agent 就认为任务完成了,至于画布上是不是真的有 10 个节点,没人检查。
怎么破?大厂的解法可以总结成 5 个点:
1. 收敛成少量高层工具。
Anthropic 明确说过,把产品 API 原样包成几十个工具是常见错误。应该提供面向完整工作流的工具,比如"创建一条生成流程",内部的多次操作由产品自己完成。原子工具留在底层,不默认暴露给模型。
2. 让 Agent 提交声明式 Plan,而不是几十次离散调用。
Agent 只需要描述要创建哪些节点、怎么连接、布局目标和完成条件。真实 ID、坐标计算、批量循环和事务提交,都交给确定性的 Runtime。
3. 确认粒度提到计划级。
不要每建一个节点弹一次确认。先 dry-run 展示完整预览和预计费用,用户确认一次,然后原子执行。否则长任务天然被切碎。
4. 复杂批处理交给受限 Code Mode。
创建 10 个节点、批量连线这类任务,让 Agent 在沙箱里调用领域 SDK 写循环,通常比连续调用十几次 MCP 更稳定。
5. 强制验证。
Plan 里内置后置条件:节点数量对不对、有没有断线、有没有重叠。执行完由 Runtime 重新读取状态逐条检查,不通过就进入修复循环,通过才算完成。MCP-Atlas 基准显示,大量失败发生在工具全部调用成功之后——模型提前停了。
一句话概括这套 Harness 的思路:模型负责决定要什么,Runtime 负责保证做对。

3 00