即刻App年轻人的同好社区
下载
personal agent或许是美团搭上AGI末班车的绝佳机会,作为掌握吃喝玩乐住行购物全场景、拥有海量用户基础、行为偏好数据、支付信任的平台,live better的使命和PA不谋而合,没有人比美团更拥有资源禀赋。错过了可能就彻底沦为数百亿美金的老登公司,抓住了则有希望重新回到数千亿市值。
首先要做的就是千万不要指望内部员工能干成了,如果我是兴哥,我会考虑把todayai或者一个类似的公司收购,内部所有权限给他开放,年底之前绝对有机会做起来。
首先要做的就是千万不要指望内部员工能干成了,如果我是兴哥,我会考虑把todayai或者一个类似的公司收购,内部所有权限给他开放,年底之前绝对有机会做起来。
13 25


当在一个问题空间里长期无法判断谁是最优解时,不一定意味着问题太复杂,也可能意味着研究的层级错了。
与其继续比较“谁更好”,不如进行思考升维,寻找决定整个系统最终结果的核心瓶颈、不可替代资源或者底层反馈机制。
例如 AI 应用到底投什么?
可能会讨论:AI coding、AI 搜索、AI agent、AI healthcare、AI 教育、AI design、AI客服......
然后发现每个赛道看起来都有机会,但每个赛道也都有大量不确定性。继续往下研究,会陷入“这个赛道比那个赛道好一点吗?”但这时候可能永远得不到非常确定的答案。
此时或许需要问的是,不管最终 AI 应用是什么,什么样的公司最终更容易长期创造价值?这时候研究对象就不是哪个vertical,而是独家数据、深度嵌入客户workflow、高频使用中持续迭代etc.
研究掌握什么要素的公司更有可能成功,比直接选赛道更接近投资的本质。
同样的例子在具身智能领域也是同理。
VLA也好,WAM也罢,怎么加action expert,怎么做表征,通过读一堆paper想知道到底哪个 architecture 更优?会陷入非常难的 object-level debate,很难判断到底哪条技术路线是终局。
此时就应该升维思考,机器人学习真正的瓶颈到底是什么?于是会发现一个更基础的问题:机器人世界的数据生成成本太高,而且缺少高质量、低成本的 evaluation / reward / verification。
谁能够用最低的成本给机器人训练进行feedback,克服sparse reward难以找到合适梯度的问题,类似大模型在数学、coding等science任务上的RL环境,谁就具备快速scaling的能力,找到找到合适的模型 architecture反而不难。
因此升维不是逃避无法回答的问题,而是寻找一个更高层级、对下层结果具有支配作用的变量。通过升维,才会认知当 intelligence 越来越 abundant,真正稀缺的东西反而可能从“智能”转移到“现实世界的数据、关系和反馈”。
5 00

关于gptX会不会把具身智能的模型颠覆掉
Robocurve的puzzle task里面GPT6的success rate只有10%,我觉得这个实验其实非常“诚实”。
它说明:
GPT 很强的部分:“我要抓住这个圆片中心的 knob,然后放进那个槽。”
GPT 不够强的部分:“现在距离槽 1.5mm,夹爪需要往右 0.6mm,同时降低 z 0.3mm,并根据接触力判断是否已经插入。”
这就是典型的 embodied control problem。
它需要:
precise geometry
force sensing
contact dynamics
friction
proprioception
tactile feedback
high-frequency control
而这些东西不是从大量互联网文本中自然出现的。
所以:
physical intelligence 的最后 10% 很可能比 cognitive intelligence 的最后 10% 难得多。
3 00
最近市场上开始动辄就出现一些5-10亿美金的大天使,虽然说AI时代买卡需要很多钱,但是从投资回报角度来看,如果公司做不到100亿美金,考虑到dilution,VC是几乎赚不到钱的。
简单统计了一下,过去10年新成立的公司里面,市值/估值超过100亿美元的公司,美国一共只有不到40家;中国如果按照500亿,则只有20家左右。
进一步来看,美国的百亿美金公司,其中3家foundation model、7家compute/data infra、5家AI native software、3家physical ai、10家enterprise saas和healthcare、其他还有个别国防军工等。
而中国的公司里面,接近一半都是半导体、4家大模型、3家互联网平台、3家新能源、外加一个宇树。
由此可见,真正能出现百亿美金级别的机会的赛道,其实并不多。而所有的美元基金要想做到出色的DPI,一定要在这些大机会里面抓住1-2个,最牛的机构或许可以投到5个以上。
当然值得一提的是,从成立到百亿美金的时间,可能随着inflation会逐渐缩短。但anyway,5-10亿美金的超贵天使,还是得慎重下手
25 95
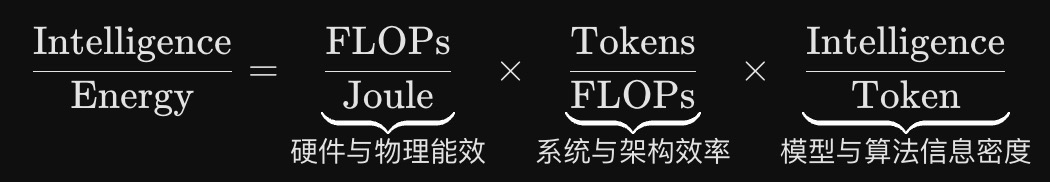
AI时代应该会有新的摩尔定律,制程逼近极限之后从硬件设计角度已经基本到头,且token爆发式增长背后稀缺资源逐渐成为能源,因此Intelligence / Energy或许是新时代的摩尔定律,且将会以每年数倍的速度持续增长
4 00
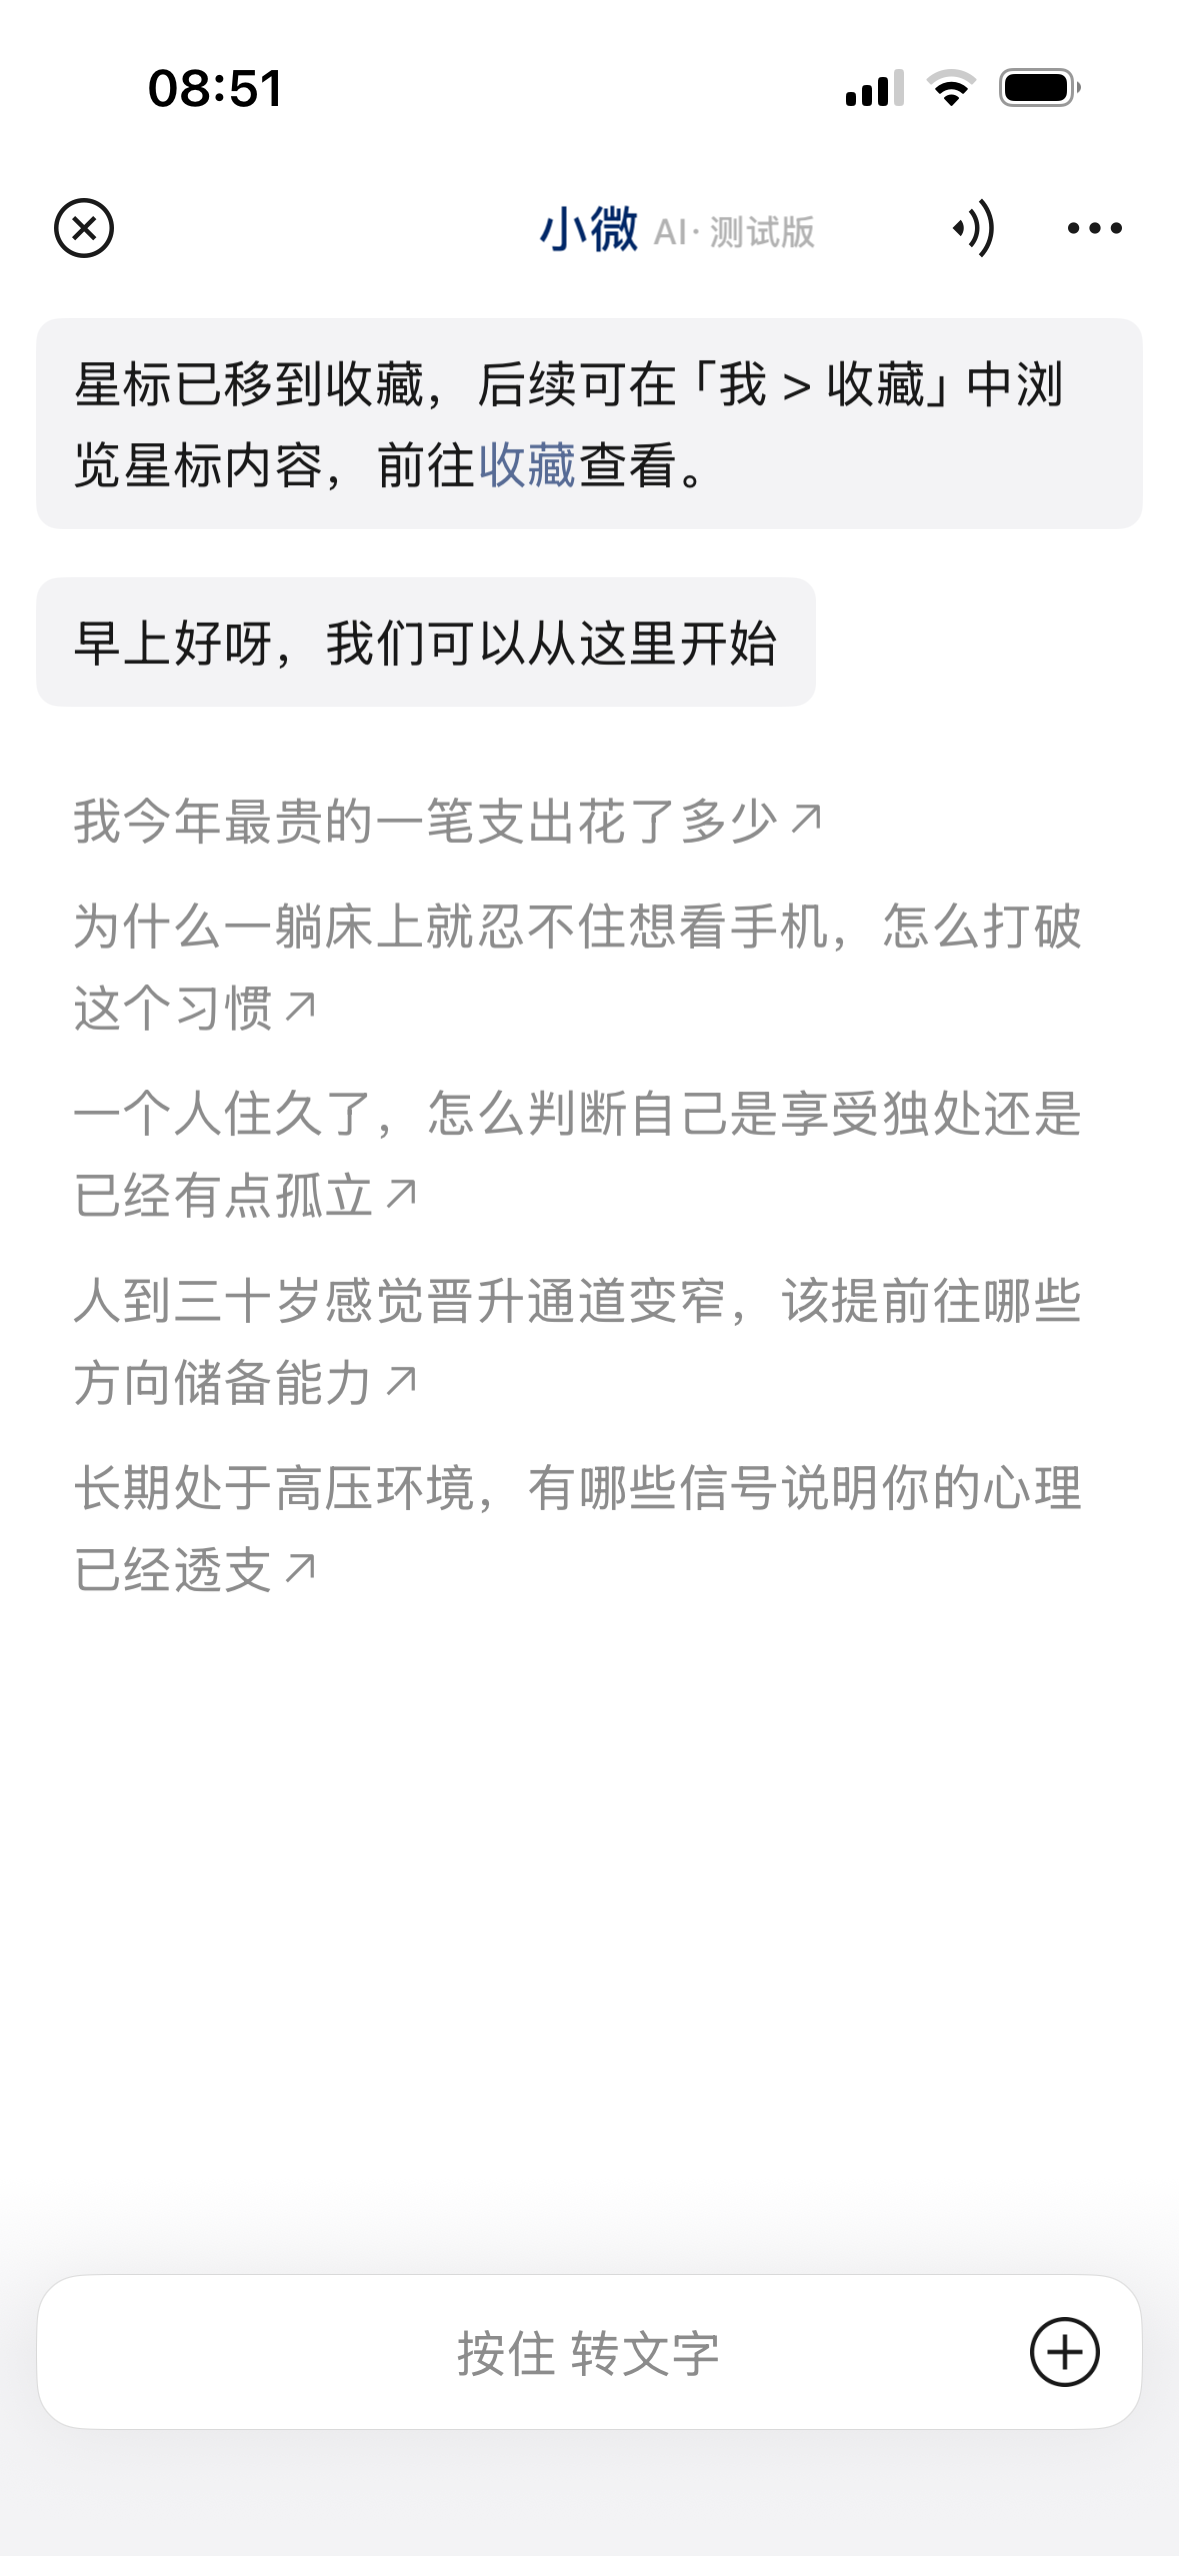
微信这次有点猛,给了chatbot两个这么优先的流量位,还能索引视频号和小程序,这次对豆包的量应该要有不小冲击了。不过唯一美中不足的是他不能retrieve我的聊天记录,不然真的就王炸了
5 11