即刻App年轻人的同好社区
下载
 置顶
现实当中我们有多少任务是可以甩手,不需要任何外界信息的摄入就长时间执行的?我是看到孔博士的微信推文里面提到,他去做了个小调研,发现超过1小时的真实任务好像不那么多。
现实工作中,经常做着做着发现,需要补充信息,需要跟别人沟通获取信息,然后把新信息消化掉,再加工。
要无人值守,让agent做一个很长的任务,意味着操作者需要一开始就把信息提供完整,这非常难。
而且,几个小时过去,如果人有责任心、勤于思考,可能自己对于这个问题也会有一些新想法,他也需要把这些新想法补充到agent的进程里面去。
有一些任务符合条件,比如证明数学猜想,或者把编程项目从一个语言迁移到另一个语言,这些问题很难,需要执行很久,而且信息可以在一开始就给齐。
模型厂商为了突破长程任务,提高了模型主动校验闭环、处理长上下文的能力。有了这些能力,agent可以做几十个小时的任务。由于上述人类交付信息的方式,我认为已经不太实用。另外,太长的任务,就算agent交付了,由于工作量太大,人类去审阅结果的质量也很难,不如拆成更小的issues分别去解决。这里就牵涉到另外一个问题——基于issue的agent管理机制。
在这些突破之后,模型执行任务已经不缺能力,而是缺信息。这也就是Matt skills这个套组有用的地方,它解决的是信息问题。信息永远要提供,因为模型不可能知道我的需求。模型不是我肚子里的蛔虫,它不知道我的话是什么意思。不同的人讲同样的词,意思都可能不一样。模型无法得知给它下需求的人到底是什么意思,它得从多个角度来询问我,然后我们才能够对齐,尽量把误解降到最小。
这就是Matt skills的思想。
有一种幻想,说一个企业可以把知识库沉淀下来,然后就能做Deep Research了。
我不知道有多少人尝试过Deep Research。以我的标准而言,Deep Research出来的结果准确率仍然不够高。
很多时候是“搜商”有问题,模型不知道自己不知道什么。它会按自己的想法去搜索和构建,往往掌握的信息已经过时了,但它还不知道,还按已经掌握的旧假设去搜,结果搜到旧信息,于是一切都是对的、自洽的。最后出一份刻舟求剑的报告,其准确性,在我的场景,能有50%就不错了。
“不知道自己不知道什么”这个信息覆盖问题很难解决,这也是所有agent的长程任务必须要面对的一个困难。在执行长程任务之前,agent怎么确定它的信息是完备的?
不要说一个企业的知识库了,就算我作为一个个体给agent下任务时,可能做着做着就发现它跑偏,跟我的预期不一样。因为agent没有和我对齐。我以为一件事是不言自明的,但它其实不知道,它也不知道自己不知道,也不会来问我,所以就做不好。
这也说明了为什么所谓的“loop engineering”行不通。这个词一度很火,受到Peter Steinberger和Boris Cherny的追捧。整个loop过程都没有外界信息的摄入,只是让agent自己不断地重复,缺的信息一直缺下去,结果自然不会优化。
Matt skills的精髓就在于,会要求agent向我盘问各种细节,也就是著名的grill-me。甚至,Matt skills套组里还有一个新技能叫做to questionnaire,功能是把当前问题列表整理成问卷,以发给同事或者其他人。不仅让使用者可以补足信息,也让使用者可以邀请团队成员一起补足信息。
那么,模型不知道自己不知道什么,它都不知道,又怎么能问出来呢?Matt的做法是:让模型先写方案,然后把模型写的方案里面的每个抉择点拿出来问。一问,自然就知道缺什么信息了,用户和模型对一下就可以。根据补充的信息,改一下决策,得出来的决策结果自然质量更高。
当然,有的人会觉得很烦,觉得问题问得太多。因为每一个抉择点都拿出来问,自然是过于饱和。但经过了几轮产品层面优化,现在Matt skills一轮会一齐问三四个问题,而且大部分选默认就可以,我们只需少量干预,体验有所改善。这个被问的过程,正好也是我们审阅agent计划的过程。这样还挺好,等于我还顺便看了一眼agent的决策,比完全摸黑要更有控制力,还回顾、梳理了自己的需求。
我喜欢Matt skills远远超过Superpowers。Superpowers希望把人类的一些很好的工程规范介绍给agent。但首先我觉得没有一个好的工程规范可以解决所有问题,工程需要灵活性。而模型自身的通用智能能力提升,在学习了大量工程手段、掌握了深刻的工程思想之后,它自己就知道拿到什么样的需求,该用什么样的工程规范去做。它具有灵活性,比任何规则都还要灵活智能。
但是Matt skills不一样,它解决的是信息问题。模型永远缺信息,所以这是需要我来提供的。虽然Matt skills里也有工程方面的内容,但主要还是围绕信息展开。
而且Matt skills体现的是对模型性格的设定,即希望模型来询问用户。但在很多任务上,是不需要模型这么做的。比如面对简单问题的时候,我问一句话,模型直接交付结果就行了,不用总是问。有时候用户可能希望它问,有时候用户可能不希望它问。
调用模型API的时候,经常出现这种情况:问模型是谁,模型却答不出来自己的名字。模型厂商当然可以通过训练让模型正确地答出自己的身份。但各公司现在都不这么做。
有一种传言说,这样做会降低模型的通用智力,但是我没有找到论文和研究来佐证这一点。我想从产品层面也有这样做的理由:如果模型强化了它的身份信息,意味着我作为下游开发者,调用模型API向我的客户提供服务时,客户问它是谁,它还会很倾向于说“我是某某厂商的模型”,而更不愿意说我指定的产品名字,这样肯定不行。所以,类似这种身份、性格信息是不适合训到模型里的,而是适合写在指令里,在系统指令里面告诉模型:“你是谁谁谁”。这样才更契合模型API本身作为一个产品在市场上的需求。
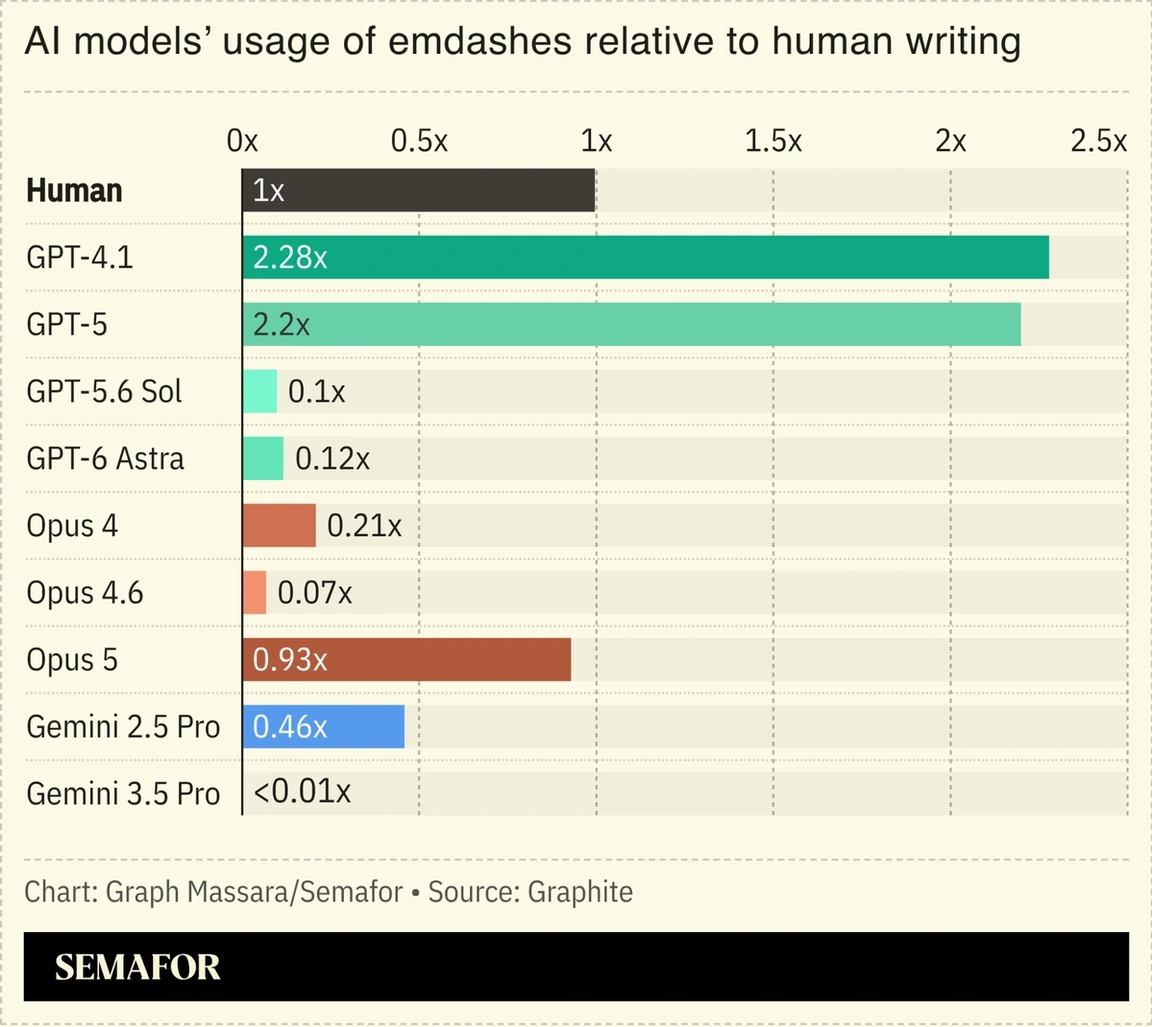
同样,针对每一个决策做盘问,作为一种性格,肯定也不适合内化到模型中。比如模型API也可以做陪伴应用、客服应用,这些场景盘问性格都不合适。所以“盘问”就更适合作为外挂指令。有朋友反馈,GPT 6 Astra很喜欢盘问,它干活的时候觉得有问题,就会停下来问人,而这在很多场合是有问题的。这个特征一旦作为模型性格底色,在很多应用场景就会不适配。因此,我相信,喜欢盘问将不会是未来模型的原生性格,Matt skills作为外挂需要长期存在,这是它跟Superpowers的不同之处。
那么,在利用Matt skills把信息全部对齐以后,我们是不是就可以做十几个小时的任务了呢?因为,我们已经在执行行动开始之前,把信息都给齐了。
我觉得仍然有困难。如果要执行的是对agent而言都要做十几个小时的任务,那就意味着这个任务方案也会非常长,人很难在有限的注意力和工作记忆里,把这么长的方案审阅、决策、答复清楚。做方案给信息本身,就把任务约束在了一定规模之内。人处理信息的规模将会约束任务的规模。当然,前文提到的数学证明、代码迁移这种信息几乎全部在项目本身的情况除外。

长程任务、Matt skills、信息瓶颈
16 01
迪士尼继承之战
Soon after my arrival at The New York Times in March 2020, a source suggested I write about the fact that Bob Iger, who had just handed the reins at Disney over to Bob Chapek, appeared to have thrown himself back into the company amid the developing COVID-19 crisis. Though my title there was media columnist, I’d never covered Hollywood and didn’t know the players. But this was the Times, so Iger responded to my inquiries:
“A crisis of this magnitude, and its impact on Disney, would necessarily result in my actively helping [Chapek] and the company contend with it, particularly since I ran the company for 15 years!” Iger told me back then in a brief email.
The story — and, I think, the perception that Iger had deviously placed it to undermine his successor — turned into one of the industry’s great dramas. My contact with Iger, it turned out, was the last straw: “When he did the interview with Ben Smith where he essentially reasserted himself as CEO — that was as big a sign as possible of an attempt to undermine me,” Chapek told the The Wall Street Journal last week.
As is often true, the reality was dumber than the theories: While the underlying tensions between the Bobs were obviously real, my story wasn’t some devious plant; I was new to the beat and bumbling around. Iger didn’t call me up to do an interview; he shot back a couple short emails. These theories often give everyone too much credit.
1 00
我也觉得应该是 codex 抄中国产品吧😂

葬愛咸鱼: codex改版了,我的意思是办公agent赶紧抄
6 30
这也就是做自由软件的人所说的,开源软件不等于自由软件。

momo....: 我发现现在很多开源项目背后都是一个公司在做,而且还会花钱找人做推广,前期开源免费,后期慢慢都加入商业化,变成一个商业产品了 开源或许是他们冷启动最快的方式🤔
7 00
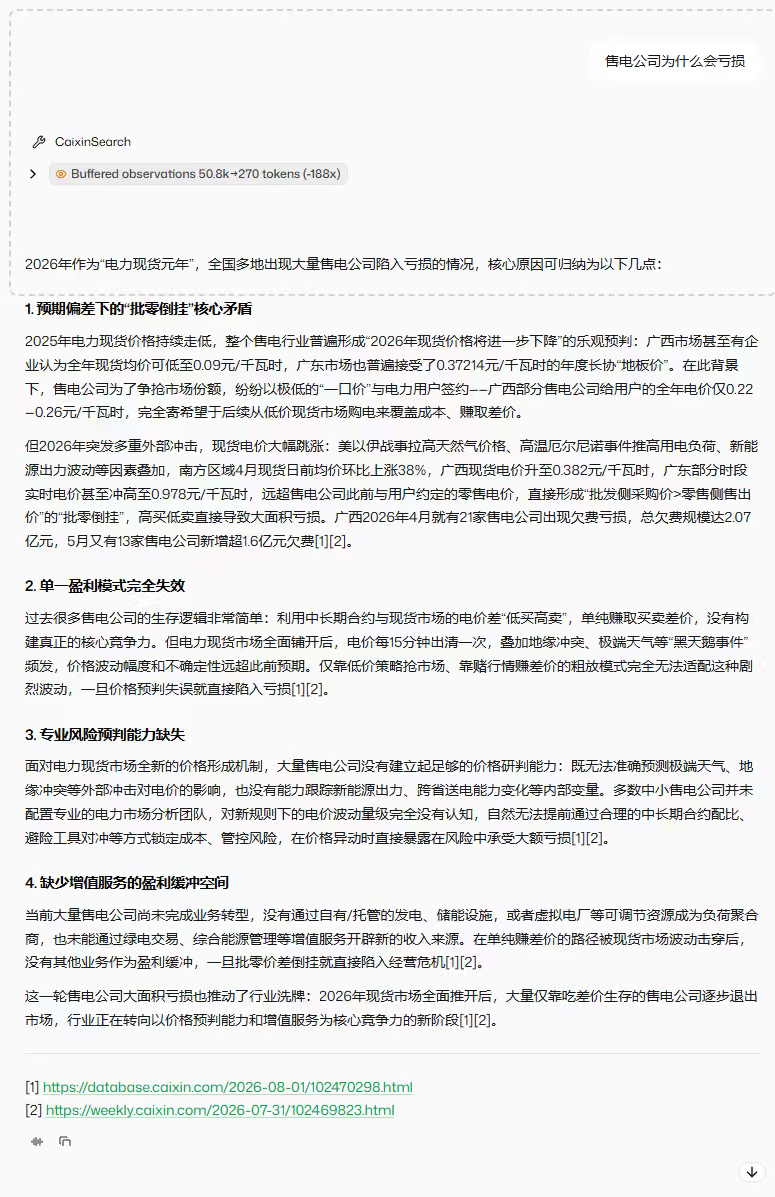
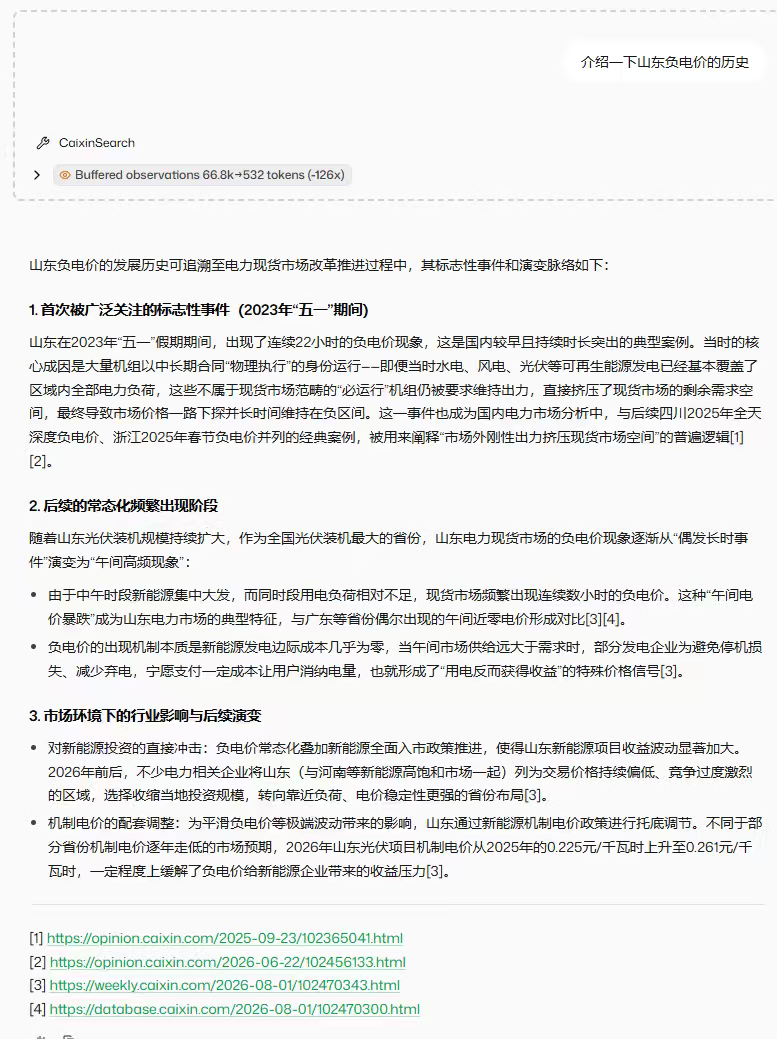
不过今天看到 Ben Evans 说:“I think Muse is the new Clubhouse.”他说话应该就有分量一些了。

大核桃: 在这一波海外的Personal Agent的讨论中,如果没有真正的深度使用邮件,完全不刷Facebook,不了解Marketplace有多重要,那其实很难得出什么坚实的结论。 我也得不出来,因为我没有在海外的生活环境中,所以学学产品设计层面的精彩之处对我更有价值。
7 00
> 一位上海实验室的预训练研究员给了我所见过的对 agentic gap(智能体能力差距)为何存在的最原创解释:中国缺乏足够的 RL 环境。
> 美国公司默认彼此互操作。开放 API、MCP、webhook,上百种 SaaS 产品都假定自己会被其他软件调用。这意味着美国的智能体是针对真实世界的界面进行训练的。当你教一个模型调用工具、把多步工作串联起来时,工具是现成的、有文档的,使用它们是家常便饭。
> 中国的技术生态是封闭的,有两个相互叠加的原因。首先,B2B SaaS 在中国从未跑通,所以一开始就没有多少可供工作共享的界面。其次,每家公司都与其他所有公司竞争,而且存在一种真实的恐惧:一旦某家公司触碰了另一家的数据,就会被“吃掉”。其结果是,智能体没有任何东西可以练习。
> 这比“他们在后训练上落后”是一个好得多的理论,因为它能解释那些更简单的理论解释不了的事情。它有可能解释为什么字节跳动的 UI-TARS 原生 GUI 智能体赌注会存在。那是针对封闭生态的一种架构性绕行方案,而不是押注 GUI 智能体是更优的范式。它也解释了我一直注意到、却无法在这个生态中给出理由的那种缺失:这里没有值得一提的可互操作基础设施层,因为根本就不存在互操作。阿里先做云,再做芯片,再做模型,再做应用,全部自研,一路到底。
> 这对任何在这里做构建的人都很重要:我们当作便利的美国式互操作,实际上是一种训练资产。 开放 API 让集成变得更容易;它们也创造了智能体学习的环境。这不是一个靠在后训练上投入更多就能弥合的差距。只有当底层生态开放,它才会弥合,而底层生态之所以封闭,原因是竞争性和结构性的,而非技术性的。
> 如果你在构建一家美国应用公司,你的集成界面和数据回路就是你的护城河。尽你所能,掌控并培育你的产品向最终客户的交付。
https://earnedintuition.substack.com/p/involution-without-export-is-wasted
20 14