即刻App年轻人的同好社区
下载
招 10 个「AI对话管理器」体验官(免费)
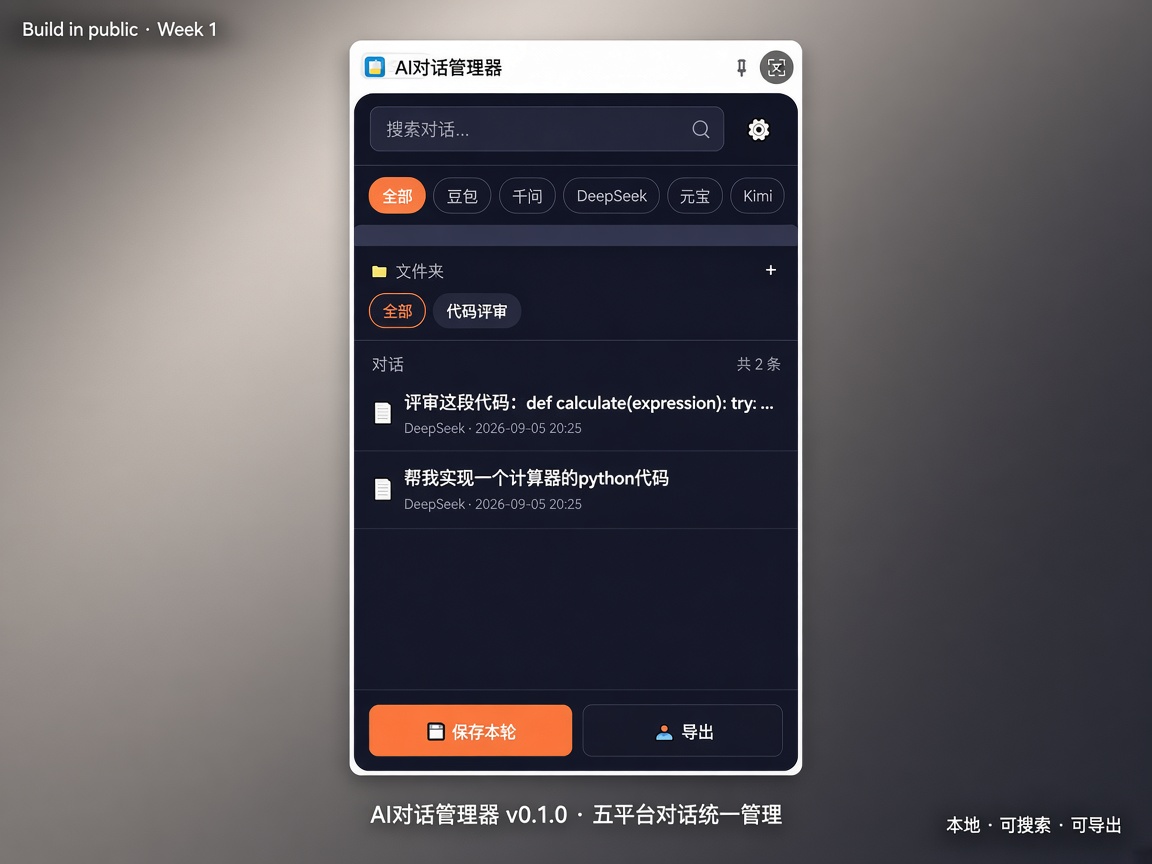
我在做 Edge/Chrome 扩展:把豆包、千问、DeepSeek、元宝、Kimi 的对话存到浏览器侧栏——本地整理、搜索、导出,不上传服务器。
找的人:
· 每周至少用 2 个 AI
· 有 Edge 或 Chrome
· 愿意装完回我几句真实卡点
怎么装:
· Edge(省事):扩展商店搜「AI对话管理器」
· Chrome:GitHub 搜 SantoCc/ai-chat-manager → 下载解压 → chrome://extensions/ 开开发者模式 →「加载已解压的扩展程序」
说明页:santocc.github.io/ai-chat-manager
装完评论区回三句就行:
1)最先用了哪个功能
2)卡在哪 / 最缺什么
3)不用插件时你怎么找旧对话
不是互推,是按反馈改产品。符合的扣 1 / 直接回。
0 00
「AI对话管理器」已经可以在 Edge 里搜到并安装了。
解决什么问题?
豆包 / 千问 / DeepSeek / 元宝 / Kimi
对话散落在各个网站,事后很难找、很难复用。
我做的不是又一个聊天机器人,
而是把聊完的内容变成可管理资产:
保存 · 整理 · 搜索 · 导出 · 数据默认留在本地。
怎么装(不放外链)
1. 用 Microsoft Edge 打开扩展商店
2. 搜索:AI对话管理器
3. 安装后打开侧栏,在 AI 对话页点「保存本轮」
小提示
· 请先打开具体对话页再保存
· 重载扩展后,记得刷新一下 AI 页面
· Kimi 需要进入具体会话页再保存
欢迎评论区聊聊:你平时同时开几个 AI?
解决什么问题?
豆包 / 千问 / DeepSeek / 元宝 / Kimi
对话散落在各个网站,事后很难找、很难复用。
我做的不是又一个聊天机器人,
而是把聊完的内容变成可管理资产:
保存 · 整理 · 搜索 · 导出 · 数据默认留在本地。
怎么装(不放外链)
1. 用 Microsoft Edge 打开扩展商店
2. 搜索:AI对话管理器
3. 安装后打开侧栏,在 AI 对话页点「保存本轮」
小提示
· 请先打开具体对话页再保存
· 重载扩展后,记得刷新一下 AI 页面
· Kimi 需要进入具体会话页再保存
欢迎评论区聊聊:你平时同时开几个 AI?
0 00
Build in public · 最痛的 3 个坑(细拆)
做多站点内容抽取时,最容易踩的不是「取不到」,
而是 DOM 一改版就碎,还把推荐墙、思考壳当成正文。
我在写一个 Edge/Chrome 扩展(AI对话管理器),
要统一保存豆包 / 千问 / DeepSeek / 元宝 / Kimi 的对话。
下面细拆最痛的 3 个坑。
————————
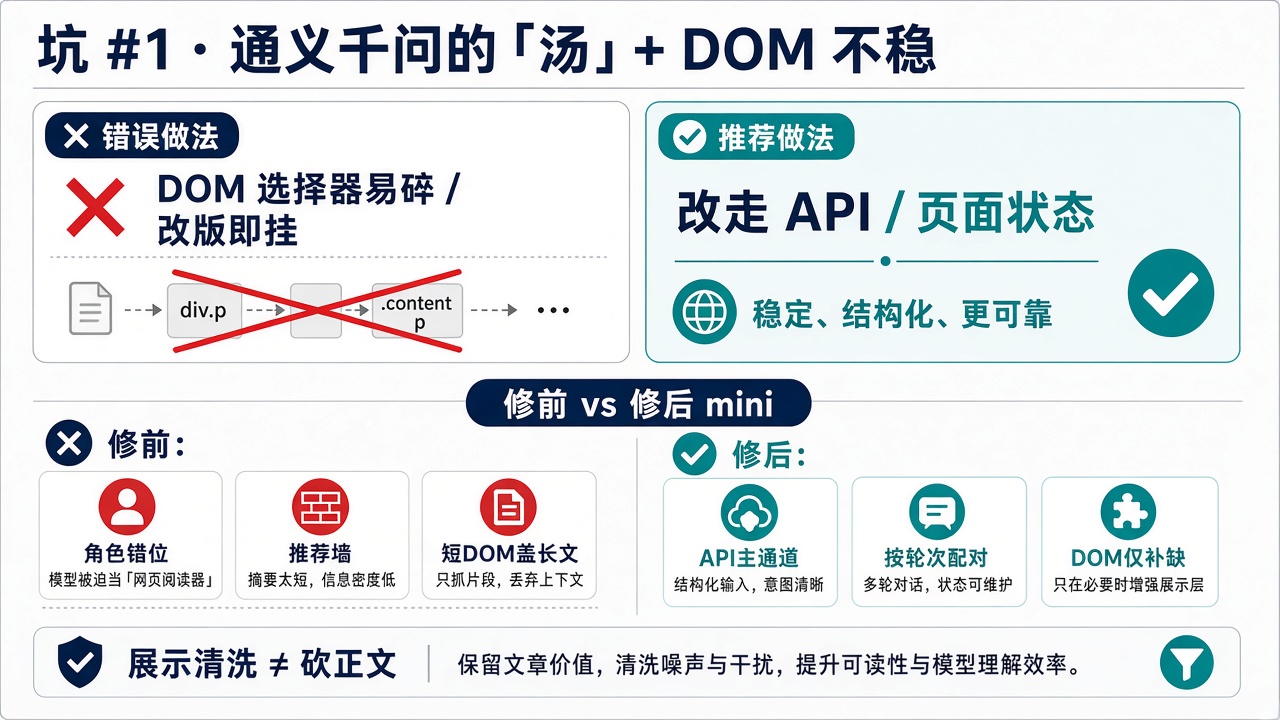
坑 #1|通义千问的「汤」+ DOM 不稳
现象
· 用户 / AI 角色错位
· 正文被「推荐 / 检索 / 思考过程」顶掉
· 表格、加粗丢失
· 图和 Word 变成一串怪文字,或卡片直接没了
· 同一套 DOM 逻辑,站点小改就抽空/抽错
为什么难
千问不是纯 DOM 文本。一页里同时有:
思考壳、检索墙、推荐卡、多轮问答、媒体结构。
早期为了「保留格式」,优先拿带 Markdown 的 DOM 碎片——
短碎片盖掉完整正文;合并时又「全局取最长一段」,
第二轮回答直接消失。
更麻烦的是:class / 结构不契约,DOM 路径本身就不稳定。
怎么拆开的
1)主通道改走 API / 页面状态(chatRounds 等),不再赌选择器
2)DOM 降级为补缺:只补缺轮、补格式;短 DOM 不得覆盖长正文
3)结构类型黑名单:think / planning / 推荐卡先跳过
4)按轮次配对:用户A→AI答A,用户B→AI答B,禁止跨轮折叠
5)展示层可剥思考壳;存储层不砍原文与媒体
教训
多站点适配,最危险的不是「取不到」,
而是取到了一锅汤,还以为是答案;
以及把易碎的 DOM 当成唯一真相。
————————
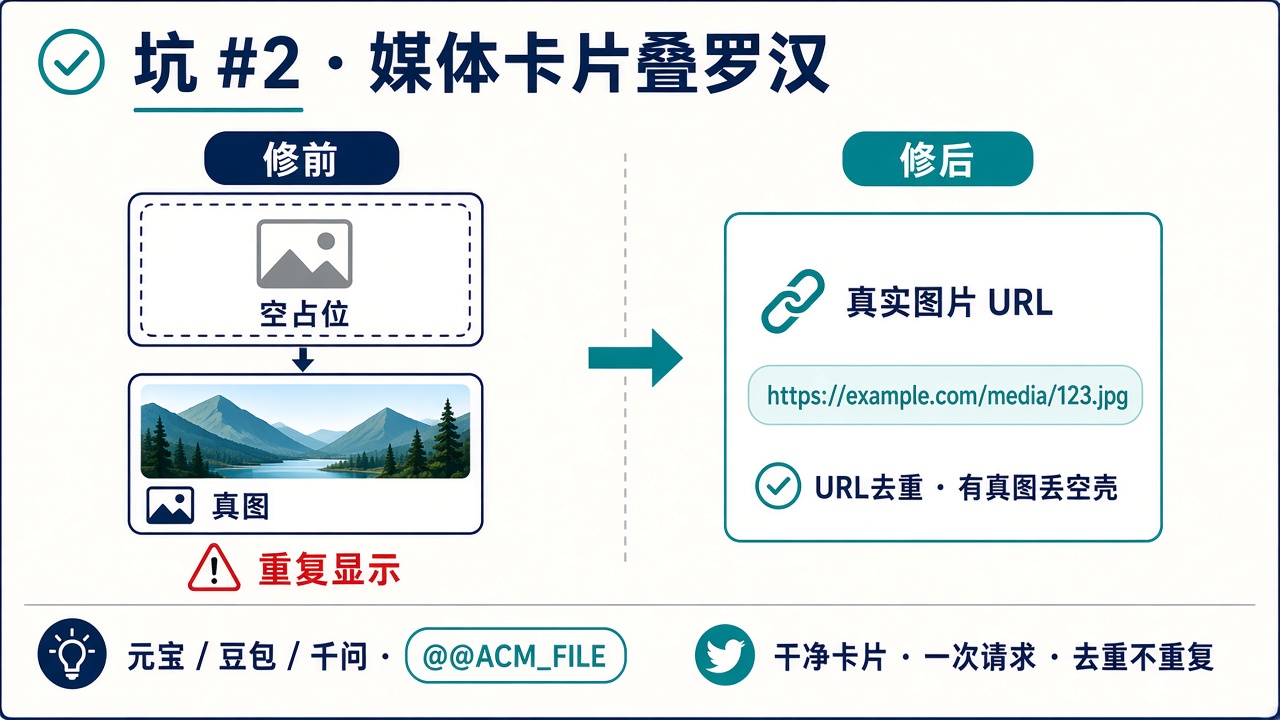
坑 #2|媒体卡片叠罗汉
现象
元宝 / 豆包 / 千问都出现过:
· 生成图根本没卡片
· 或者空占位卡片和真实图片叠在一起
· 推荐类图片还曾被存成一堆文字
为什么难
各站媒体形态不统一:进度文案(如 0%)、占位 URL、真实 CDN、文件卡片混在一起。
DOM 里「看起来像图」的节点更不可靠;
只「有 media 就塞一张卡」,必然重复或假卡。
怎么拆开的
1)尽量从 API/状态里拿真实资源地址,再渲染卡片
2)统一卡片协议(内部 @@ACM_FILE 一类标记)
3)有真实 URL 就丢掉空占位;按唯一 URL 去重
4)推荐墙图片:产品决策改为不展示,避免污染正文
教训
媒体是一等公民。去重写进抽取层,
别在易碎 DOM 上碰运气。
————————
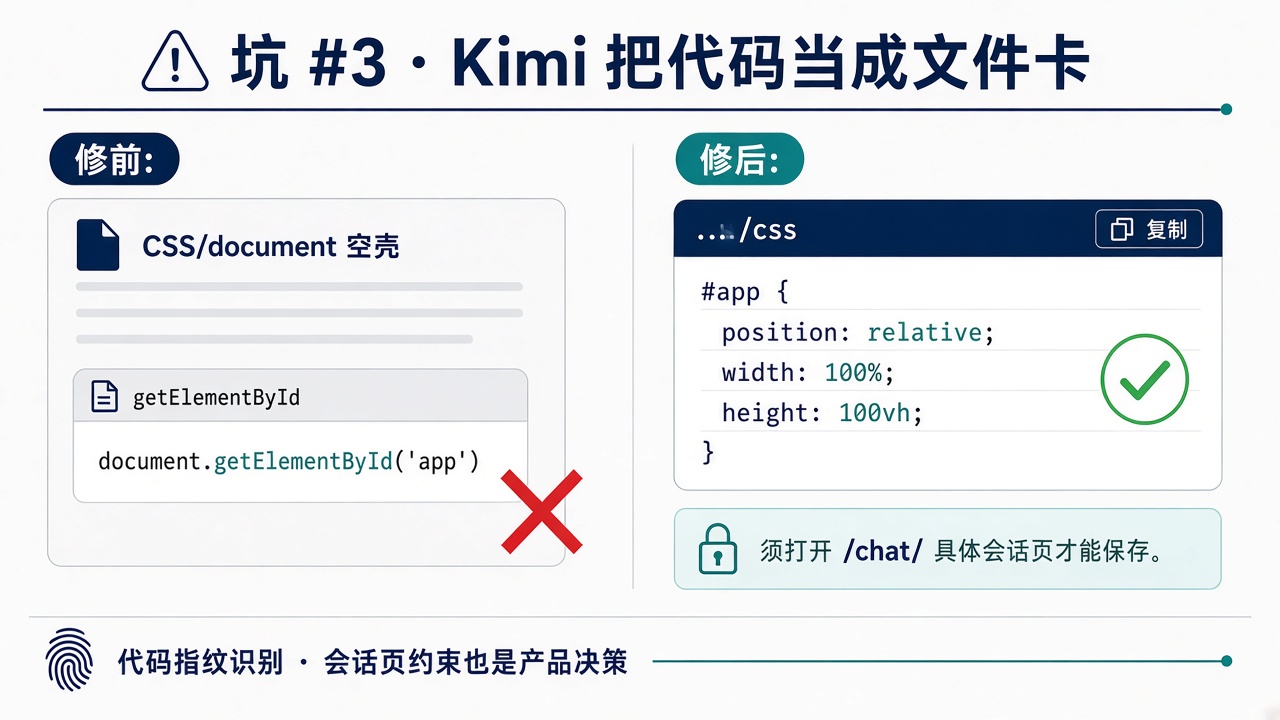
坑 #3|Kimi:代码变文件卡 + 会话页约束
现象
· 计算器等代码被存成空的「CSS / 文档」卡片
· 图片搜索标记没转成卡,有时还挂到用户气泡上
· 不进具体对话页就存不住
为什么难
Kimi 的代码/文档/图片在结构上容易糊在一起;
纯 DOM 更容易把 `getElementById` 误判成「文档/CSS 附件」。
会话 ID 只在 /chat/… 具体页稳定——这是平台事实。
怎么拆开的
1)能走接口/结构化数据的优先走;DOM 代码块只做回填
2)代码指纹:编程代码走代码块,不走文件卡
3)图片标记解析成卡片,并绑到正确角色
4)产品决策:必须打开具体对话再保存(明确提示,不硬猜首页)
教训
「不改」有时也是正确解法——
把约束说清楚,比静默存脏数据更负责任。
————————
三个坑的共通解法
1. DOM 不稳定 → 主通道改 API / 页面状态,DOM 只补缺
2. 按轮次,不按「全局最长」
3. 展示清洗 ≠ 存储砍内容
4. 媒体卡片化 + URL 去重
5. 写不清的边界,就写成产品提示,不要装智能
开源:github.com
你做多站点抓取时,是继续加选择器,还是切 API ?
0 00
Build in public · 过程决策、踩坑与解法
上周「AI对话管理器」到了 v0.1.0,回归 90/90。
有人问:中间到底怎么拍板的?踩了哪些坑?
一、过程里定死的 4 个决策
1)产品主轴 = 对话管理,不是又一个聊天框
做保存 / 整理 / 搜索 / 导出;不抢模型本身的对话体验。
2)架构用 Adapter,不写五套平行逻辑
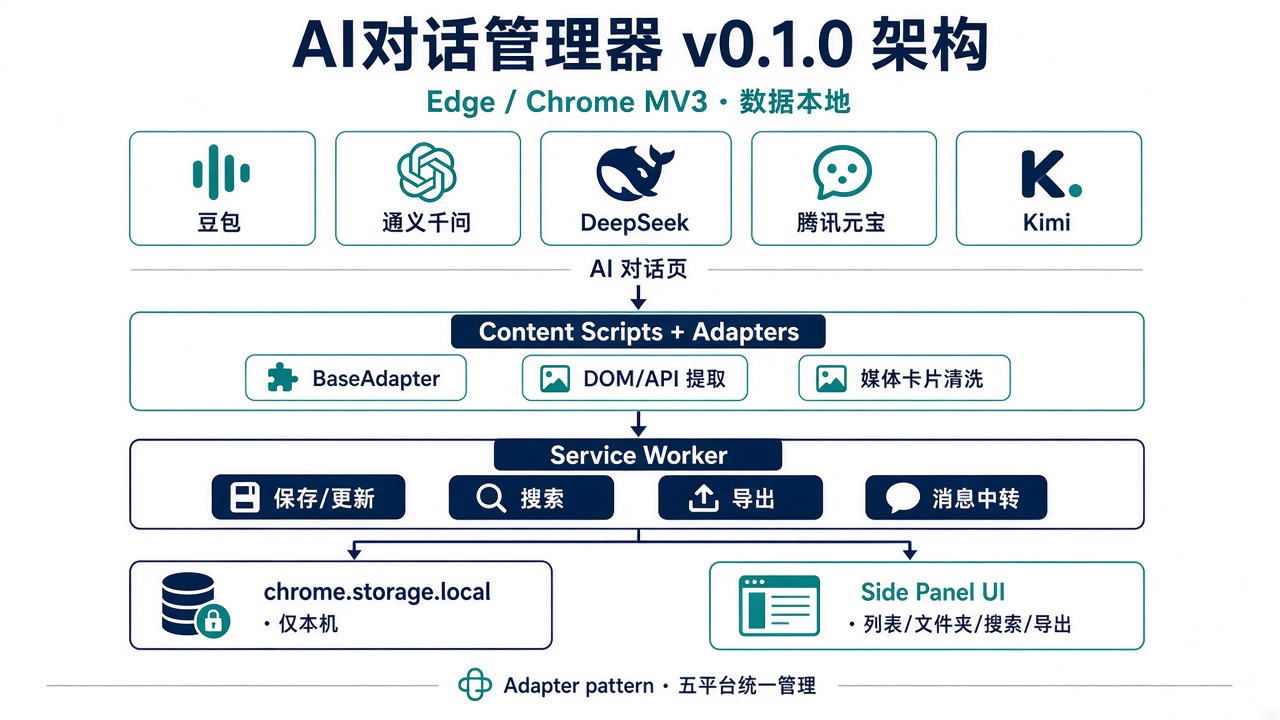
页面 → Content Scripts + Adapters → Service Worker → 本地存储 + Side Panel
平台会变,抽取接口尽量统一。
3)数据默认本地(chrome.storage.local)
隐私优先;云同步留给以后的 Pro,不在 v0.1 里硬上。
4)用 G1 关口约束自己
主路径能存、能看、能搜、能备份,且全量回归无失败,才对外叫 v0.1.0。
没有「感觉差不多」这回事。
二、真实踩过的坑(按平台)
· 通义千问:角色错位、正文被推荐/检索墙顶替、表格加粗丢失、图/Word 卡丢了
· 腾讯元宝:图片没卡片;有了又和真实图叠两层;引用标记要清洗
· 豆包:多轮末条延迟、文件/图片不成卡片
· Kimi:图片标记没转成卡;代码块被误判成「文件/CSS」;必须进具体 /chat/ 页才能存
· 通用:新对话串出「未命名」脏数据;搜索「豆包+AI趋势」组合查不准;重载扩展后 AI 页要提示刷新
三、怎么解的(可复用的打法)
1)双通道抽取:API / 页面状态优先,DOM 补缺;合并时按轮次配对,绝不「全局取最长一段」把多轮压没。
2)展示层清洗 ≠ 存储层砍内容:思考过程、推荐墙、citation 标记可在展示剥掉;正文与媒体要完整可导出。
3)媒体一律卡片化 + URL 去重:有真实图就丢掉空占位,避免「假卡片 + 真图」叠罗汉。
4)搜索做成「平台 + 关键词」可组合,命中处出摘要并标黄——窄侧栏里只飘关键词不够用。
5)明确「不改」也是决策:
- Kimi 必须点进具体对话再存(页面没有稳定会话 ID)
- 列表批量删除留给后续 Pro 能力,不和本周主轴抢工期
- 跨机迁移 / 超大库压力测先 Block,不假装测过
四、这一周教我的
多平台扩展最难的不是「能不能 hook 到」,而是每个站点都有自己的「汤」:思考壳、推荐墙、进度条、占位图、脏 session。v0.1.0 的意义,是先把主路径打穿,再用回归清单把自己锁住。
下一篇会写:最痛的 3 个坑(细拆复盘)。
开源:github.com
有在做浏览器扩展 / 多站点适配的,欢迎对一对你的坑。
0 00
Build in public · 第一周
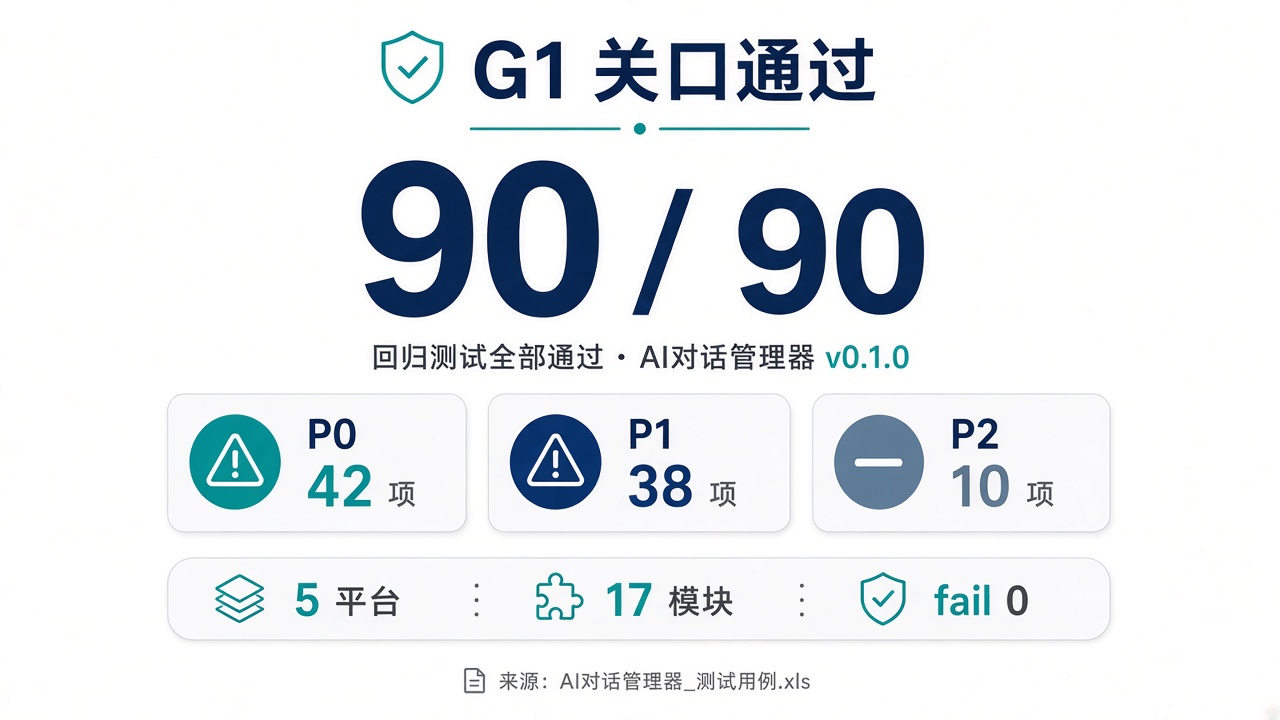
从 0 写出「AI对话管理器」v0.1.0,回归测试 90 项全过。
一、为什么做
每天在豆包 / 千问 / DeepSeek / 元宝 / Kimi 来回聊,
对话却散落在 5 个站点里——搜不到、难复用、一刷新就丢上下文。
我想做的不是又一个聊天机器人,
而是把「聊完的东西」变成可管理的资产:
保存 · 整理 · 搜索 · 导出 · 数据留在本地。
二、怎么做的(架构)
5 个 AI 页
→ Content Scripts + Adapters(统一抽取 / 清洗)
→ Service Worker(保存 / 搜索 / 导出)
→ 本地存储 + Side Panel
核心是 Adapter 模式:平台可以变,主轴始终是「对话管理」。
开源在这(Edge/Chrome 开发者模式可装):
github.com
三、第一周进度盘点
✅ 五平台保存链路跑通
✅ 文件夹 / 收藏 / 搜索 / JSON 备份
✅ 媒体卡片、格式、角色不错乱(硬仗)
✅ 版本钉死:v0.1.0
这周目标不是堆功能,是把「能用」打磨到「敢给别人装」。
四、G1 关口:通过
回归清单 90 / 90 · fail 0
P0 42 · P1 38 · P2 10
覆盖 5 平台 × 17 模块
主路径能存、能看、能搜、能备份,且全量回归无失败。
有在用国内 AI 的朋友,欢迎拍砖。
0 00
先问一个问题:
你现在手机和电脑上,装了几个AI?
豆包、DeepSeek、Kimi、通义千问、腾讯元宝……再加上ChatGPT、Claude、Gemini,保守估计,大部分人至少在用3个以上。
然后再问一个更扎心的:
上个月你跟AI聊过的那些对话,现在还能找到吗?
我先说说我的混乱
我算是AI重度用户了,每天在各个AI平台之间来回切换:
· 写技术方案,用这个AI聊了半小时,出来一版不错的思路
· 第二天想翻出来看看,打开对话列表,刷了两分钟——找不到了
· 换个平台问同样的问题,之前的上下文全没了,得从头解释
· 有时候AI给了一个特别好的回答,当时觉得"这个先收藏",结果三天后连在哪个平台问的都忘了
· 更别说跟不同AI聊的方案版本,想对比一下都做不到
对话列表越来越长,有用的信息越来越难找。
我试过的办法:
❌ 截图——截了几十张,相册里根本翻不到
❌ 复制到备忘录——坚持了两天就放弃了,太麻烦
❌ 让AI重新说一遍——上下文没了,回答质量完全不一样
❌ 用文件夹/标签整理——大部分平台压根没这功能
我不知道你们是不是也这样。
所以想问问大家,你们现在是怎么管理AI对话的?
比如:
· 你日常用几个AI平台?主要用哪些?
· 觉得好用的对话,你会怎么保存?
· 有没有遇到过"之前聊过一个特别好的回答,但怎么都找不到了"的情况?
· 你最希望AI平台在对话管理上加什么功能?(搜索?文件夹?标签?导出?跨平台同步?)
· 如果你有一套自己的管理方法,求分享,我真的很需要。
评论区聊聊,或者转发给你身边那个天天跟AI聊天的朋友,我想看看有多少人跟我一样在这个问题上挣扎。
0 00