即刻App年轻人的同好社区
下载
 置顶
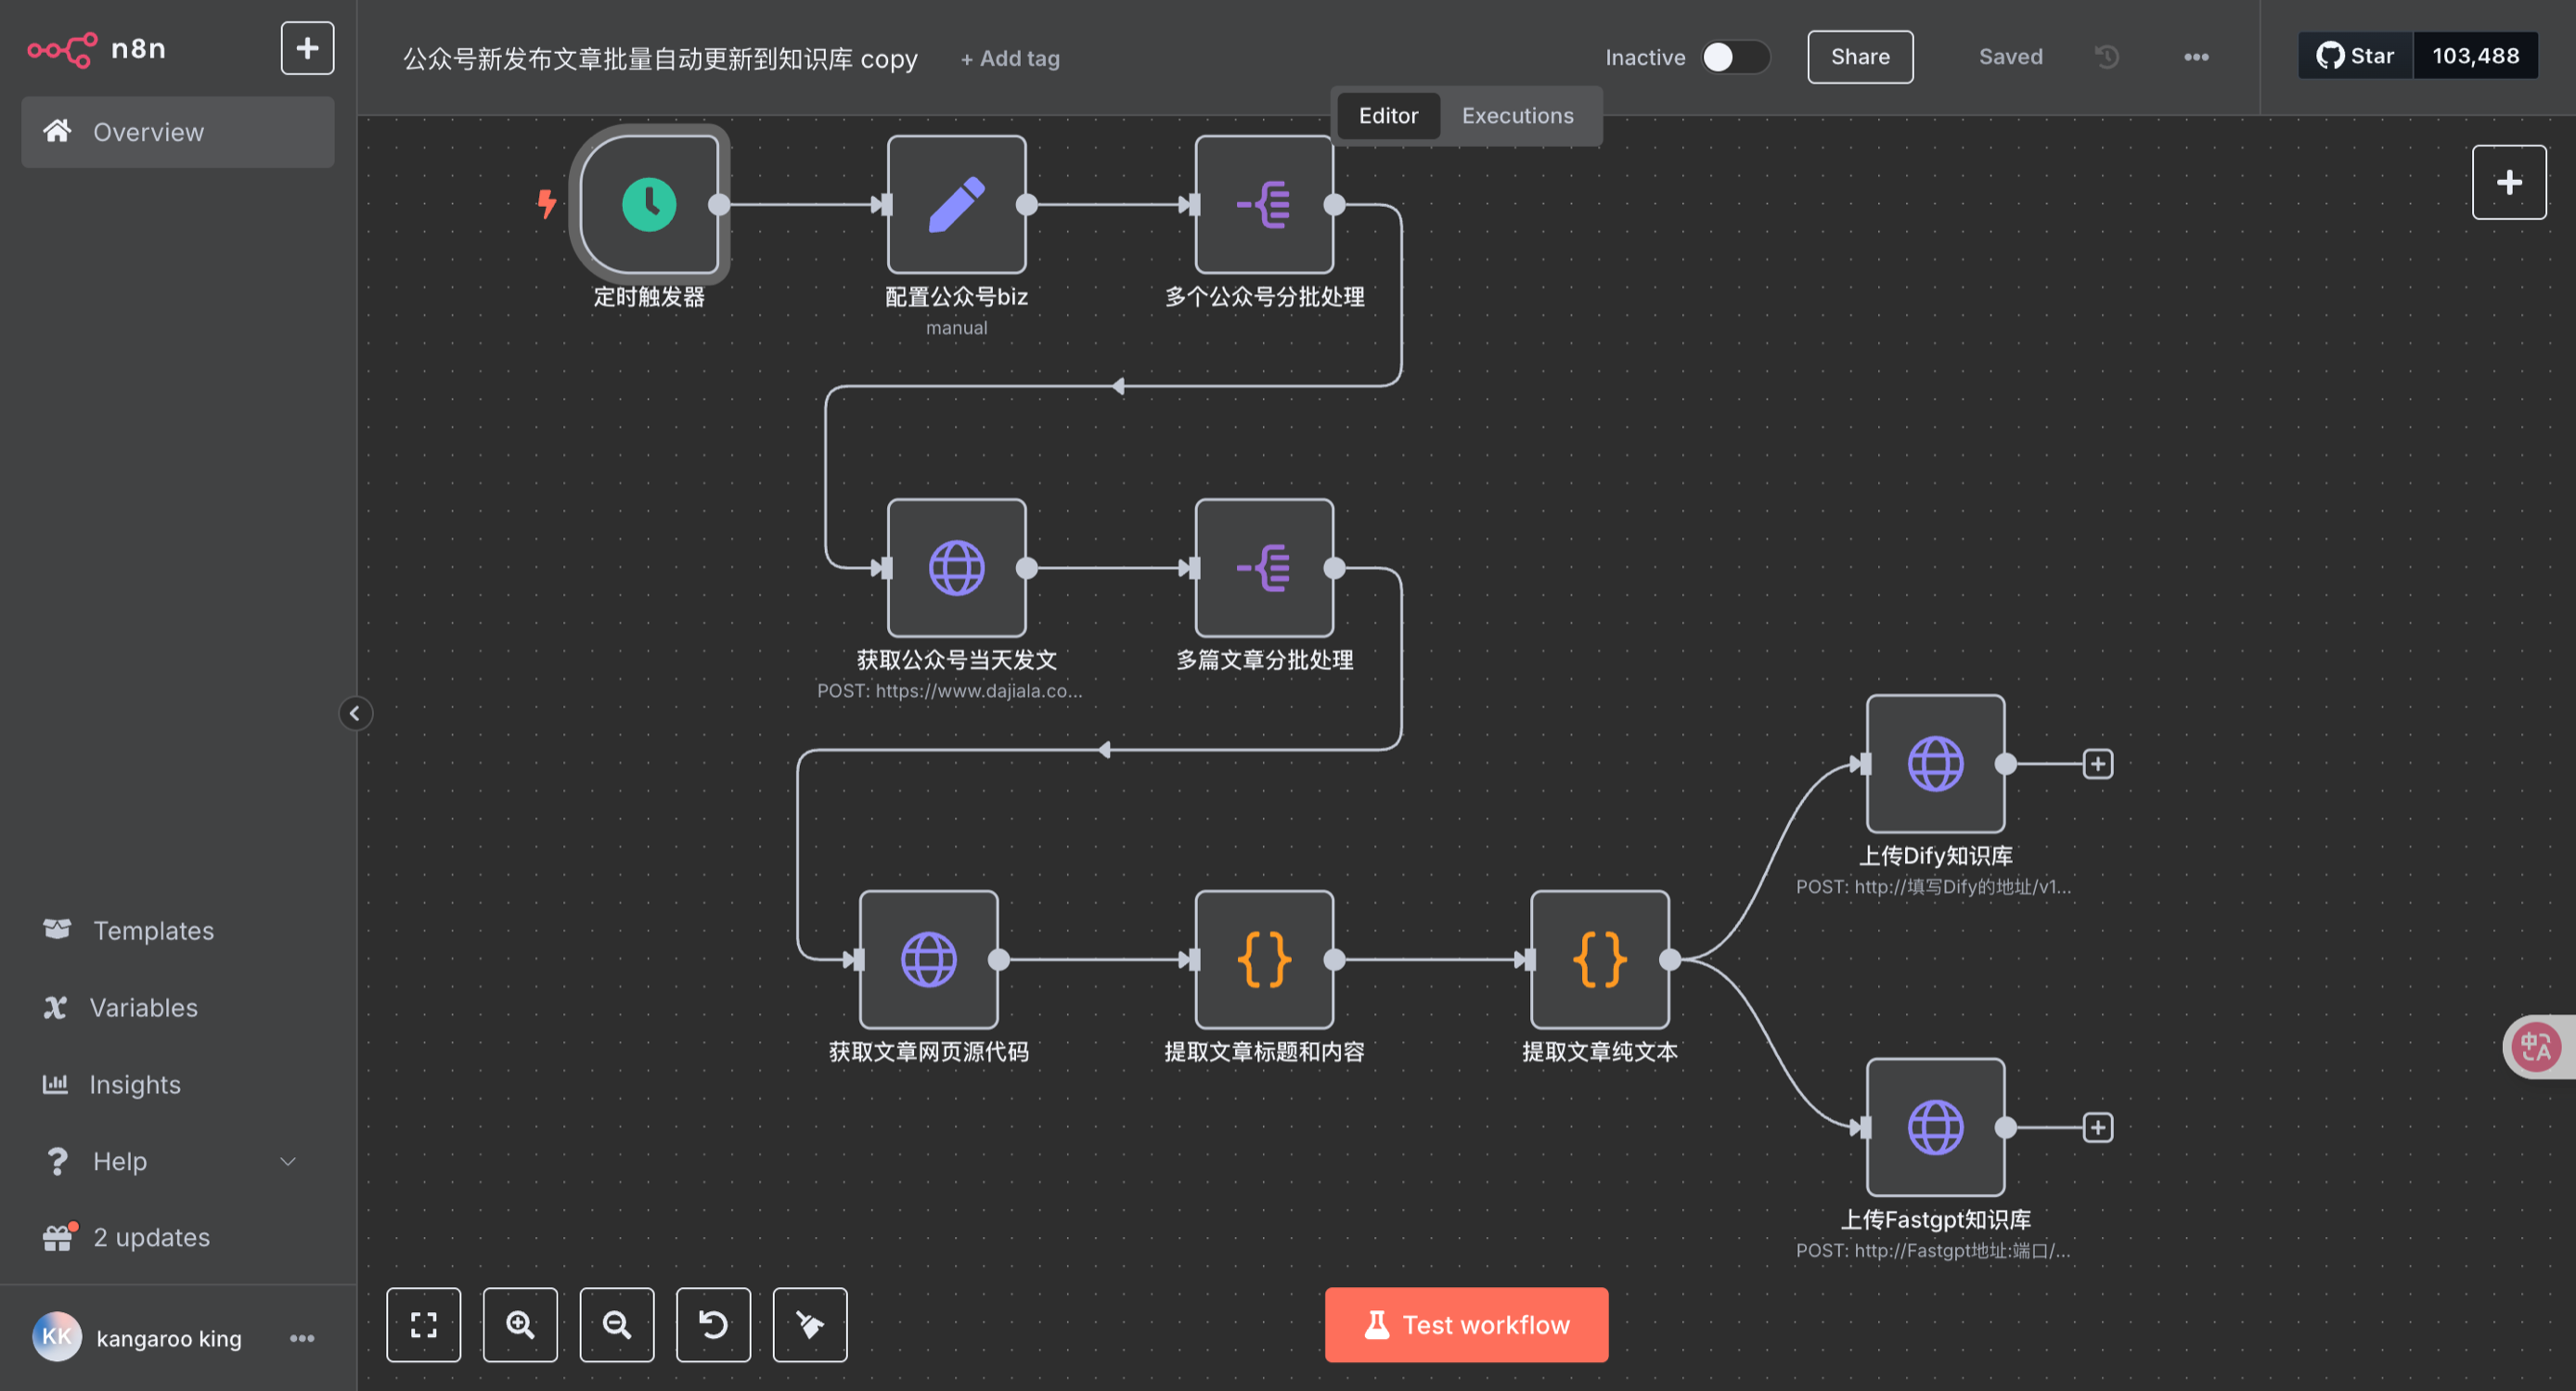
还在为手动搬运公众号文章到知识库而头秃?
告别 ctrl+c/v 的石器时代吧!
我用n8n 做了一套【全自动】工作流,能把多个公众号(对,N个都行!)的历史文章+每日最新内容,全自动同步到你的 私有知识库~
喂饭级教程+工作流文件都给你打包好了(在评论区),只想换你一个三连!
告别 ctrl+c/v 的石器时代吧!
我用n8n 做了一套【全自动】工作流,能把多个公众号(对,N个都行!)的历史文章+每日最新内容,全自动同步到你的 私有知识库~
喂饭级教程+工作流文件都给你打包好了(在评论区),只想换你一个三连!
77 1041
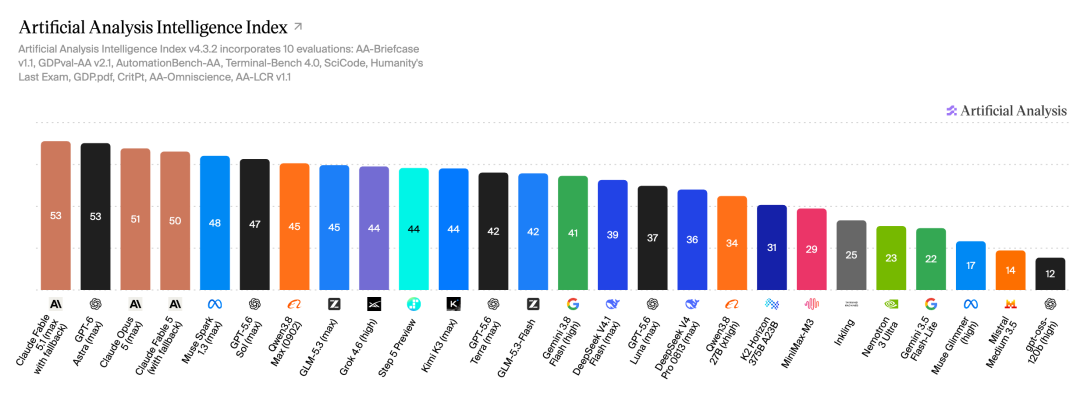
这次内测了阶跃的新旗舰模型 Step 5 Preview。
版本号直接从 3.7 跳到 5,我一开始也半信半疑:到底是名字跳了,还是能力真跳了?
我拿它连续做了 5 个挺折腾的项目:
1. 用 three.js 做了一个昆明 3D 城市网页
2. 把我的截图工具 Ta 往 Windows 版迁移
3. 做了一款手机端 MD/HTML 阅读器
4. 复刻了一个广告小游戏
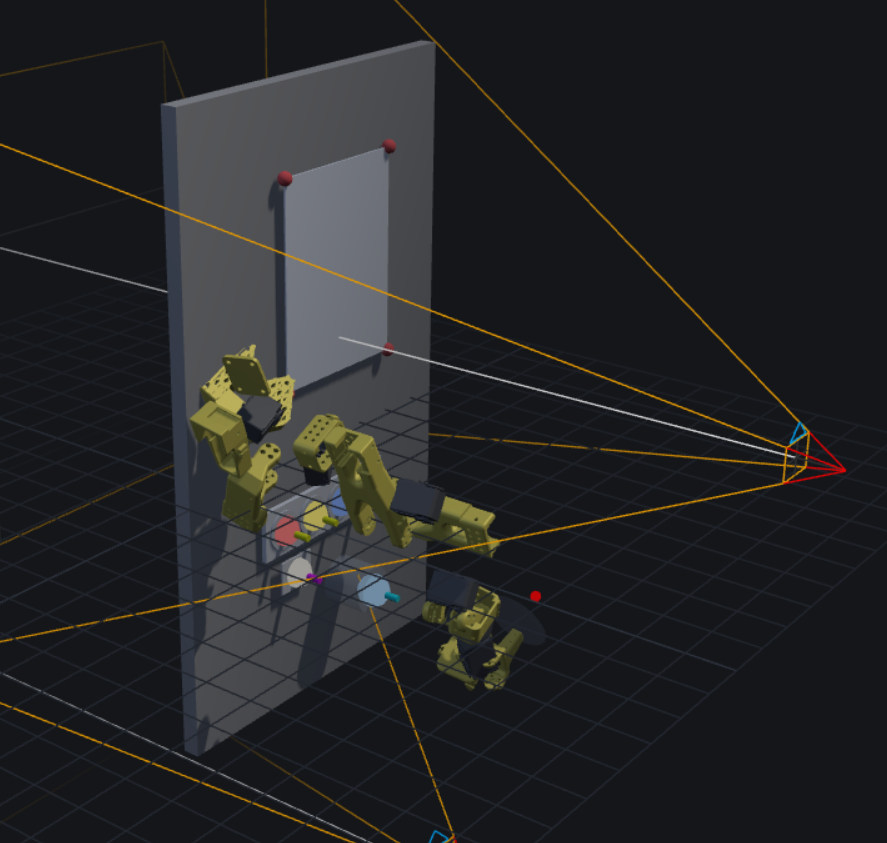
5. 做了个虚拟机械臂,还接 AI 画画
最让我意外的不是某个 demo 多惊艳,而是它真的能长时间干活。
城市 3D 网站那个项目跑了快三个小时,中间没断,也没有明显跑偏。它会按 PRD 一步一步来,该查资料查资料,该对照文档对照文档。
这种感觉挺不一样的。
以前很多模型像是「聪明但坐不住」,一开始思路很好,做着做着就开始自由发挥。Step 5 Preview 更像一个能熬长任务的工程同事,速度不一定最快,但能一直往前推进。
当然,也不是每个 case 都完美。
比如机械臂建模就比较一般,但 AI 控制机械臂画出月亮这件事确实跑通了,而且它为这个项目做了 158 项测试。
这个数字我看到的时候也愣了一下。
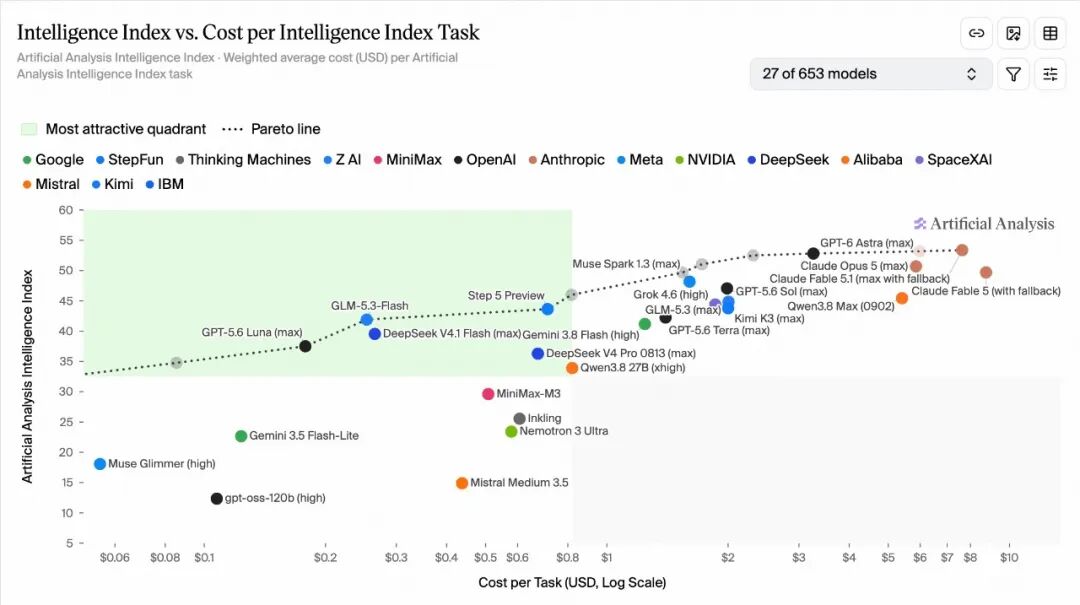
价格也挺关键。国内 API 价格是输入 7 元 / 百万 tokens,输出 20 元 / 百万 tokens,缓存命中输入只要 0.35 元 / 百万 tokens。
如果这种长任务以后都能用比较低的成本跑起来,意义会很大。
我现在越来越觉得,Agent 的变化不是「回答更快了」,而是「能接的活变长了」。
从几分钟的小任务,到一两个小时甚至更久的工程任务,这个跨度才是真正改变工作方式的地方。
以前我说过:用钱买时间很划算。
现在我想补一句:用钱买交付结果,可能更划算。
尤其是这种不怕慢、能上夜班的模型。
晚上扔个任务,睡一觉起来收菜,这事儿确实很爽。
1 00
终于能在手机用WorkBuddy丝滑操纵电脑了!WorkBuddy现在也太火了吧。。
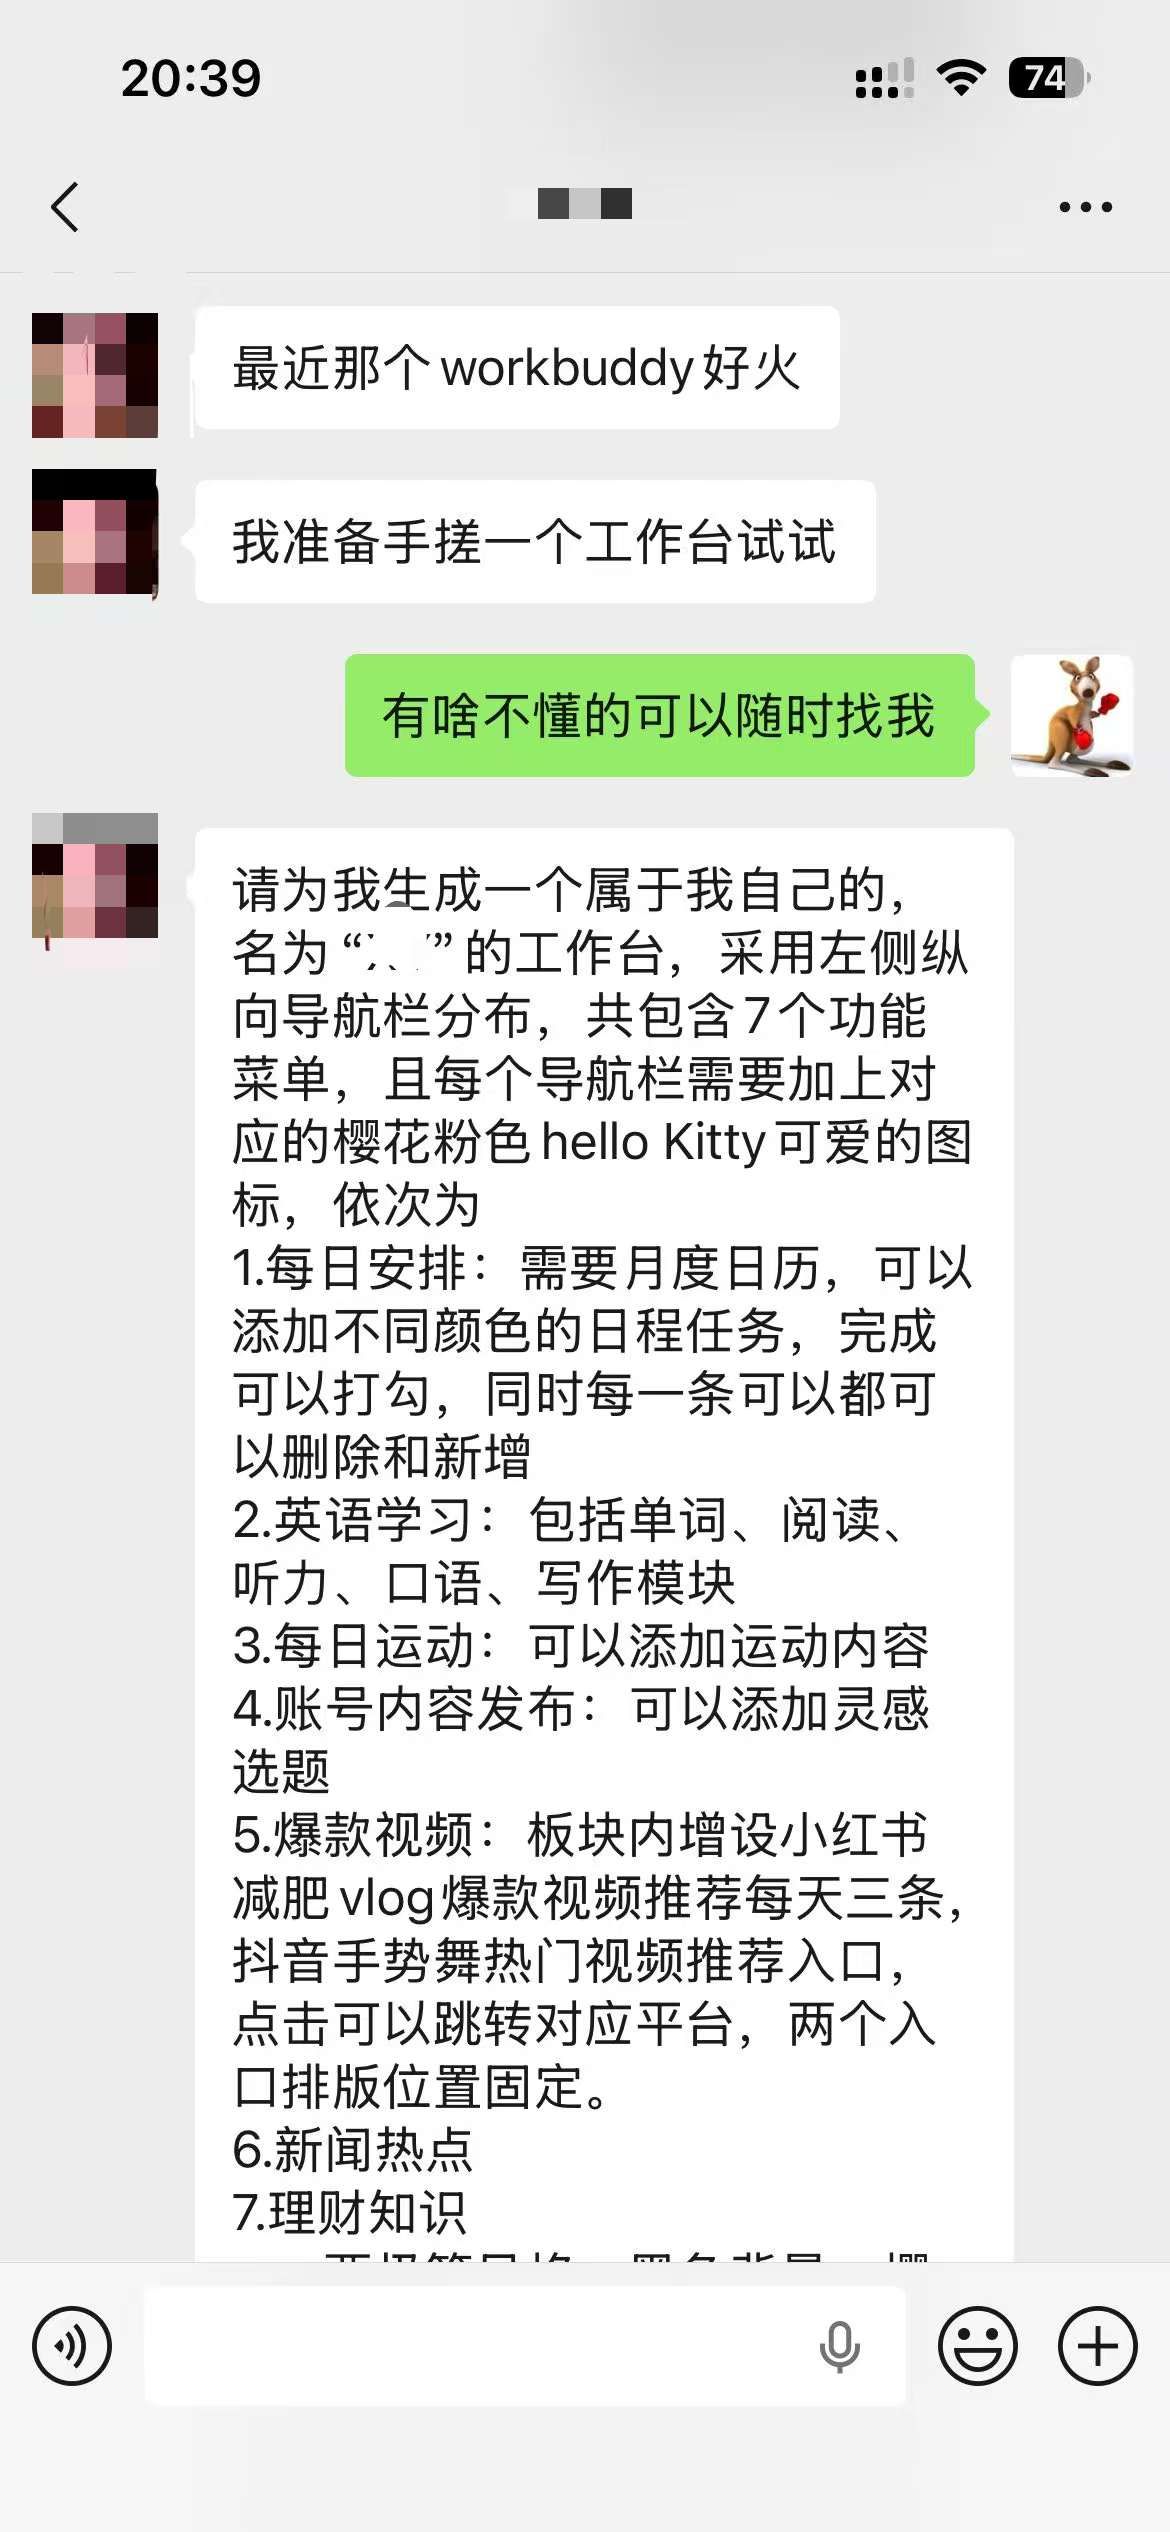
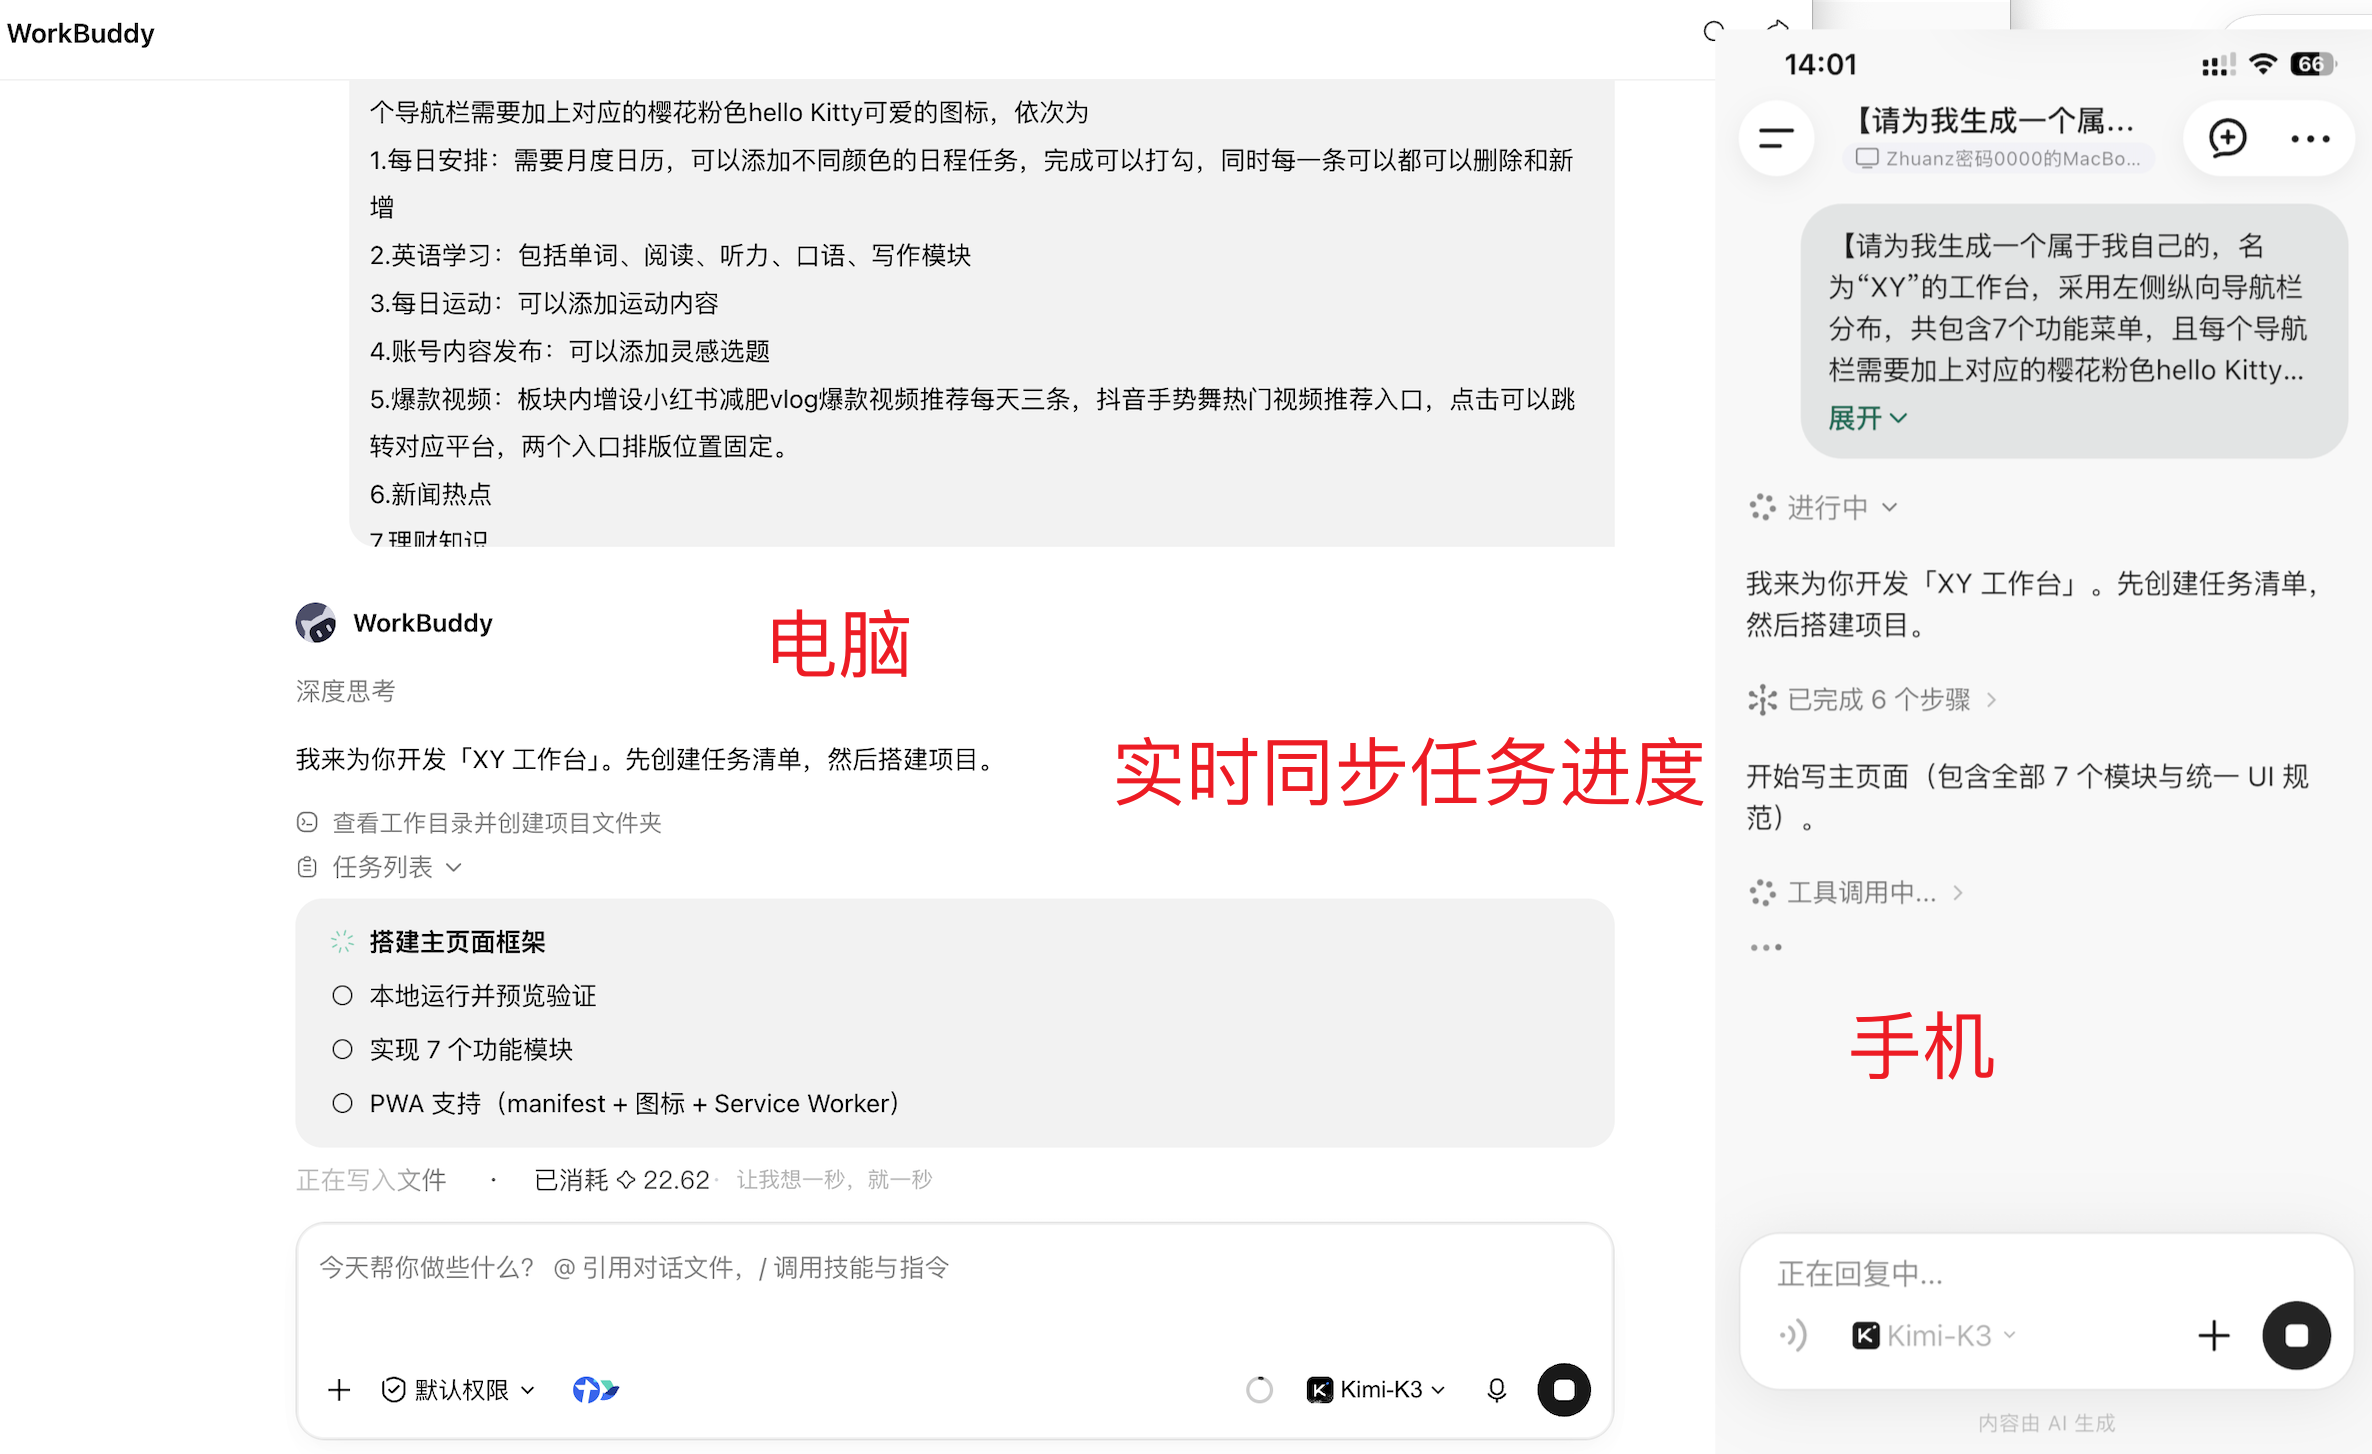
前几天我表妹居然都来跟我说WorkBuddy好火,想要用它来搓一个工作台试试(图2)。
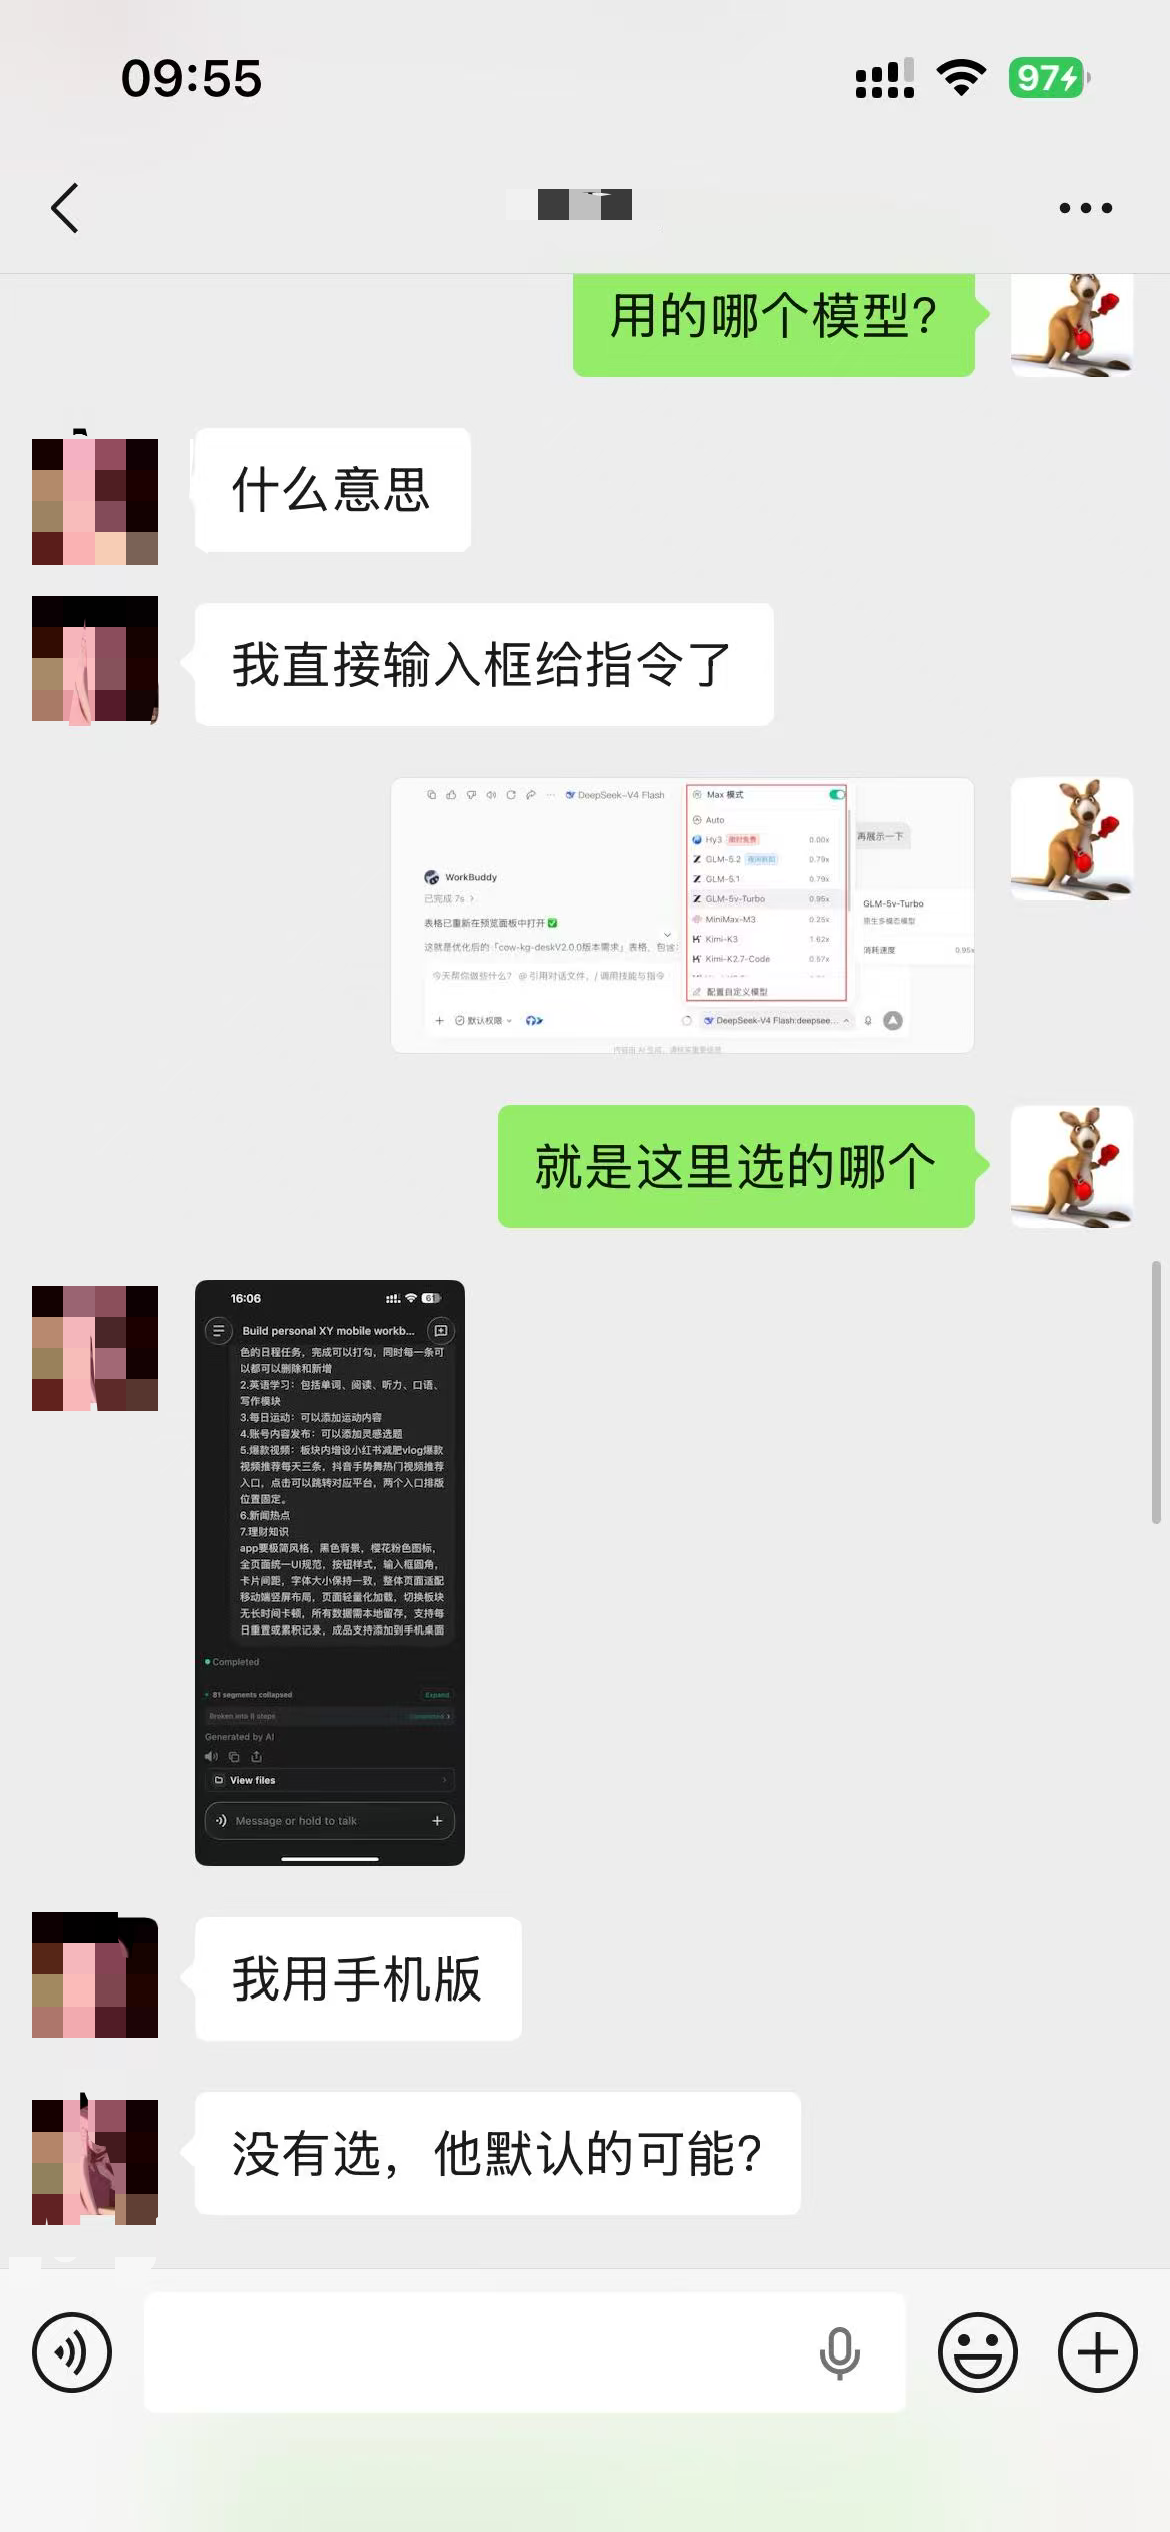
因为我通常都是用电脑来做开发,所以惯性思维就以为她也是用的电脑。
结果她居然用的是手机,这是我完全没有想到的(图3)。
也没毛病,都是用WorkBuddy,只是每个人使用的方式不一样。
目前WorkBuddy有PC端、App、小程序三端。
我之前只是在手机安装了App,但没怎么用过。为了给表妹解答一些疑惑,我更新了WorkBuddy App版本:1.2.1
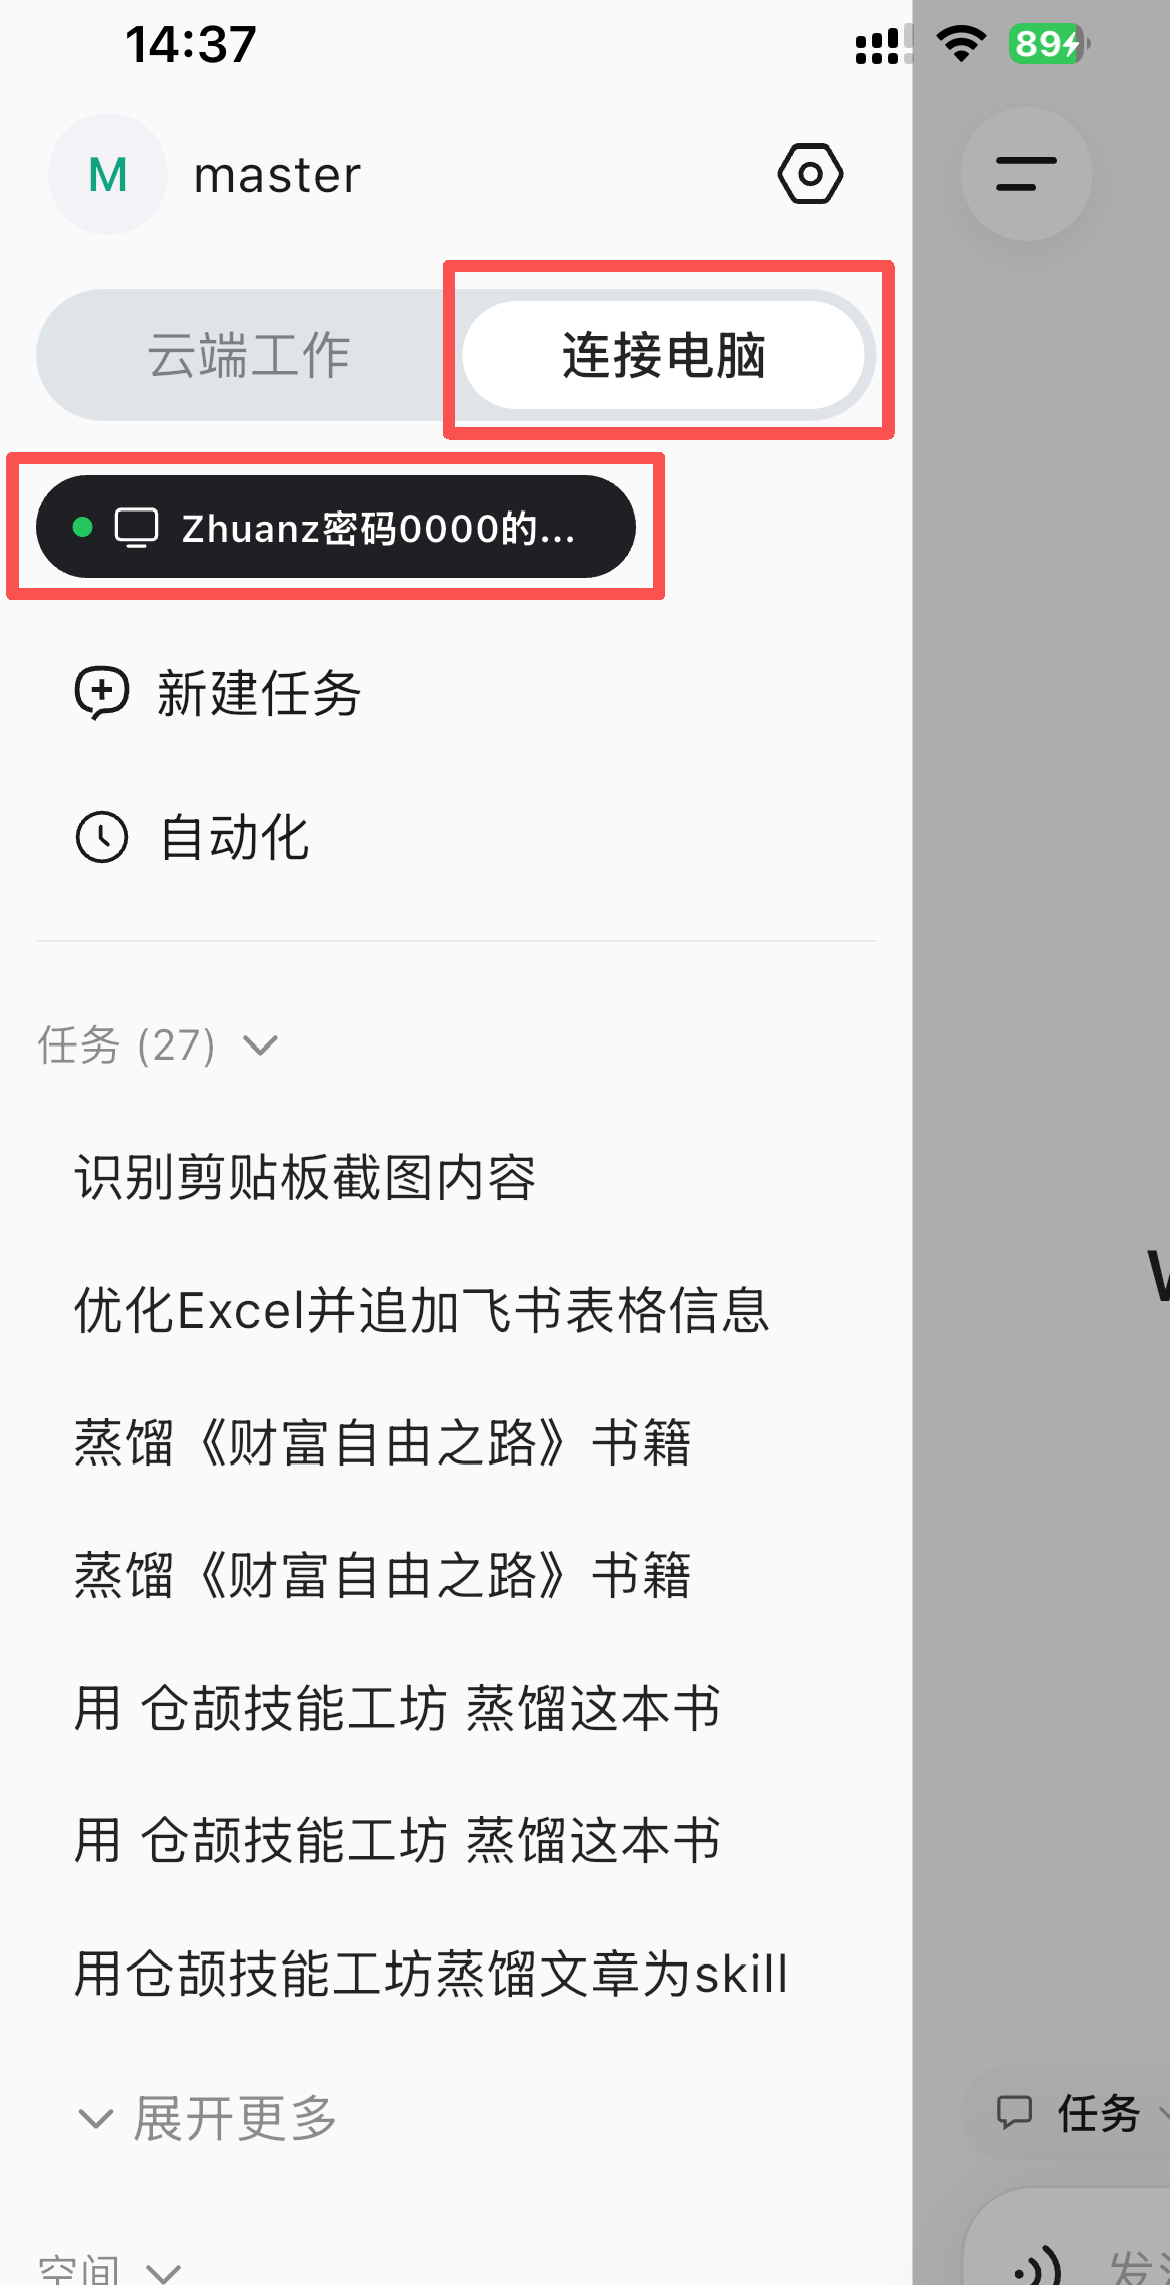
突然发现WorkBuddy App悄悄更新了「多端同步」,登录同一账号居然就能一键远程连接电脑了~(图4)而且还挺丝滑。
在之前,虽然WorkBuddy也可以在手机上做事情,但是手机和电脑端的同步体验并不算丝滑,电脑模式只能同步1个会话,电脑上的其他会话和工作空间都看不到。
现在手机能远程同步控制电脑的WorkBuddy:
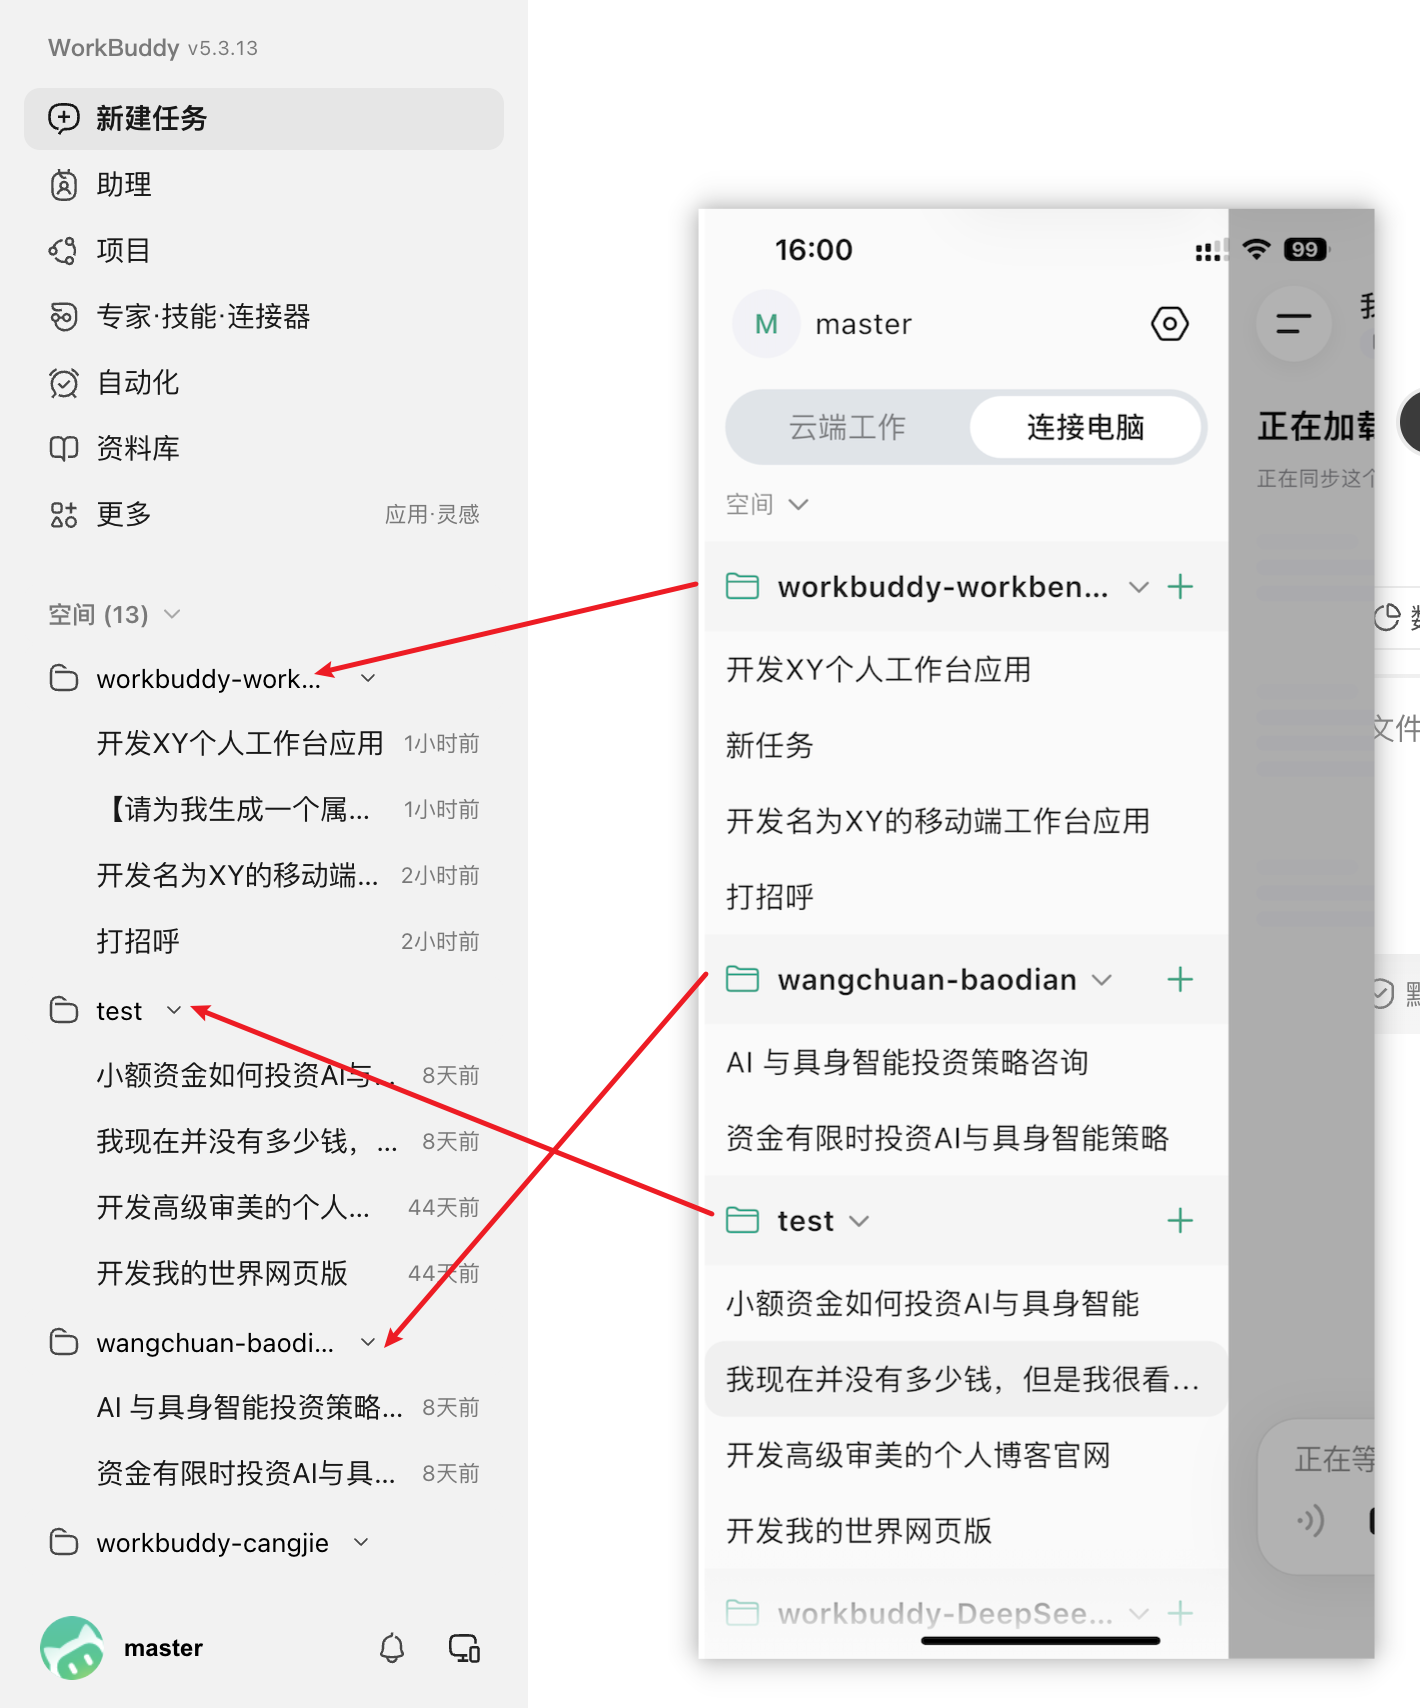
随时查看任务状态,远程续聊或停止任务(图5),工作空间和PC的WorkBuddy一致,双分组实时同步,项目也可以任意切换(图6)。
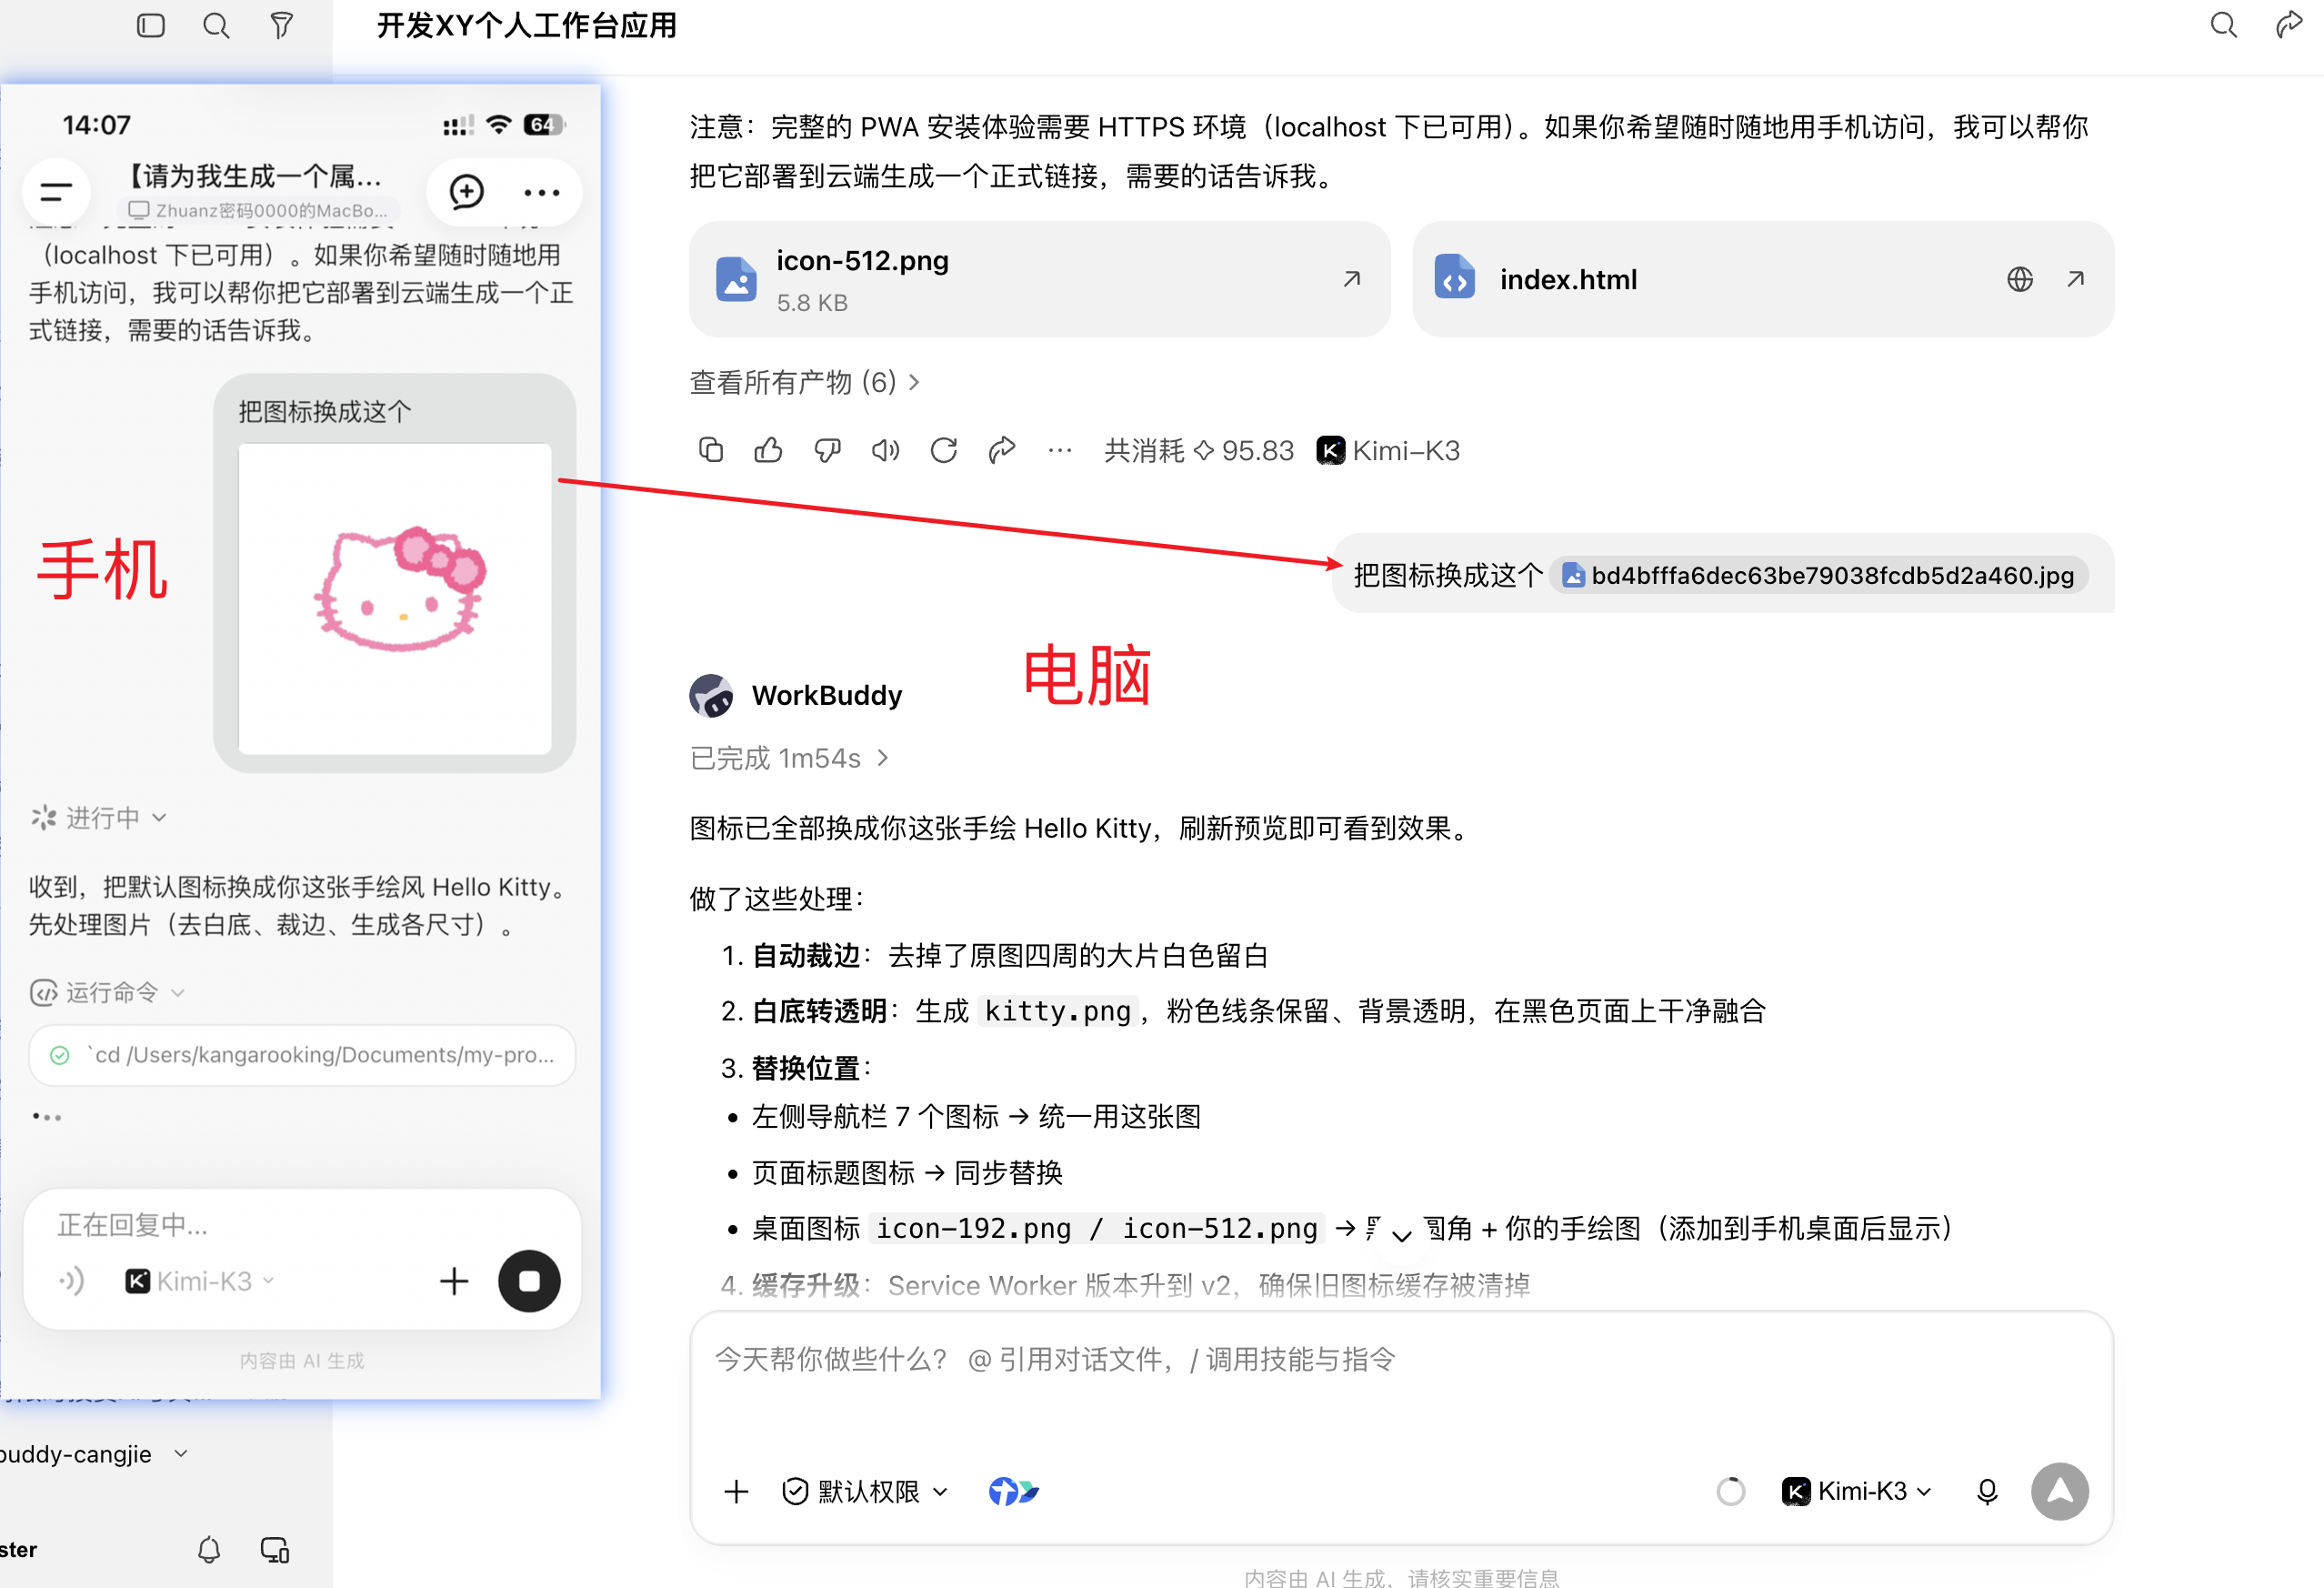
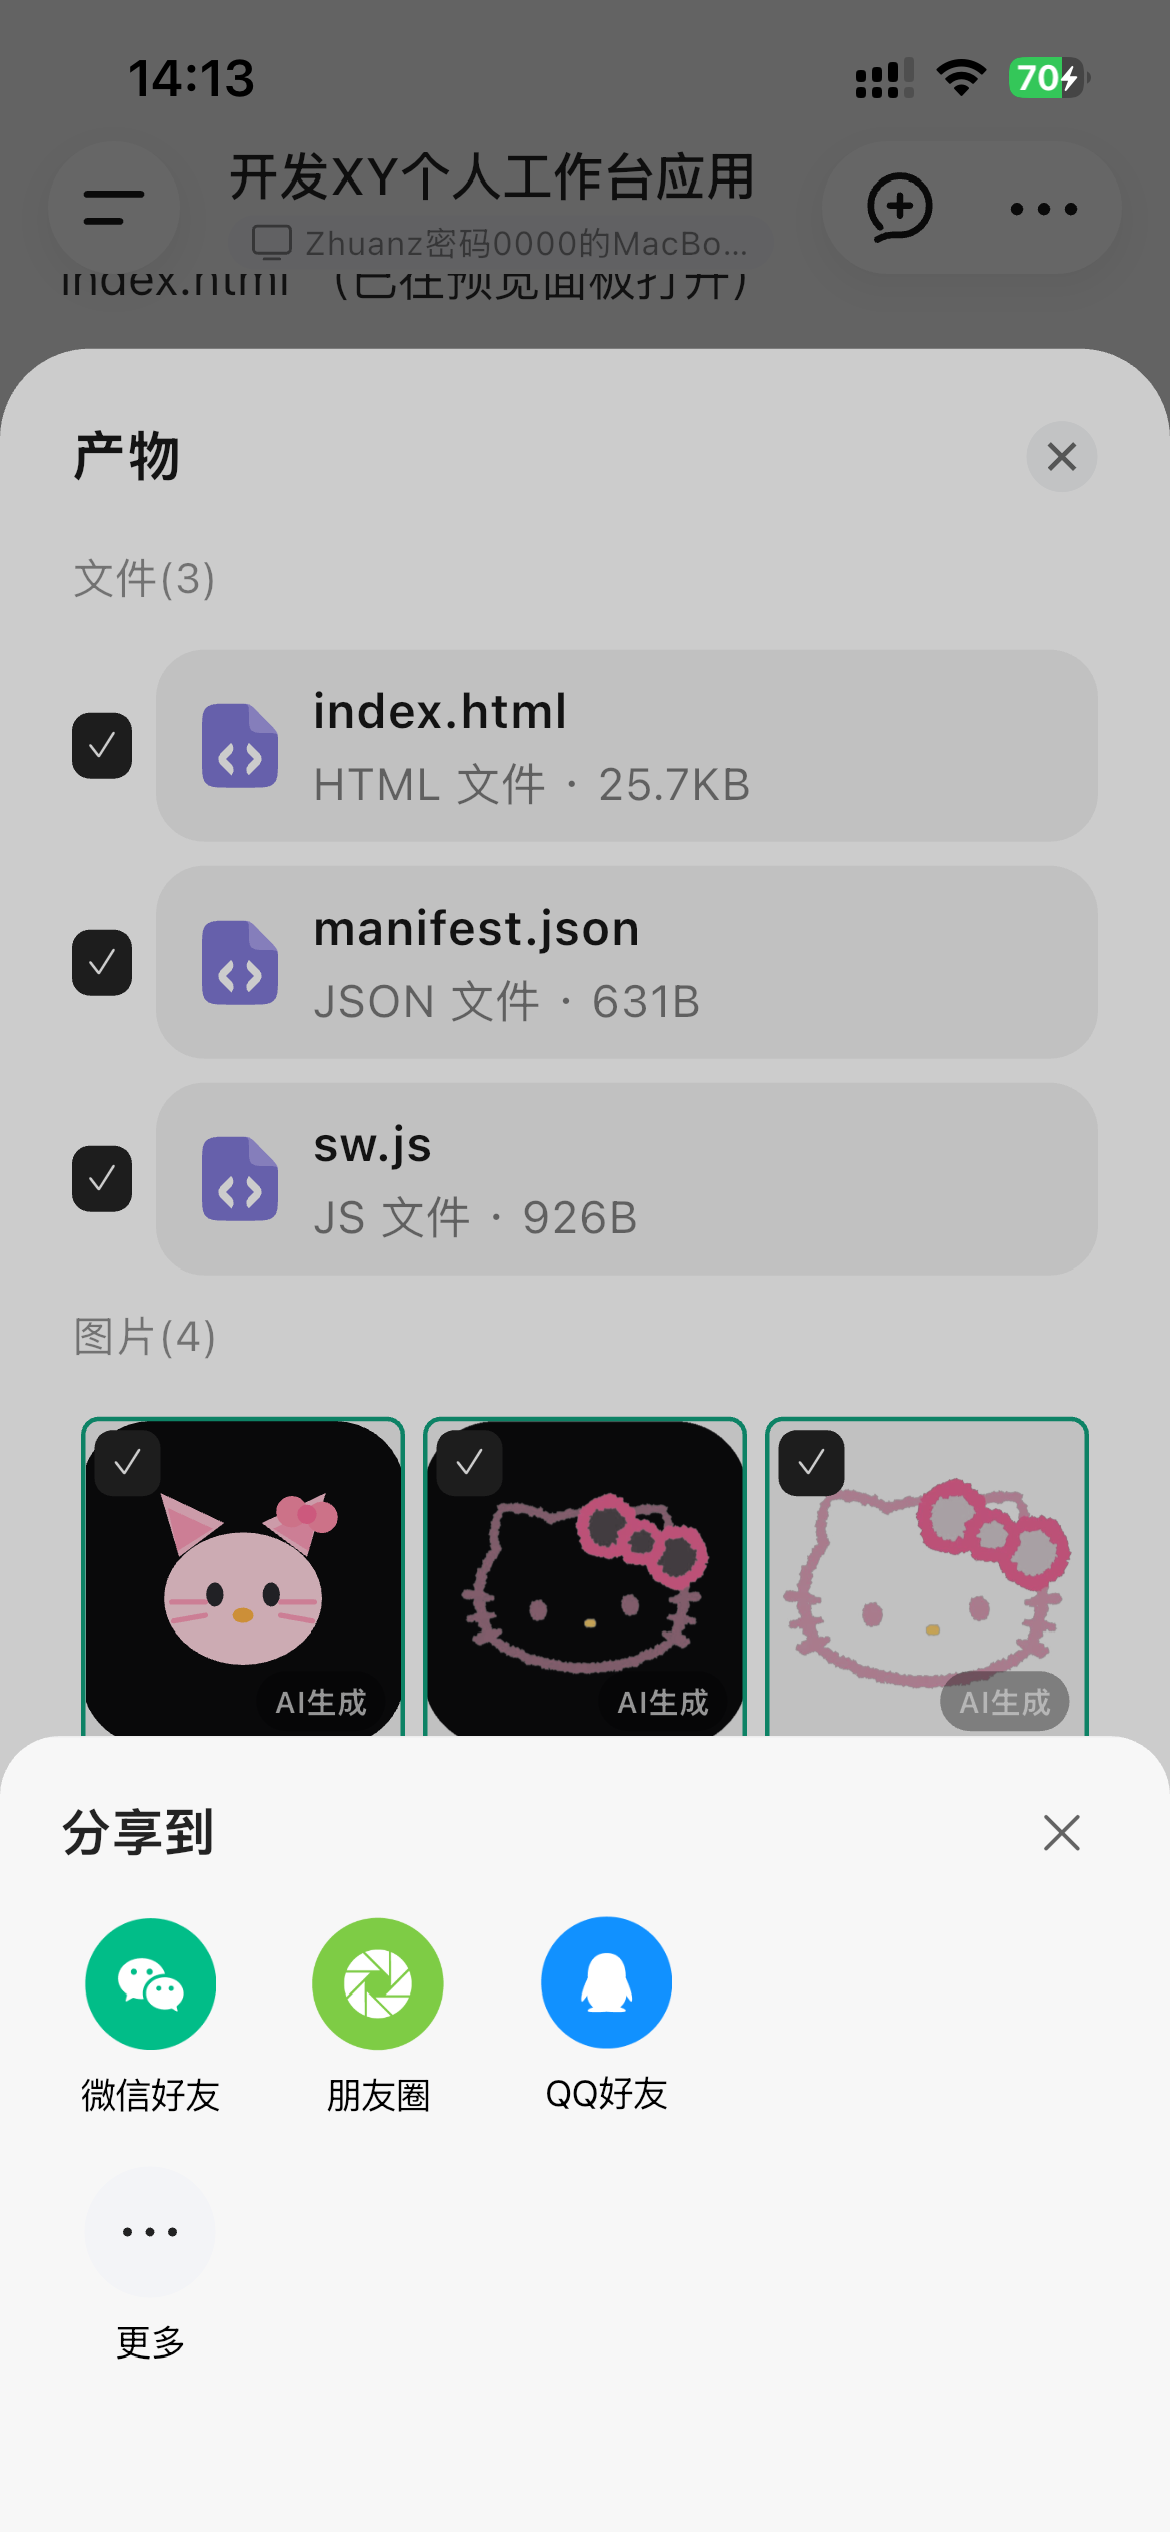
在手机上传文件,电脑端也能识别内容然后处理。比如我表妹要求的,图标换成Hello Kitty(图7)
开发完的产物App上也能看,还能一键分享到微信(图8)。
而且不止可以连接一台电脑,可以连接多台,只要每台都登录同一个账号。
可以说,三端同步之后越发方便了,非常利好经常使用WorkBuddy办公的朋友。
最爽的是,开启「锁屏远程」后电脑不会自动休眠,即便电脑锁屏,WorkBuddy也能持续工作。这点非常Nice啊,工位上的电脑锁屏不怕被同事乱动,靠手机远程同步还可以盯着电脑跑任务,再也不怕离开电脑后任务暂停了。
以后蹲个坑都可以干活了~ 嘿嘿
开个玩笑,其实它最方便的是:
比如晚上已经躺床上了,突然想起明天要汇报。直接手机点开公司电脑的对话,把任务交给电脑端跑,刷会儿手机后"收菜"。
还有就是比如公司电脑跑一个工作项目、家里电脑跑生活项目,一台手机连接两台电脑可以随时切换。生活和工作分离。
我感觉,WorkBuddy就像给我们人人都配了一个小助手,随时随地有事情,打开手机,语音派活,然后它直接在电脑上都给你搞定,结果还能在手机上拿到,巨方便。
如果说,去年是Agent诞生的元年,那么今年就是Agent高速进化的元年。
初步估计今年的Agent,至少给我个人提效了6倍。
大家觉得WorkBuddy这类Agent有提高你的效率吗,预估多少倍呢?
1 01
腾讯这次是认真做企业级Agent了。
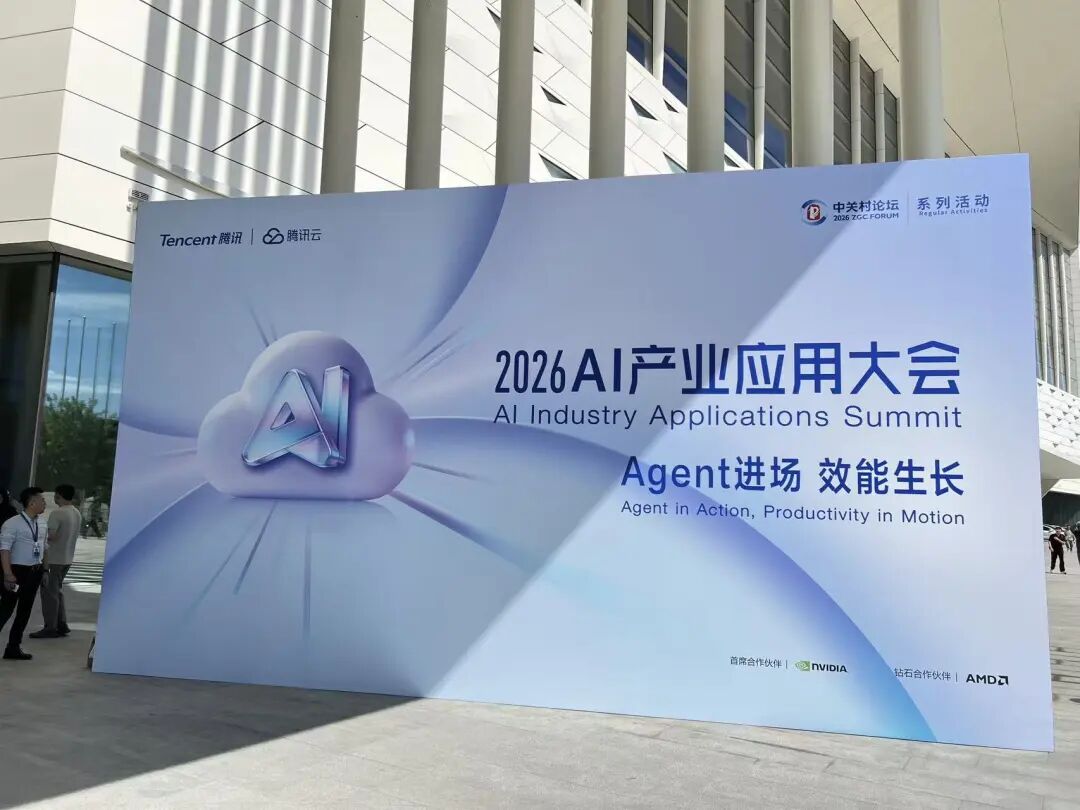
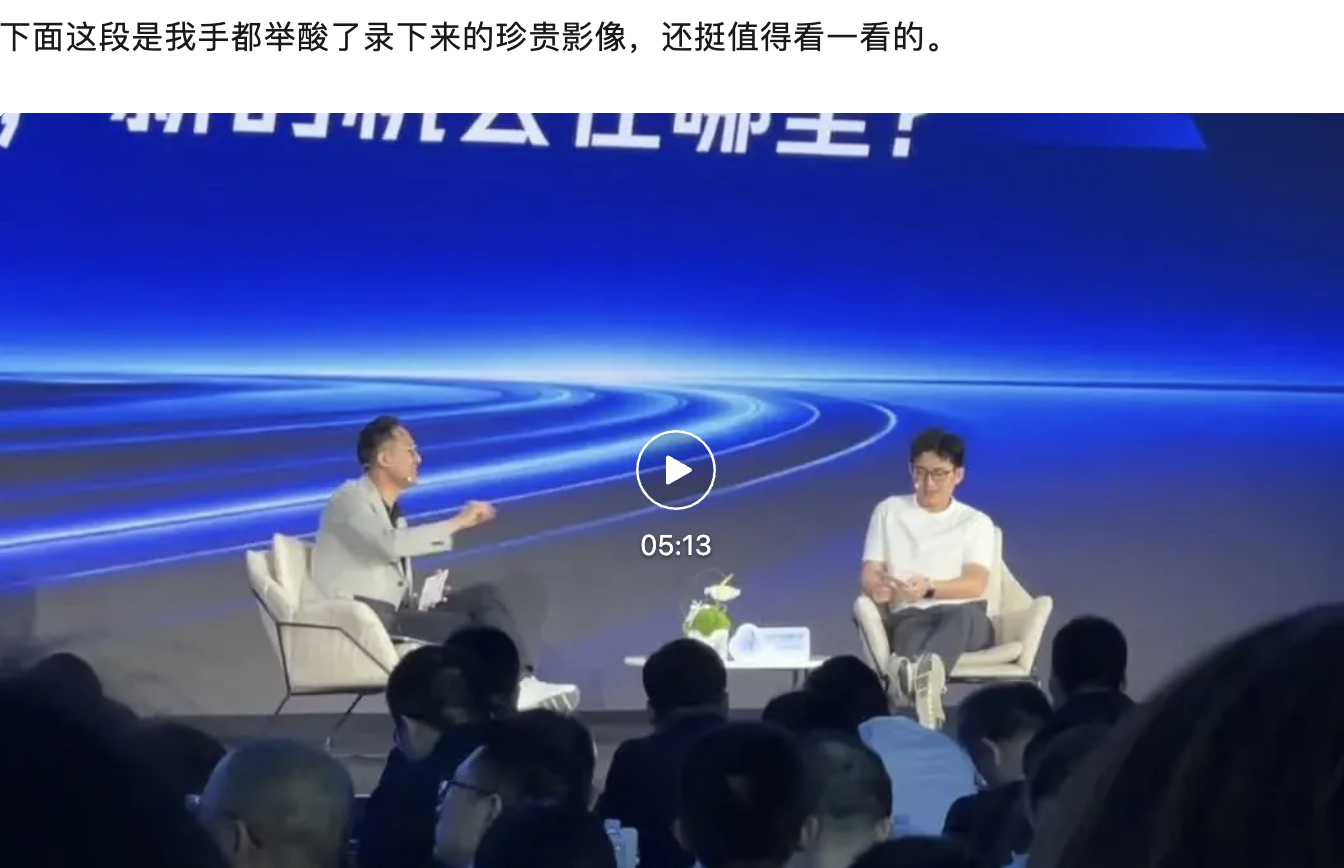
6月去了趟2026腾讯云AI产业应用大会,现场挤到只能站最后一排举手机看汤道生和姚顺雨对谈。
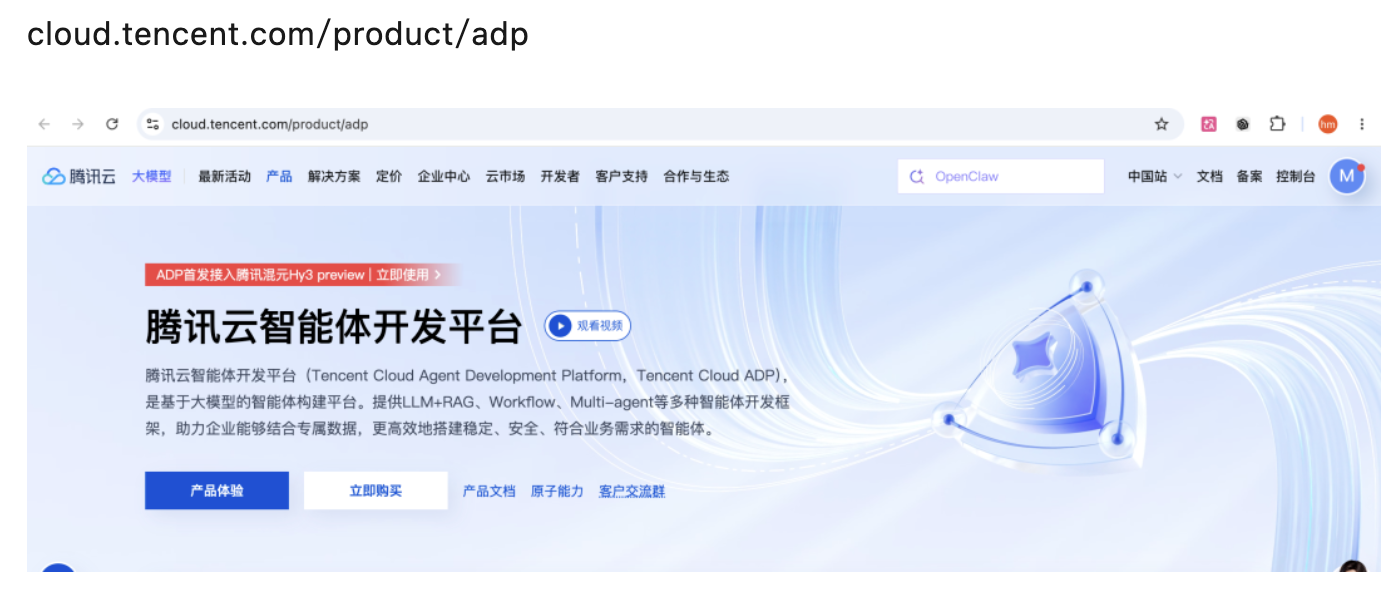
但真正让我停下来的,是展区里的一位"老朋友"——腾讯云智能体开发平台ADP,这次升级到了4.0。
我没测什么花哨场景,就拿公司最真实的痛点开刀:合同审核。
以前的流程是把合同丢给Gemini/GPT要意见,再手动修订原文件,还得保留Word修订痕迹给甲方法务看。一套下来,忙的时候真的很耗时间。
这次在ADP上的体验:
1. 新建Agent,选Claw模式(云端沙箱里自己跑代码、调工具、验证结果,跑错了自己改)
2. 平台Skill很多,但不用自己翻——右侧有个类似Claude Code的聊天窗口,把需求丢过去,自动找Skill、写System Prompt、配好整个Agent
3. 上传合同,它先问我是甲方还是乙方,然后审出一堆风险,比我以前用Gemini细得多
4. 确认后直接生成带修订痕迹的Word,预览里能看到每一处改动
更有意思的是,我又加了个"合同对比审核"Skill,另开对话让它扮演甲方法务,审我改过的合同——甲乙同体,左右互搏,直接闭环。
但真正让我理解"企业级"三个字的,是Agent做完之后的部分:
- 应用评测:批跑测评集,给Agent质量一个量化分数,不用跟领导说"感觉挺好的"
- 发布管理:版本记录、历史回退,发布成API/网页/企微/钉钉机器人
- 运营数据:分渠道调用量、用户统计、对话记录
- 资源管控:按模型限制调用频率和Token量
- 告警:Token用量、QPM、成功率超阈值就通知,支持短信/邮件/企微/钉钉/飞书/Webhook
- 权限:功能权限+数据权限,粒度细到我见过的Agent平台里最细
很多人问企业级Agent和本地办公Agent有什么区别。一个简单的道理:公司不需要每个人都建一个合同审核助手。统一做一个,全员用,可管控、可分发、可运营——这是企业层面中心化的逻辑。
开发时代企业有DevOps,Agent时代的企业,也一定需要一套自己的AgentOps。
价格:专业版188/月,企业版4.8W/年,私有化部署百万/年起。小团队直接用云上版本就够了。
cloud.tencent.com/product/adp
2 00
仓颉Skill网页版来了!一键蒸馏任何书/视频。我也找到了一个Skill变现的新思路,一并分享给大家~
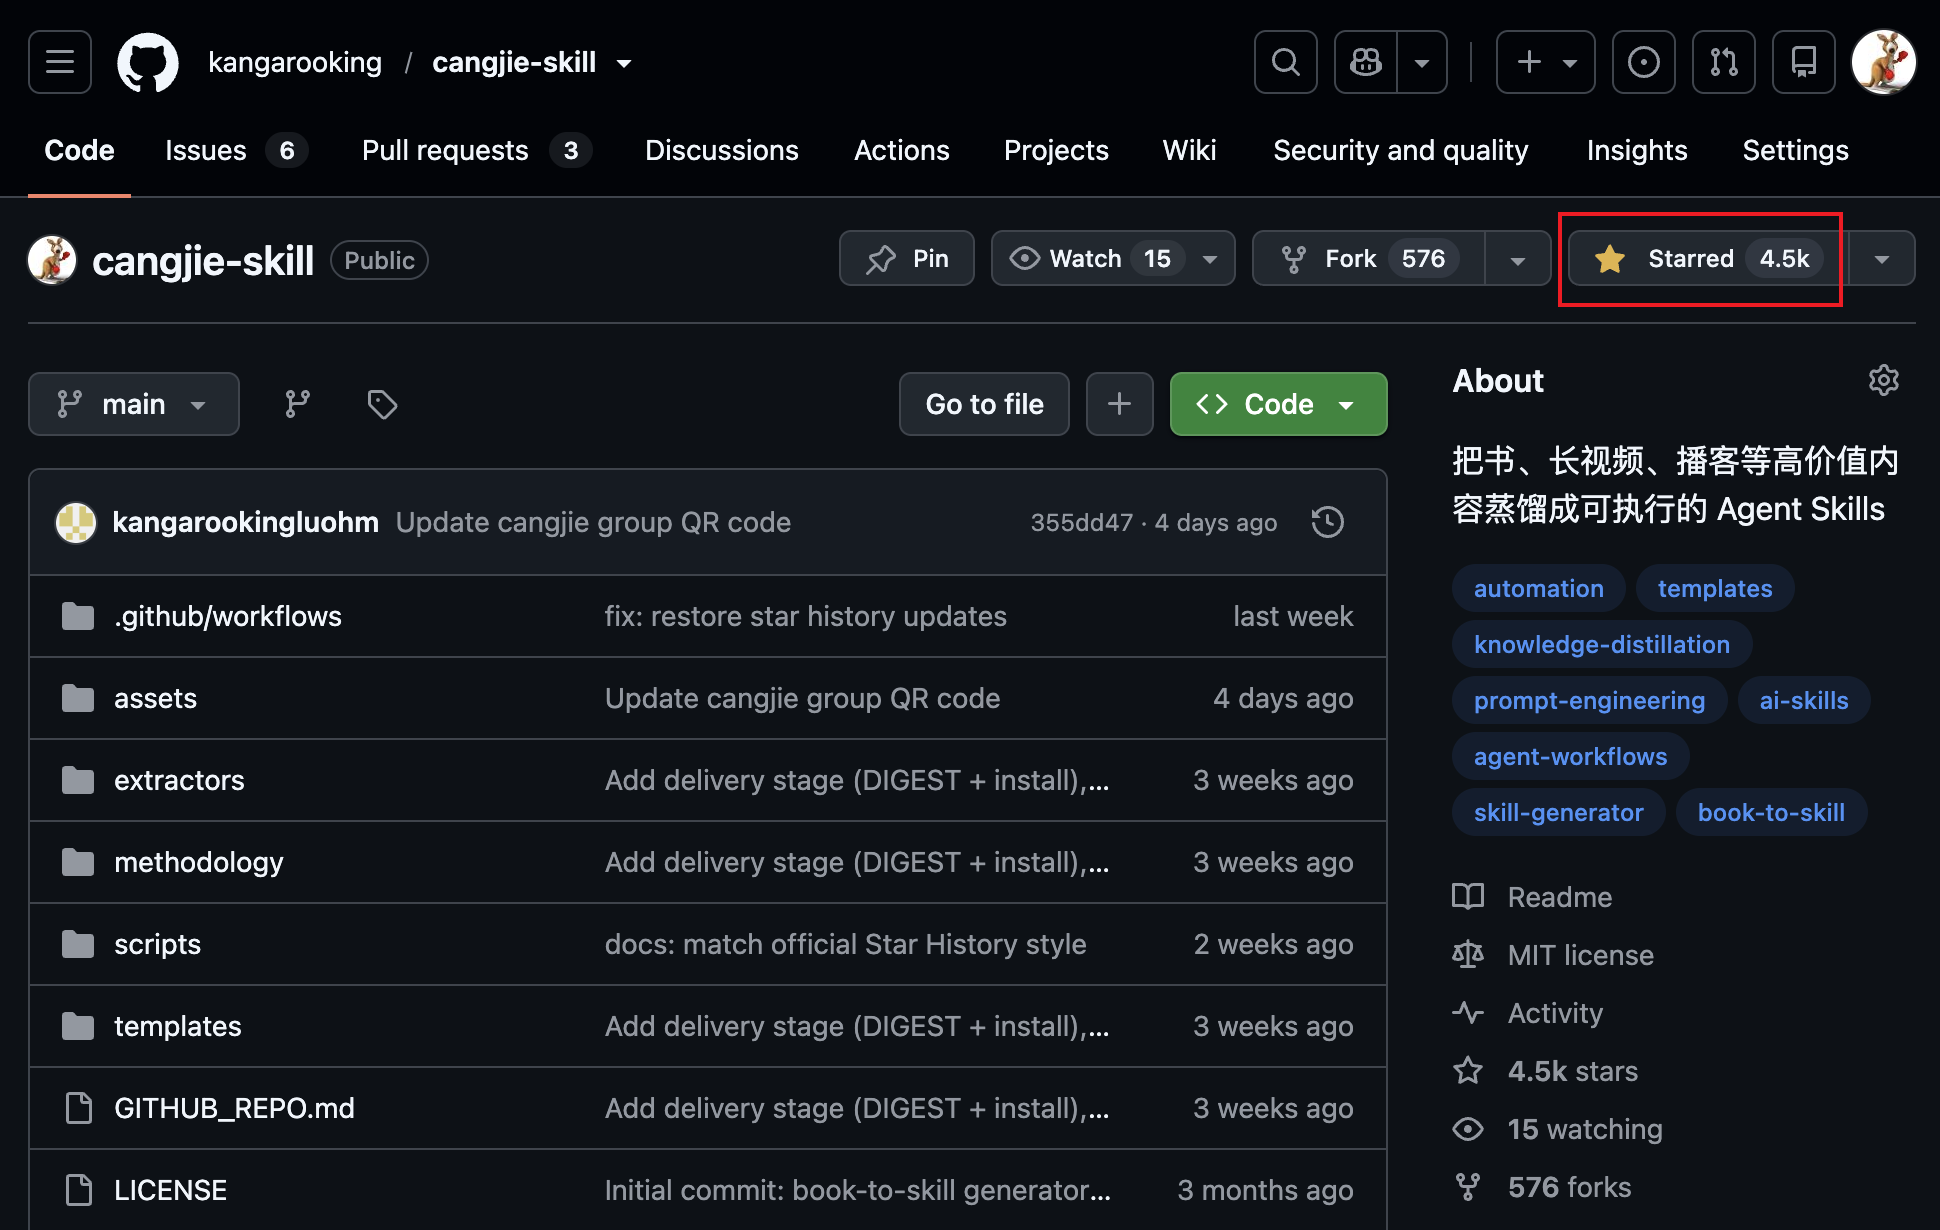
GitHub 4.5K Star!我开源的仓颉skill(cangjie-skill)火了。
我算了一下, 全网视频+文章曝光已经超100万了(说明需求很大)。
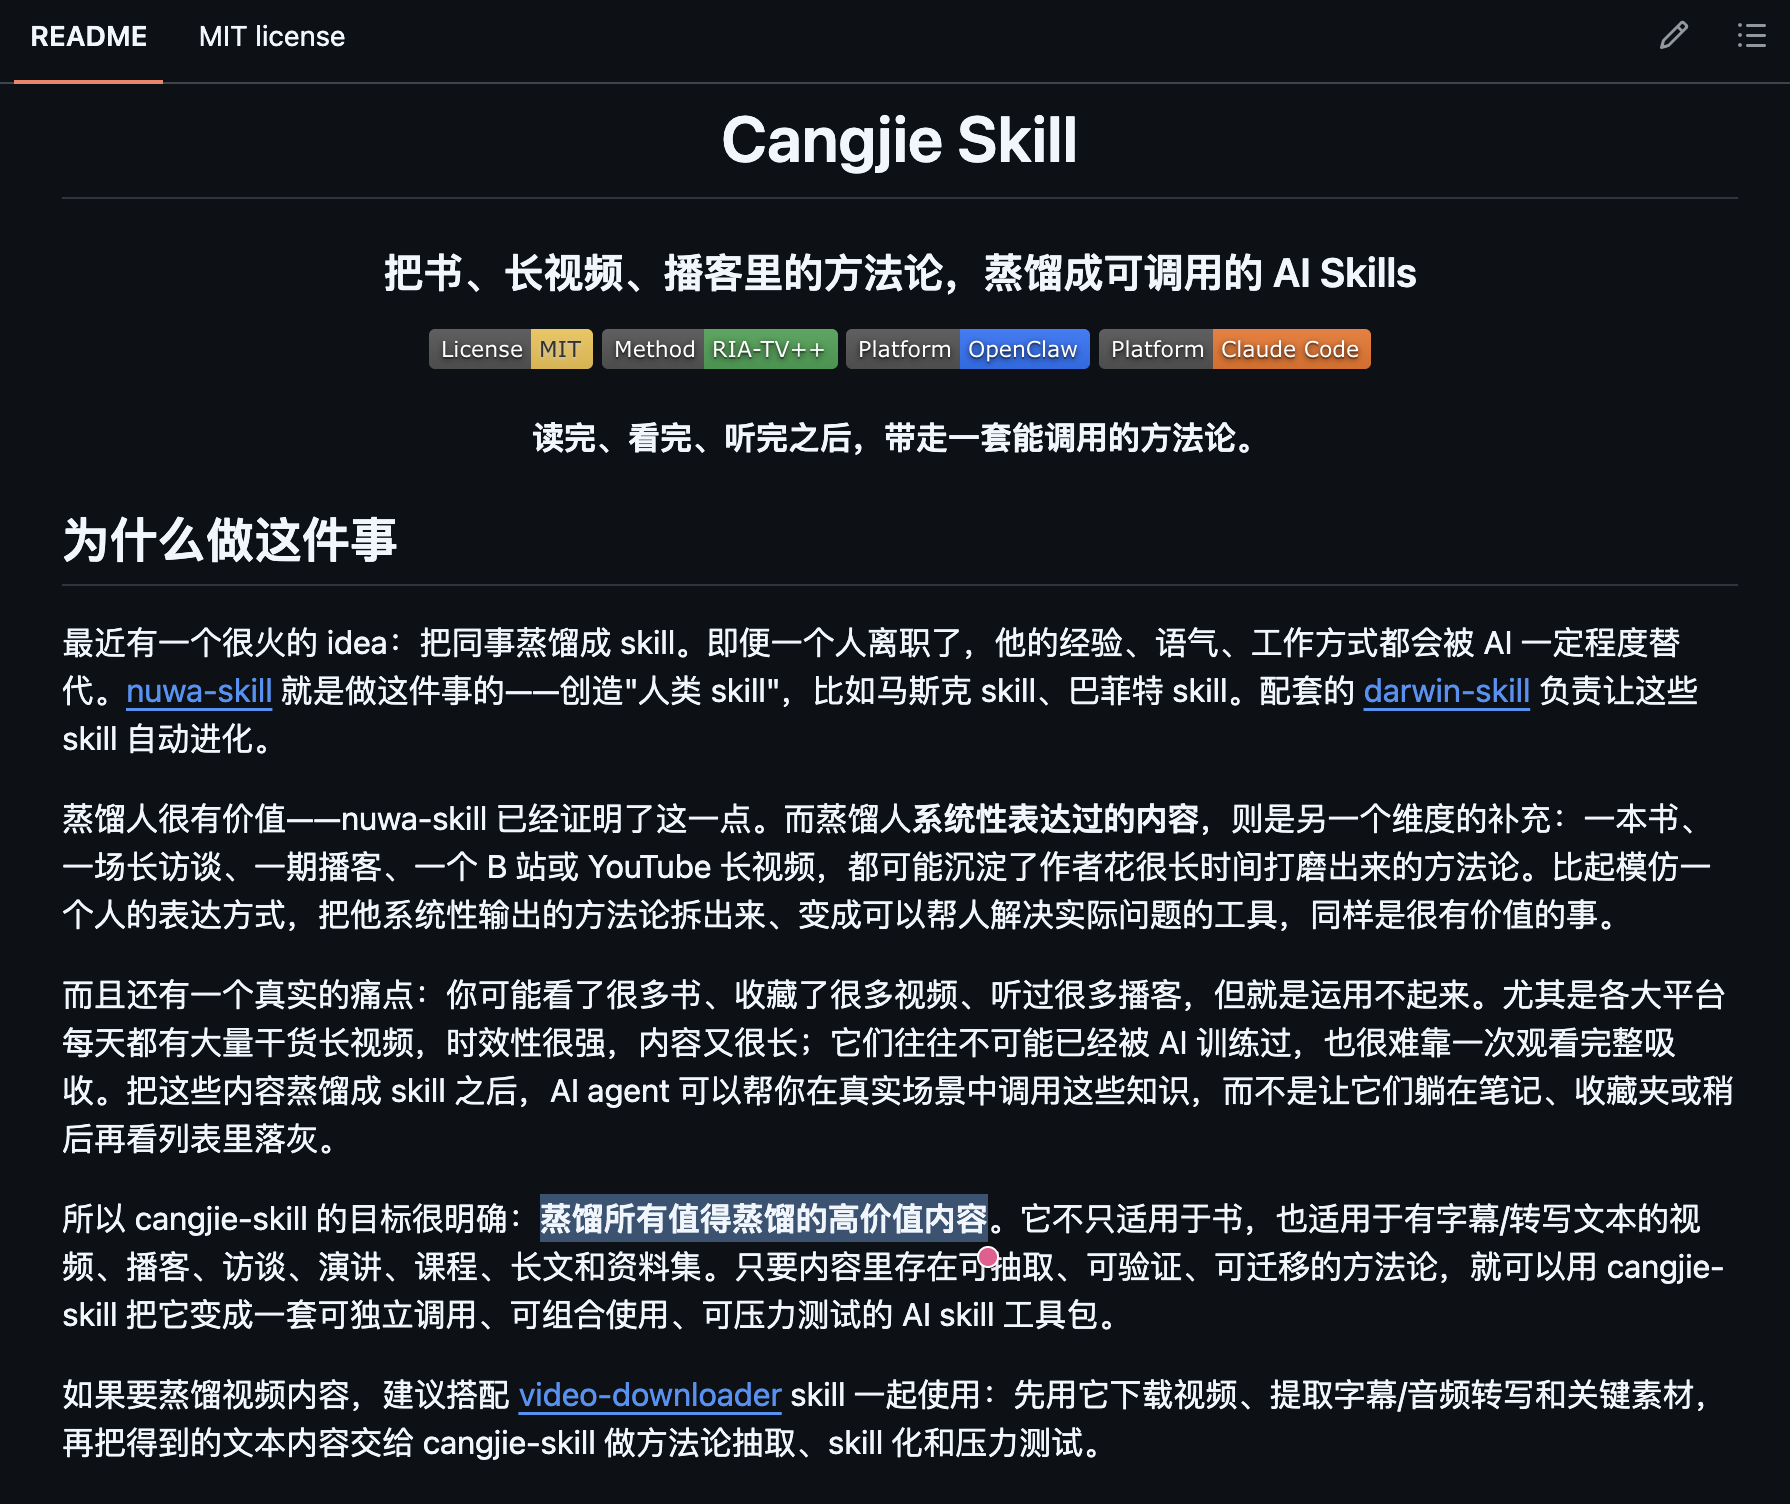
它干的事很简单:蒸馏所有值得蒸馏的高价值内容,比如把一本书、一个视频/播客,蒸馏成AI Agent能直接用的Skill,让Agent真正带着这些方法论干活。
不过,评论区和GitHub issue里问得最多的是,能不能给个在线入口?或者到底怎么用?
甚至还有朋友不知道在哪里获取开源的仓颉skill
确实,想用仓颉skill,你得先解决网络问题,把仓库拉下来,再琢磨怎么安装进本地Agent里。
对不懂技术的朋友来说,光是clone这一步可能就劝退了一大半。
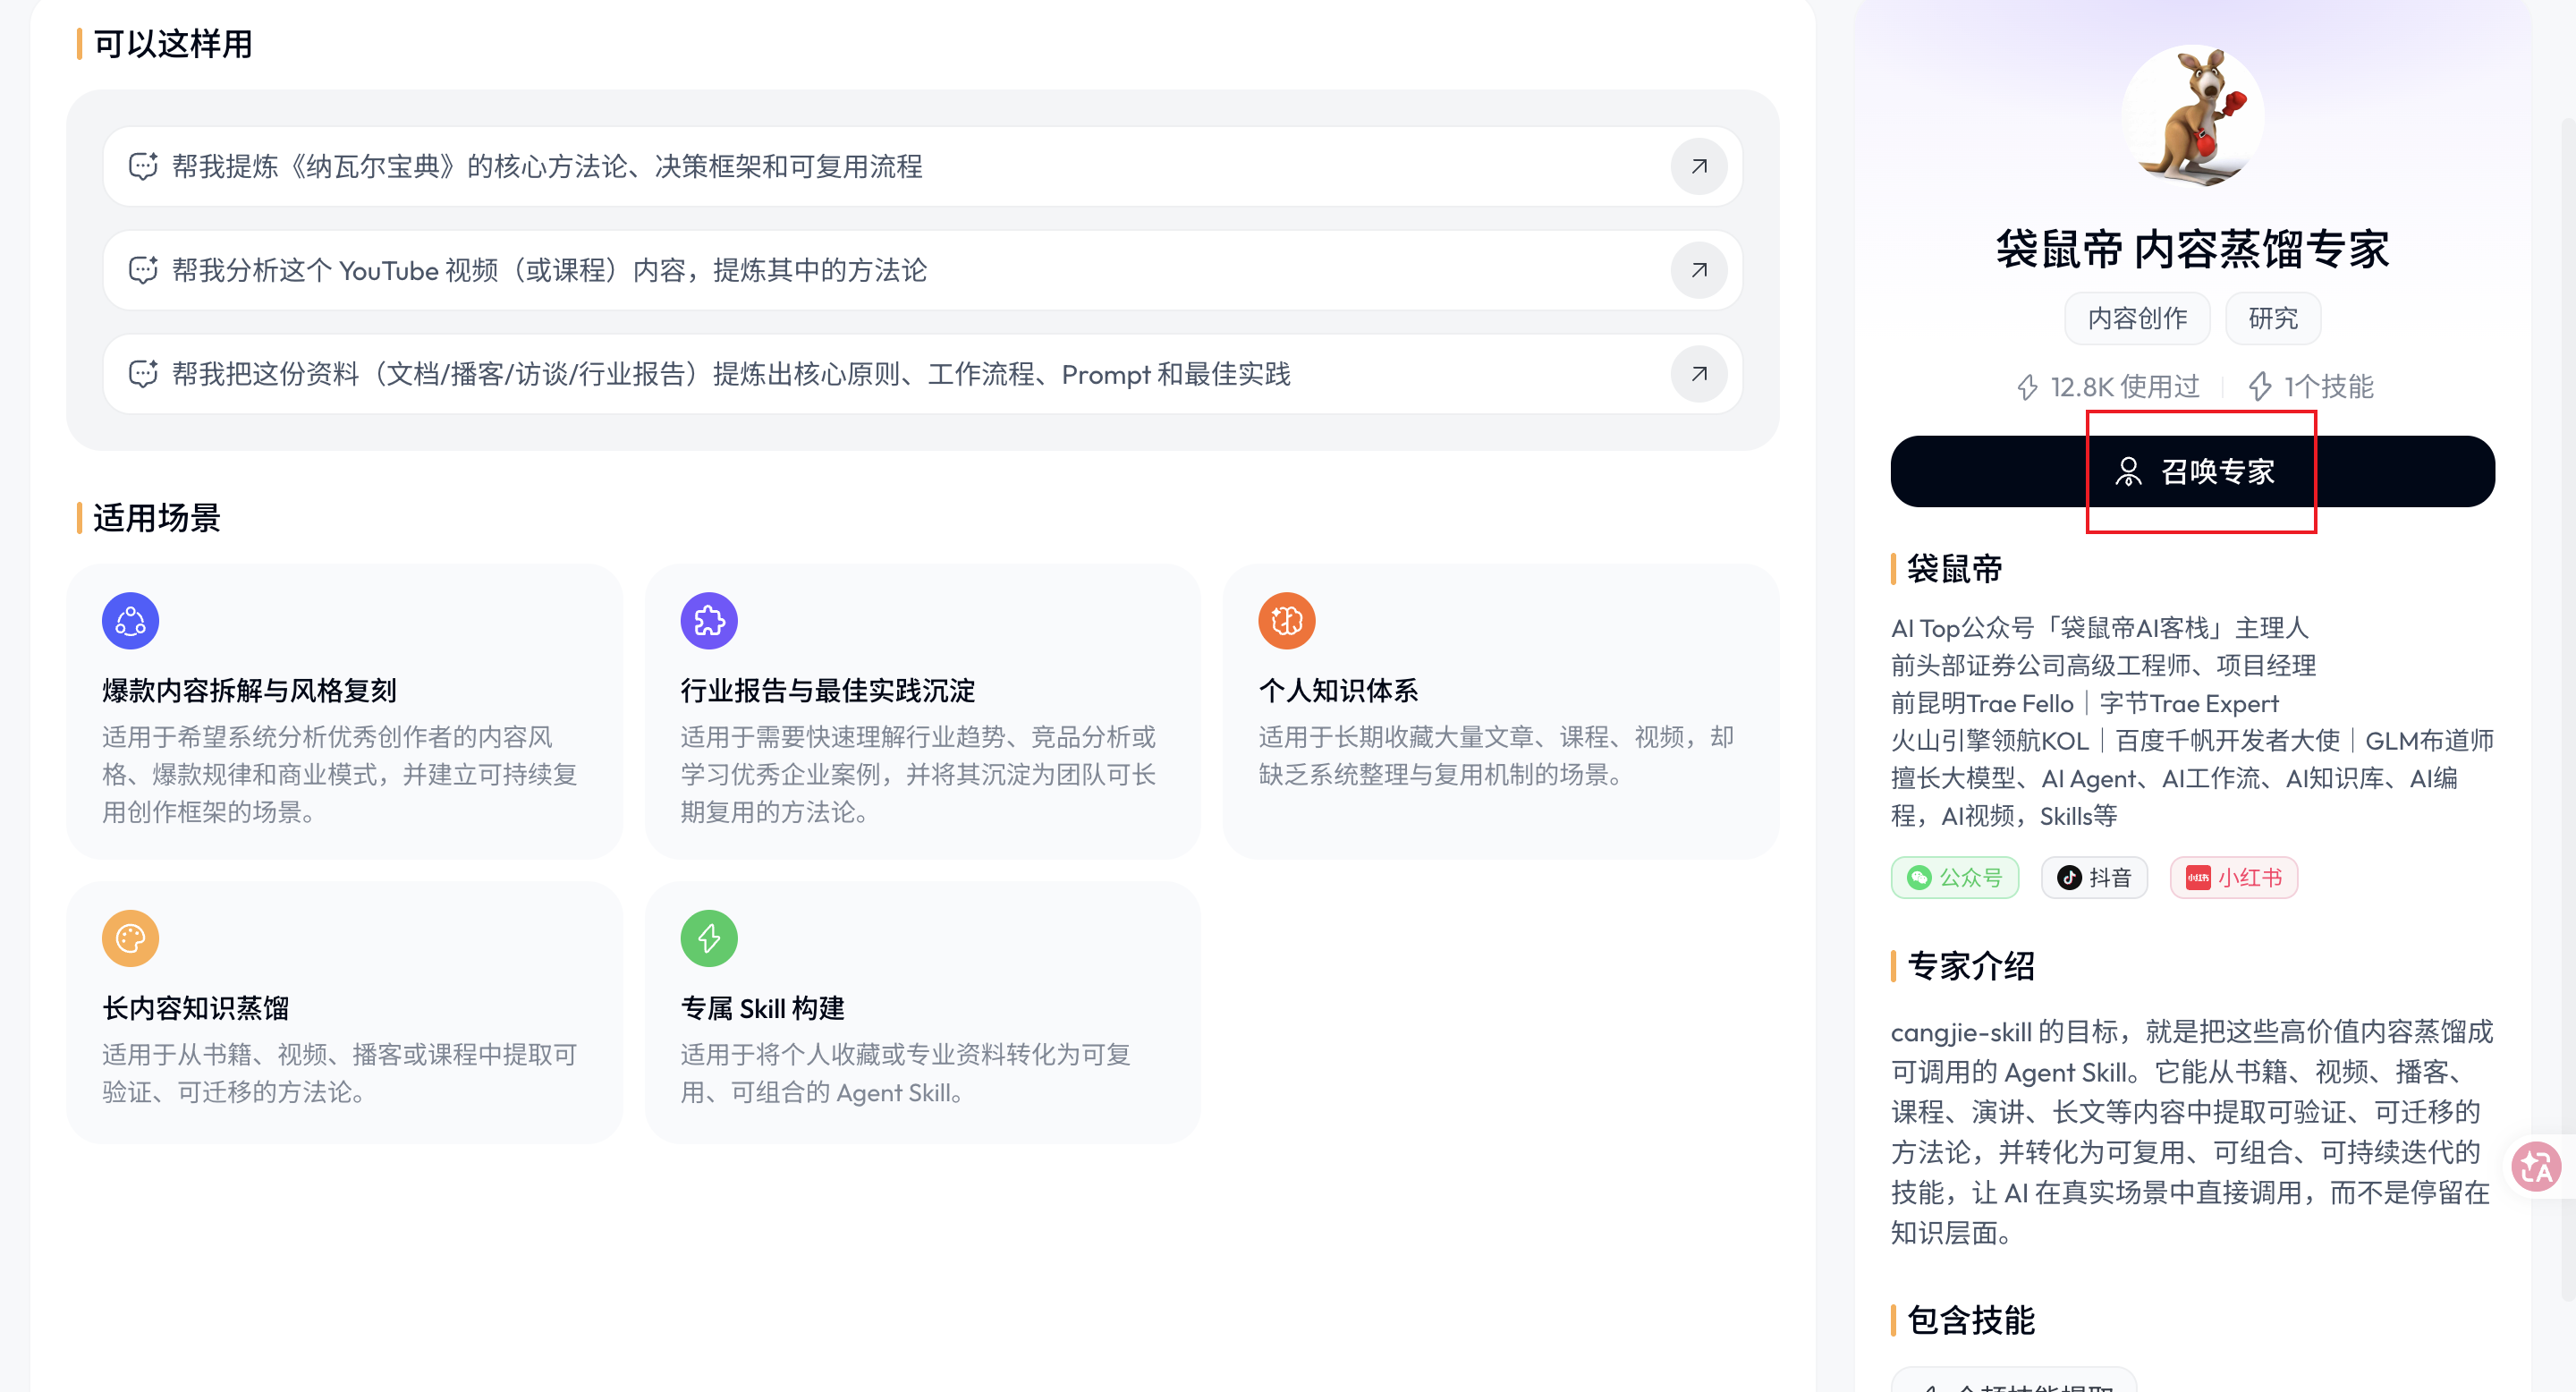
然后我搞了个网页版,在天工超级智能体上线了一个专家:
袋鼠帝·内容蒸馏专家(图3)
同时,专家每被调用一次,我也能获得一份收益分成,大家最近都在讨论的Skill 变现问题就这样被跑通了,想要Skill变现的朋友也可以参考这个方式~
这个专家底层就是cangjie-skill的完整能力,但你不用碰GitHub、不用装任何东西。国内直接打开网页就能用,完全零门槛。
体验地址见评论区👇
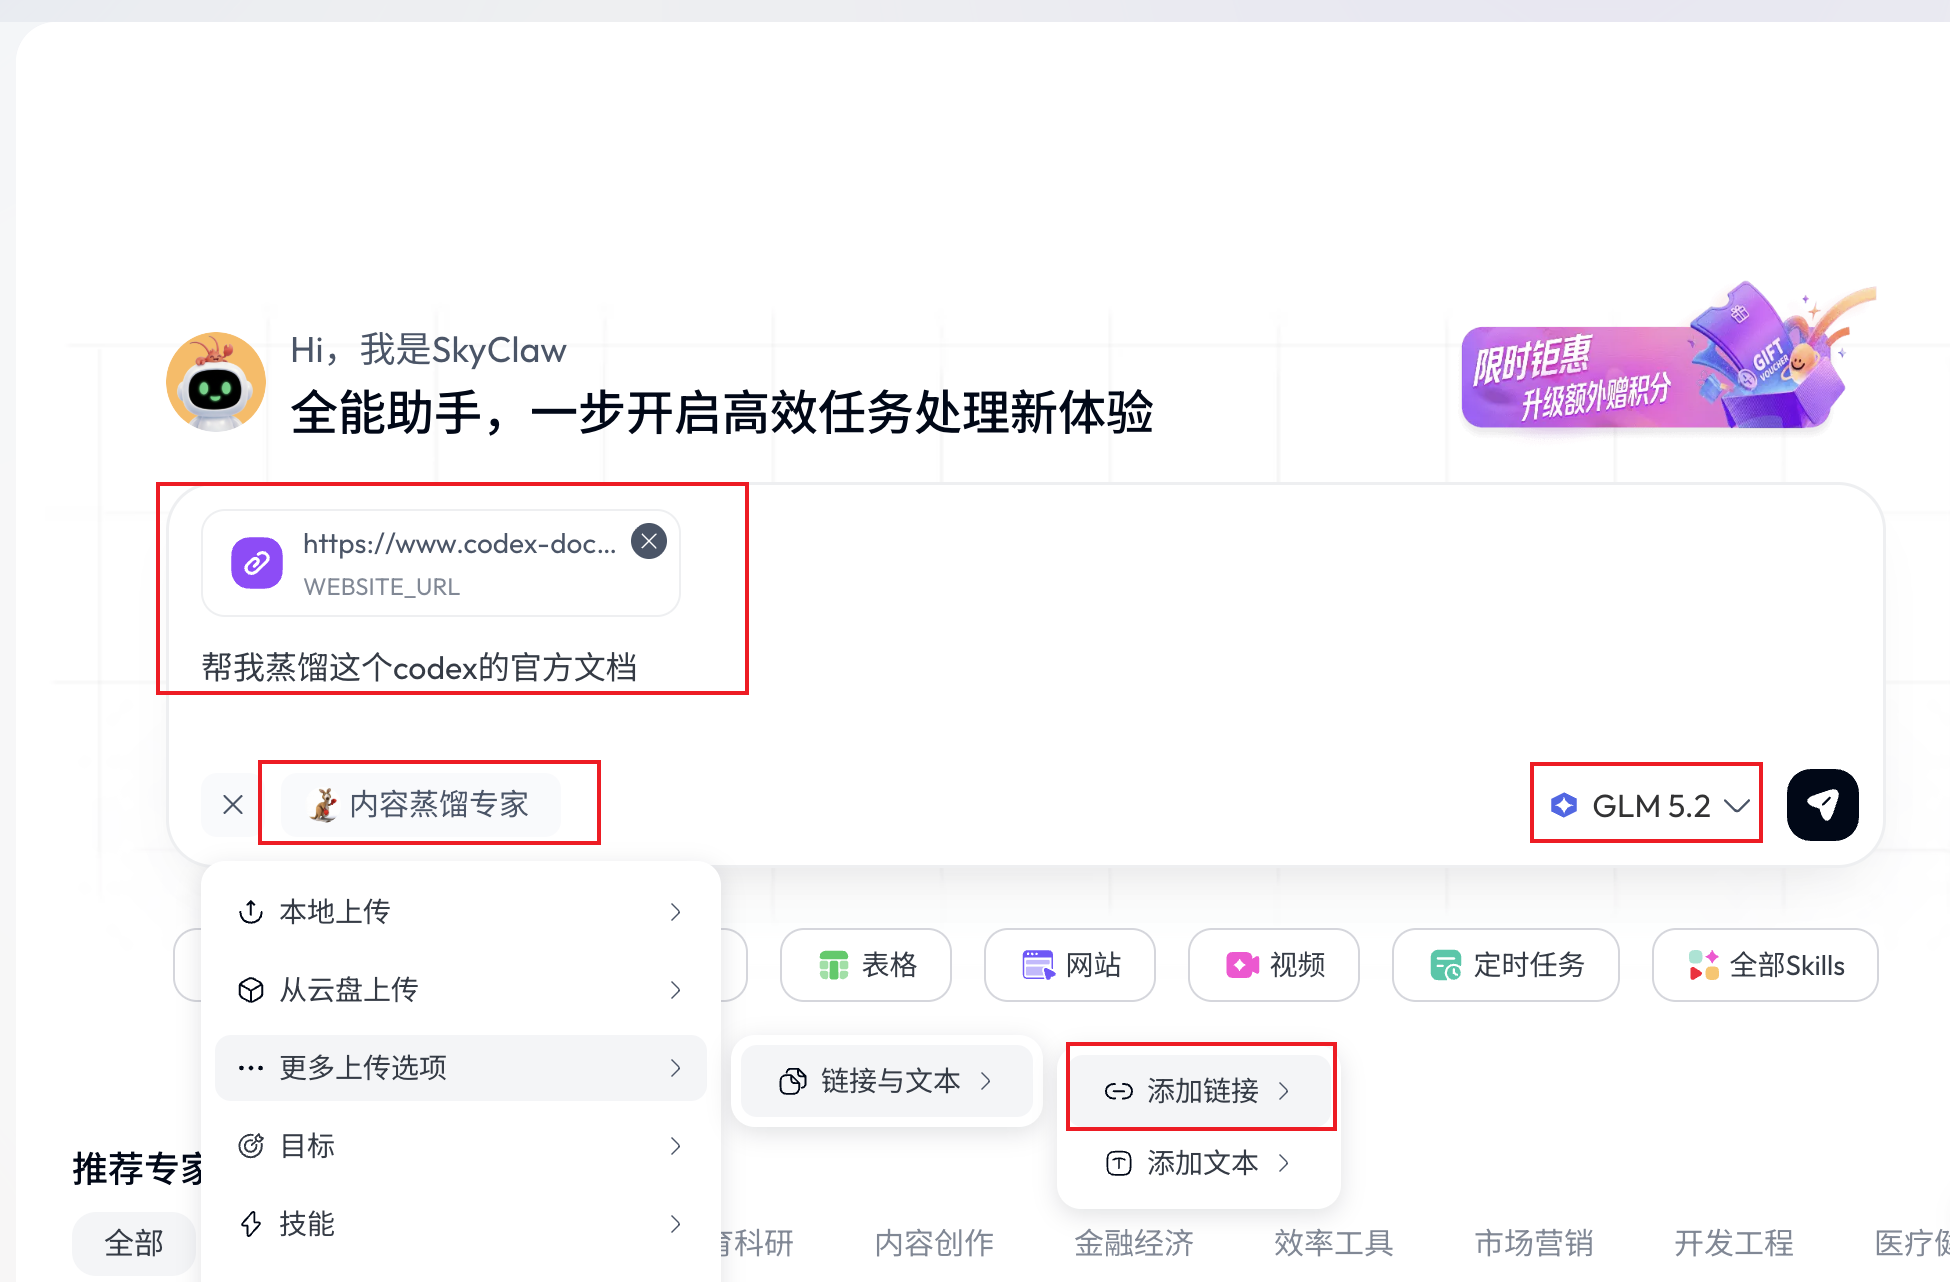
使用方式也很简单,上传你想蒸馏的内容(文件、视频),甚至还能直接给网页链接(图4,我给的Codex文档链接),剩下的交给它。
三步搞定:
1、打开体验地址,进入袋鼠帝·内容蒸馏专家。手机电脑都行,页面就是普通的对话界面,会打字就会用。
2、上传你想蒸馏的内容。可以是一本书的PDF/PPT,可以是一篇长文,也可以是链接。不只是读书,网课、行业报告、大佬访谈,只要是你觉得有价值、又没时间学都能丢给它。
第三步,模型建议选DeepSeek V4 Flash,然后告诉它你的要求,比如:把这本书蒸馏成一个skill。等它跑完,你会拿到一份结构化的skill文件。书里的方法论、案例、关键判断,全部被提炼成AI可以调用的知识。整个过程不用懂任何技术,等着"收菜"就行。
拿到蒸馏的Skill能干嘛?装进CC、Codex、天工等Agent里,AI就算读过这本书了。你问它问题,它会用书里的方法论回答你,而不是泛泛而谈。
相当于给你的AI请了一位领域专家。而且Skill可以复用,蒸馏一次,任何Agent都能带着这份知识跑。
以后技术书、内部文档、项目规范、研究论文, 都可以变成你自己的 Skill 库。普通人还在收藏 PDF。会玩的人,已经开始把知识变成 AI 能反复调用的能力了。
4 05
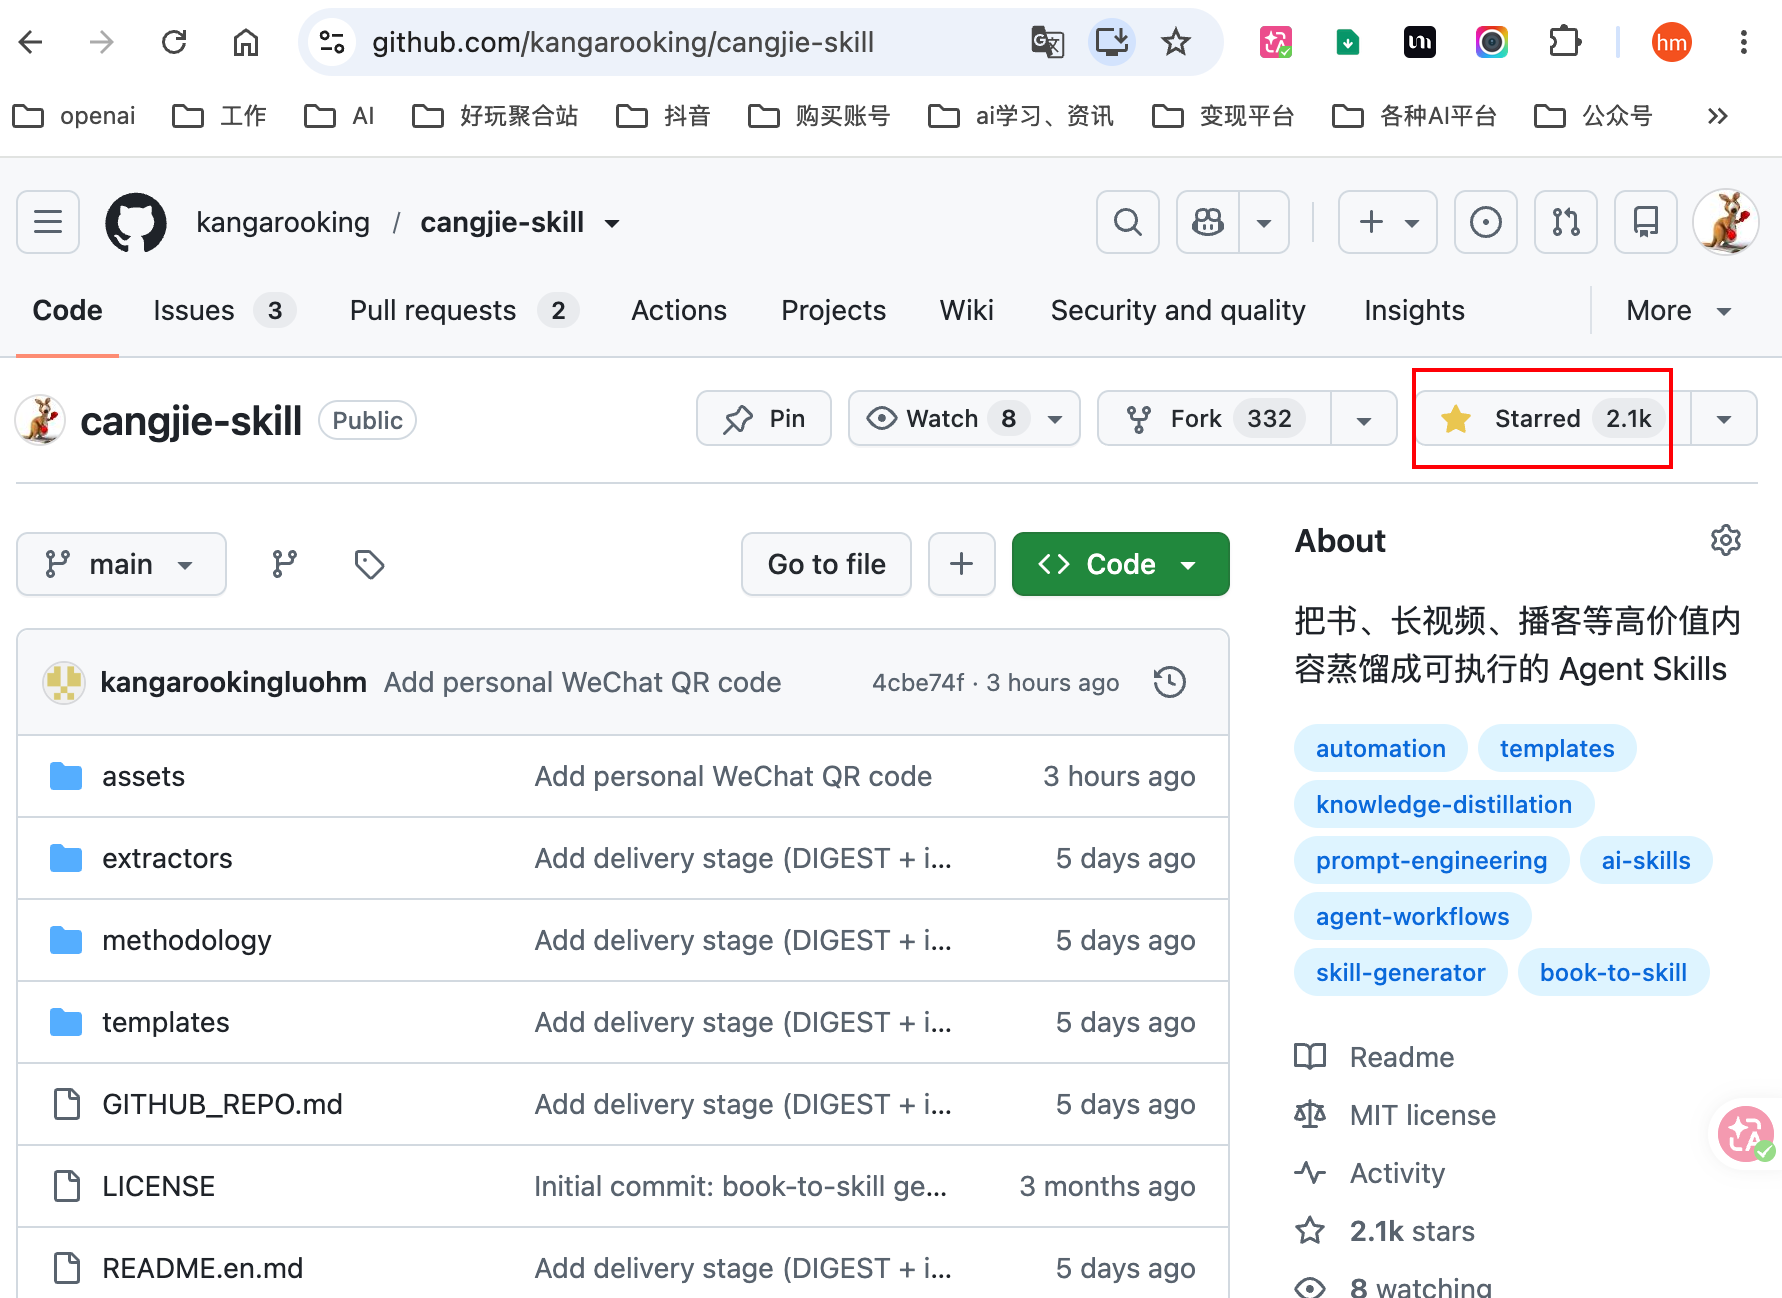
我开源的仓颉skill,火了!目前已经2.1K Star(感谢大家支持~,不过也反应了大家对仓颉skill是有需求的)
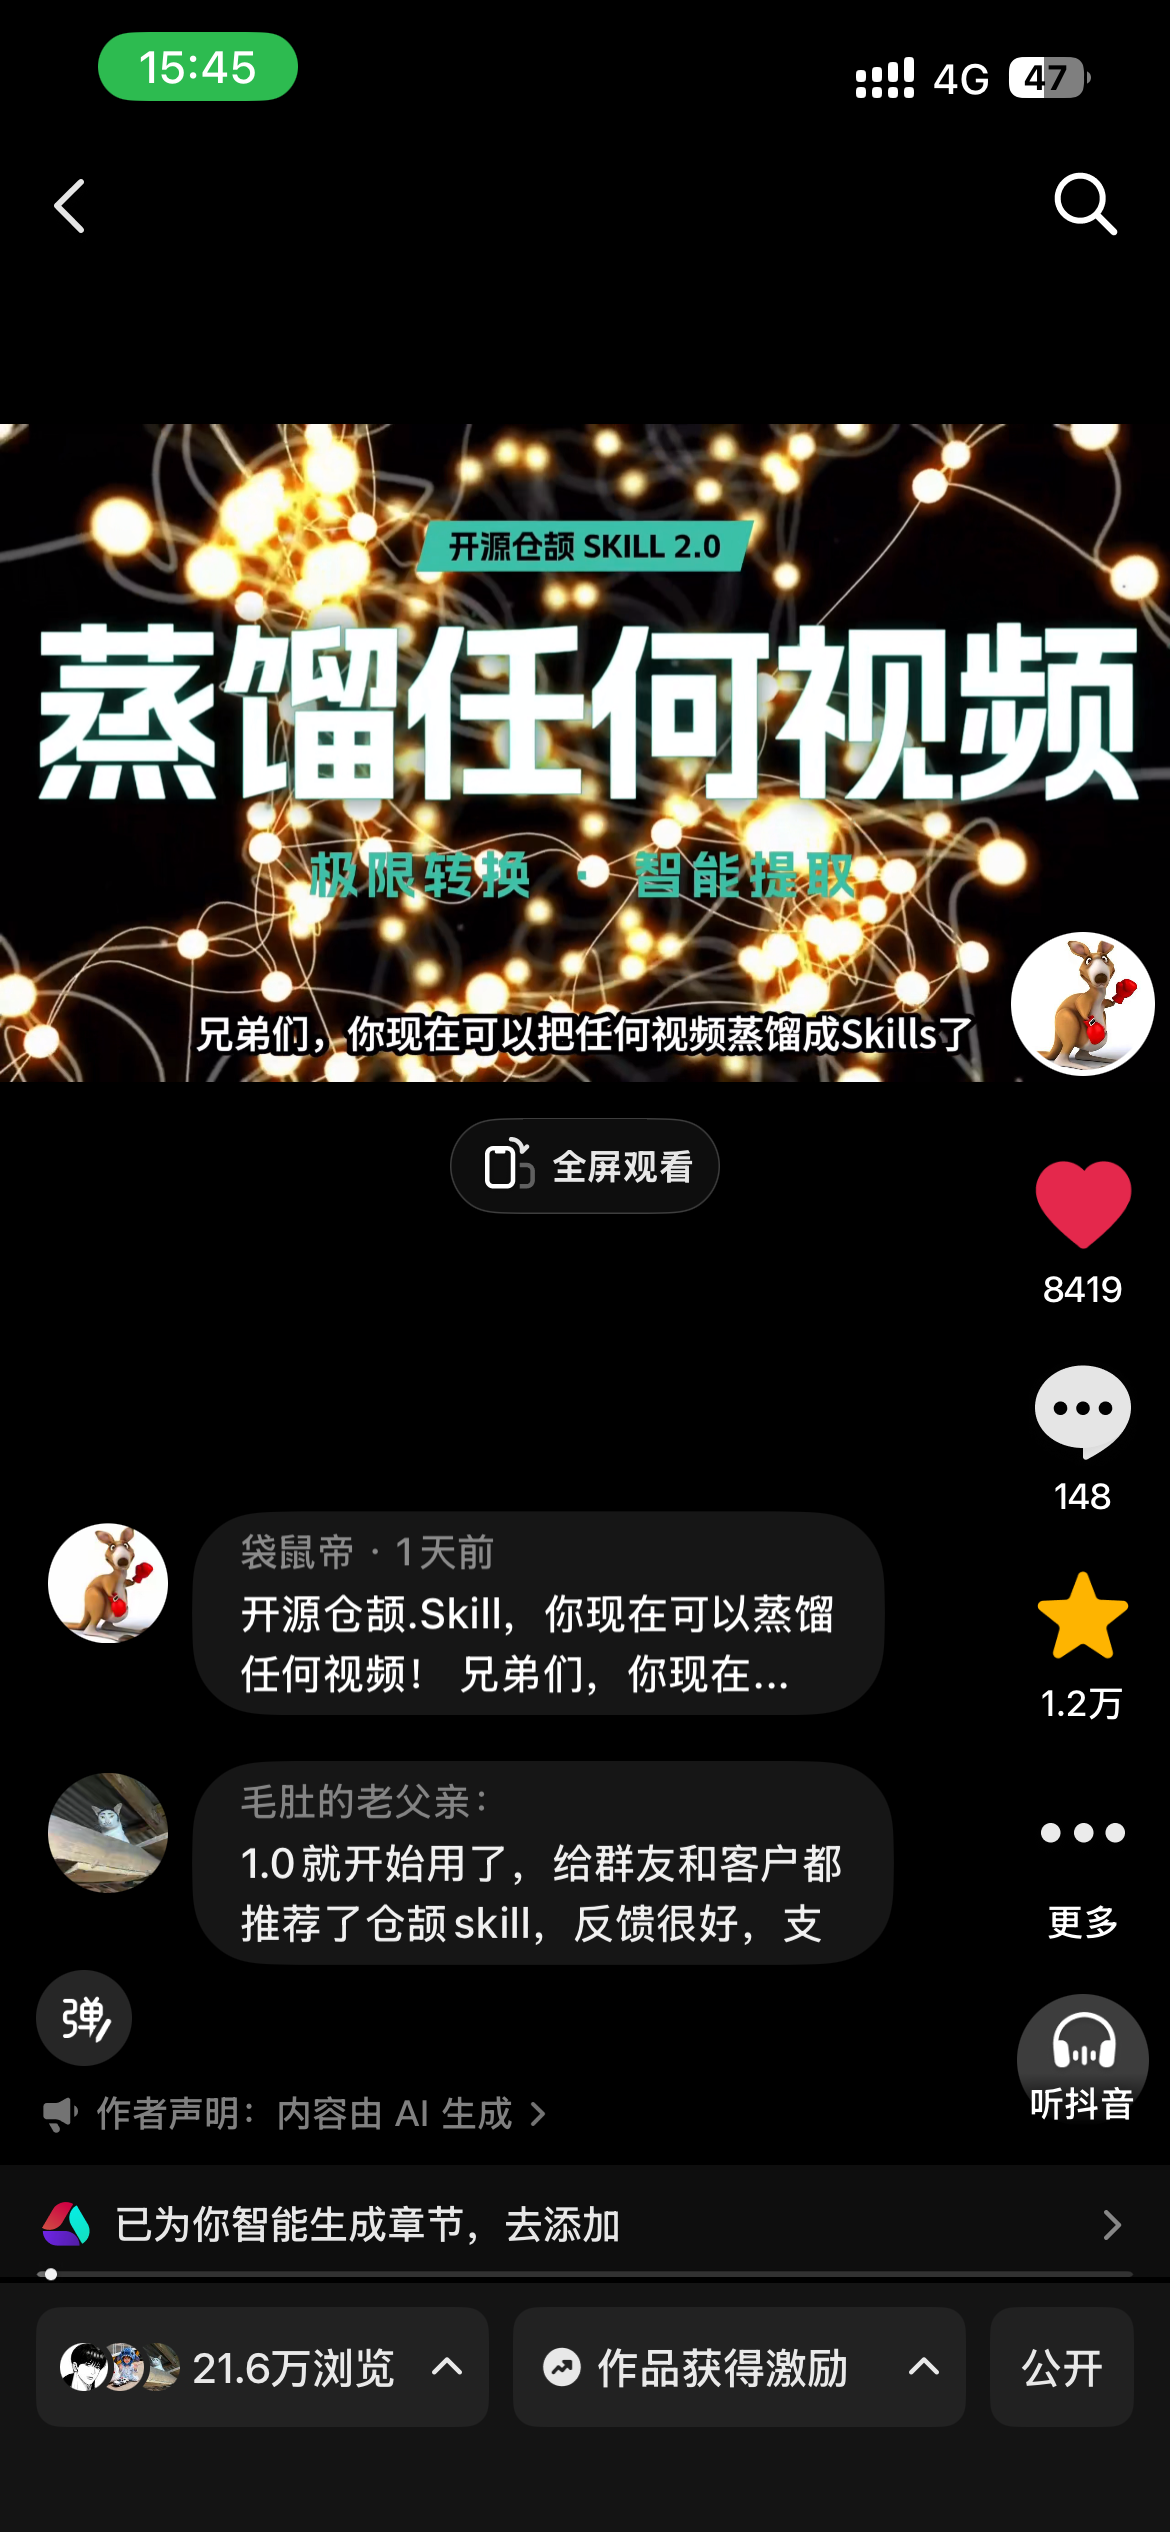
前天我本来想把仓颉skill2.0 那篇文章,转成口播视频的。但是由于有点忙,就用AI跑了条3分多钟的视频,随手在各个平台都发了,然后我就没管了。结果晚上朋友告诉我视频居然火了(小火了一把),而且在抖音、视频号、小红书、B站、X流量都还不错。
特别是在抖音居然跑到了20多万播放(关键我抖音都好久没更新视频了。。)
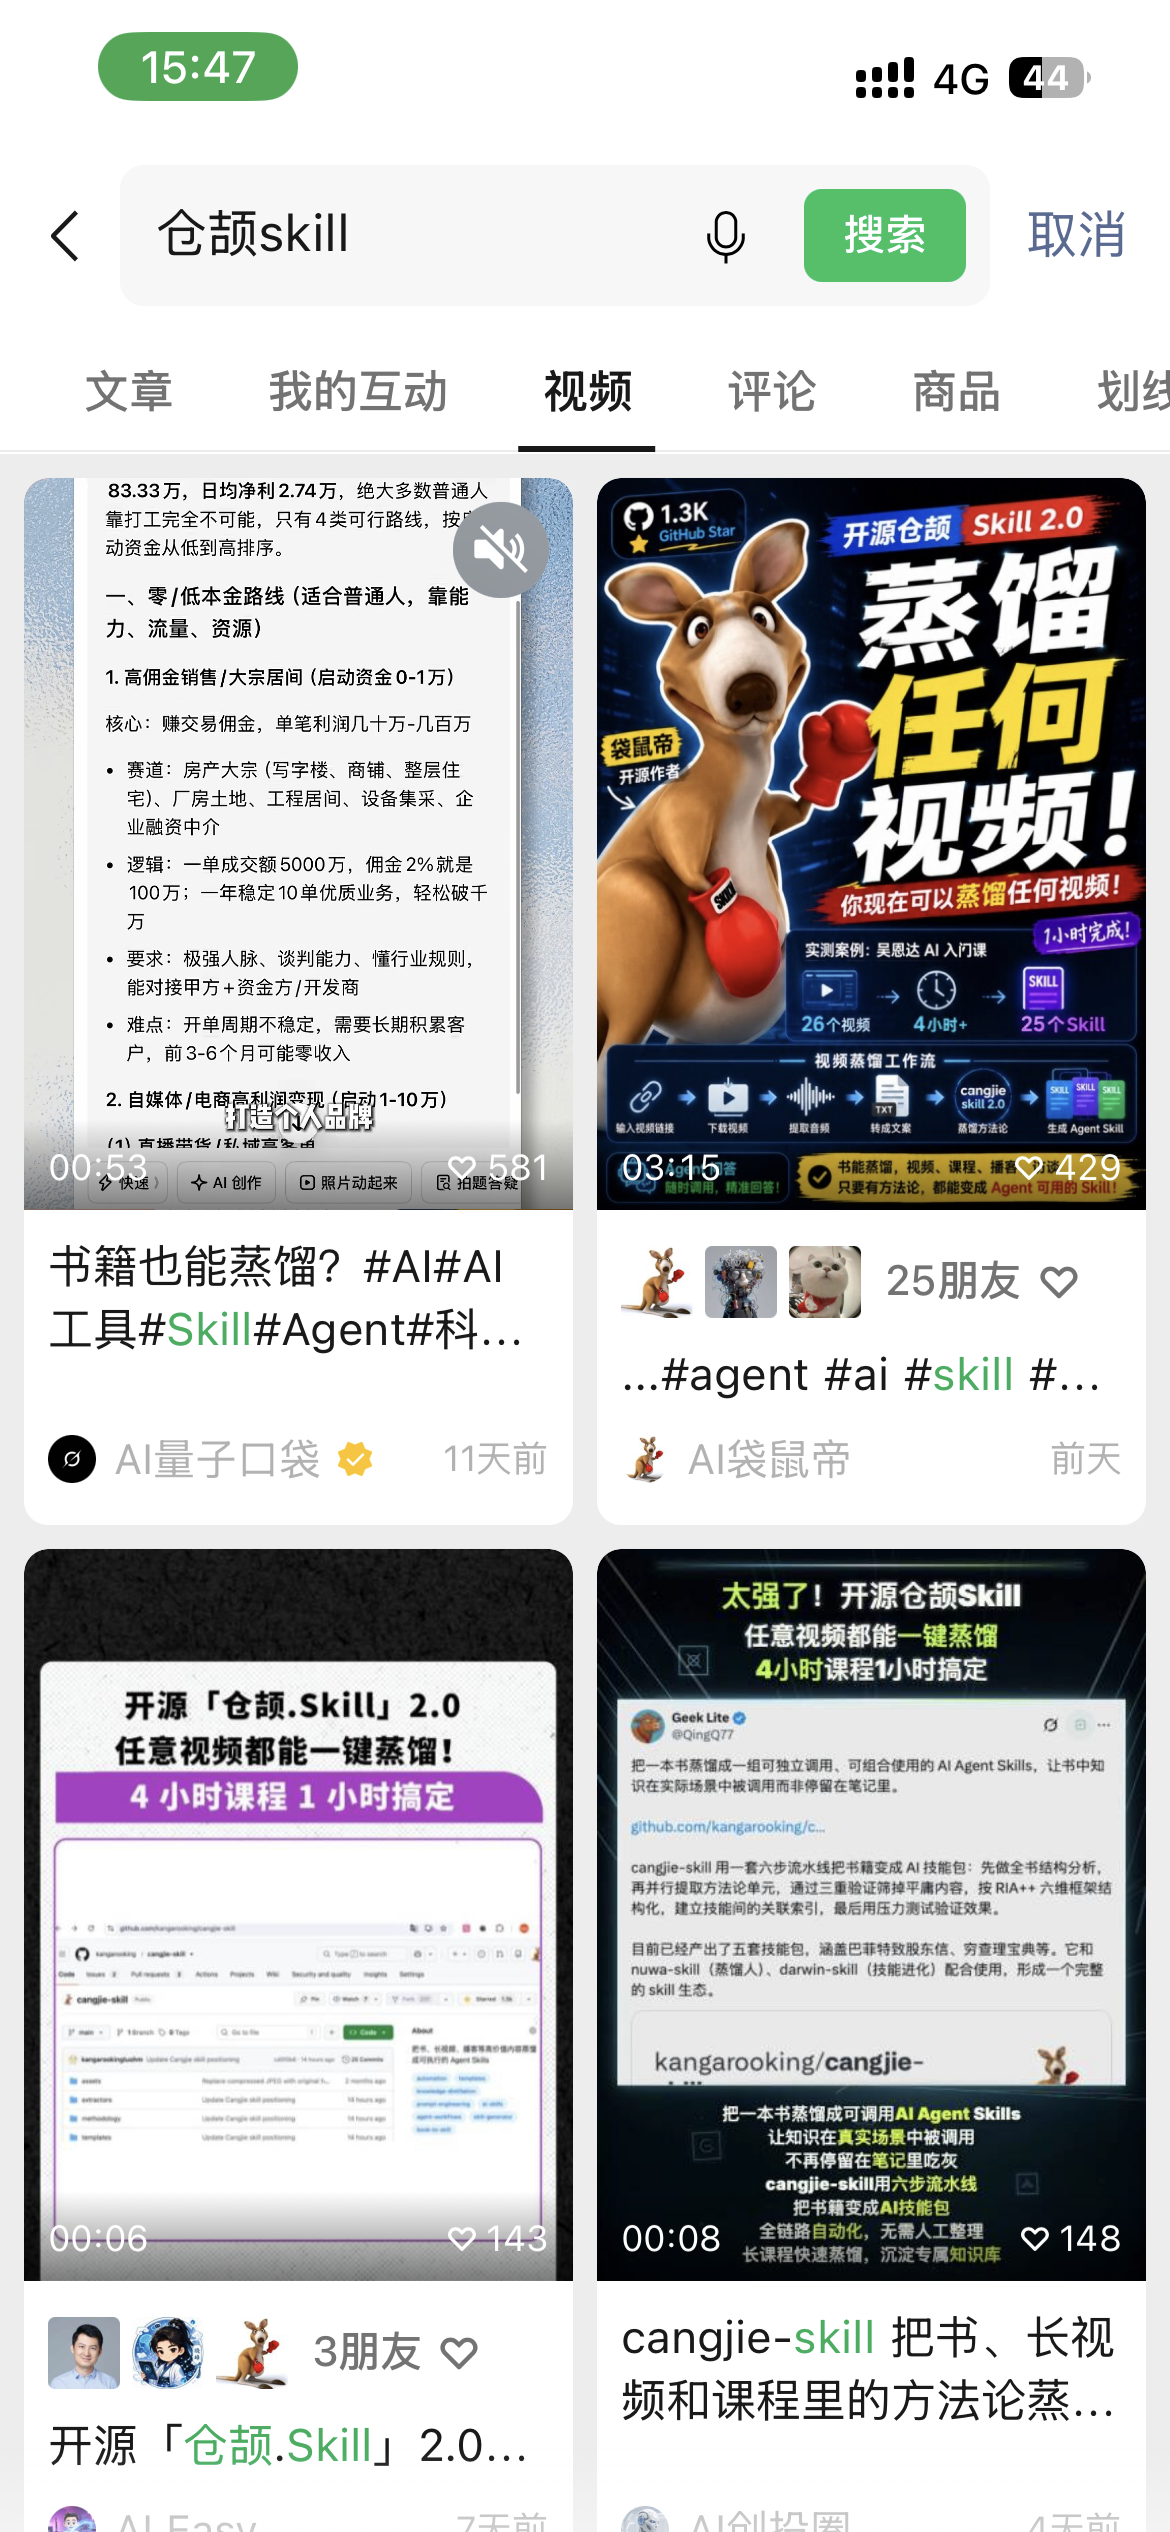
然后我就在各大平台搜了一下仓颉skill,没想到在之前就有很多朋友自发的推荐了仓颉skill,而且流量都还不错。
没想到之前突发奇想开源的一个skill,能收到这么多人的喜爱。
为了不辜负大家的厚爱,我决定继续优化迭代仓颉skill,但一个人时间和能力都有限,希望招募共创者,一起共建,感兴趣的小伙伴可以私我~
以及为了方便大家交流,我还建了一个仓颉skill的企微群,感兴趣的朋友可以扫描下面的二维码进群😄
3 00
兄弟们,你现在可以把任何视频蒸馏成skills啦🎉('ω')🎉。
比如我基于x起号的诸多信息和视频资料,蒸馏了一个x起号skills,可以用于x冷启动使用。✈️
大家有需要吗?可以在评论区聊聊~😄
比如我基于x起号的诸多信息和视频资料,蒸馏了一个x起号skills,可以用于x冷启动使用。✈️
大家有需要吗?可以在评论区聊聊~😄
03:15
1 10
上周接了个需求,客户想在本地用 1500 个文档做一个“小秘书”Agent,查会议纪要、批复文件,要求准确率极高,特别是要能查确定性的项目金额和时间。
第一反应是用 FastGPT 直接搭。但我拉朋友仔细盘了一下,发现这事儿没那么简单。知识库最难的从来不是「搭建」,而是调优。
这种包含大量会议纪要的场景,传统 RAG 只要遇到多跳推理大概率就 GG 了。
举个例子:
文档1说“A公司收购了B公司”,文档2说“张三是A的CTO”,文档3说“张三离职加入了盘古项目”。
此时用户问:“收购B公司的企业,其CTO后来去了哪?”
传统检索拿着问题去找,能找到1和2,但绝对找不到3。因为文档3里根本没有“收购”、“B公司”这些词,字面没有交集,线索直接断了。
那用 GraphRAG 呢?太重了。大量调用 LLM 离线提取三元组建图,一个中等数据集光索引成本就大几万,进来新文件还得重算,维护成本贼高,杀鸡用牛刀。
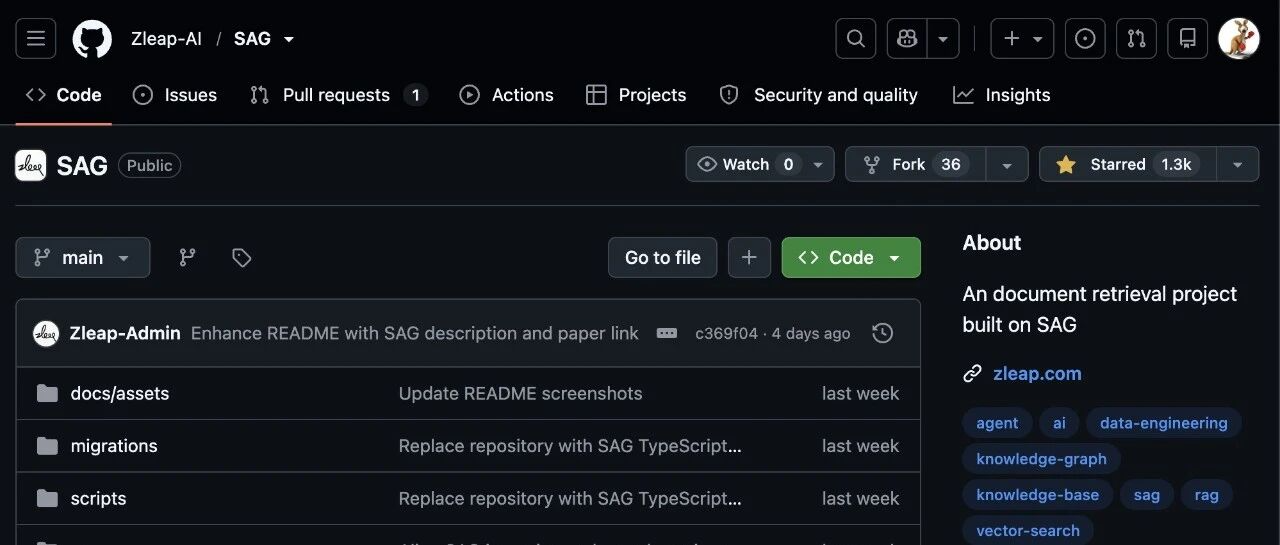
找了一圈,发现个刚开源、在 GitHub 斩获 1.3K Star 的新架构:SAG (SQL-Retrieval Augmented Generation)。
github.com
看到底层是用 SQL 动态组装超边,我一下子就来精神了。
它的核心思路特别“返璞归真”:不画全局关系图,而是文档入库时,用 AI 提炼成「事项-实体」存进普通 SQL 数据库。查询时,用 SQL 的 JOIN 语句动态把有关联的事项拎出来,实时串联线索。
换个接地气的比喻:
传统 RAG 是个死板的图书管理员,靠字面意思死找。
GraphRAG 是提前花大价钱把所有书的人名、事件画一张巨大的全局关系网挂墙上。
SAG 走了第三条路,把书变成独立卡片存表里。回到刚才那个问题,SAG 在搜出文档 1 和 2 的同时,用 SQL 发现了它们之间的隐藏实体「张三」,并自动触发第二轮查询,精准命中包含张三去向的文档 3。让多跳推理变成了确定的事。
除此之外,SAG 还有两个对开发者极其友好的特性:
1. 告别“黑盒炼丹”: 传统 RAG 调优基本是瞎摸索,改切块、改重排,按下葫芦浮起瓢。而 SAG 的检索链条是完全可追溯的 SQL 日志。大模型提了什么实体 -> 命中了哪些 -> 路线哪里断了,看一眼就能修,砍掉 80% 盲目调优的时间。
2. 不挑模型: 因为核心找线索靠的是确定的 SQL 实体关联,而不是模糊的向量距离。底层就算换个便宜的弱模型,准确率也极其稳定。
目前的评测里,SAG 在最难的多跳测试集 MuSiQue 上,把大火的 HippoRAG 2 按在地上摩擦,且已经在生产环境扛住了 5 亿条数据的秒级检索。
回到落地,这套怎么玩?
纯从头搭一套 SAG 工程量太大,烂尾风险极高。
比较推荐的解法是:站在巨人的肩膀上,把 SAG 作为 MCP 工具,丝滑接入 FastGPT。
既能复用 FastGPT 成熟的前端界面和飞书/微信接入能力,又能用 SAG 的思想彻底解决“切块破碎”和“多跳关联”的死穴。当然,你也可以通过 MCP 把它接入 Claude Code 或者 Trae 里作为本地 Agent 的利器。
把用了几十年的老古董 SQL 拉进 AI 检索,这波创新太稳了。拿到确定性更强的数据底座,本地 Agent 的推理能力绝对能更上一层楼。
3 00
视频号视频一直没有官方保存入口,存下来要么带水印,要么画质压成渣🤔
最近找到一个免费的解法,分享给大家,3步搞定[吃瓜]:
1、打开视频号,点右下角分享 → 复制链接 ;
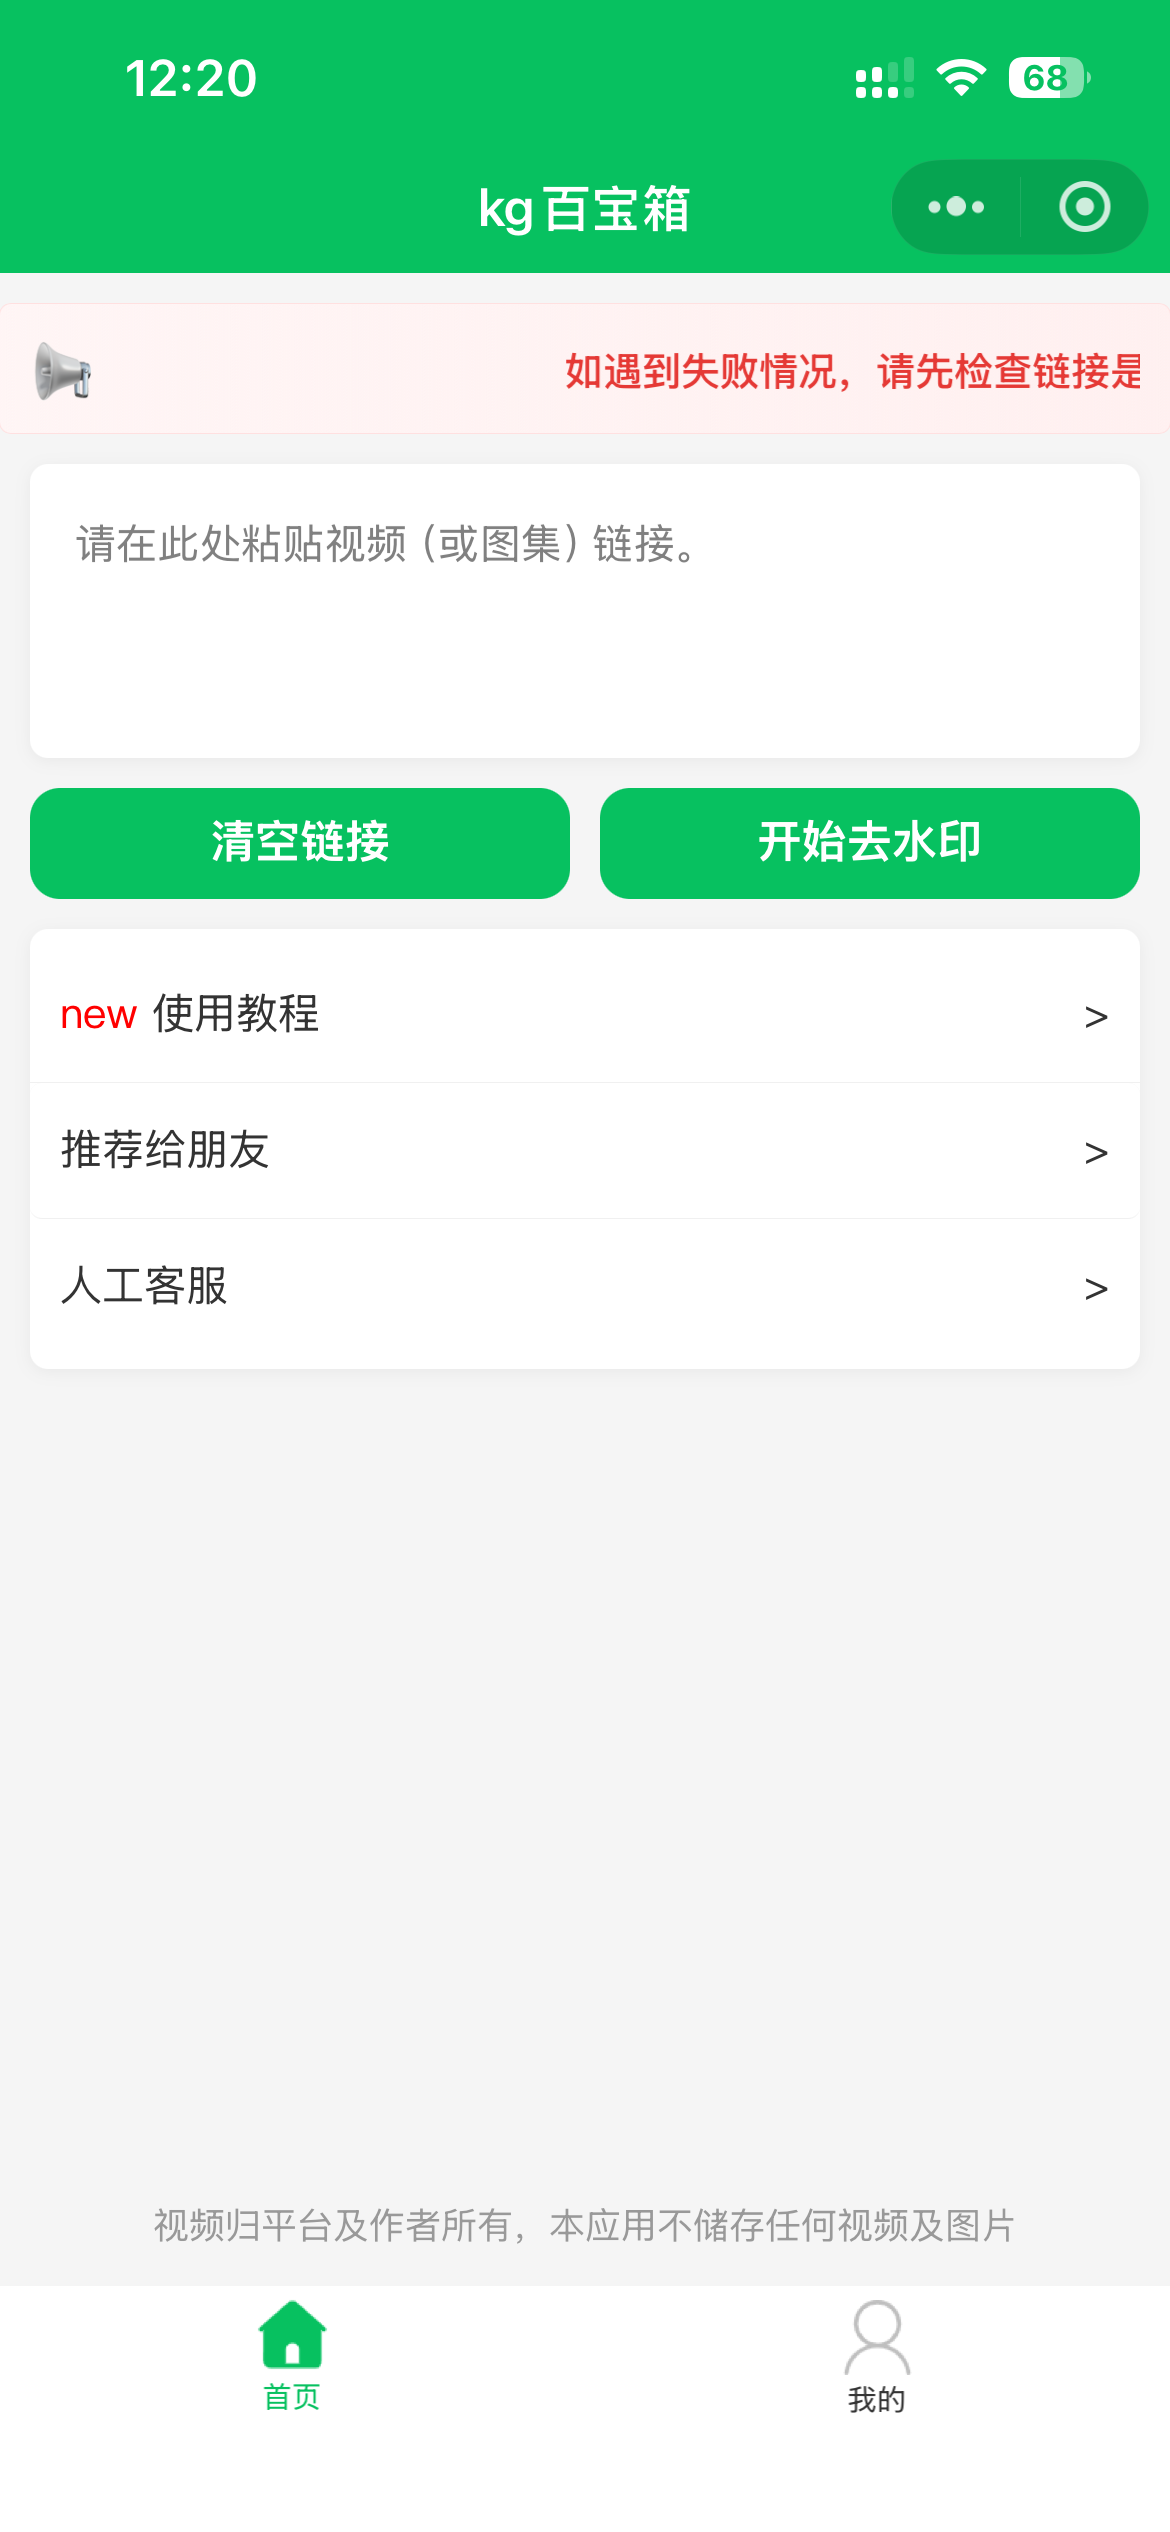
2、微信搜小程序"kg百宝箱",粘贴链接 ;
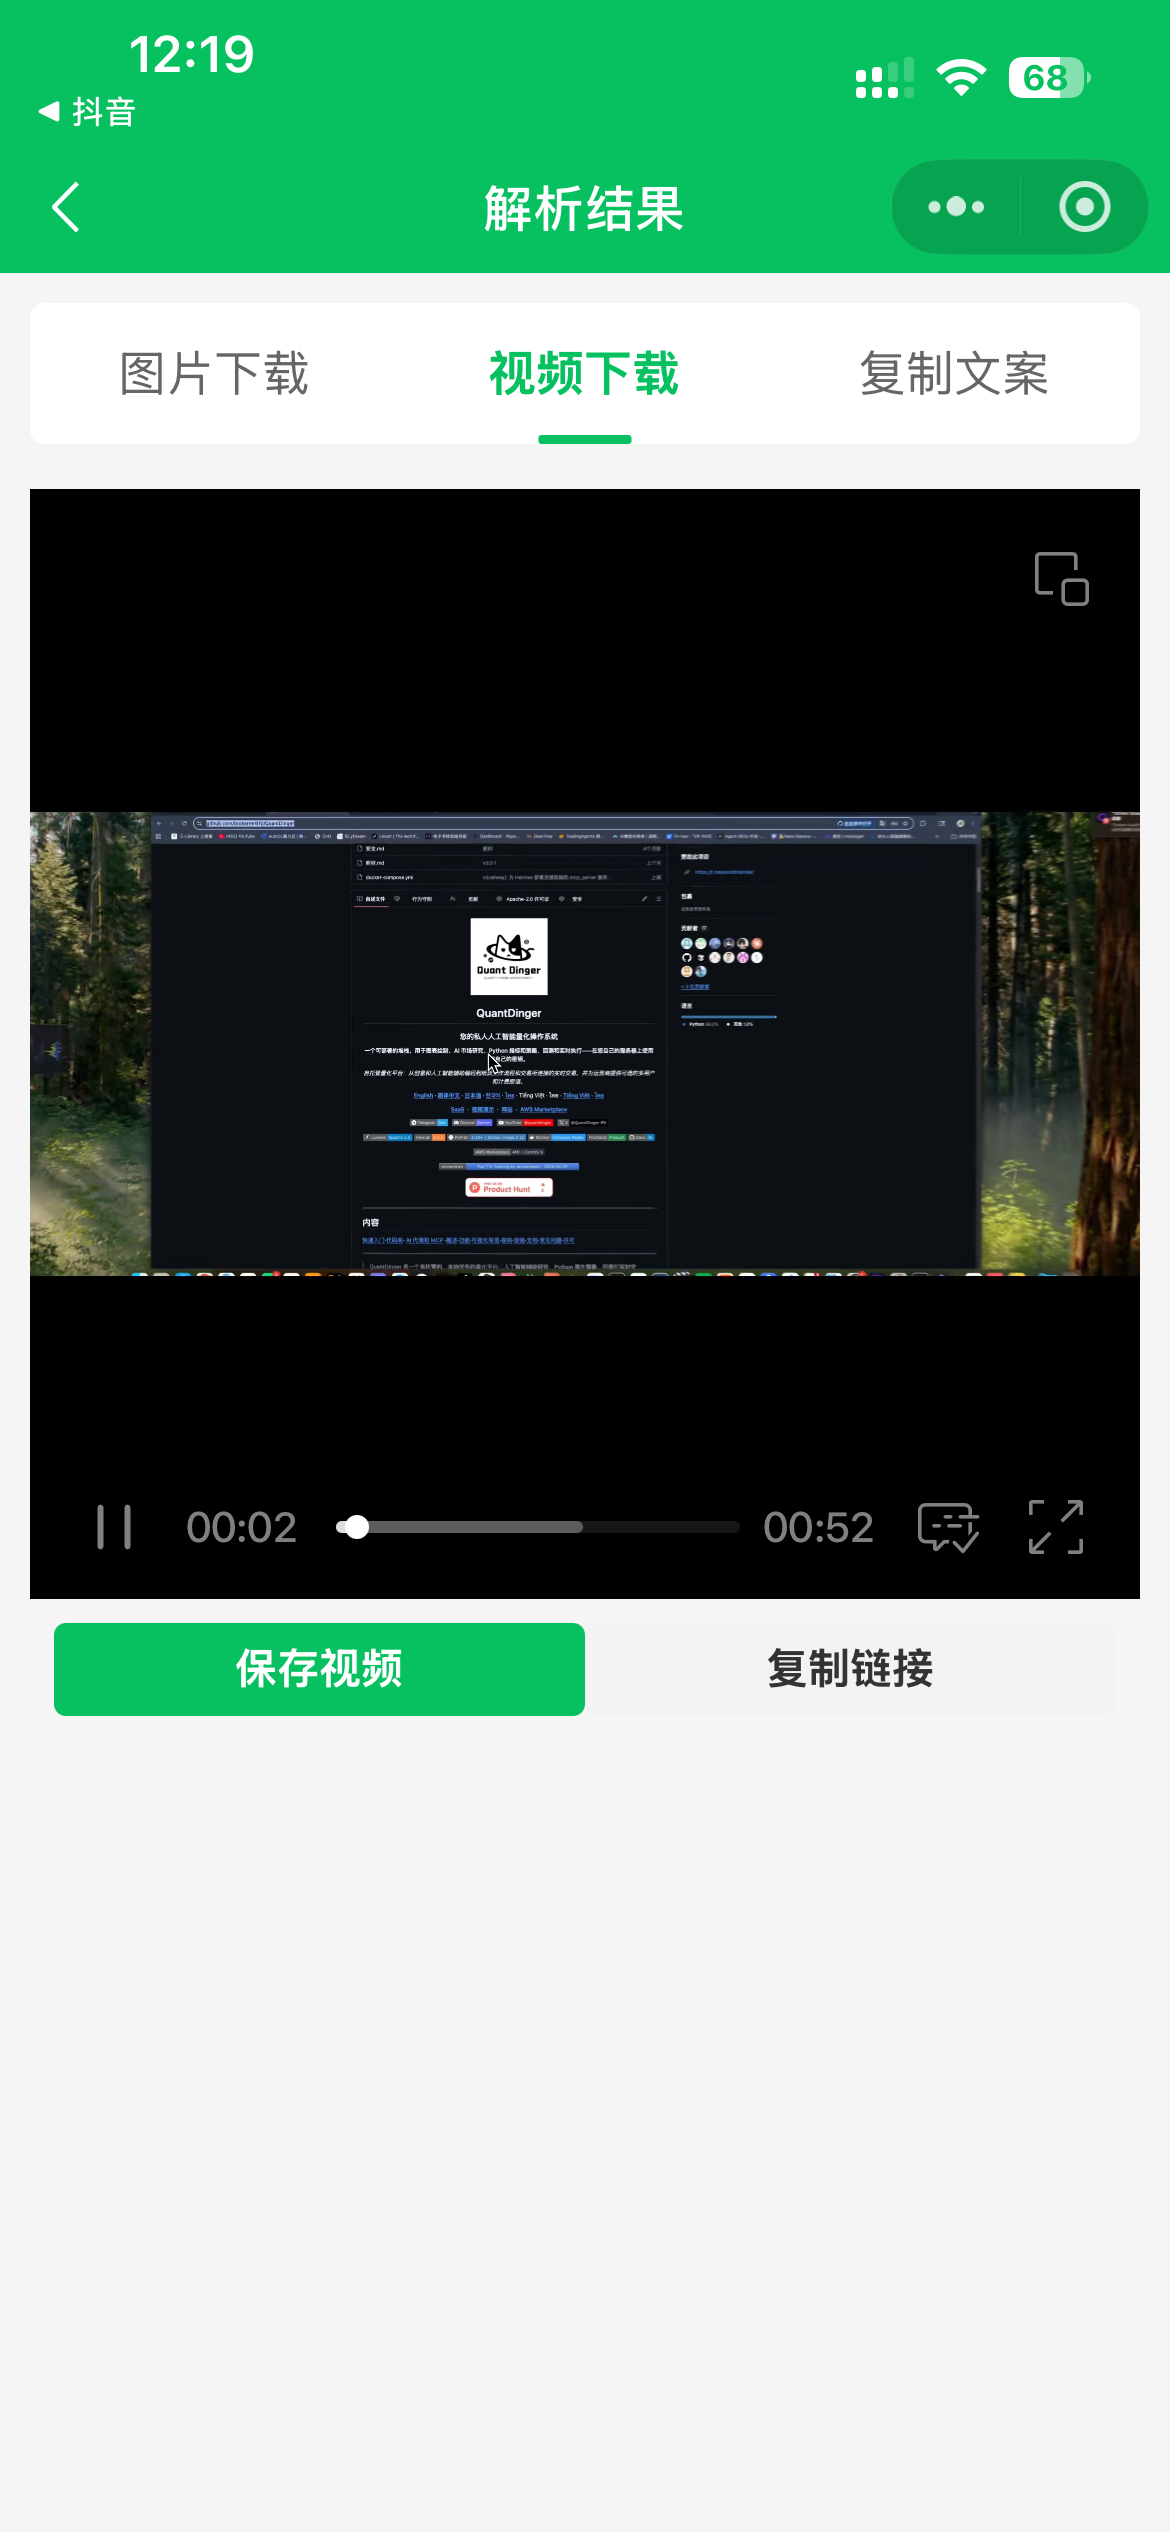
3、一键解析,直接存相册,原画质无水印。
不只是视频号。豆包、即梦、千问生成的AI视频,抖音快手小红书被设了禁止下载的内容,全都能解析,下载,并去除官方水印。
苹果安卓都能用,也不用注册登录。
唯一注意:微信要是最新版本,旧版本链接解析会失效。
最近找到一个免费的解法,分享给大家,3步搞定[吃瓜]:
1、打开视频号,点右下角分享 → 复制链接 ;
2、微信搜小程序"kg百宝箱",粘贴链接 ;
3、一键解析,直接存相册,原画质无水印。
不只是视频号。豆包、即梦、千问生成的AI视频,抖音快手小红书被设了禁止下载的内容,全都能解析,下载,并去除官方水印。
苹果安卓都能用,也不用注册登录。
唯一注意:微信要是最新版本,旧版本链接解析会失效。
1 00
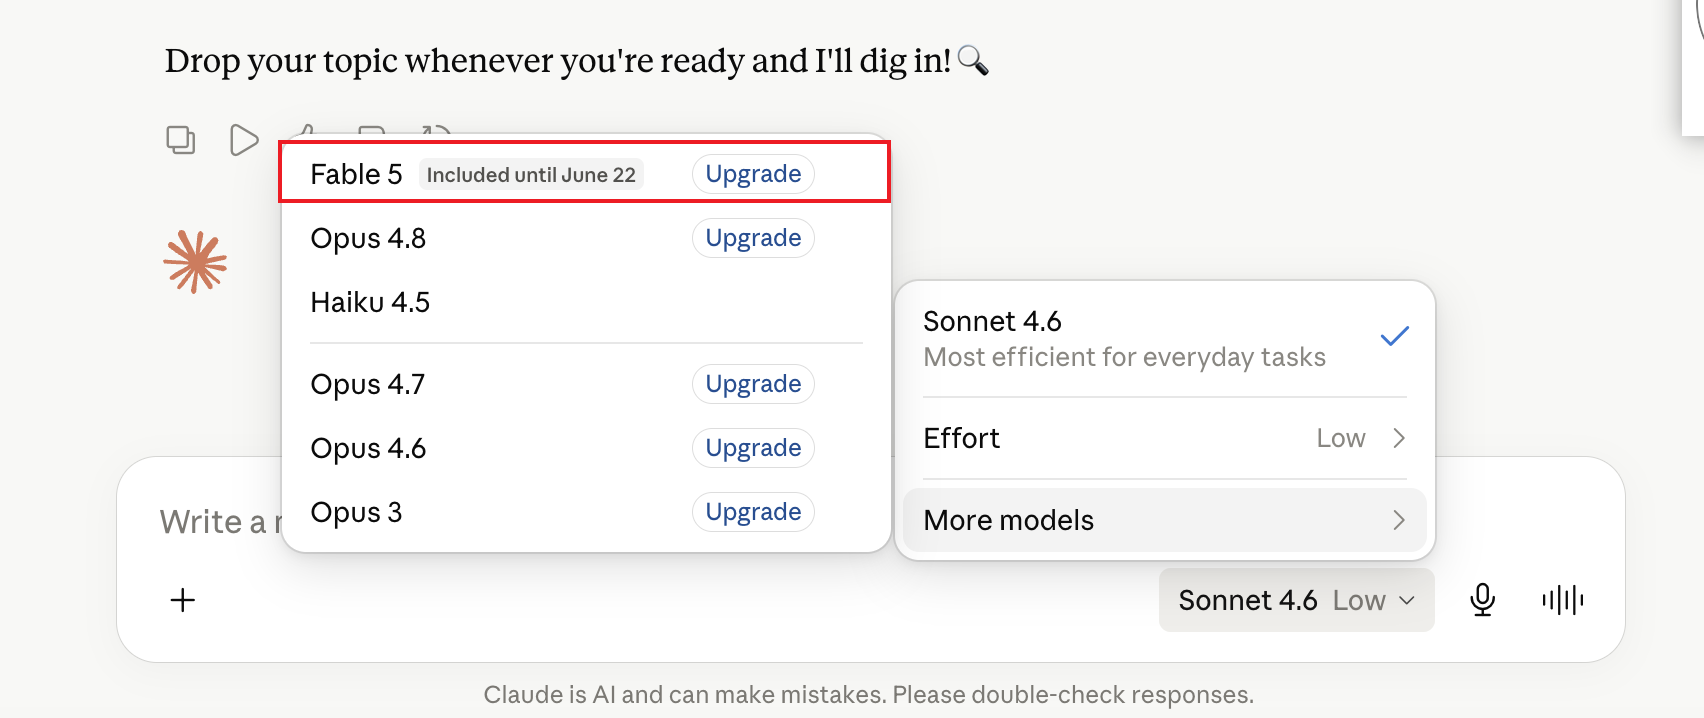
Anthropic把之前封锁的、只给美国政府和少数机构用的全球最强AI:Claude Mythos,以"Claude Fable 5"的名字正式面向所有人开放了...
回顾一下Mythos有多离谱?!数周内自主挖出数千个零日漏洞,找到OpenBSD里藏了27年的远程崩溃漏洞,找到FFmpeg里藏了16年、500万次自动化测试没检出来的漏洞。消息泄露当天网安股全线暴跌,后来连欧洲央行都被迫开紧急会议。
这么危险的东西,Anthropic花了三个月研究怎么让它能安全使用。今天终于搞定,并开放了。
在产品层面其实是发布了两个模型
Claude Fable 5:公开版,今天起面向所有用户/API 可用。
Claude Mythos 5:受限版,只给 Project Glasswing 合作伙伴和后续可信访问计划里的机构。
按模型底座:是一个。
官方说 Mythos 5 是 “the same underlying model as Fable 5”,只是某些领域的 safeguards 被移除。所以你可以理解成:
Fable 5 = Mythos 5 同底座 + 安全分类器 + 高风险请求回退到 Opus 4.8
Mythos 5 = 同底座 + 对可信机构开放部分高风险能力
但其实:95%的会话不会触发任何限制。也就是说95%的情况下,你用的就是Mythos本身。
只有涉及网络攻击、生化、蒸馏才会降级到Opus 4.8回答。注意,是降级回答,不是拒绝你。这个设计还挺不错的。
硬实力方面:Stripe拿5000万行代码库实测,一天干完原本两个月的迁移工作。
纯视觉通关宝可梦火红,不需要任何辅助工具。
玩杀戮尖塔会自己写笔记优化策略,表现提升三倍。
任务越复杂越长期,优势越明显,这一点对Agent场景是质的飞跃。
定价10/Minput,50/M output,比Mythos Preview砍了一半还多。
6月22日前Pro/Max/Team用户免费用。卧槽。。不敢充啊,怕被封..
6 月 23 日之后需要 usage credits,未来容量允许后再恢复为订阅制。
对Codex+GPT-5.5有没有冲击?我觉得短期不会取代,但长任务能力、SOTA级视觉、自我记忆迭代这三个点,太强了。
大概率会逼OpenAI加速出GPT-6。加油啊OpenAI,干翻Claude
我感觉以后想用最强模型可能不是花钱就行,还需要能通过审核。
AI竞争的下一个维度,不只是比谁强,还要能让最强的东西安全地被所有人用上。
不然AI真的可能会失控..
1 00