即刻App年轻人的同好社区
下载
Anthropic 关于 Agent Memory 的文章写得非常精彩,强烈推荐大家读一下。
我啃了一周了,还没有彻底啃完,先阶段性总结一下我的理解。同样看过这篇文章,或者正在研究 Agent Memory 的同学,咱们可以在评论区交流。
这里面有两个核心的认知。
第一,Memory 这件事,最大的难点是判断什么样的信息应该写入记忆。
Anthropic 认为,这种判断最好更多地交给模型自己完成,而不是完全依赖外层 Harness 预先设置好的规则。
他们做了几组实验,发现模型越聪明,通常就越擅长判断哪些信息值得记住,也更善于把过去的经验转化为未来能够复用的规则。
所以,同样一套记忆系统,在不同模型手里,效果可能差别很大。
第二,人脑的记忆机制确实非常精妙,Anthropic 也在尝试借鉴人脑的记忆机制,来设计 Agent Memory。
大家可以想一下,我们在日常生活中,其实一直在不断形成新的记忆,同时又在不断遗忘。
人脑的海马体在记忆形成过程中发挥着重要作用,可以帮助我们快速记录当下的经历。但人脑又不会把所有经历都原封不动地保存下来。
在睡眠或者安静休息的时候,大脑也没有停止工作。
海马体会重新激活我们之前经历过的一些神经活动模式,这个过程叫记忆回放(Memory Replay)。它会把近期经历中的部分信息,逐渐整合进更加稳定的长期记忆中。
Anthropic 就借鉴了这个思路,给 Agent Memory 引入了一套叫 Dreaming 的机制,直译过来就是“做梦”。
当然,Agent 不需要像人一样睡觉。这里的 Dreaming,指的是 Agent 可以利用空闲时间,重新整理过去的对话和任务记录,把有价值的信息放到记忆系统中。
因为记忆这个词比较宽泛,很多人还会把它和知识库混淆。我们下个定义,记忆是指模型从过去的经历中获得,并且能够跨 Session 保留的知识,而且 Agent 预判这些知识未来大概率还会再用到。
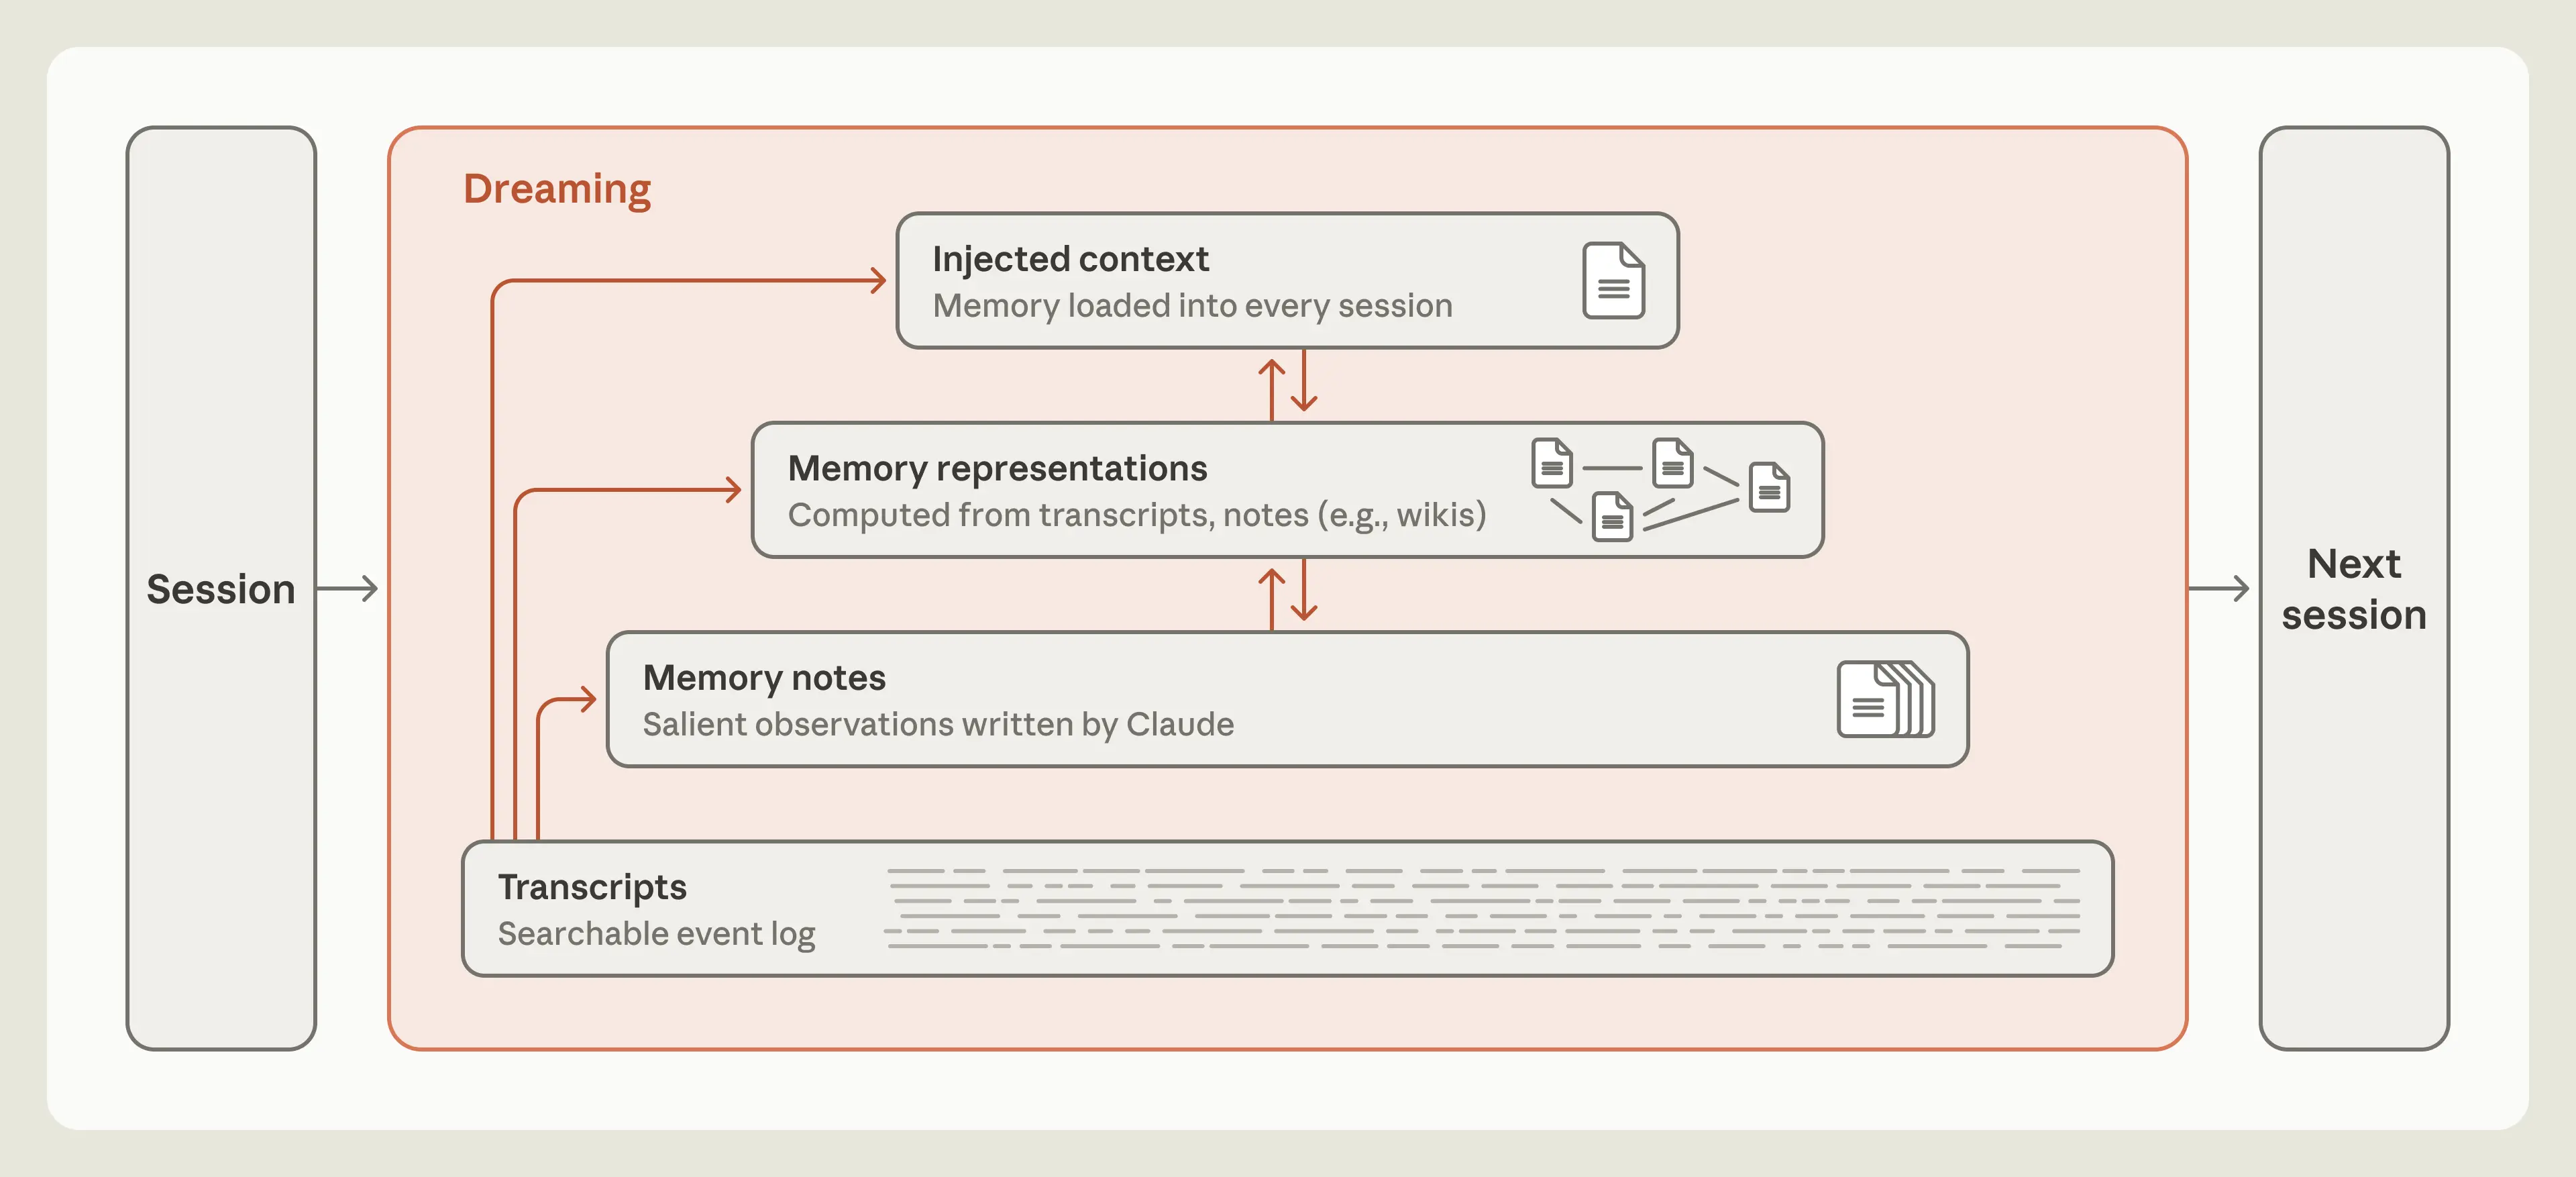
下面这张图是 Anthropic 设计的 Agent Memory 架构图。
图的最左边是 Session,代表 Agent 之前的一次会话。最右边是 Next session,代表后续开启的新会话。中间浅红色的区域就是 Dreaming,它可以在两次会话之间,利用过去留下的记录整理和维护记忆。
大家注意看中间的记忆结构,从下往上,一共分成四层。
第一层,Transcripts,也就是原始日志。比如我和 Claude 讨论一篇文章怎么写,从最开始的选题,到修改正文,再到最后确定标题,整个对话和任务执行过程都会被记录下来。
按理说,计算机可以保存大量历史记录,为什么还需要单独设计记忆呢?有需要的时候再搜索不就行了吗?
不是的。原始记录往往非常冗长,里面还有大量没有长期价值的信息。如果每次都重新搜索、分析这些记录,成本就会很高。
所以就有了第二层 Memory Notes,也就是记忆笔记。这玩意我们不陌生啊,几乎目前所有的 Agent 的记忆机制都会有 Memory Notes。
还是拿写文章来举例子。比如我在修改文章的时候,反复告诉 Claude,自己不喜欢大词,希望语言更加通俗自然。Claude 就可以判断,这些信息未来可能还会用到,于是主动把它们整理到 Memory Notes 中。比如 OpenClaw 的 Memory Notes 就是 MD 文件。
这样,下次再帮我写文章的时候,Claude 就可以通过记忆找到我的写作偏好。
但这里又会出现一个问题。随着 Agent 使用时间增长,记忆规模会越来越庞大。而且,这些记忆可能涉及不同的事情,有的是我的体重,有的是我的饮食偏好,有的是我孩子的学习情况。
Agent 不可能在每次新 Session 开始时,就把所有历史记忆全部加载进上下文。
当然,也可以通过搜索的方式来查找记忆。但问题是,模型未必知道应该搜索什么,而且很多信息分散在不同的记忆文件中,彼此之间还有关联。
即使搜索到了,也需要重新梳理这些信息之间的关系。随着记忆越来越多,这个过程的成本也会越来越高。
所以,Anthropic 又设计了第三层,Memory representations,记忆表示。
Memory representations 具体的实现方式其实很简单,就是 Wiki(更准确的说,Wiki 是其中一种实现方式)。大家可以把它理解成一套由 AI 自动整理和维护的知识库。
比如,Claude 可以把我过去积累的记忆,按照写作风格、标题偏好、研究过的 AI 公司、历史文章等不同主题,整理成 Wiki 页面。
这样一来,原本散落在大量记忆文件中的信息,就有了一个相互关联的知识结构。
以后我再让 Claude 写一篇关于 Memory 主题的文章,它就可以先找到相关的 Wiki 页面,了解我过去研究过哪些内容,再根据需要查找具体的记忆笔记或者原始记录。
这比每次都从大量历史文件里重新寻找信息,要方便得多。
在这个基础上,还有第四层,叫 Injected context。
Dreaming 会把特别重要的记忆提升到这一层,由 Harness 在新 Session 开始时自动加载。这样,Claude 不需要主动搜索或者查找 Wiki,就能直接看到这些信息。
但 Context 是非常宝贵的,不可能把大量记忆都加载进去。
所以,这一层除了保存少量重要记忆,还会放一些记忆索引,告诉 Claude 已经记住了哪些信息,以及更详细的内容保存在哪里。
比如,现在 Claude Code 每次新 Session 开始时,只会自动加载 MEMORY.md 的前 200 行或 25 KB。这部分内容就相当于一份记忆目录,Claude 需要更多信息时,再去读取对应的记忆文件。
理解了这四层记忆的结构,我们再接着讲 Dreaming。
简单来说,Dreaming 就是利用 Agent 空闲的时间,重新整理过去 Session 留下的原始记录,更新和维护整个记忆系统。
举个很简单的例子。
Agent 在平时的会话中,可能直接把一些重要信息写进 Memory Notes,但当时记录的信息未必准确。比如,我告诉 Claude,自己喜欢红色。它判断这是一条重要信息,于是保存到了记忆里。
但是过了一段时间,我在另外一个 Session 中又提到,自己现在更喜欢绿色了。如果之前的记忆没有及时更新,就可能出现前后不一致的问题。
怎么办呢?
Dreaming 会检查不同 Session 的原始记录,然后更新 Memory Notes。如果没办法确认,也可以先把这条信息标记为存疑,避免后面继续使用错误的记忆。
还有刚才提到的 Wiki 的整理和更新,以及判断哪些记忆特别重要,应该提升到 Injected context,这些都是在 Dreaming 阶段干的。
挺有意思,Personal Agent 最近刚刚热起来啊,还远不成熟。好像大家讨论 Personal Agent 时,比较关注 Context、隐私和安全这些问题。但我感觉,长期记忆应该是做好 Personal Agent 关键中的关键。
反正最近我使用的几个 Personal Agent 产品,尽不如人意的地方几乎都和记忆相关。
www.anthropic.com
我啃了一周了,还没有彻底啃完,先阶段性总结一下我的理解。同样看过这篇文章,或者正在研究 Agent Memory 的同学,咱们可以在评论区交流。
这里面有两个核心的认知。
第一,Memory 这件事,最大的难点是判断什么样的信息应该写入记忆。
Anthropic 认为,这种判断最好更多地交给模型自己完成,而不是完全依赖外层 Harness 预先设置好的规则。
他们做了几组实验,发现模型越聪明,通常就越擅长判断哪些信息值得记住,也更善于把过去的经验转化为未来能够复用的规则。
所以,同样一套记忆系统,在不同模型手里,效果可能差别很大。
第二,人脑的记忆机制确实非常精妙,Anthropic 也在尝试借鉴人脑的记忆机制,来设计 Agent Memory。
大家可以想一下,我们在日常生活中,其实一直在不断形成新的记忆,同时又在不断遗忘。
人脑的海马体在记忆形成过程中发挥着重要作用,可以帮助我们快速记录当下的经历。但人脑又不会把所有经历都原封不动地保存下来。
在睡眠或者安静休息的时候,大脑也没有停止工作。
海马体会重新激活我们之前经历过的一些神经活动模式,这个过程叫记忆回放(Memory Replay)。它会把近期经历中的部分信息,逐渐整合进更加稳定的长期记忆中。
Anthropic 就借鉴了这个思路,给 Agent Memory 引入了一套叫 Dreaming 的机制,直译过来就是“做梦”。
当然,Agent 不需要像人一样睡觉。这里的 Dreaming,指的是 Agent 可以利用空闲时间,重新整理过去的对话和任务记录,把有价值的信息放到记忆系统中。
因为记忆这个词比较宽泛,很多人还会把它和知识库混淆。我们下个定义,记忆是指模型从过去的经历中获得,并且能够跨 Session 保留的知识,而且 Agent 预判这些知识未来大概率还会再用到。
下面这张图是 Anthropic 设计的 Agent Memory 架构图。
图的最左边是 Session,代表 Agent 之前的一次会话。最右边是 Next session,代表后续开启的新会话。中间浅红色的区域就是 Dreaming,它可以在两次会话之间,利用过去留下的记录整理和维护记忆。
大家注意看中间的记忆结构,从下往上,一共分成四层。
第一层,Transcripts,也就是原始日志。比如我和 Claude 讨论一篇文章怎么写,从最开始的选题,到修改正文,再到最后确定标题,整个对话和任务执行过程都会被记录下来。
按理说,计算机可以保存大量历史记录,为什么还需要单独设计记忆呢?有需要的时候再搜索不就行了吗?
不是的。原始记录往往非常冗长,里面还有大量没有长期价值的信息。如果每次都重新搜索、分析这些记录,成本就会很高。
所以就有了第二层 Memory Notes,也就是记忆笔记。这玩意我们不陌生啊,几乎目前所有的 Agent 的记忆机制都会有 Memory Notes。
还是拿写文章来举例子。比如我在修改文章的时候,反复告诉 Claude,自己不喜欢大词,希望语言更加通俗自然。Claude 就可以判断,这些信息未来可能还会用到,于是主动把它们整理到 Memory Notes 中。比如 OpenClaw 的 Memory Notes 就是 MD 文件。
这样,下次再帮我写文章的时候,Claude 就可以通过记忆找到我的写作偏好。
但这里又会出现一个问题。随着 Agent 使用时间增长,记忆规模会越来越庞大。而且,这些记忆可能涉及不同的事情,有的是我的体重,有的是我的饮食偏好,有的是我孩子的学习情况。
Agent 不可能在每次新 Session 开始时,就把所有历史记忆全部加载进上下文。
当然,也可以通过搜索的方式来查找记忆。但问题是,模型未必知道应该搜索什么,而且很多信息分散在不同的记忆文件中,彼此之间还有关联。
即使搜索到了,也需要重新梳理这些信息之间的关系。随着记忆越来越多,这个过程的成本也会越来越高。
所以,Anthropic 又设计了第三层,Memory representations,记忆表示。
Memory representations 具体的实现方式其实很简单,就是 Wiki(更准确的说,Wiki 是其中一种实现方式)。大家可以把它理解成一套由 AI 自动整理和维护的知识库。
比如,Claude 可以把我过去积累的记忆,按照写作风格、标题偏好、研究过的 AI 公司、历史文章等不同主题,整理成 Wiki 页面。
这样一来,原本散落在大量记忆文件中的信息,就有了一个相互关联的知识结构。
以后我再让 Claude 写一篇关于 Memory 主题的文章,它就可以先找到相关的 Wiki 页面,了解我过去研究过哪些内容,再根据需要查找具体的记忆笔记或者原始记录。
这比每次都从大量历史文件里重新寻找信息,要方便得多。
在这个基础上,还有第四层,叫 Injected context。
Dreaming 会把特别重要的记忆提升到这一层,由 Harness 在新 Session 开始时自动加载。这样,Claude 不需要主动搜索或者查找 Wiki,就能直接看到这些信息。
但 Context 是非常宝贵的,不可能把大量记忆都加载进去。
所以,这一层除了保存少量重要记忆,还会放一些记忆索引,告诉 Claude 已经记住了哪些信息,以及更详细的内容保存在哪里。
比如,现在 Claude Code 每次新 Session 开始时,只会自动加载 MEMORY.md 的前 200 行或 25 KB。这部分内容就相当于一份记忆目录,Claude 需要更多信息时,再去读取对应的记忆文件。
理解了这四层记忆的结构,我们再接着讲 Dreaming。
简单来说,Dreaming 就是利用 Agent 空闲的时间,重新整理过去 Session 留下的原始记录,更新和维护整个记忆系统。
举个很简单的例子。
Agent 在平时的会话中,可能直接把一些重要信息写进 Memory Notes,但当时记录的信息未必准确。比如,我告诉 Claude,自己喜欢红色。它判断这是一条重要信息,于是保存到了记忆里。
但是过了一段时间,我在另外一个 Session 中又提到,自己现在更喜欢绿色了。如果之前的记忆没有及时更新,就可能出现前后不一致的问题。
怎么办呢?
Dreaming 会检查不同 Session 的原始记录,然后更新 Memory Notes。如果没办法确认,也可以先把这条信息标记为存疑,避免后面继续使用错误的记忆。
还有刚才提到的 Wiki 的整理和更新,以及判断哪些记忆特别重要,应该提升到 Injected context,这些都是在 Dreaming 阶段干的。
挺有意思,Personal Agent 最近刚刚热起来啊,还远不成熟。好像大家讨论 Personal Agent 时,比较关注 Context、隐私和安全这些问题。但我感觉,长期记忆应该是做好 Personal Agent 关键中的关键。
反正最近我使用的几个 Personal Agent 产品,尽不如人意的地方几乎都和记忆相关。
www.anthropic.com
34 619
来自圈子
AI探索站
121316人已经加入