即刻App年轻人的同好社区
下载
强烈推荐大家听下 Jev 创始人的最新分享。
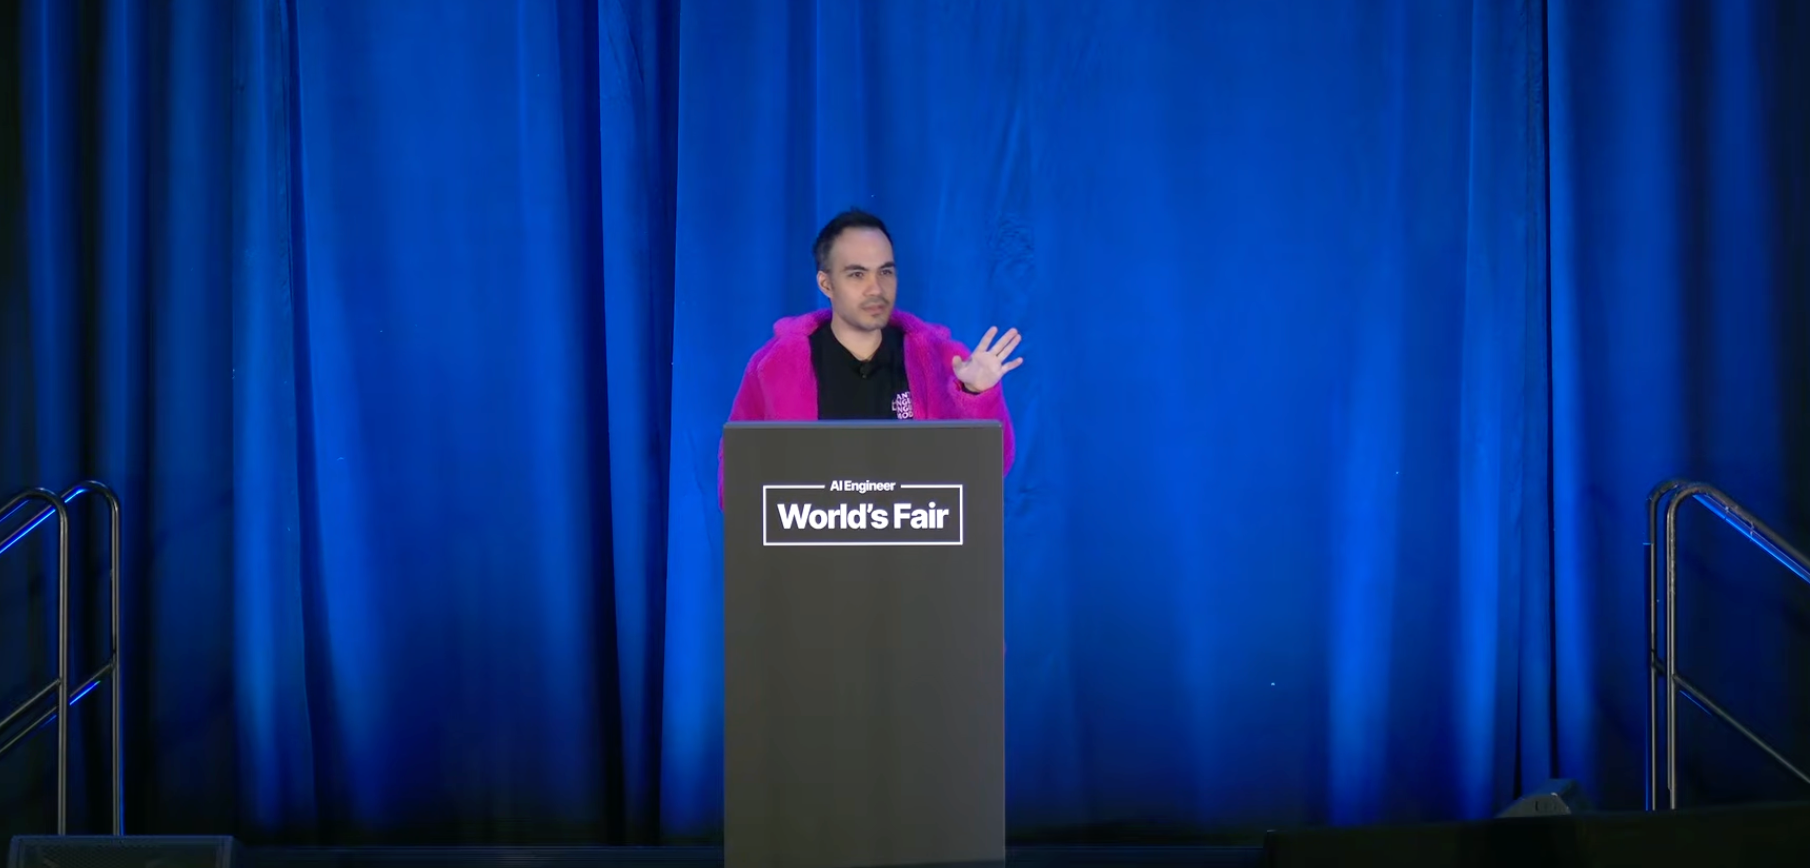
太精彩了。刚刚听完最近大火的模型 Jev 创始人 Diogo Almeida 的分享,真的是醍醐灌顶啊。不管 Jev 这个模型能不能成,但我觉得,它至少给目前的 LLM 行业一个新的思考问题的角度。
Diogo Almeida 这哥们以前是 OpenAI 的早期团队成员,参与过 ChatGPT、GPT-4、InstructGPT 和 RLHF 等工作。观点非常有见地,强烈推荐大家看看。我写下我的笔记。
www.youtube.com
我觉得,他的整场分享都在回答一个扎心的问题:AI 已经这么强了,为什么现实中那么多看起来简单得多的工作,我们还是不敢放心交给它自动完成?
比如用户给客服发了一句话,说这个产品体验特别糟糕,他很失望。这种情况到底要不要给用户退款?目前绝大多数的软件当中,仍然需要客服人工确认。
我天,模型都能解决很复杂的数学题了,为什么还不能放心地让它自己处理一次客服退款?
Almeida 觉得,归根结底还是 Assistance 和 Automation 这两类任务优化的目标大相径庭。
Claude Code、Codex 这样的产品,本质上依然是 Assistance。它们的目标是要理解人的意图,并给出让人满意的结果。
但客服后台、财务审核、业务运营这类自动化任务完全不同。它们真正理想的状态,是系统自己在服务器里长期运行,大部分时间根本不需要有人盯着。
一个是 Assistance。一个是 Automation。两条不同的道路。今天的大模型在 Assistance 上已经非常强,但到了真正的 Automation,我们其实还处在很早期。
要理解这个问题,我们还得再往回倒腾到大模型的原理。
今天我们用到的大模型,并不是 Pre-training 完成之后就直接拿来用。
Pre-training 只是让模型学到大量知识和能力。接下来还要经过 Post-training,也就是后训练。后训练是在已有能力的基础上,继续把模型训练成一个真正可用的产品。
过去几年,RLHF 就是 Post-training 里非常重要的方法之一。
简单理解,RLHF 做的事情就是先让模型生成不同回答,让人类判断哪个更好,再根据这些反馈继续训练模型。
所以它的优化目标,从一开始就和 Human Preference 有直接的关系。
这也解释了为什么今天的 AI 总需要 Human in the Loop。因为在训练模型的时候,我们本来就在围绕 Human Preference 优化它。
模型学习的是,面对一个人时,怎样给出更符合人类偏好的回答。这套方法非常适合训练 Chatbot,也很适合 Agent。
但 Automation 需要解决另外的问题。当人根本不在场的时候,模型还得能够做出可靠的判断。
或者这么说吧,今天模型的一部分幻觉问题,也和这种训练目标有关。
如果 Reward 很大程度来自人类偏好,那么当模型不知道答案的时候,给出一个自信、流畅、听起来靠谱的回答,有时候比直接说自己不知道更容易得到好的反馈。
举一个很好玩的例子。
有人给 ChatGPT 发了一段放屁音效,然后告诉它这是自己创作的音乐,让 ChatGPT 评价一下。
ChatGPT 真的一本正经开始分析这段音乐的氛围。
从一个聊天产品的角度,这甚至很好理解。用户既然希望讨论自己的音乐,模型就尽量顺着这个上下文继续聊。
但如果同样的行为进入自动化系统,问题就大了。比如模型需要判断这个客户该不该退款,这份合同有没有风险,这笔交易要不要放行。
这时候我们真正需要的,是模型知道自己到底有多大把握。它知道的时候可以判断,不知道的时候也应该知道自己不知道。聊天的时候,顺着用户说,最多是体验问题。一旦模型开始替企业做决定,这种倾向就可能直接变成风险。
所以真正的 Automation 对模型的要求是,必须稳定、可靠,而且要知道自己的判断什么时候值得相信。
把握足够高的话,可以自己执行。把握不够,就应该继续找信息,或者把决定权交给人。
大家想想,过去几年,大模型的能力进步这么快,但 SaaS 的基本形态其实从 2019 年到现在都没有发生太大变化。或者也不是 SaaS,像我们用的美团啊这类的产品,仍然没有什么本质变化。
为什么?
因为如果 AI 最擅长的是 Assistance,那它进入软件之后最自然的形态,当然也是给原来的软件加一个 Assistant。
Claude Code 这样的工具只是帮助程序员更快的写代码,但软件本身能够完成的事情,并没有出现同等程度的变化。我们真正期待的是,软件本身能够处理更多过去必须由人完成的工作。
传统软件其实已经自动化了很多事情。只要规则足够明确,代码就可以稳定、准确地反复执行,根本不需要人一直盯着。
问题是,现实世界里还有大量工作没法写成这么清楚的规则。比如一个订单看起来有点异常,到底要不要拦截?一个客户申请退款,到底该不该通过?一个供应商看起来有风险,到底要不要继续合作?
过去的软件很难处理这种带有判断性质的问题,所以流程走到这里,往往就只能停下来等人处理。
可能有人会问,用现在的 LLM 可以处理这样的问题吗?可以,但仍然不放心。大模型有幻觉,而且慢。总之,不是那么可靠。
如果有一个模型能够可靠完成这些判断,那也许软件就会变得更加智能。
新的疑惑又来了。难道是因为今天的 LLM 还不够聪明,所以搞不定 Automation 的问题?
不是。现在,大模型的 Pre-training 已经非常成功,它把互联网里海量的知识压进模型,形成了一个非常强的通用智能底座。Intelligence 已经在那里了。
问题是,我们到底应该怎样把这些 Intelligence 拿出来用。通过 RLHF 这样的后训练方式,肯定不行。前面都已经讲了,RLHF 主要优化的是 Human Preference。它很适合把模型训练成一个好用的 Assistant,但不一定适合真正的 Automation。
那有没有另外一种后训练方式,直接让模型追求正确答案?
我知道,说到这里肯定有大聪明会举手说 RLVR。我在听分享的时候,也是这么想的。担心有同学不理解,我简单解释一下。RLHF 关心的是人类更喜欢哪个回答,RLVR 关心的是这个答案到底对不对,而且这个对错最好可以直接验证。
这俩都是目前后训练中的主流方法。
不行。RLVR 也不行。因为 RLVR 的核心仍然是纠正,或者更直接点,就是让模型怎么把可验证的任务做对。而真正的 Automation 需要模型给出可靠的决策。
比如模型判断一笔退款应该通过。如果它说自己有 95% 把握,那长期来看,这类 95% 把握的判断就应该真的大部分是对的。如果它其实只有 55% 把握,就不该装得像 95% 一样自信,更不应该直接自动执行。
所以,他们重新设计一套不同于 RLHF 和 RLVR 的技术栈,试图把 Pre-training 已经获得的这些 Intelligence,变成一种软件可以放心使用的能力。
这就是 Jev 的来时路。
太精彩了。刚刚听完最近大火的模型 Jev 创始人 Diogo Almeida 的分享,真的是醍醐灌顶啊。不管 Jev 这个模型能不能成,但我觉得,它至少给目前的 LLM 行业一个新的思考问题的角度。
Diogo Almeida 这哥们以前是 OpenAI 的早期团队成员,参与过 ChatGPT、GPT-4、InstructGPT 和 RLHF 等工作。观点非常有见地,强烈推荐大家看看。我写下我的笔记。
www.youtube.com
我觉得,他的整场分享都在回答一个扎心的问题:AI 已经这么强了,为什么现实中那么多看起来简单得多的工作,我们还是不敢放心交给它自动完成?
比如用户给客服发了一句话,说这个产品体验特别糟糕,他很失望。这种情况到底要不要给用户退款?目前绝大多数的软件当中,仍然需要客服人工确认。
我天,模型都能解决很复杂的数学题了,为什么还不能放心地让它自己处理一次客服退款?
Almeida 觉得,归根结底还是 Assistance 和 Automation 这两类任务优化的目标大相径庭。
Claude Code、Codex 这样的产品,本质上依然是 Assistance。它们的目标是要理解人的意图,并给出让人满意的结果。
但客服后台、财务审核、业务运营这类自动化任务完全不同。它们真正理想的状态,是系统自己在服务器里长期运行,大部分时间根本不需要有人盯着。
一个是 Assistance。一个是 Automation。两条不同的道路。今天的大模型在 Assistance 上已经非常强,但到了真正的 Automation,我们其实还处在很早期。
要理解这个问题,我们还得再往回倒腾到大模型的原理。
今天我们用到的大模型,并不是 Pre-training 完成之后就直接拿来用。
Pre-training 只是让模型学到大量知识和能力。接下来还要经过 Post-training,也就是后训练。后训练是在已有能力的基础上,继续把模型训练成一个真正可用的产品。
过去几年,RLHF 就是 Post-training 里非常重要的方法之一。
简单理解,RLHF 做的事情就是先让模型生成不同回答,让人类判断哪个更好,再根据这些反馈继续训练模型。
所以它的优化目标,从一开始就和 Human Preference 有直接的关系。
这也解释了为什么今天的 AI 总需要 Human in the Loop。因为在训练模型的时候,我们本来就在围绕 Human Preference 优化它。
模型学习的是,面对一个人时,怎样给出更符合人类偏好的回答。这套方法非常适合训练 Chatbot,也很适合 Agent。
但 Automation 需要解决另外的问题。当人根本不在场的时候,模型还得能够做出可靠的判断。
或者这么说吧,今天模型的一部分幻觉问题,也和这种训练目标有关。
如果 Reward 很大程度来自人类偏好,那么当模型不知道答案的时候,给出一个自信、流畅、听起来靠谱的回答,有时候比直接说自己不知道更容易得到好的反馈。
举一个很好玩的例子。
有人给 ChatGPT 发了一段放屁音效,然后告诉它这是自己创作的音乐,让 ChatGPT 评价一下。
ChatGPT 真的一本正经开始分析这段音乐的氛围。
从一个聊天产品的角度,这甚至很好理解。用户既然希望讨论自己的音乐,模型就尽量顺着这个上下文继续聊。
但如果同样的行为进入自动化系统,问题就大了。比如模型需要判断这个客户该不该退款,这份合同有没有风险,这笔交易要不要放行。
这时候我们真正需要的,是模型知道自己到底有多大把握。它知道的时候可以判断,不知道的时候也应该知道自己不知道。聊天的时候,顺着用户说,最多是体验问题。一旦模型开始替企业做决定,这种倾向就可能直接变成风险。
所以真正的 Automation 对模型的要求是,必须稳定、可靠,而且要知道自己的判断什么时候值得相信。
把握足够高的话,可以自己执行。把握不够,就应该继续找信息,或者把决定权交给人。
大家想想,过去几年,大模型的能力进步这么快,但 SaaS 的基本形态其实从 2019 年到现在都没有发生太大变化。或者也不是 SaaS,像我们用的美团啊这类的产品,仍然没有什么本质变化。
为什么?
因为如果 AI 最擅长的是 Assistance,那它进入软件之后最自然的形态,当然也是给原来的软件加一个 Assistant。
Claude Code 这样的工具只是帮助程序员更快的写代码,但软件本身能够完成的事情,并没有出现同等程度的变化。我们真正期待的是,软件本身能够处理更多过去必须由人完成的工作。
传统软件其实已经自动化了很多事情。只要规则足够明确,代码就可以稳定、准确地反复执行,根本不需要人一直盯着。
问题是,现实世界里还有大量工作没法写成这么清楚的规则。比如一个订单看起来有点异常,到底要不要拦截?一个客户申请退款,到底该不该通过?一个供应商看起来有风险,到底要不要继续合作?
过去的软件很难处理这种带有判断性质的问题,所以流程走到这里,往往就只能停下来等人处理。
可能有人会问,用现在的 LLM 可以处理这样的问题吗?可以,但仍然不放心。大模型有幻觉,而且慢。总之,不是那么可靠。
如果有一个模型能够可靠完成这些判断,那也许软件就会变得更加智能。
新的疑惑又来了。难道是因为今天的 LLM 还不够聪明,所以搞不定 Automation 的问题?
不是。现在,大模型的 Pre-training 已经非常成功,它把互联网里海量的知识压进模型,形成了一个非常强的通用智能底座。Intelligence 已经在那里了。
问题是,我们到底应该怎样把这些 Intelligence 拿出来用。通过 RLHF 这样的后训练方式,肯定不行。前面都已经讲了,RLHF 主要优化的是 Human Preference。它很适合把模型训练成一个好用的 Assistant,但不一定适合真正的 Automation。
那有没有另外一种后训练方式,直接让模型追求正确答案?
我知道,说到这里肯定有大聪明会举手说 RLVR。我在听分享的时候,也是这么想的。担心有同学不理解,我简单解释一下。RLHF 关心的是人类更喜欢哪个回答,RLVR 关心的是这个答案到底对不对,而且这个对错最好可以直接验证。
这俩都是目前后训练中的主流方法。
不行。RLVR 也不行。因为 RLVR 的核心仍然是纠正,或者更直接点,就是让模型怎么把可验证的任务做对。而真正的 Automation 需要模型给出可靠的决策。
比如模型判断一笔退款应该通过。如果它说自己有 95% 把握,那长期来看,这类 95% 把握的判断就应该真的大部分是对的。如果它其实只有 55% 把握,就不该装得像 95% 一样自信,更不应该直接自动执行。
所以,他们重新设计一套不同于 RLHF 和 RLVR 的技术栈,试图把 Pre-training 已经获得的这些 Intelligence,变成一种软件可以放心使用的能力。
这就是 Jev 的来时路。
49 638
来自圈子
AI探索站
118926人已经加入