即刻App年轻人的同好社区
下载
Eval Moves Right——
从理解和照顾人的缺陷
到定义下一个值得被改变的 state
1. 长久以来,人对世界产生 impact 的方式是:
Context → Human → Action → State Change
人通过学习和吸收 context,将其转化为正确的 action,推动某个状态发生改变。
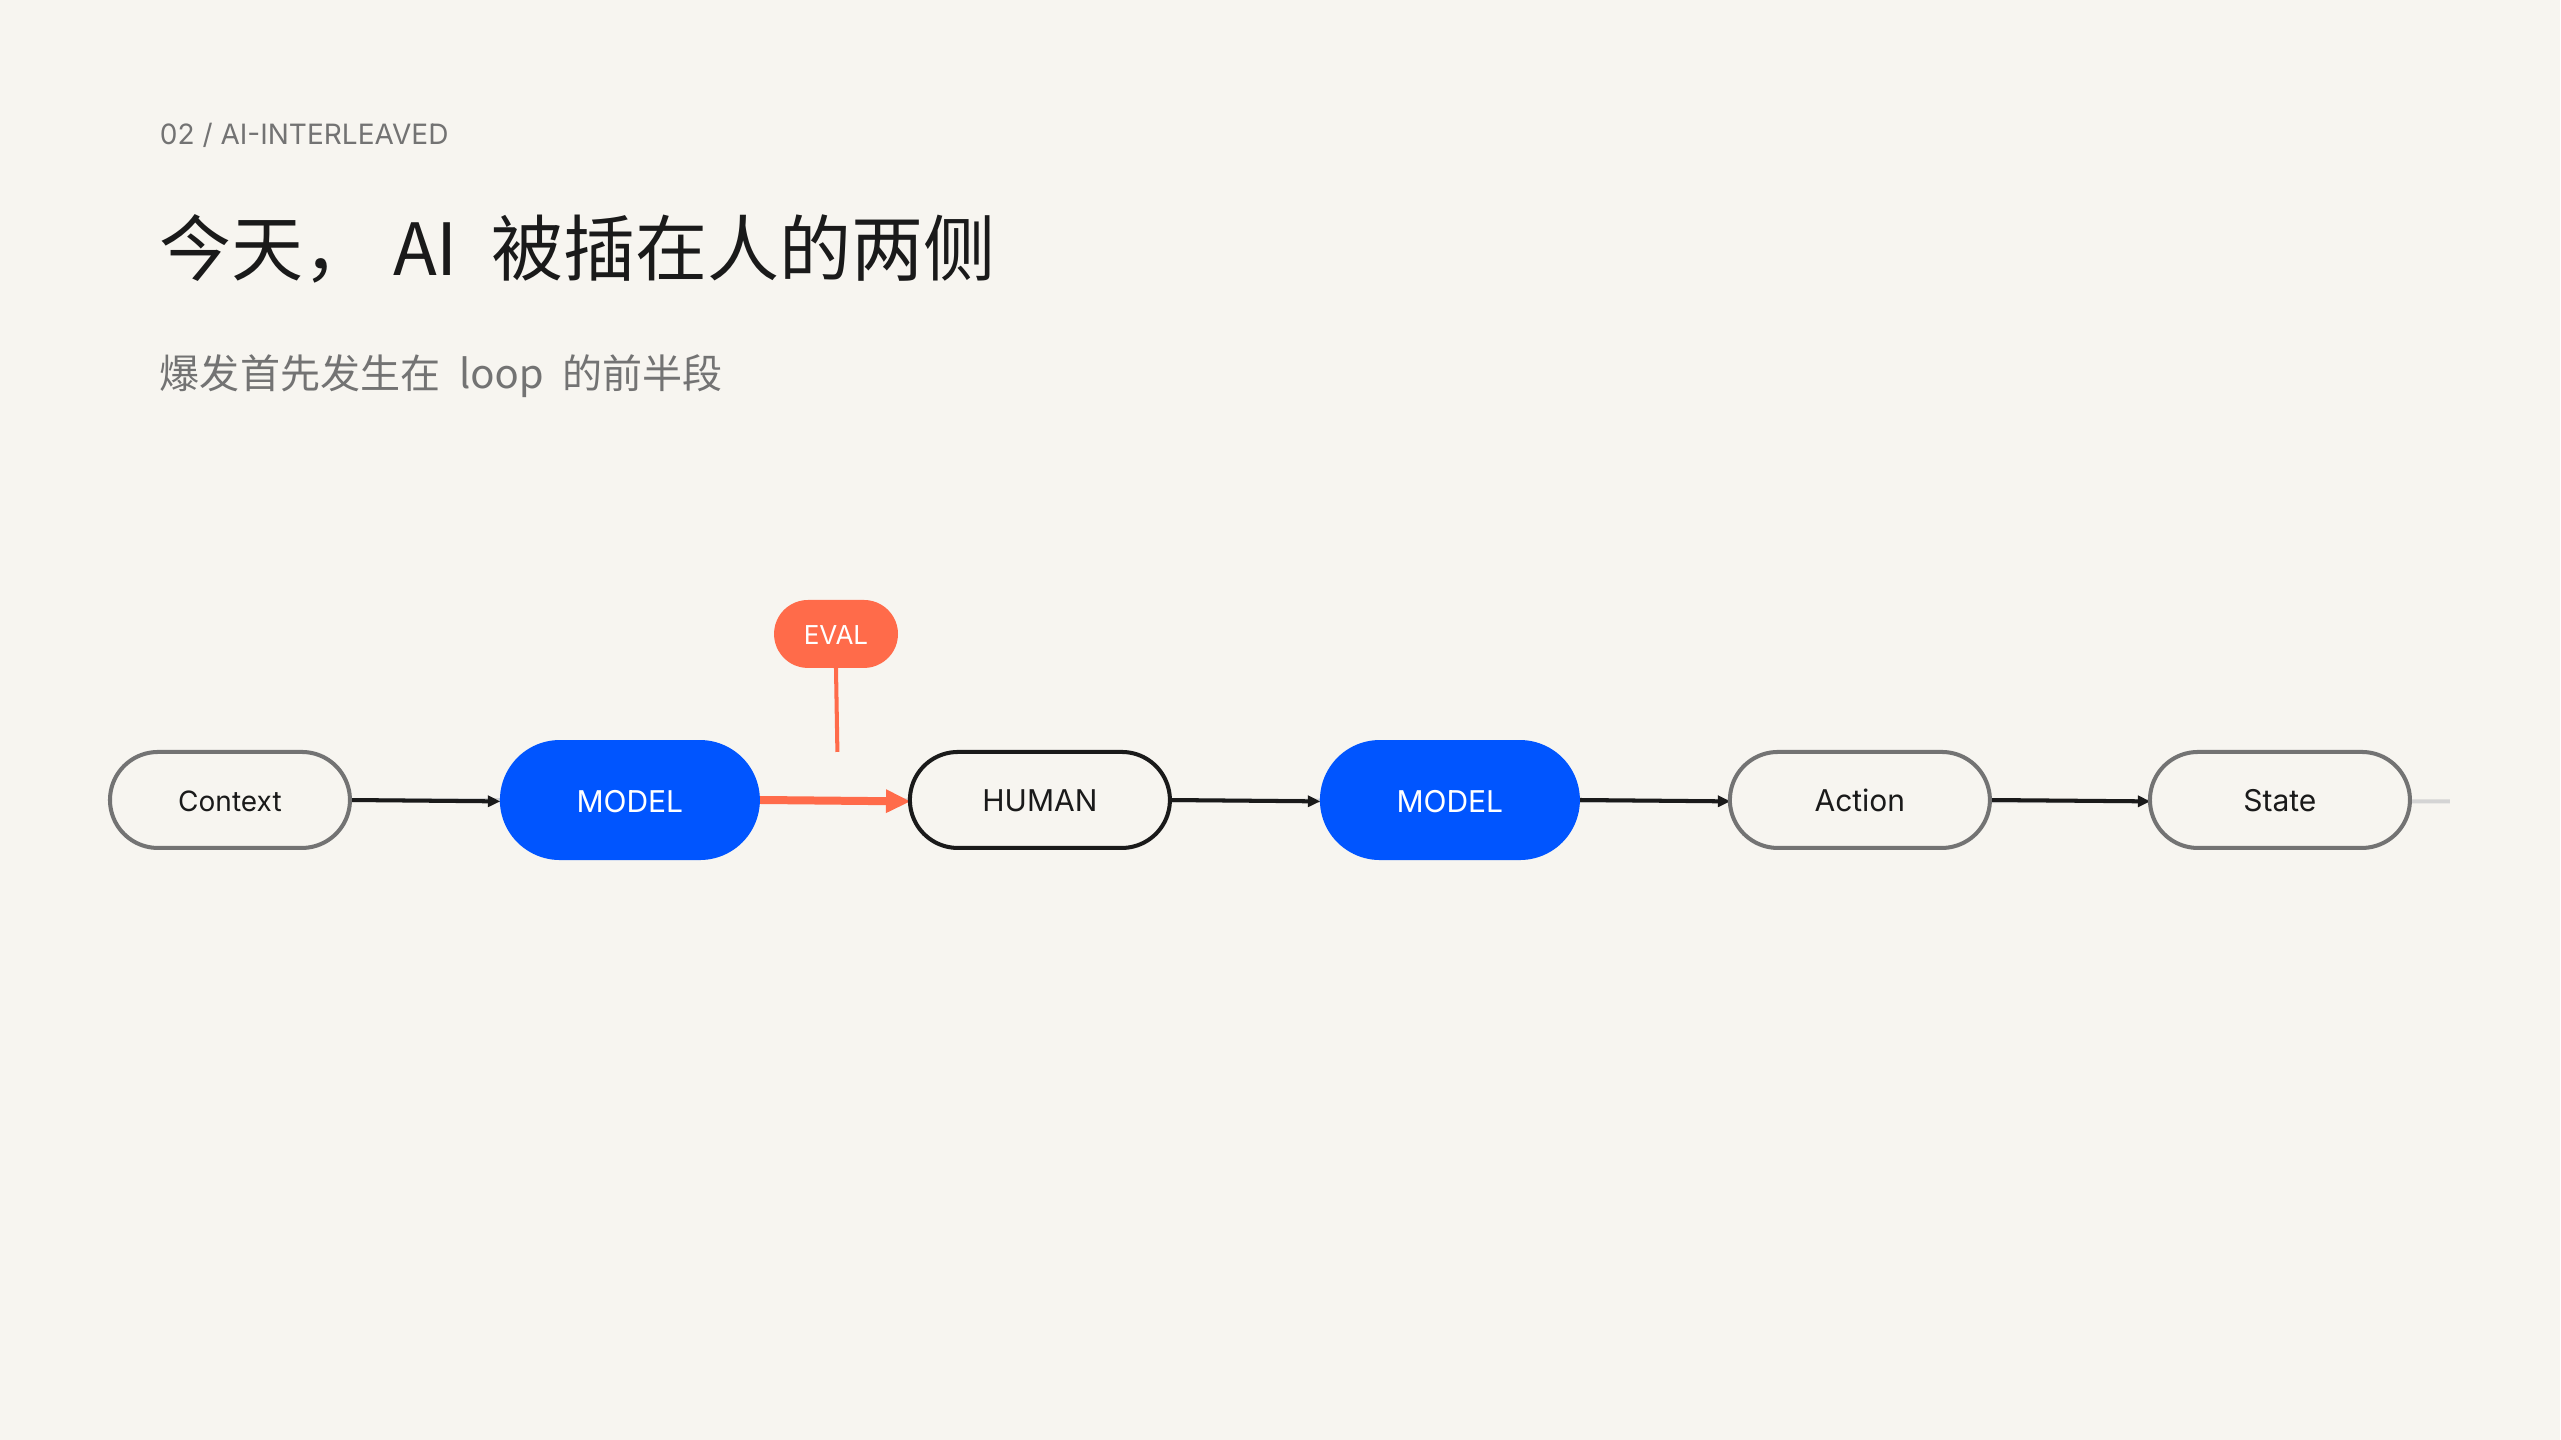
2. 当有了 AI,我们阶段性地变成了:
Context → Model → Human → Model → Action → State Change
这个阶段,AI 最先爆发的use case是调研报告、Office 三件套和 Website。它们大致覆盖了 loop 的前半部分:
Context → Model → Human
因为人获取 context 的带宽很低,所以报告需要更易读,Slides 需要更美观,前端需要更炫酷。也因此出现了Eval角色:它位于 Model → Human 之间,目标是理解和照顾人的“缺陷”,让模型的输出更容易被人理解、信任和使用。
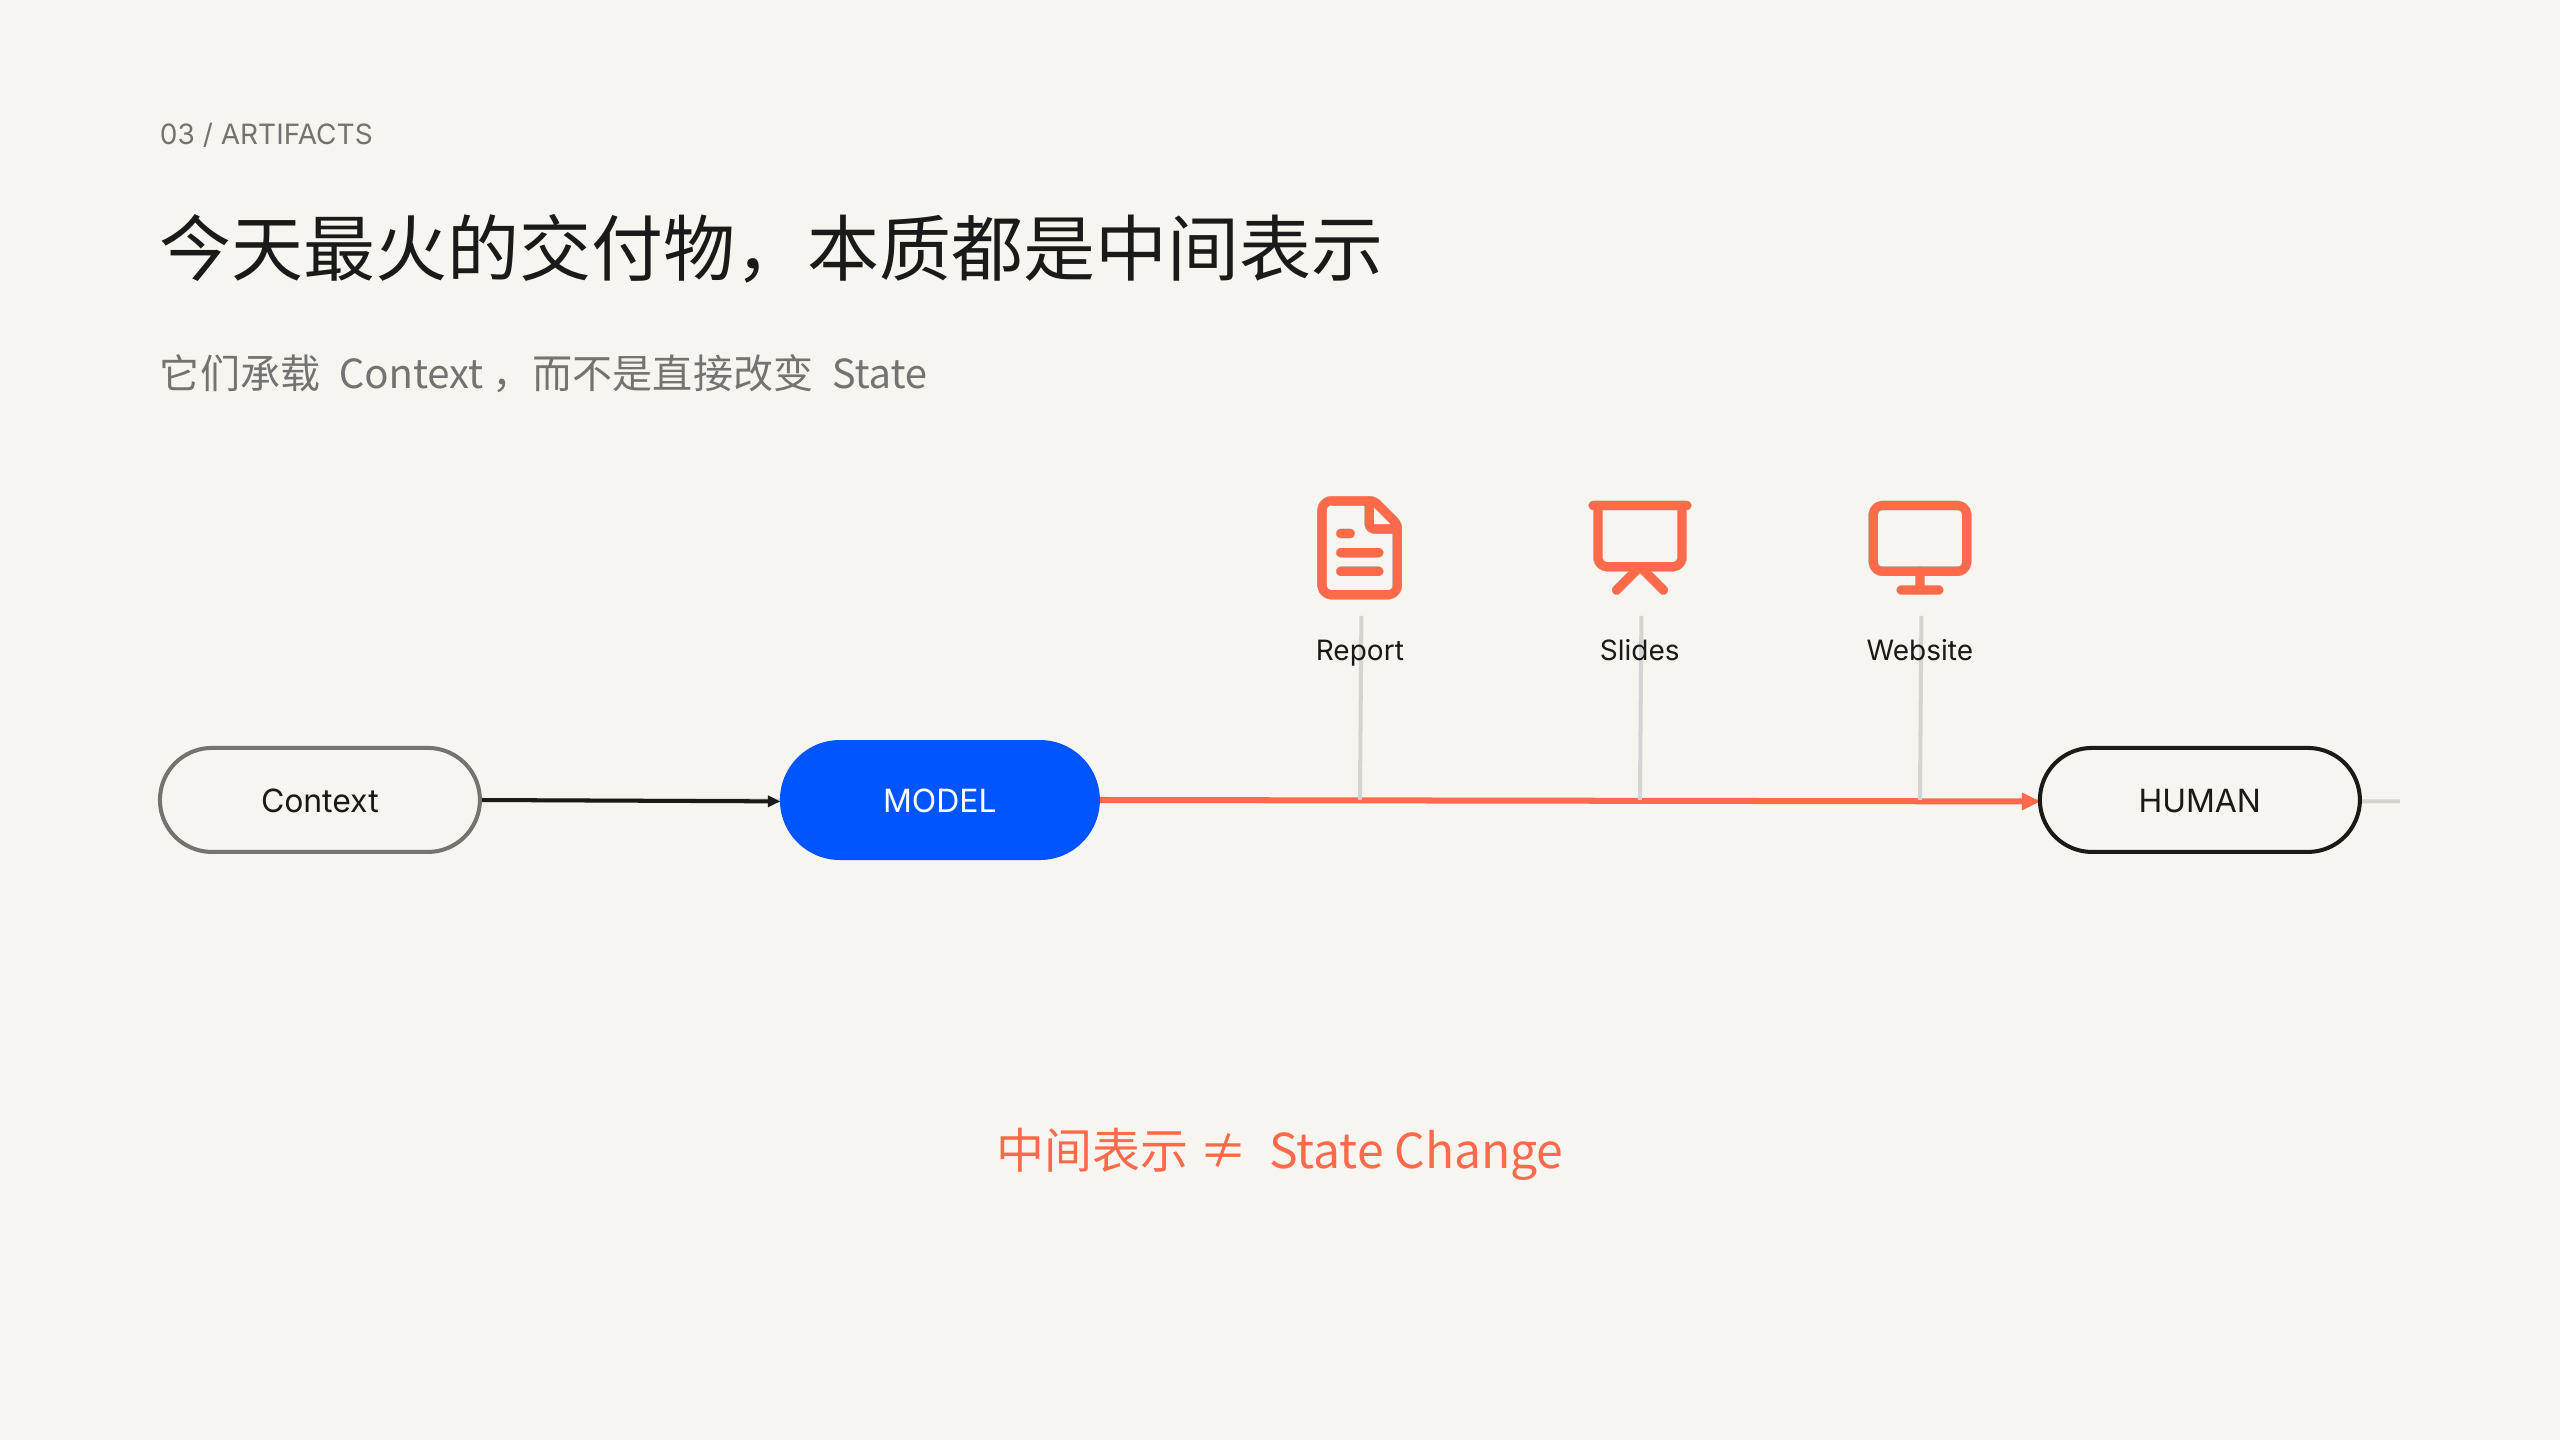
但这些今天被当作“交付物”的东西,其实都只是中间表示。它们本身通常不改变 State,只是作为 context 的载体,帮助另一个决策主体找到正确的 action。
3. Eval 会沿着 loop 向右移动
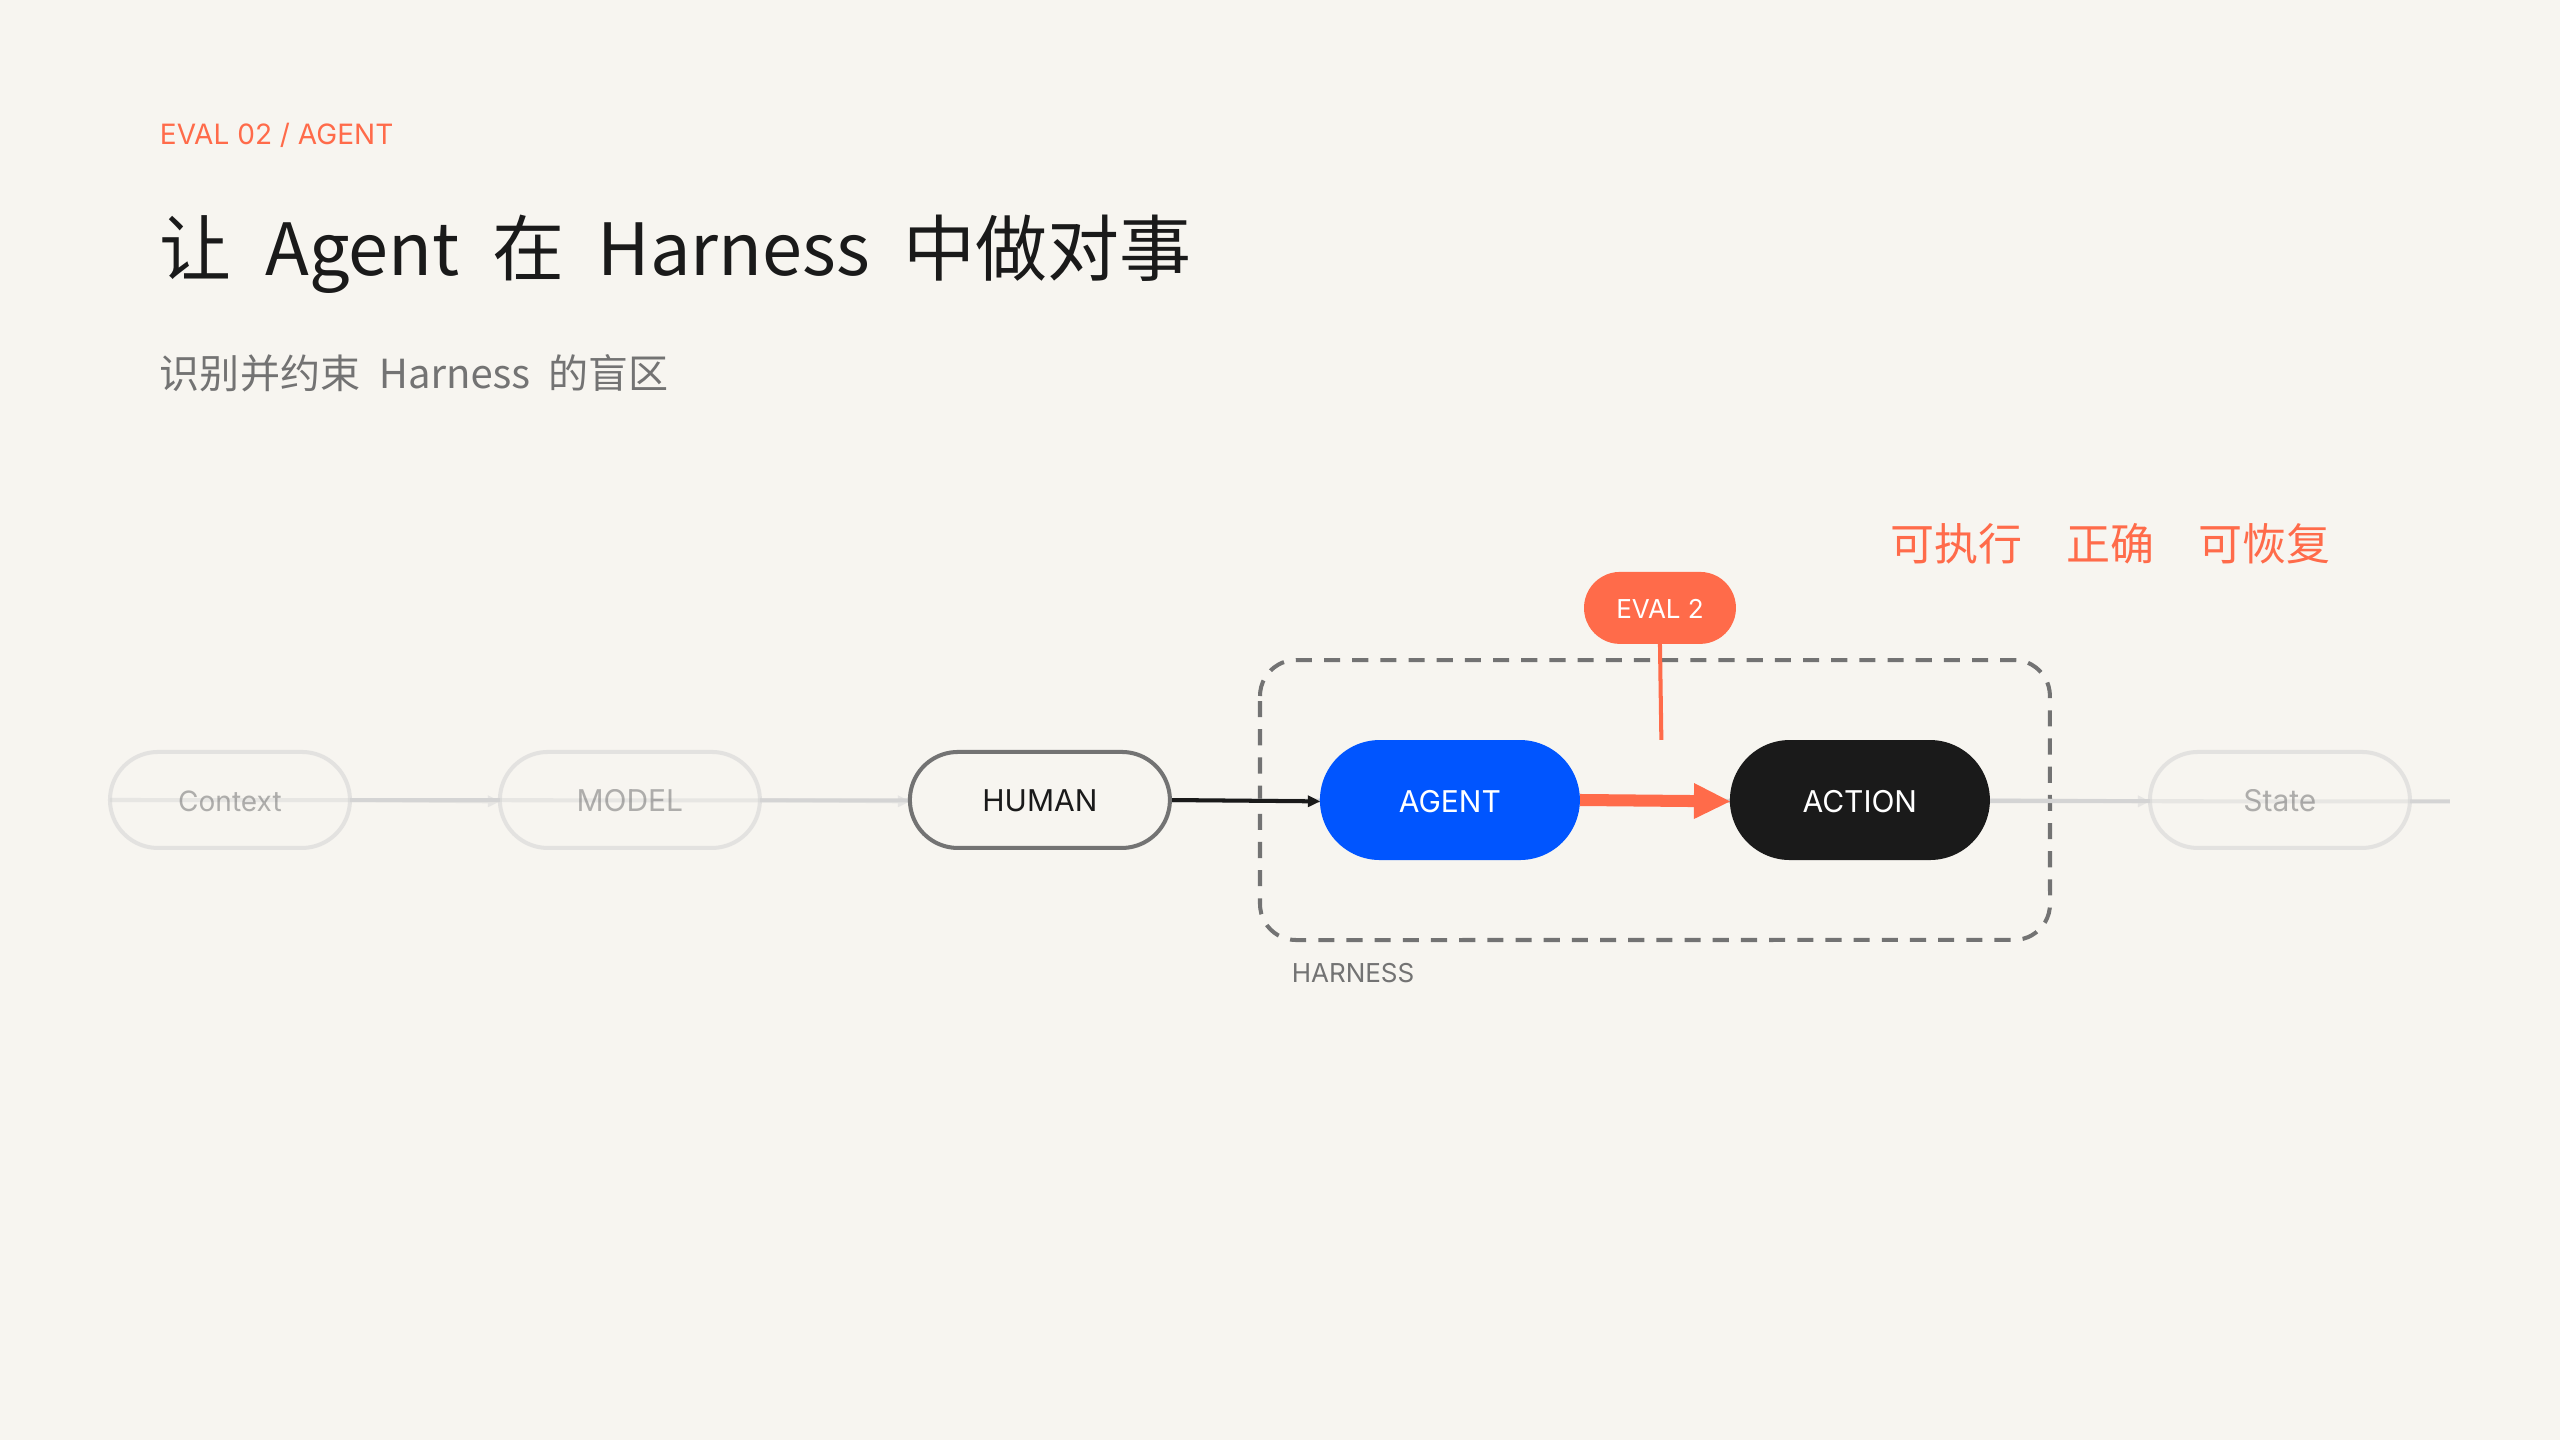
随着 Agent 开始真正采取行动,Eval 会从 Model → Human 移动到 Model → Action。
这个位置的 eval 关心 model 是否在 Harness 中采取了正确的行动:工具是否调用正确,任务是否完成,失败是否能够恢复,边界是否被遵守。
这里的 Eval 需要理解和约束的,也不再只是人的缺陷,而是 Harness 的缺陷:环境不完整、工具会失败、反馈稀疏、规则与边界并不总是清晰。
前两类 Eval 有一个共同点:它们都无法直接看到一个明确、可观测的 State。因此只能在模糊中构造代理指标去拟合 State。
4. 理想的 impact loop 是:
Context → Model → Action → State Change
和人相比,AI 天然的高带宽、高并发和低延迟,会让整个 loop 比第一阶段更高效。长期来看,我们努力的方向,就是让 AI 强到足以把 Human 从执行 loop 中解放出来。
当 Human 不再 in the loop,许多 effort 都会被节省。模型不需要报告更易读,也不需要更漂亮的 Slides 和网页来承载 context。
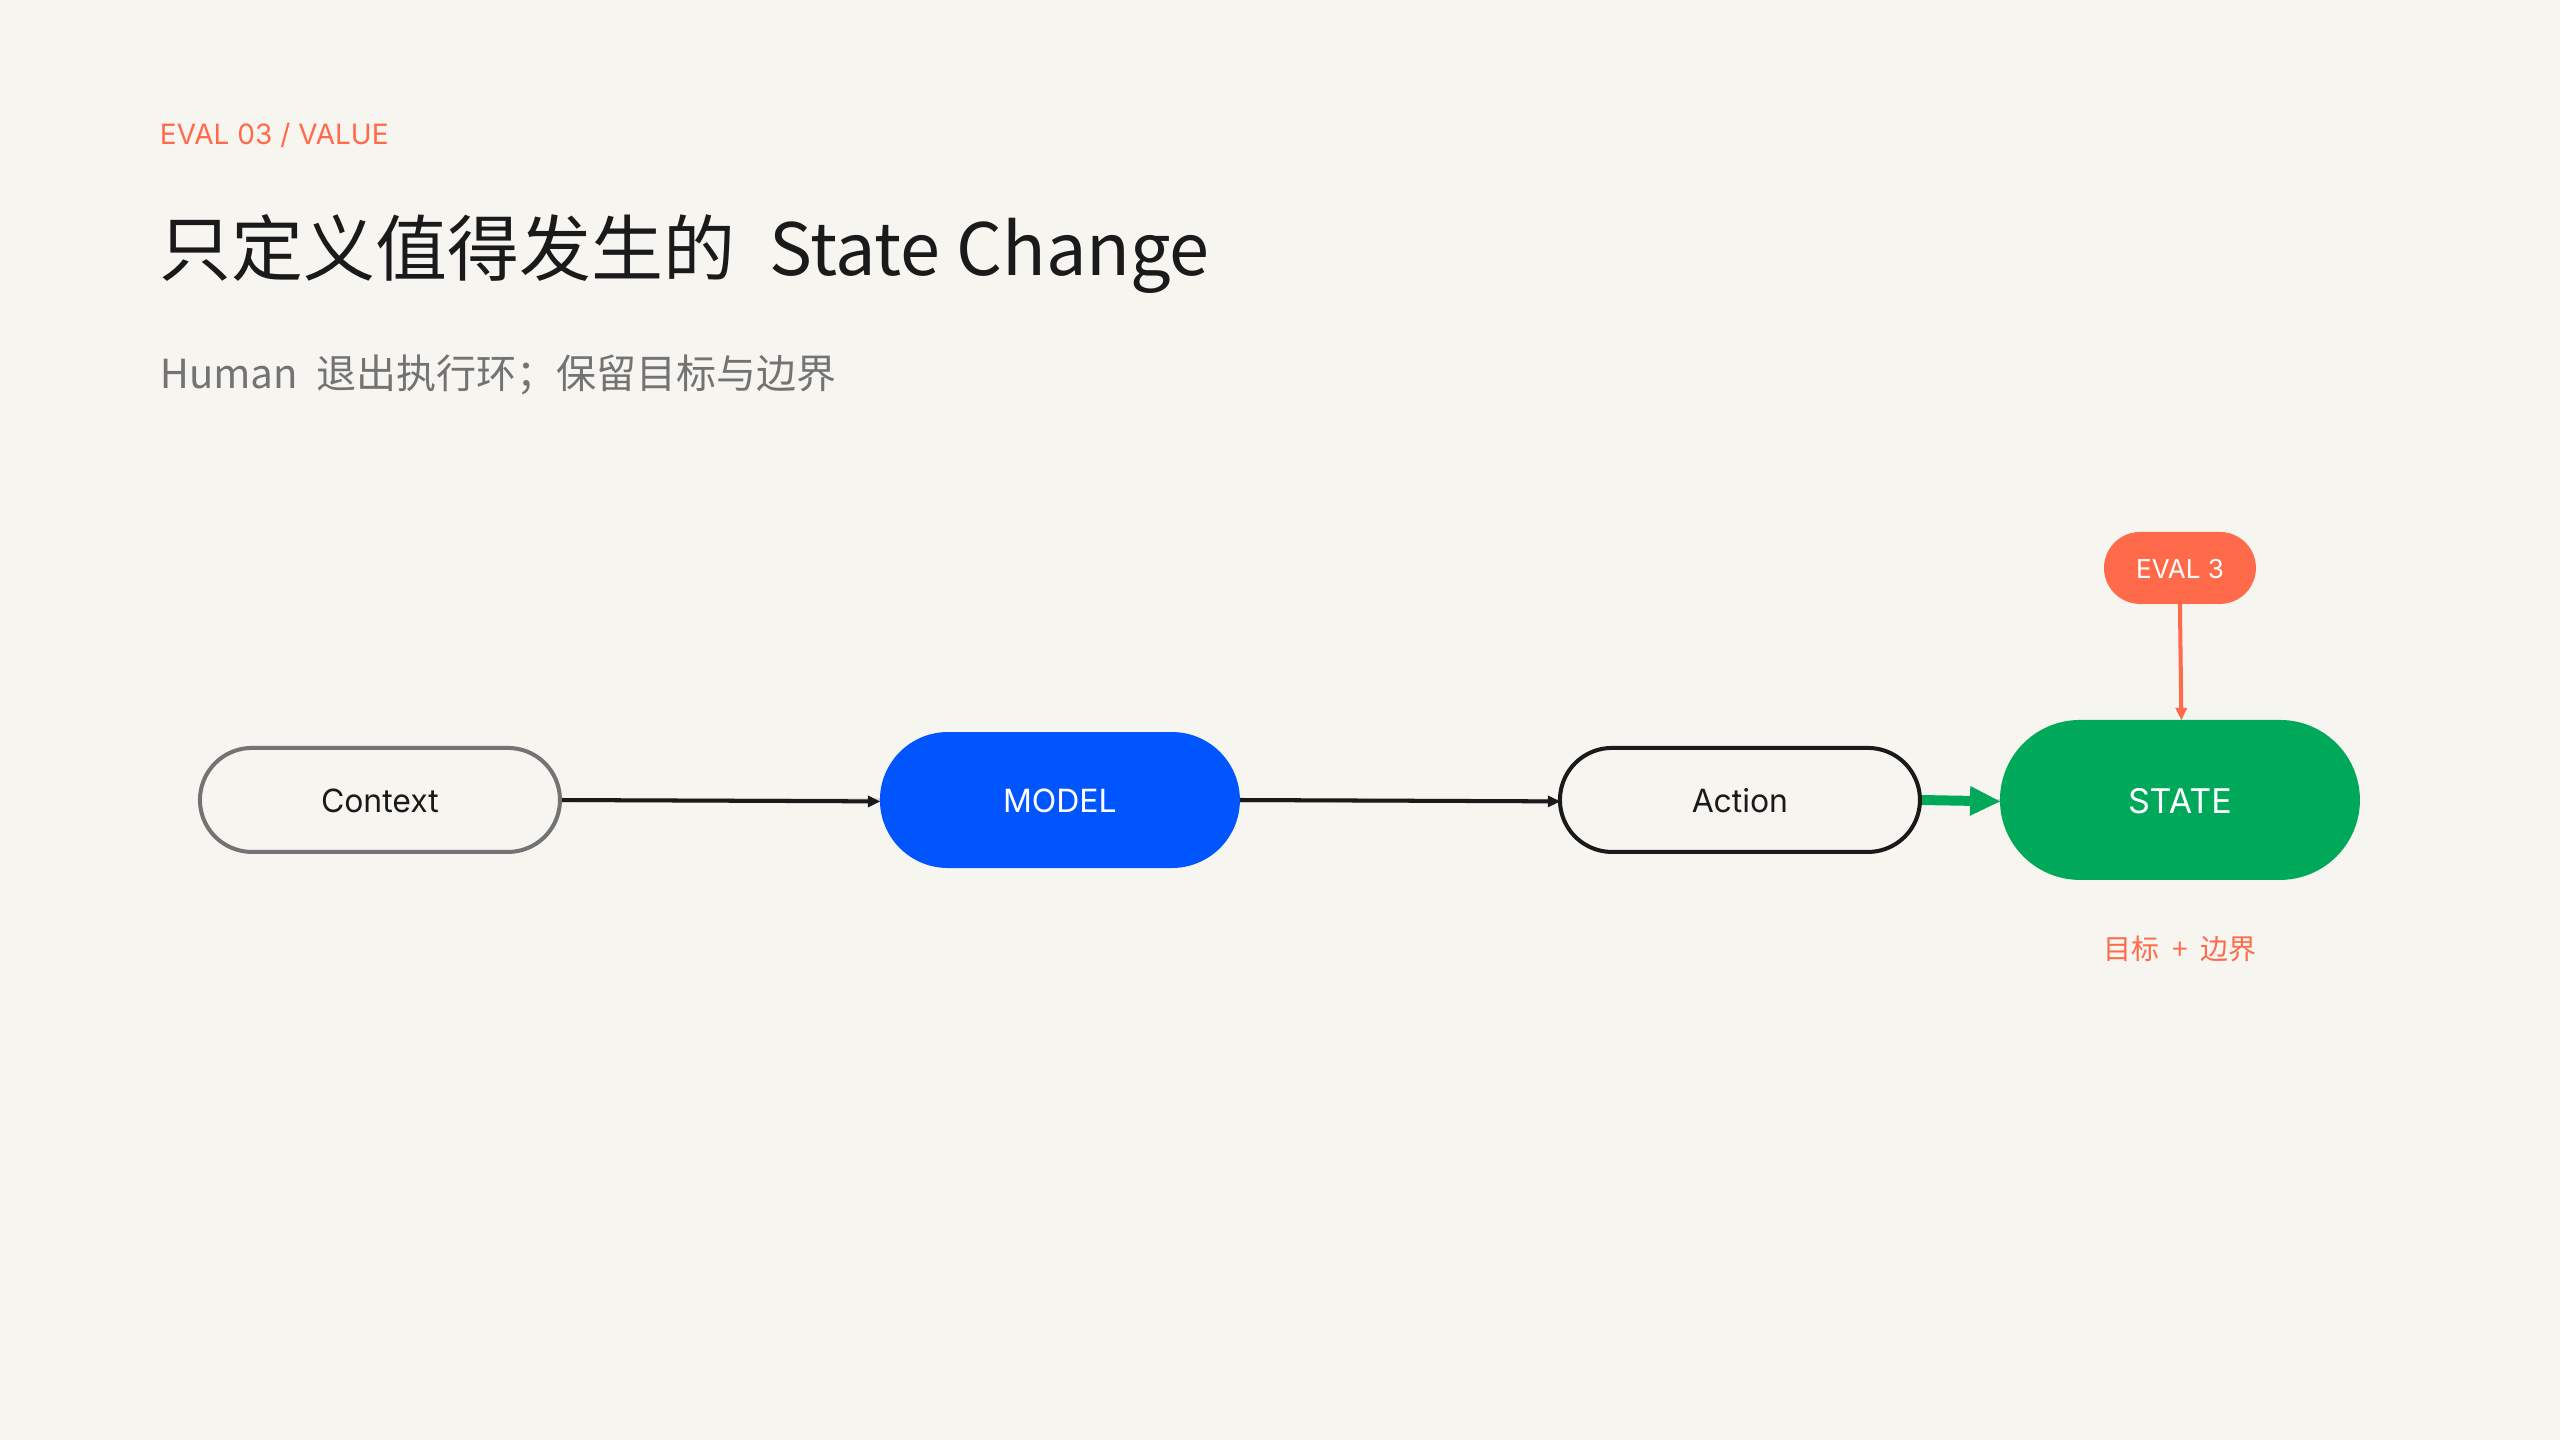
Eval 也会继续向右移动,最终只留下一个问题:
什么 State 值得被改变?
一旦 State 被选定,它往往比中间产物更容易观测。真正困难的,不再是“怎么评”,而是“评什么”;不再是构造一个更好的 proxy,而是找到一个真正值得优化的世界状态。
那会是一个人人都是 Eval 的时代。我们需要通过定义 State 的演进方向,继续维护人的价值。
但那些 State 会是什么?
是更长的健康寿命,是更低的洁净能源成本,是更快的科学迭代,是去火星,还是更丰富的艺术?
我真的很好奇。
从理解和照顾人的缺陷
到定义下一个值得被改变的 state
1. 长久以来,人对世界产生 impact 的方式是:
Context → Human → Action → State Change
人通过学习和吸收 context,将其转化为正确的 action,推动某个状态发生改变。
2. 当有了 AI,我们阶段性地变成了:
Context → Model → Human → Model → Action → State Change
这个阶段,AI 最先爆发的use case是调研报告、Office 三件套和 Website。它们大致覆盖了 loop 的前半部分:
Context → Model → Human
因为人获取 context 的带宽很低,所以报告需要更易读,Slides 需要更美观,前端需要更炫酷。也因此出现了Eval角色:它位于 Model → Human 之间,目标是理解和照顾人的“缺陷”,让模型的输出更容易被人理解、信任和使用。
但这些今天被当作“交付物”的东西,其实都只是中间表示。它们本身通常不改变 State,只是作为 context 的载体,帮助另一个决策主体找到正确的 action。
3. Eval 会沿着 loop 向右移动
随着 Agent 开始真正采取行动,Eval 会从 Model → Human 移动到 Model → Action。
这个位置的 eval 关心 model 是否在 Harness 中采取了正确的行动:工具是否调用正确,任务是否完成,失败是否能够恢复,边界是否被遵守。
这里的 Eval 需要理解和约束的,也不再只是人的缺陷,而是 Harness 的缺陷:环境不完整、工具会失败、反馈稀疏、规则与边界并不总是清晰。
前两类 Eval 有一个共同点:它们都无法直接看到一个明确、可观测的 State。因此只能在模糊中构造代理指标去拟合 State。
4. 理想的 impact loop 是:
Context → Model → Action → State Change
和人相比,AI 天然的高带宽、高并发和低延迟,会让整个 loop 比第一阶段更高效。长期来看,我们努力的方向,就是让 AI 强到足以把 Human 从执行 loop 中解放出来。
当 Human 不再 in the loop,许多 effort 都会被节省。模型不需要报告更易读,也不需要更漂亮的 Slides 和网页来承载 context。
Eval 也会继续向右移动,最终只留下一个问题:
什么 State 值得被改变?
一旦 State 被选定,它往往比中间产物更容易观测。真正困难的,不再是“怎么评”,而是“评什么”;不再是构造一个更好的 proxy,而是找到一个真正值得优化的世界状态。
那会是一个人人都是 Eval 的时代。我们需要通过定义 State 的演进方向,继续维护人的价值。
但那些 State 会是什么?
是更长的健康寿命,是更低的洁净能源成本,是更快的科学迭代,是去火星,还是更丰富的艺术?
我真的很好奇。
78 614
来自圈子
AI探索站
118928人已经加入