即刻App年轻人的同好社区
下载
氛围很好,轻松又充满能量,3mins分享的形式很轻,看见每个人都在闪着光,mark不少有意思的,很哇噻🤗
OwenYoung: #Tab星期四 第一期的氛围是我想要参加的活动! 很期待下周的活动,下周四想来的朋友可以先进图九的群~
0 00
personal agent会不会&适不适合主动推送实时生成的视频流?
最近做了个小小的实验,muse 围绕我的兴趣主动找了信息给我时,我既让他出现在对话主界面(muse在主界面还是克制的,一天最多给我推 2 次);也同时出现在 Feed 里(条数会更多一些)。
一开始只是想看我会在哪边养成习惯。用了一段时间发现,主界面明明是我第一下碰到的,我却禁不住往 Feed 里看,可能Feed里是图文,主界面只有文字。不过主界面是双向的,我能找它,它也能找我。
为什么会想到视频流,是我发现当前有个断点。拿我的另一个personal agent - today举例,他会基于memory对我的理解进行proactive的探索发现,在主界面给我推:桂林公园桂花季、秋日市集。从完成任务角度看,我确认后他当前可以帮我安排行程规划,未来能帮我买好门票,打通履约。
中间的断点是啥呢?我看到推送的还是文字,文字是非常具有想象力,同时也是缺少具象体感的。在确认之前,我还是希望看一眼画面的,有一点身临其境的感觉,我并不知道那里的桂花是什么样子。现在我是切到小红书看一圈图文或视频感受一下。
我认为这一步未来 agent 自己是能接住的。Genie 4已经能实时生成一个能走进去的世界,推过来的是一个我可以实时感受的场景,我看完点个头,它接着把事办了。发现、感受、确认、履约,一段对话里全搞定,这个体验就更 perfect 了。(token消耗先不谈)
生成更有意思的可能是预演还没发生的事。小红书能给我看桂林公园桂花过去时和现在时多么漂亮,但它没法给我看"我这个周六":几点出门,那天下不下雨,人挤不挤,逛完去哪吃饭。这些只有了解我的 agent 才排得出来。
personal agent 帮我订票、购物,吃的是移动互联网里做履约的公司,用老王的话说是 B 面公司。可如果personal agent 开始做基于意图的内容消费,它吃的可能就是 A 面了。
最近做了个小小的实验,muse 围绕我的兴趣主动找了信息给我时,我既让他出现在对话主界面(muse在主界面还是克制的,一天最多给我推 2 次);也同时出现在 Feed 里(条数会更多一些)。
一开始只是想看我会在哪边养成习惯。用了一段时间发现,主界面明明是我第一下碰到的,我却禁不住往 Feed 里看,可能Feed里是图文,主界面只有文字。不过主界面是双向的,我能找它,它也能找我。
为什么会想到视频流,是我发现当前有个断点。拿我的另一个personal agent - today举例,他会基于memory对我的理解进行proactive的探索发现,在主界面给我推:桂林公园桂花季、秋日市集。从完成任务角度看,我确认后他当前可以帮我安排行程规划,未来能帮我买好门票,打通履约。
中间的断点是啥呢?我看到推送的还是文字,文字是非常具有想象力,同时也是缺少具象体感的。在确认之前,我还是希望看一眼画面的,有一点身临其境的感觉,我并不知道那里的桂花是什么样子。现在我是切到小红书看一圈图文或视频感受一下。
我认为这一步未来 agent 自己是能接住的。Genie 4已经能实时生成一个能走进去的世界,推过来的是一个我可以实时感受的场景,我看完点个头,它接着把事办了。发现、感受、确认、履约,一段对话里全搞定,这个体验就更 perfect 了。(token消耗先不谈)
生成更有意思的可能是预演还没发生的事。小红书能给我看桂林公园桂花过去时和现在时多么漂亮,但它没法给我看"我这个周六":几点出门,那天下不下雨,人挤不挤,逛完去哪吃饭。这些只有了解我的 agent 才排得出来。
personal agent 帮我订票、购物,吃的是移动互联网里做履约的公司,用老王的话说是 B 面公司。可如果personal agent 开始做基于意图的内容消费,它吃的可能就是 A 面了。
1 20
用drive.js“导演”了几个 use case 故事用来演示,在静态的 html 上其实也能满足,我偏偏要体现触发逻辑和完整交互,决定先去搓好产品功能demo,在 demo 上再叠加故事板。
从完成task 角度来说,大可不必选择此路径。但后者交付的体验就是更舒服更好。如果是Agent 来自主选择,在想它会怎么选择路径?以及怎么 eval 这种任务表现的好与更好?
从完成task 角度来说,大可不必选择此路径。但后者交付的体验就是更舒服更好。如果是Agent 来自主选择,在想它会怎么选择路径?以及怎么 eval 这种任务表现的好与更好?
0 00
从南京赶回来,为了晚上来听 @敖特_Aute Ai @永远怀念过去的左巨 在 AI Hacker House的开放麦,不仅即刻上关注,我也是ego lite和today ai 的早期用户,有这个机会现场面即。感受到他们都对做的事情很相信,而且在看往的是对personal agent进入生活后,新的可能性和判断。
参与大家的自由交流时,体感置身事内和置身事外是非常不一样的视角,置身事内对有些点是还没想清楚的、还没收敛的很坦然,反而置身事外的可能在焦虑、在推测。
今天特别惊喜收获了 ego lite 的贴纸🤗,还很神奇的是有意想不到的共同认识的连接。
参与大家的自由交流时,体感置身事内和置身事外是非常不一样的视角,置身事内对有些点是还没想清楚的、还没收敛的很坦然,反而置身事外的可能在焦虑、在推测。
今天特别惊喜收获了 ego lite 的贴纸🤗,还很神奇的是有意想不到的共同认识的连接。


9 44
这两天在牛首山的间隙,最值得的体验是2 场疗愈工作坊:音波疗愈和正念冥想
老师是一位在上海工作十年现在搬到了南京,会说中文的印度老师
学到了两种不同的呼吸方式:一是蜜蜂呼吸法,二是4-4-4/4-7-8 呼吸,鼻吸 4s +闭气 4s+鼻呼 4s,通过呼吸调整逐步进入放松的状态,而body relax 包括肌肉的放松和mind peaceful
接触了7 个颂钵对应 7 个脉轮的说法,我尝试去感受不同声波下,是不是真的有脉轮对应的身体部位会响应/共振,脑子里总有一些思绪在展开,没有进入到 mind peaceful的状态
还练习了UAM颂唱,体验了直击天灵盖的共振
mind是比较难以控制的,例如,我们找不到如何让自己的 mind focus 在某个具体身体部位上。这是需要持续练习的
老师还举了一个例子,他不会开车,但他坐在车上他脑中念头会想他是怎么开车的,手打方向盘,眼睛看后视镜,脚在踩油门刹车。他的mind在不断练习
老师是一位在上海工作十年现在搬到了南京,会说中文的印度老师
学到了两种不同的呼吸方式:一是蜜蜂呼吸法,二是4-4-4/4-7-8 呼吸,鼻吸 4s +闭气 4s+鼻呼 4s,通过呼吸调整逐步进入放松的状态,而body relax 包括肌肉的放松和mind peaceful
接触了7 个颂钵对应 7 个脉轮的说法,我尝试去感受不同声波下,是不是真的有脉轮对应的身体部位会响应/共振,脑子里总有一些思绪在展开,没有进入到 mind peaceful的状态
还练习了UAM颂唱,体验了直击天灵盖的共振
mind是比较难以控制的,例如,我们找不到如何让自己的 mind focus 在某个具体身体部位上。这是需要持续练习的
老师还举了一个例子,他不会开车,但他坐在车上他脑中念头会想他是怎么开车的,手打方向盘,眼睛看后视镜,脚在踩油门刹车。他的mind在不断练习
0 00
之后回看不一定是暴论😁,有相同观点+1,看好personal agent坚持走toC免费(免费够用),说不准什么时候还有倒给用户返现😂
莫唯书Mark: 讲个暴论,所有Personal Agent向用户收费的没前途,做Save Time的也没前途,不论中外
0 00
working agent 以 task 为中心;personal agent 以什么为中心?(简单的说以人为中心,我认为是在偷懒)
working agent 的核心对象是"事",事做完就消亡。
personal agent 的核心对象或许是"人及其未竟之事"——你答应过谁什么、你正在往哪儿走、你这周精力还剩多少、哪些关系需要维护、哪些决定悬而未决。这些东西没有完成态,只有状态变化。
以 task 为中心的产品可以被验收、被 benchmark;以人为中心的产品可能没法单次验收?
(欢迎讨论)
working agent 的核心对象是"事",事做完就消亡。
personal agent 的核心对象或许是"人及其未竟之事"——你答应过谁什么、你正在往哪儿走、你这周精力还剩多少、哪些关系需要维护、哪些决定悬而未决。这些东西没有完成态,只有状态变化。
以 task 为中心的产品可以被验收、被 benchmark;以人为中心的产品可能没法单次验收?
(欢迎讨论)
3 20
看proactive 到底在主动什么?working agent 是以 task 为中心的,如果是在你交代的任务里面主动(例如做完顺手把下一步备好、自己修复问题),这不叫 proactive,这叫胜任。一个被雇来干活的 agent 连这个都没有,是失职。如果是跨出任务边界主动,没人让它盯,它自己决定什么对你重要、什么时候来打扰你,这个我理解是需要克制的,proactive 其实是 cost 信任的。🤔

Gavin_C.: working agent 不需要 proactive,谢谢。
0 00
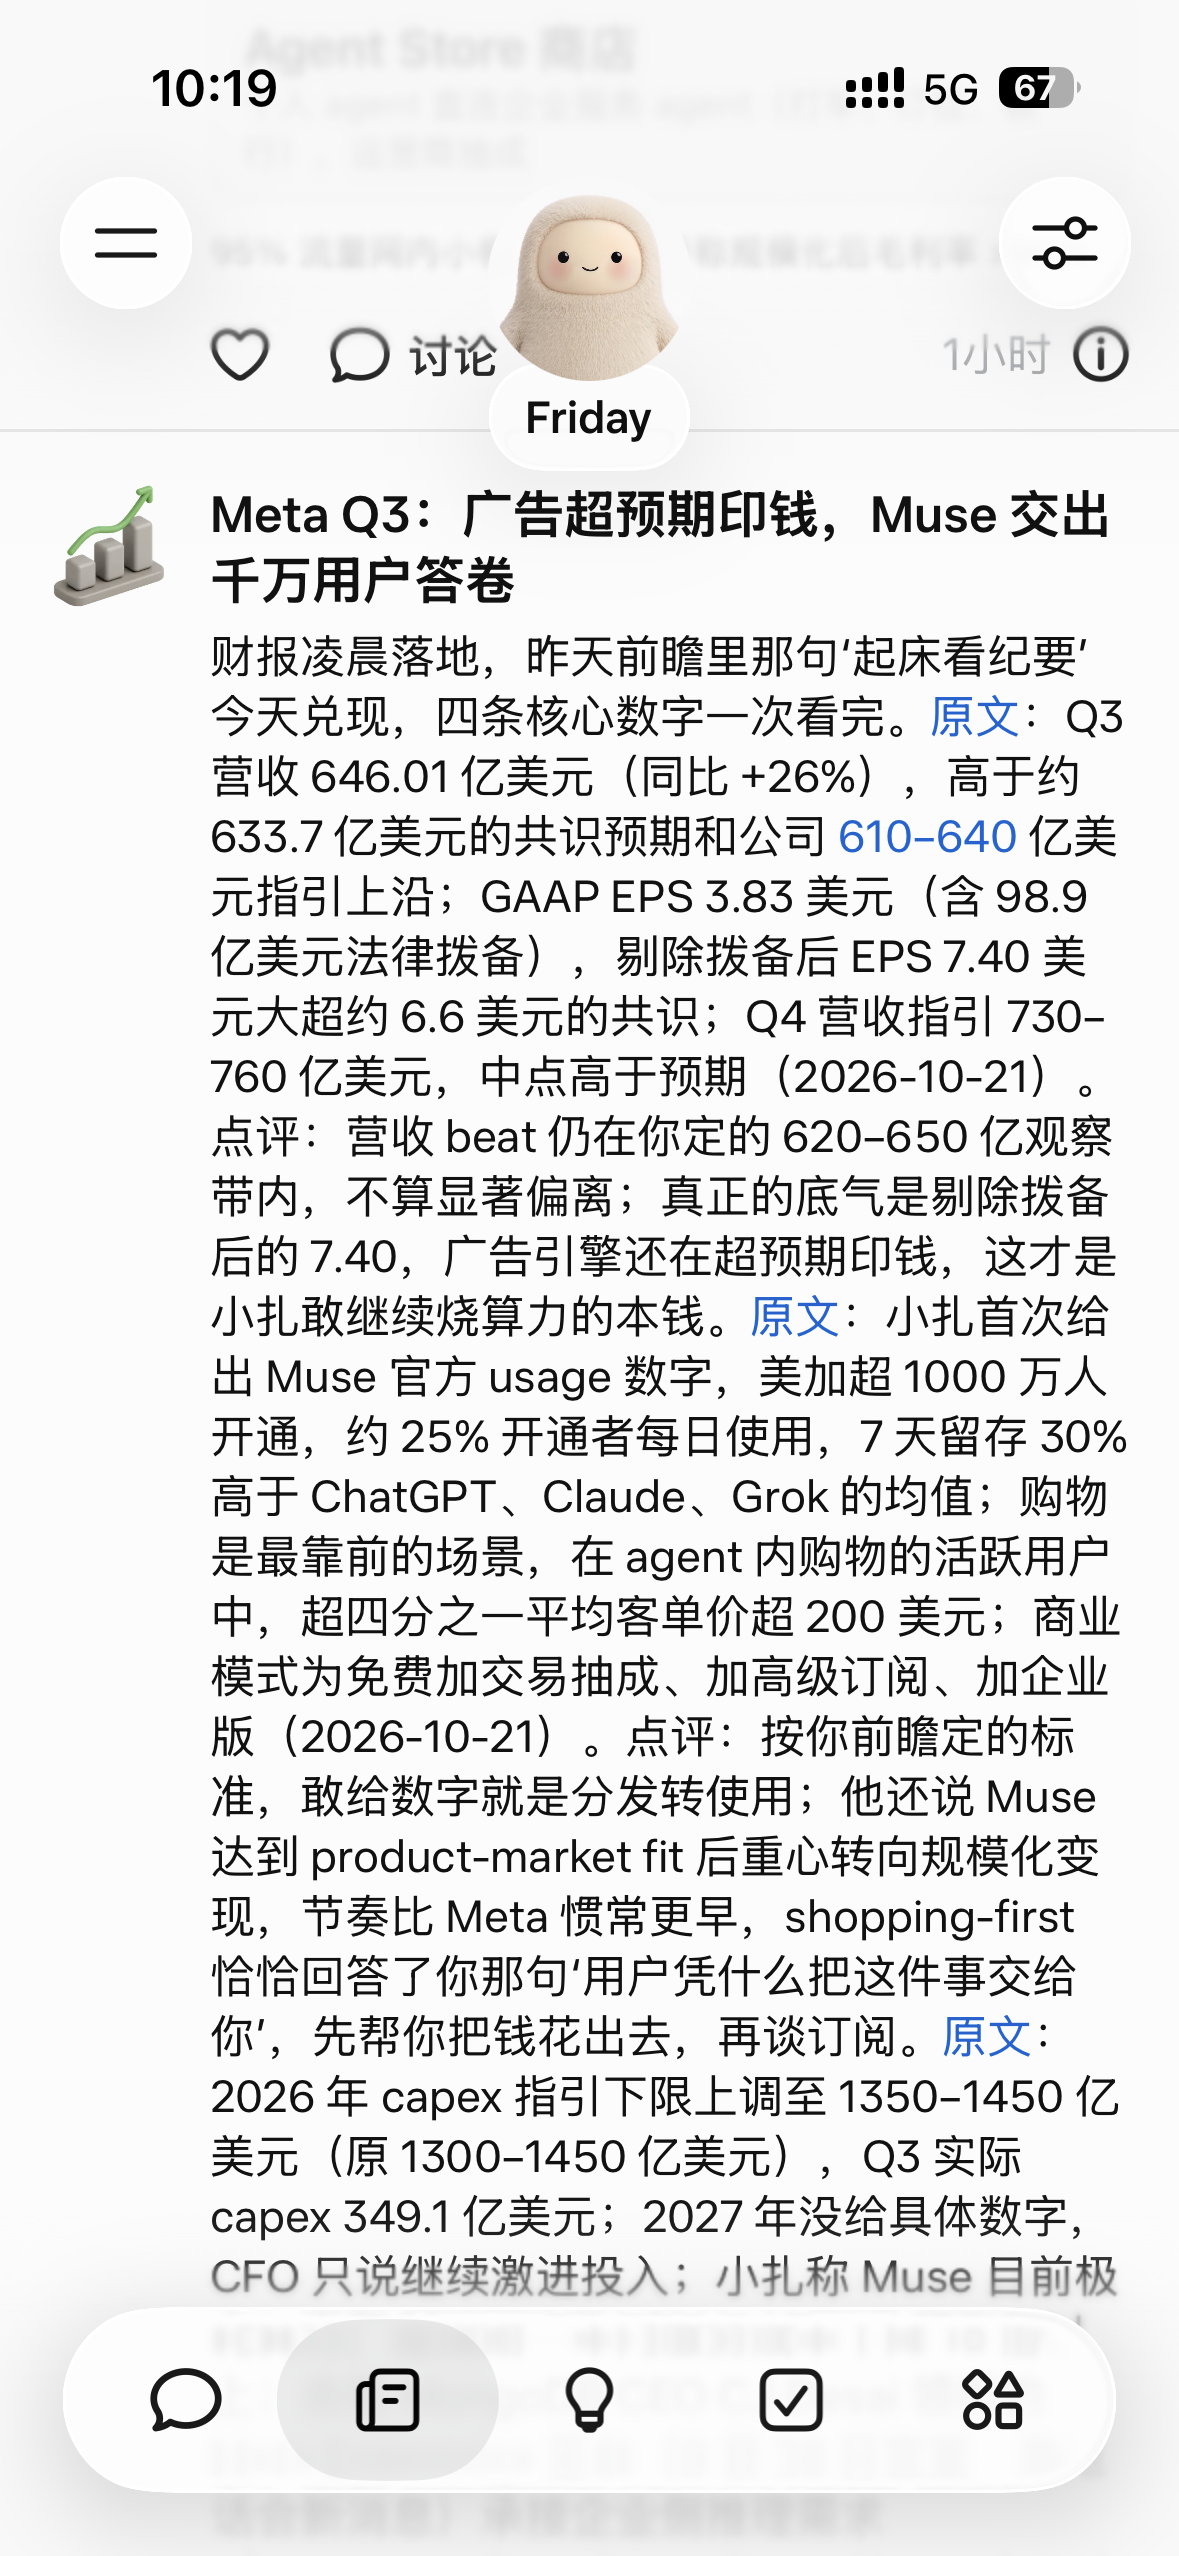
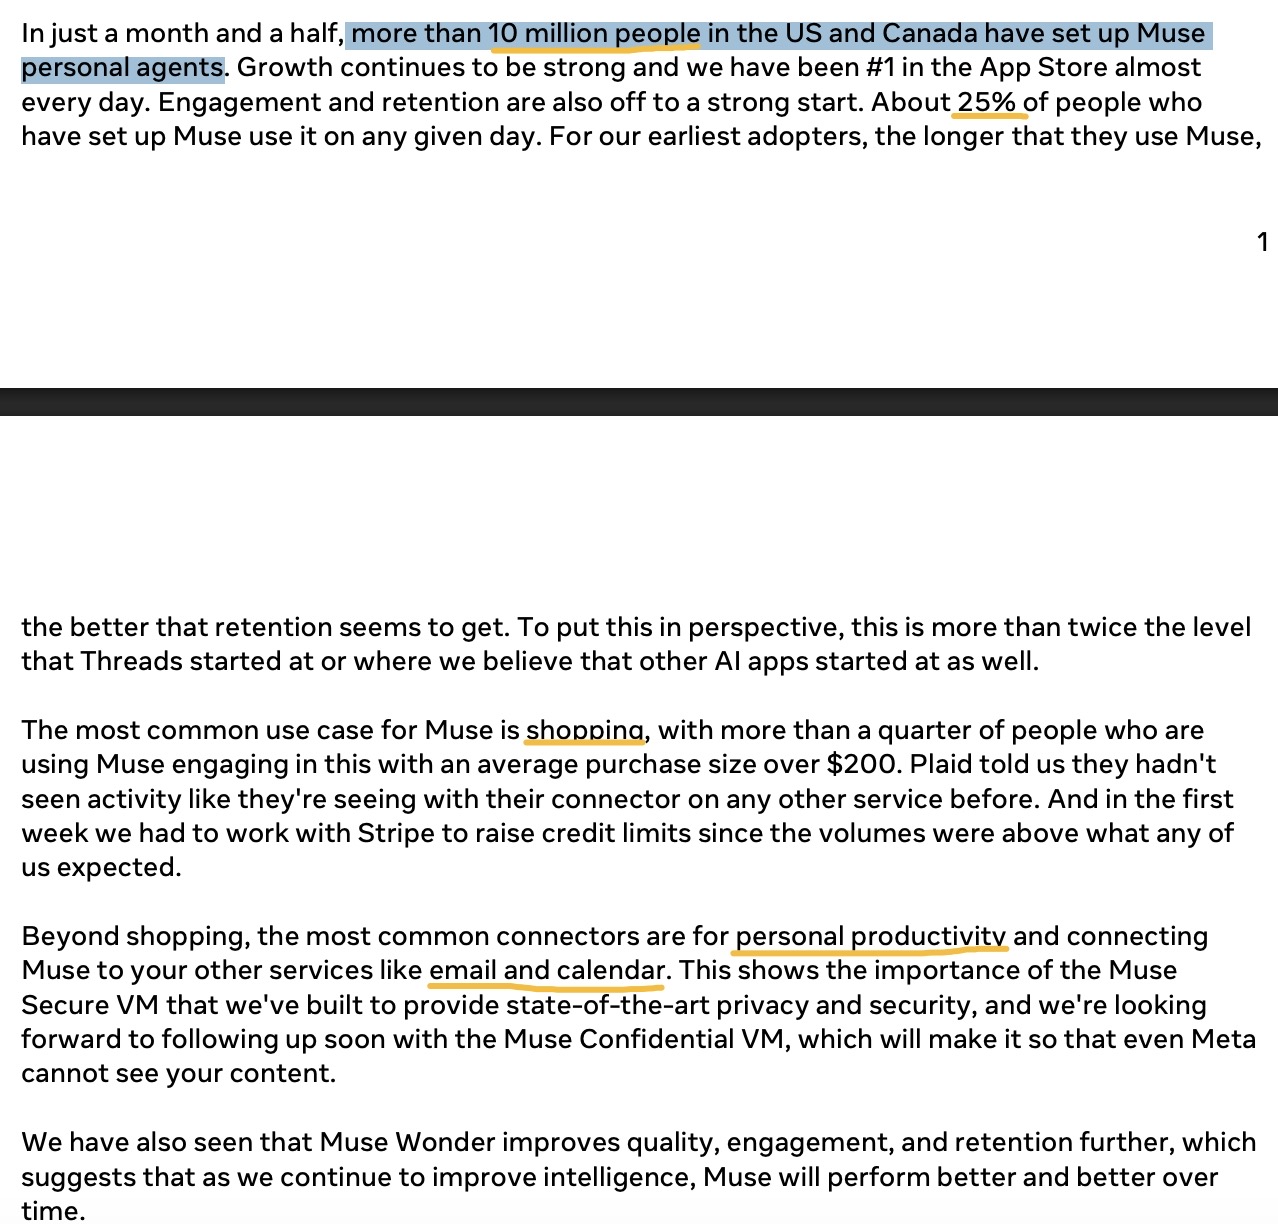
Meta电话会上小扎分享的Muse数据:
1. Muse上线约一个半月,美加超 1000 万人开通、约 25% 日活(Threads 初期的两倍多);
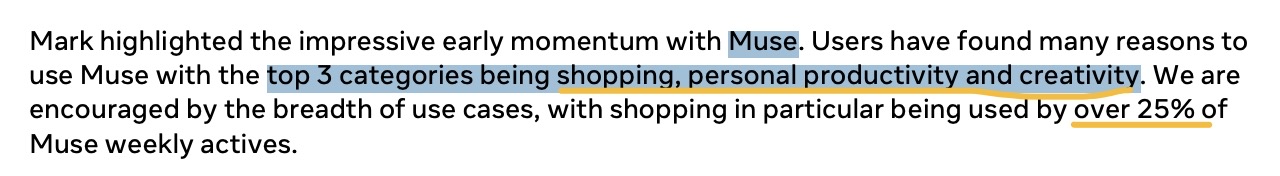
2.Top3场景是shopping、personal productivity、creativity,在购物的人里,超 1/4 的人平均客单价超 200 美元;
3.Muse 达到 product-market fit 后重心会转向规模化变现,节奏比 Meta 惯常更早;
4.Muse 目前极耗算力,但预期一年内服务成本下降 10 倍以上
另据 Sensor Tower 第三方估算,Muse7 天留存 30%、14 天 23%,高于 ChatGPT、Claude、Grok 的均值(19%/16%)
1. Muse上线约一个半月,美加超 1000 万人开通、约 25% 日活(Threads 初期的两倍多);
2.Top3场景是shopping、personal productivity、creativity,在购物的人里,超 1/4 的人平均客单价超 200 美元;
3.Muse 达到 product-market fit 后重心会转向规模化变现,节奏比 Meta 惯常更早;
4.Muse 目前极耗算力,但预期一年内服务成本下降 10 倍以上
另据 Sensor Tower 第三方估算,Muse7 天留存 30%、14 天 23%,高于 ChatGPT、Claude、Grok 的均值(19%/16%)
0 02